🐢 Librería de código abierto para la evaluación y pruebas de agentes de LLM
[!IMPORTANT] Giskard v3 es una reescritura completamente nueva diseñada para pruebas dinámicas y de múltiples turnos de agentes de IA. Esta versión elimina dependencias pesadas para mejorar la eficiencia, a la vez que introduce un escáner de vulnerabilidades de IA más potente y una evaluación RAG mejorada — ambos ahora incluidos de forma nativa en
giskard-scan, sin dependencia de la v2. Solo el escaneo heredado para modelos tabulares/ML sigue siendo exclusivo de la v2. Giskard v2 sigue disponible pero ya no se mantiene activamente. Sigue el progreso → Lee el Anuncio de la v3 · Hoja de ruta
pip install giskard           # checks (+ agents, llm, core)
pip install "giskard[scan]"   # + vulnerability / quality scan
pip install "giskard[openai]" # provider SDK for LLM judges / generators
Requiere Python 3.12+.
| Extra | Añade |
|---|---|
| (ninguno) | giskard-checks y dependencias |
scan | giskard-scan |
openai / anthropic / … | SDKs de proveedores (ver dependencias opcionales en pyproject.toml) |
Telemetría: analítica agregada opcional mediante giskard-core. No se envían prompts ni salidas.
Desactívela con export DO_NOT_TRACK=1 o export GISKARD_TELEMETRY_DISABLED=1 (o las mismas claves en un archivo .env en el directorio de trabajo). Establécelas antes de la importación para evitar la creación de ~/.giskard/id; establecerlas más tarde también detiene los envíos posteriores.
Detalles: README de giskard-core.
Giskard es una biblioteca de Python de código abierto para probar y evaluar sistemas agénticos. La arquitectura v3 es un conjunto modular de paquetes enfocados — cada uno con solo las dependencias que necesita — construidos desde cero para envolver cualquier cosa: un LLM, un agente de caja negra o un pipeline de múltiples pasos.
| Estado | Paquete | Descripción |
|---|---|---|
| ✅ Estable | giskard-checks | Pruebas y evaluación — API de escenarios, comprobaciones integradas, LLM-as-judge |
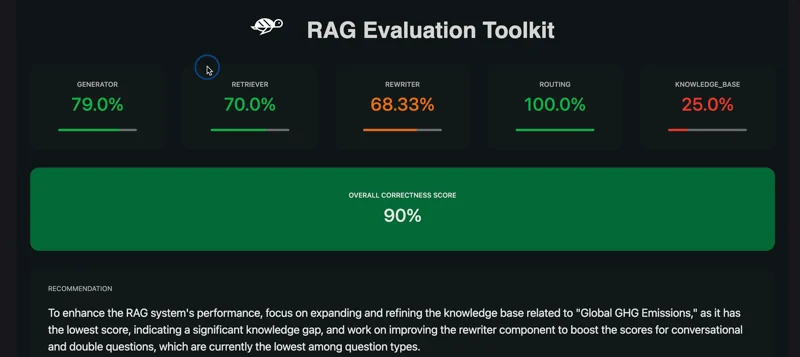
| ✅ Estable | giskard-scan | Escáner de vulnerabilidades de agentes + evaluación de calidad RAG — red teaming, inyección de prompts, jailbreaks y contenido dañino (vulnerability_scan, sucesor de v2 Scan), además de evaluación de calidad de la base de conocimiento (quality_scan, sucesor de v2 RAGET) |
Estos se basan en tres bibliotecas fundamentales — giskard-core (utilidades compartidas y telemetría), giskard-llm (enrutamiento de LLM independiente del proveedor) y giskard-agents (orquestación de agentes y flujos de trabajo) — que se incorporan automáticamente y rara vez se usan directamente.
pip install giskard-checks
Giskard Checks es una librería ligera para crear evaluaciones (evals) que prueban sistemas basados en LLM — desde simples aserciones hasta evaluaciones con LLM como juez. A diferencia de las pruebas unitarias tradicionales, las evals están diseñadas para salidas no deterministas donde la misma entrada puede producir diferentes respuestas válidas.
Usa Giskard Checks para:
Las evals integradas incluyen coincidencia de cadenas, comparaciones, regex, similitud semántica y comprobaciones con LLM como juez (Groundedness, Conformity, LLMJudge).
(inputs) -> outputs (opcionalmente con trace)giskard.agents.Generator es un cliente LLM para flujos de trabajo/jueces — no es lo mismo que
los generadores de entrada de giskard.checks (LLMGenerator) que sintetizan mensajes de usuario.
En un script sin un bucle de eventos en ejecución:
from giskard.checks import Scenario, Groundedness


def get_answer(inputs: str) -> str:
    return "Paris"  # replace with your model / agent


scenario = (
    Scenario("test_france_capital")
    .interact(inputs="What is the capital of France?", outputs=get_answer)
    .check(
        Groundedness(
            name="answer is grounded",
            context="France is in Western Europe. Its capital is Paris.",
        )
    )
)
result = scenario.run_sync()
result.print_report()
En una celda de notebook o dentro de una función asíncrona, utiliza await con el escenario en su lugar:
result = await scenario.run()
result.print_report()
Groundedness es un juez LLM — instala un extra de proveedor (por ejemplo, pip install "giskard[openai]") y configura la clave de API correspondiente. Modelo predeterminado: openai/gpt-4o-mini.
Consulta la documentación completa para Suites, LLMJudge, escenarios multiturno y más.