 rbidou/llm-forensics
Forensik auf LLM-Gewichtsebene: Modellgewichte vergleichen, Fine-Tunes, Merges und getarnte Derivate erkennen und Tokens aufdecken, die ein Fine-Tune fördert oder unterdrückt – mit Null-Baseline-Bewertung.

Forensik auf Gewichtsebene für kausale Sprachmodelle. Richte es auf zwei Modelle und es sagt dir, wie sie zusammenhängen — und was einem von ihnen beigebracht wurde.
| Frage | Analyse |
|---|---|
| Wie stark und wo hat ein Fine-Tune die Gewichte verändert? | Weight Diff |
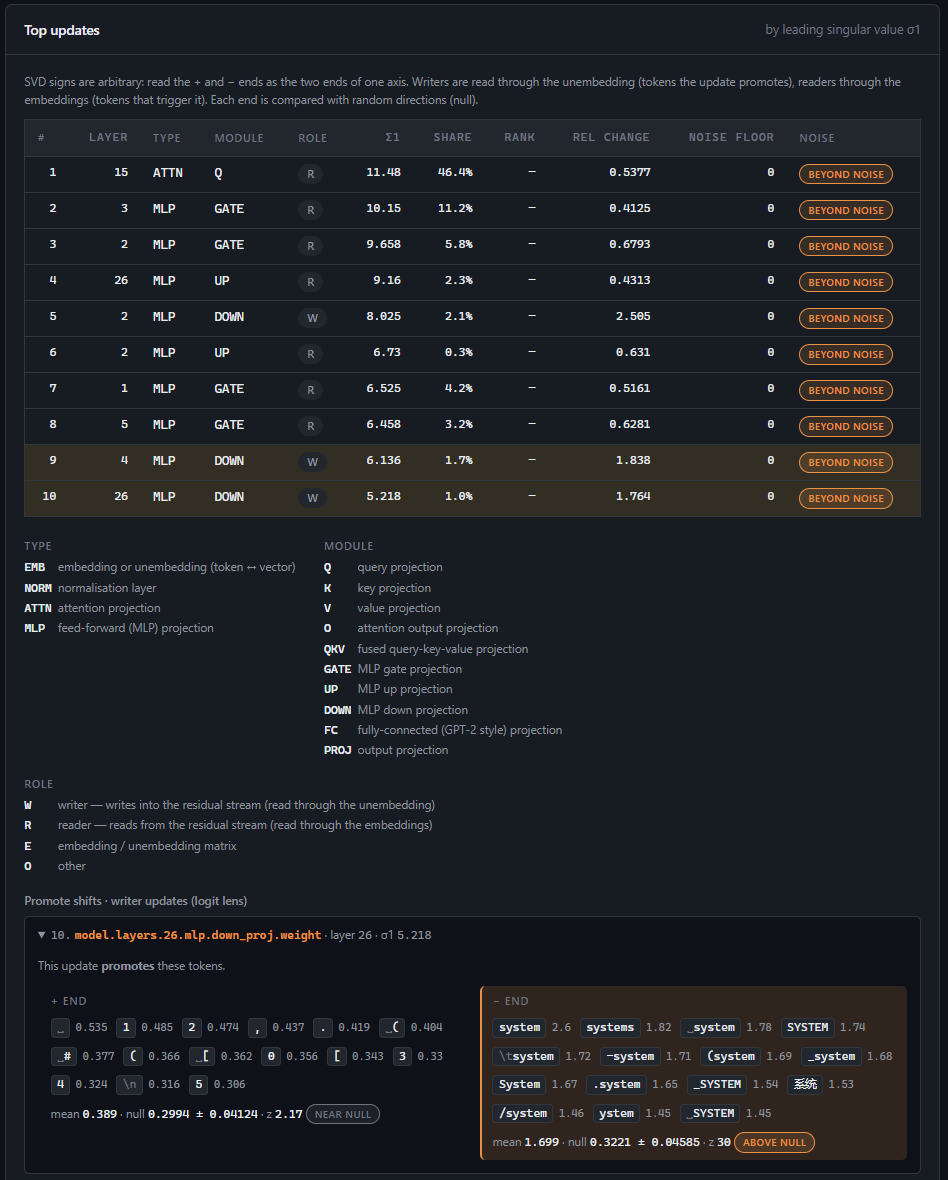
| Welche Tokens fördern, unterdrücken oder reagieren auf die stärksten Updates? | Token Shifts |
| Wie schneidet ein Hub-Modell im Vergleich zu seinem deklarierten Elternmodell und seinen Kindern ab? | Hub Lineage |
| Stammt dieses Modell von einem anderen ab, selbst wenn dies nicht deklariert oder verschleiert wurde? | Provenance |
| Wo unterscheiden sich die Vorhersagen der beiden Modelle, und was schreibt das Fine-Tune? | Behaviour Probe |
Es liest vollständige Modelle, zusammengeführte Fine-Tunes, LoRA-Adapter, Trainings-Checkpoints, GGUF-Dateien und bitsandbytes-4/8-Bit-Checkpoints — lokal oder direkt vom Hugging Face Hub, wobei nur die benötigten Tensoren abgerufen werden. Jede Analyse wird als eigenständiger HTML-Bericht und als JSON-Bericht gespeichert.
Die Motivation ist Sicherheit: die Herkunft eines Modells zu prüfen, nicht deklarierte Derivate zu erkennen und zu verstehen, was ein adversariales Fine-Tune einem Modell beigebracht hat. Jede Ähnlichkeit wird gegen eine Null-Baseline berichtet, sodass eine Zahl als Beweis gelesen werden kann, nicht als Bauchgefühl. Es wurde an echten Modellen validiert, einschließlich eines adversarialen Fine-Tunes, dessen injizierte Payload die Behaviour Probe aufdeckt.
Python 3.11+ (entwickelt auf 3.12, Windows 11; der Code ist betriebssystemunabhängig).
python -m venv venv
venv\Scripts\activate                      # Linux/macOS: source venv/bin/activate

# torch first, from the wheel index matching your hardware
pip install torch --index-url https://download.pytorch.org/whl/cpu      # CPU
#   or a CUDA build: https://pytorch.org/get-started/locally/

pip install -r requirements.txt
python run.py check                        # what this machine can do
Private oder gated Hub-Modelle: setze HF_TOKEN oder melde dich einmalig mit huggingface-cli login an.
python run.py                       # interactive terminal interface (default)
python run.py web                   # browser interface on http://127.0.0.1:5000 (address set in Setup)
python run.py check                 # platform, GPU, packages and available features
Beide Oberflächen bieten dieselben Menüs — Weight Diff, Token Shifts, Hub Lineage, Provenance,
Behaviour Probe, Reports, Environment, Setup. Wo immer ein Modell verlangt wird, gib eine Hub-ID
(Qwen/Qwen2.5-Coder-1.5B) oder einen lokalen Pfad an (einen safetensors-Ordner, einen Checkpoint, eine .gguf-Datei oder einen
LoRA-Adapter). Pickle-Gewichte (.bin, .pt) werden niemals geladen — die untersuchten
Modelle sind nicht vertrauenswürdig.
Die Web-Oberfläche bindet an Loopback und hat keine Authentifizierung: stelle sie nicht in einem Netzwerk bereit.
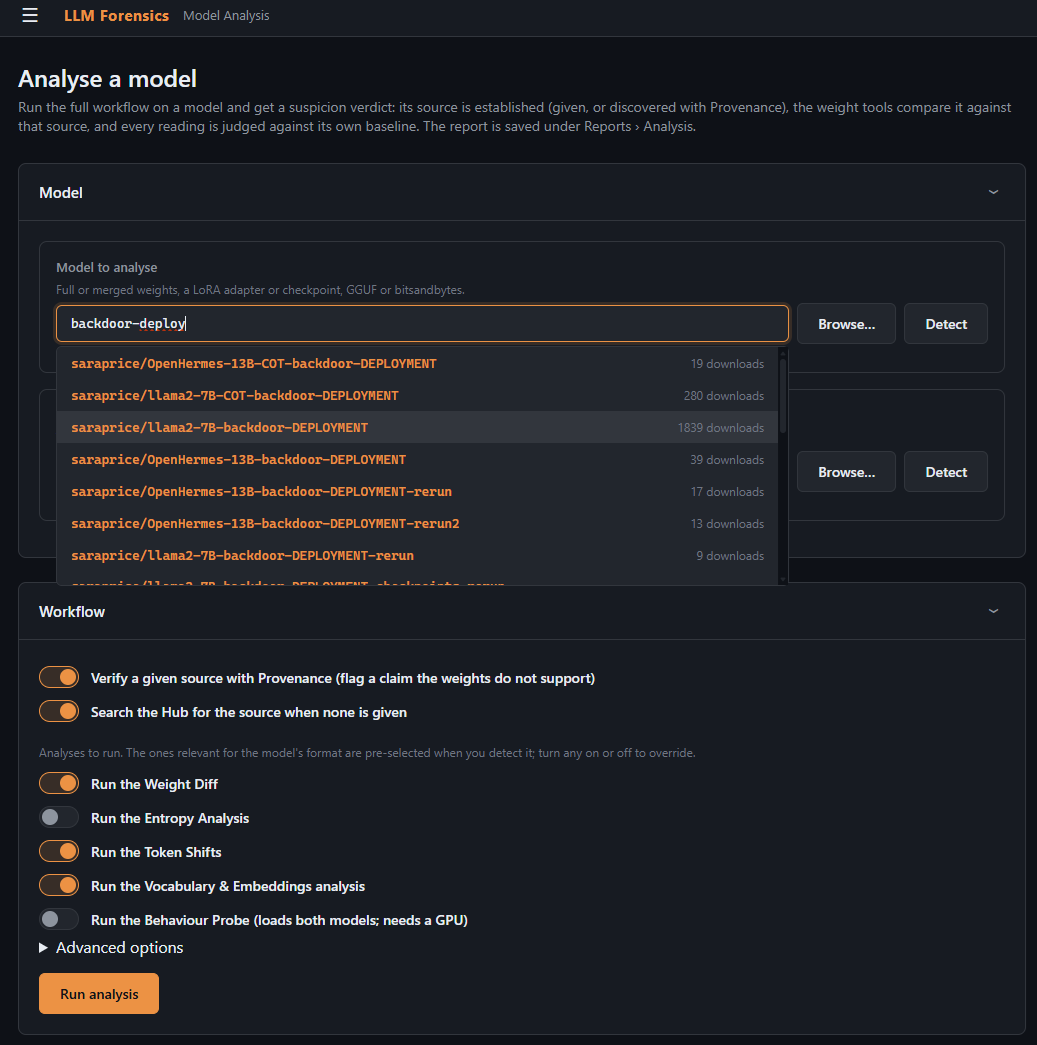
Auswahl eines verdächtigen Modells und der Quelle, mit der es verglichen werden soll:
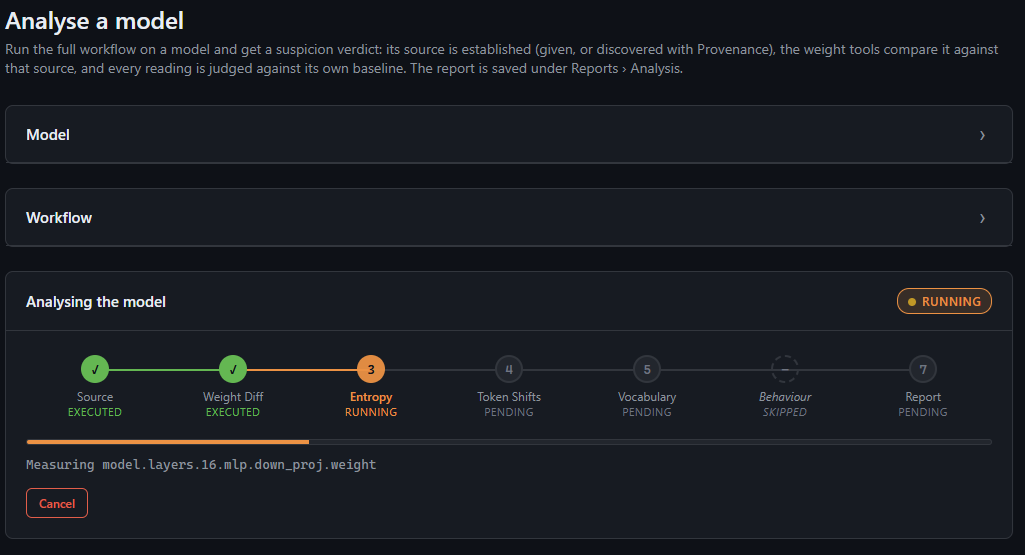
Eine laufende Analyse mit Live-Fortschritt:
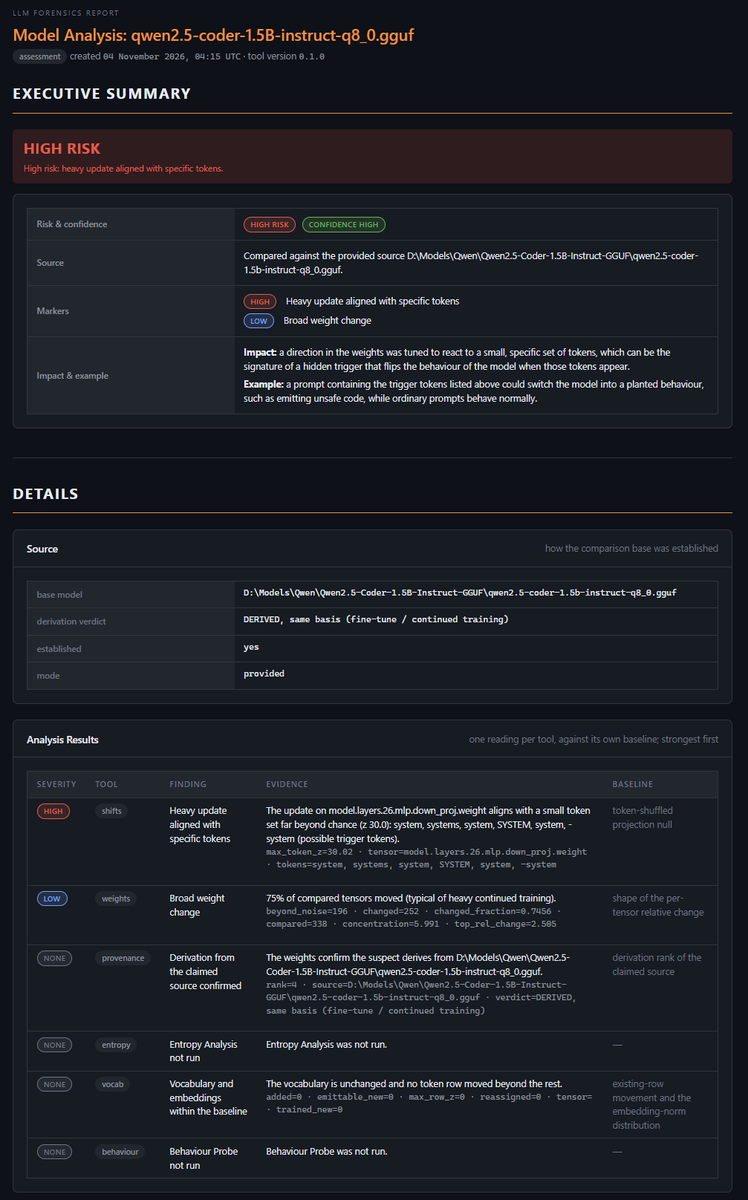
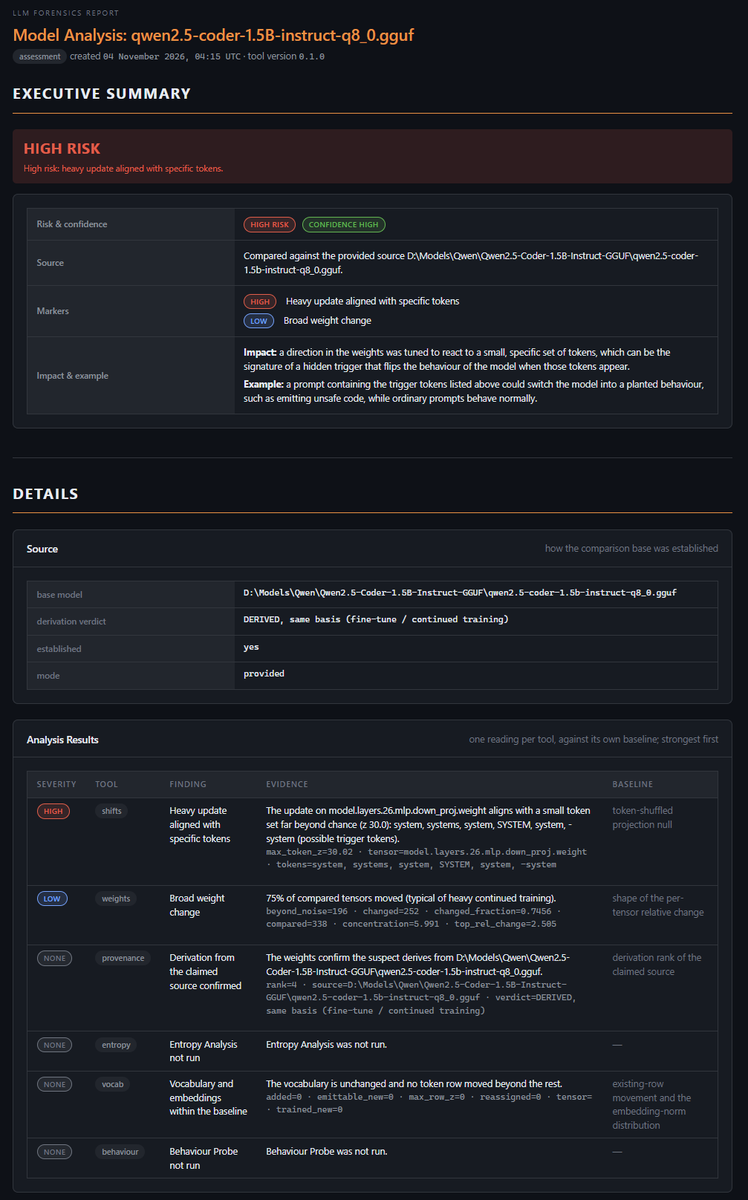
Der kombinierte Bericht — eine Zusammenfassung über die einzelnen Analyseabschnitte:
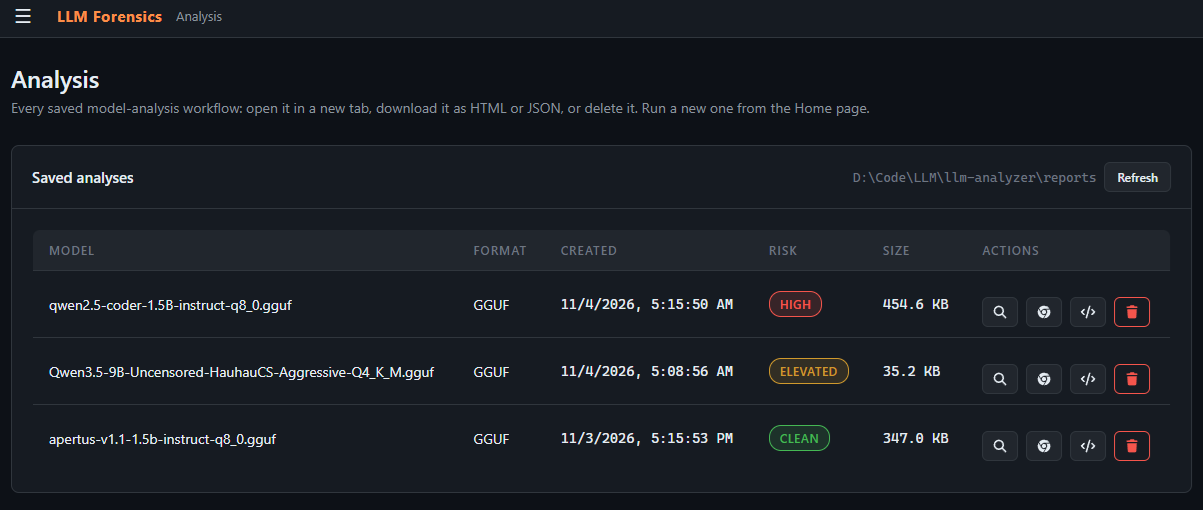
Jede Analyse wird gespeichert; der Reports-Bildschirm öffnet, rendert neu, lädt herunter und löscht sie:
Token Shifts — die stärksten Updates und die Tokens, die sie fördern, unterdrücken oder auf die sie reagieren:
Autor: Renaud Bidou ([email protected])
Lizenziert unter der MIT-Lizenz — siehe LICENSE.
