
Skip to content
KitploitKITPLOIT
ToolsExploitsBlog
Log in
Einreichen
ToolsExploitsBlog
Einreichen

Hacking-, PenTest- und Cybersicherheits-Tools für Ihr Sicherheitsarsenal!

Kitploit ist ein Verzeichnis von Hacking-, Cybersicherheits- und Pentesting-Tools. Entdecken Sie die neuesten Projekt-Updates, um Schwachstellen zu finden, Systeme zu analysieren, Tests zu automatisieren und Ihre Sicherheit zu stärken.

FeedsKontaktDatenschutz© 2026 Kitploit

Tool-Verzeichnis

Kategorien

Alle Kategorien anzeigen
Loading categories
confusable-vision — Das weltweit erste Font-für-Font-Verwechslungsdatenset: welche Unicode-Zeichen ähnlich aussehen, gemessen an den Umrissen von 322 Schriftarten in der Größe, in der Menschen sie lesen. CC BY, verwendet in Mozillas Add-on-Namensprüfungen. | Kitploit
Tools/GitHubGitHub/paultendo/confusable-vision
OSINT (Open-Source-Intelligence)AufklärungWebsicherheitBedrohungsanalyseLieferkettensicherheitPapers & ForschungLernen & BildungKuratierte Ressourcen
GitHubpaultendo/confusable-vision

confusable-vision

Das weltweit erste Font-für-Font-Verwechslungsdatenset: welche Unicode-Zeichen ähnlich aussehen, gemessen an den Umrissen von 322 Schriftarten in der Größe, in der Menschen sie lesen. CC BY, verwendet in Mozillas Add-on-Namensprüfungen.

1129vor 21 TagenNoch nicht geprüft

Beliebteste

Alle anzeigen →

Entdecken Sie die meistgenutzten Tools unserer Community.

Alle Tools erkunden

Durchsuchen Sie unsere Tool-Sammlung

Alle Tools anzeigen →
Teilen
Repository anzeigen
Webseite

confusable-vision

Der weltweit erste Confusables-Datensatz Schriftart für Schriftart. Welche Unicode-Zeichen wie welche aussehen, gemessen anhand der Umrisse der Schriftarten statt anhand von Pixeln. Die aktuelle Version, 2026.09.26, vergleicht jeden Buchstaben und jede Ziffer, die jede der 322 Schriftarten zeichnet, in der Größe und an der Grundlinienposition, die jedes Glyph im Fließtext hat. Die Verwechslungskandidaten von ASCII-Buchstaben und -Ziffern werden dann im Kontext geprüft: eingebettet zwischen anderen Buchstaben in gängigen Schriftarten in der Größe, in der Menschen sie lesen, und verglichen mit Paaren, die allgemein als gleich akzeptiert werden, wie 0 und O.

addons.mozilla.org verwendet Zeichen aus confusable-vision, um Add-on-Namen auf Verwechslungskandidaten zu prüfen, im Quellcode von Mozilla genannt; siehe Verwendet von.
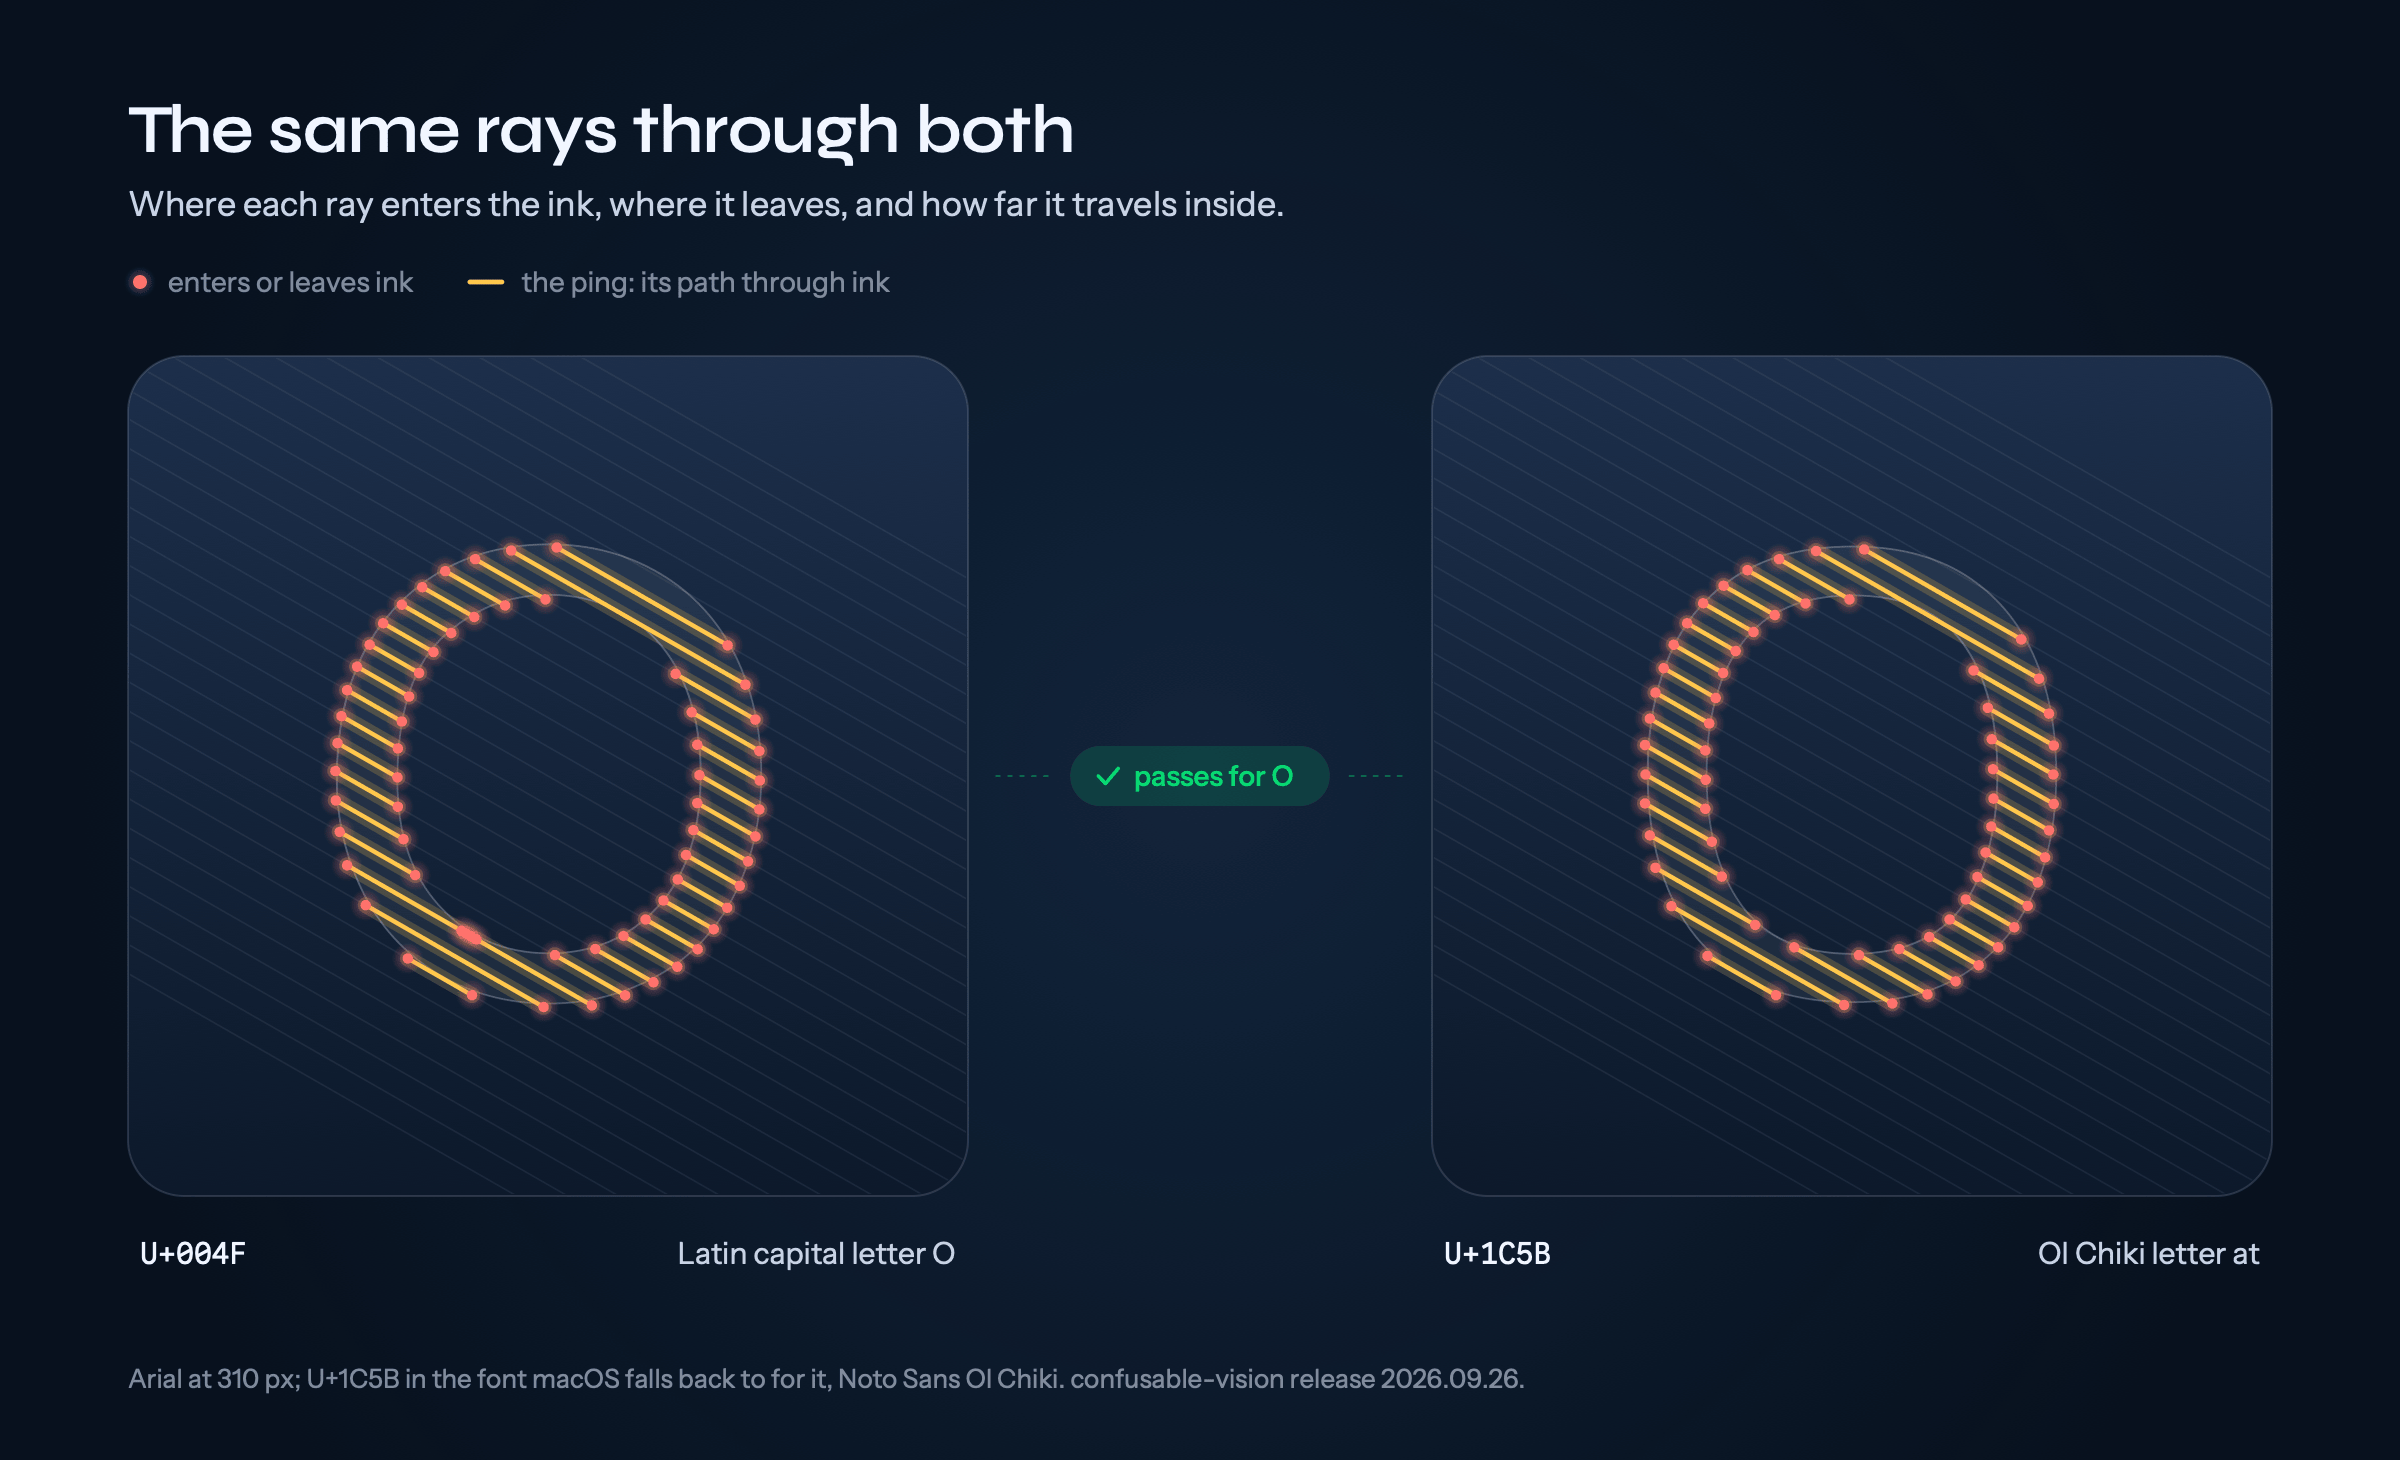
Dieselben Strahlen durch das lateinische Großbuchstaben-O und den Ol-Chiki-Buchstaben (U+1C5B): wo jeder Strahl in die Tinte eintritt und sie verlässt, und sein Weg durch die Tinte, stimmen überein.

Verwendet von

  • Mozilla addons-server, der Code hinter addons.mozilla.org, fügt Zeichen aus der Ausgabe von confusable-vision der Tabelle hinzu, mit der Verwechslungskandidaten auf ASCII abgebildet werden, wenn Add-on-Namen geprüft werden: src/olympia/amo/confusables.py, Pull Requests #24468, #24541, #24612 und #24665 (Februar bis März 2026).
  • disarm (raeq/disarm), das adversariales Unicode kanonisiert, bevor es Klassifikatoren, Indizes und Identifikatoren erreicht, fügt gemessene Paare aus confusable-vision seinen Confusables-Tabellen hinzu: data/confusables_supplement.tsv, data/confusables_vision.tsv.
  • SilverSpeak (ACMCMC/silverspeak), eine Python-Bibliothek zum Durchführen und Neutralisieren von Homoglyph-Angriffen auf Text, baut die visuellen Nachbarn in seinem Homoglyph-Graphen aus den Discovery-Dateien von confusable-vision auf (docs/hkb.md).
  • namespace-guard liefert die gemessenen Paare aus, und über es erreichen sie agent-sanitizer, das namespace-guard als Standard-Engine verwendet, um verwechselbare Zeichen in der Tool-Call-Eingabe eines KI-Agenten auf ASCII abzubilden (deps.dev).

Diese Projekte bezogen ihre Daten aus den Ausgaben von confusable-vision von Februar und März 2026.

Diskutiert auf Hacker News: I rendered 1,418 confusables over 230 fonts und Confusables.txt and NFKC disagree on 31 characters.

Version 2026.09.26 in Zahlen:

  • 322 Schriftarten: jede Schriftart auf macOS, einschließlich der bei Bedarf heruntergeladenen wie PingFang, plus Roboto, Noto Sans, Noto Serif, Noto Sans CJK und DejaVu. 64.751 Codepunkte in 140 Schriftsystemen.
  • 11.517 Paare, die in mindestens einer Schriftart oder Schriftartkombination gleich sind, von denen 5.975 die vorgeschlagenen Schwellenwerte erfüllen.
  • 719 Paare aus einem Zeichen und einer zweibuchstabigen ASCII-Sequenz, wie ǁ und ll, oder Ы und bl.
  • 3.055 Kandidaten für Verwechslungskandidaten von ASCII-Buchstaben, -Ziffern und -Sequenzen, im Kontext geprüft: 646 gleich in der strengen Stufe, 358 weitere in der breiten Stufe, 101 weitere, die dem Design des Buchstabens in einer anderen gängigen Schriftart entsprechen. 224 der strengen sind nicht in Unicode's confusables.txt.

Die Daten werden als versionierte Version in data/release/2026.09.26/ veröffentlicht (CC-BY-4.0). namespace-guard und d0ma1n bauen darauf auf.

Was sich gegenüber Version 2 geändert hat

Version 2 (2026.09.24, und 2026.09.25 für die TLD-Daten) verglich nur die Paare und Schriftarten, die frühere Läufe verglichen hatten. Eine Prüfung identischer Glyphen ergab, dass sie 637 der 2.654 Fälle erfasste, in denen eine Schriftart zwei Zeichen mit demselben Glyph zeichnet. Version 3 behebt das und fügt drei Dinge hinzu:

  • Abdeckung. Jeder Buchstabe und jede Ziffer, die jede Schriftart zeichnet, wird mit jedem anderen in dieser Schriftart verglichen, Han und Hangul eingeschlossen. Version 2 bezog ihre Zeichen aus einer festen Liste, sodass sie den Großteil von Yi, Canadian Aboriginal, Äthiopisch oder den indischen Schriftsystemen nie erreichte und die reinen Schriftsystem-Schriftarten und PingFang verpasste.
  • Die richtigen Schnitte. Schriftartsammlungen werden in dem Schnitt geladen, den ein Browser für Fließtext verwendet. Frühere Läufe nahmen den ersten Schnitt, der bei manchen Sammlungen fett, black oder kursiv war.
  • Überlappende Konturen, wie in variablen Schriftarten wie San Francisco, werden als Vereinigung ihrer Striche gemessen, so wie ein Leser sie sieht.
  • Zweibuchstabige Sequenzen. Jede Sequenz aus zwei ASCII-Buchstaben oder -Ziffern (3.844) wird so gesetzt, wie jede Schriftart sie setzt, mit ihrem Kerning und ihren Ligaturen, und wie ein Zeichen verglichen.
  • Die schriftartübergreifende Messlatte wird durch das obere Quartil der Seitenschriftarten festgelegt, sodass das Hinzufügen von Schriftarten zur Erhebung sie nicht verschieben kann.
  • Die Kontextprüfung (unten).

Die Zahlen von März 2026 (249.976 Einzelzeichenpaare und 2.524.275 Bigramm-Paare über 245 Schriftarten) stammten aus Messungen, die Größe und Grundlinie ignorierten. Sie sind überholt; die Dateien aus diesen Läufen bleiben in data/output/ als Referenz erhalten.

Wie es funktioniert

Glyphen messen

RaySpace wirft parallele Strahlen unter 36 Winkeln durch den Umriss jedes Glyphs, je 50 Strahlen, und zeichnet fünf Dinge pro Strahl auf: wie oft er den Umriss kreuzt, wo, unter welchem Winkel, wie weit er jedes Mal durch Tinte wandert (sein Ping, die Strichbreite entlang des Strahls) und die breiteste Lücke zwischen Strichen. Jedes Glyph wird zweimal gemessen: in seiner eigenen Box, für die Form, und in einem festen Rahmen auf der Grundlinie, sodass Größe und Position zählen. Zwei Zeichen sind in einer Schriftart gleich, wenn der Formabstand unter 0,5 und der grundlinienverankerte Abstand unter 0,2 liegt. Der Vergleich läuft in Rust (native/cv-pairs), auf jedem Kern.

Tool herunterladen