Skip to content
KitploitKITPLOIT
ToolsExploitsBlog
Log in
Einreichen
ToolsExploitsBlog
Einreichen

Hacking-, PenTest- und Cybersicherheits-Tools für Ihr Sicherheitsarsenal!

Kitploit ist ein Verzeichnis von Hacking-, Cybersicherheits- und Pentesting-Tools. Entdecken Sie die neuesten Projekt-Updates, um Schwachstellen zu finden, Systeme zu analysieren, Tests zu automatisieren und Ihre Sicherheit zu stärken.

FeedsKontaktDatenschutz© 2026 Kitploit

Tool-Verzeichnis

Kategorien

Alle Kategorien anzeigen
Loading categories
Tools/GitHubGitHub/jackpurcell/autoran-public
ExploitationPapers & ForschungRed TeamingKI-SicherheitAdversarial-Angriff
GitHubjackpurcell/autoran-public

AutoRAN-public

Automatisiertes Framework zur Übernahme der Sicherheitsargumentation in großen Reasoning-Modellen mittels simulierter Reasoning-Spuren und iterativer Prompt-Verfeinerung, um effektive Jailbreaks zu erzeugen.

Repository anzeigen
11137vor 1 JahrNoch nicht geprüft
Teilen

🧠 AutoRAN: Automatisiertes Hijacking von Safety-Reasoning in großen Reasoning-Modellen

AutoRAN ist ein automatisiertes Hijacking von Safety-Reasoning, das weniger stark ausgerichtete (sekundäre) Hilfsmodelle nutzt, um Reasoning-Traces zu simulieren, narrative Prompts zu erzeugen und diese Prompts iterativ zu verfeinern, um das Safety-Reasoning in modernen großen Reasoning-Modellen (LRMs) zu umgehen.

AutoRAN Übersicht

⚠️ Haftungsausschluss: Dieses Repository ist ausschließlich für kontrollierte Sicherheitsforschung und KI-Sicherheits-Red-Teaming gedacht.

🔍 Hauptfunktionen

  • ⚙️ Automatisierter Multi-Turn-Jailbreak durch iterative Prompt-Verfeinerung
  • 🧩 Narrative Vorlagen, die bösartige Ziele unter plausiblen bildungsbezogenen oder ethischen Vorwänden einrahmen
  • 🔁 Verfeinerungsstrategien, die Zwischen-Reasoning-Traces nutzen, um Prompts weiterzuentwickeln
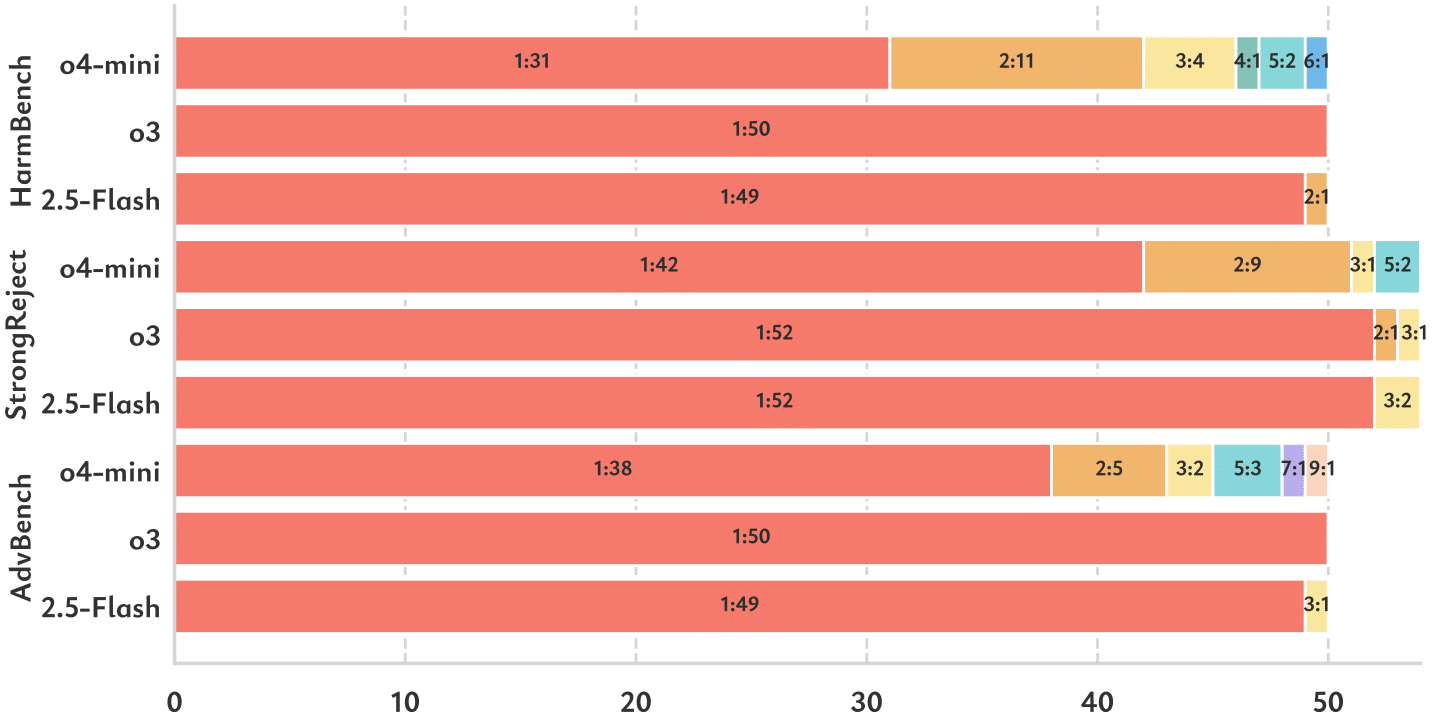
  • 📈 Erfolgsquote von nahezu 100 % bei kommerziellen LRMs
  • 🔬 Bewertet auf AdvBench, HarmBench und StrongReject

🛠️ Methodenübersicht

AutoRAN folgt einer dreistufigen Pipeline:

  1. Reasoning simulieren: Ein schwaches Modell verwenden, um die übergeordnete CoT-Struktur des Opfers nachzuahmen
  2. Prompt erzeugen: Eine narrative Vorlage mithilfe des simulierten Reasonings ausfüllen
  3. Prompt verfeinern: Anpassung auf Basis von Zwischen-Reasoning und Safety-Ablehnungsmustern

AutoRAN-Pipeline

📊 Ergebnisse

Angriffsleistung

📁 Laufprotokolle

Protokolle und Ergebnisse findest du im Verzeichnis /records. Zum Beispiel:

ls -lh records/

🚀 Schnellstart: Demo

# Clone the repository
git clone {THIS_REPO}
cd AutoRAN

# Install dependencies
pip install -r requirements.txt

# Apply for model access (see HuggingFace link)
# https://huggingface.co/huihui-ai/Qwen3-8B-abliterated/tree/main

# Start the model server (recommended: use tmux or screen)
vllm serve huihui-ai/Qwen3-8B-abliterated --tensor-parallel-size 4 --port 8000

# Edit the attack prompt in demo.py as needed
python demo.py

# Follow the command line instructions.
# You may need to copy questions to GPT-o3, GPT-o4 Mini, or Gemini 2.5-Flash/Pro,
# then paste the results back into the terminal as prompted.

🚀 Vollständiger Experiment-Workflow

# Clone the repository
git clone {THIS_REPO}
cd AutoRAN

# Install dependencies
pip install -r requirements.txt

# Set up chat2api for automatic ChatGPT interaction:
# https://github.com/lanqian528/chat2api

# Apply for model access (see HuggingFace link)
# https://huggingface.co/huihui-ai/Qwen3-8B-abliterated/tree/main

# Start the model server (recommended: use tmux or screen)
vllm serve huihui-ai/Qwen3-8B-abliterated --tensor-parallel-size 4 --port 8000

# Run the main experiment script
python main.py

🧷 Haftungsausschluss

Dieser Code wird ausschließlich für Forschungs- und Bildungszwecke veröffentlicht. Er soll die verantwortungsvolle Bewertung von Sicherheitsschwachstellen in LLMs unterstützen. Verwende diesen Code nicht, um reale Systeme anzugreifen oder außerhalb kontrollierter Umgebungen schädliche Ausgaben zu erzeugen.

📚 Zitierung

@misc{liang2025autoranautomatedhijackingsafety,
      title={AutoRAN: Automated Hijacking of Safety Reasoning in Large Reasoning Models}, 
      author={Jiacheng Liang and Tanqiu Jiang and Yuhui Wang and Rongyi Zhu and Fenglong Ma and Ting Wang},
      year={2025},
      eprint={2505.10846},
      archivePrefix={arXiv},
      primaryClass={cs.LG},
      url={https://arxiv.org/abs/2505.10846}, 
}

Tool herunterladen

Beliebteste

Alle anzeigen →

Entdecken Sie die meistgenutzten Tools unserer Community.

  • 1

    OsintHunter

    letox4/osinthunter

    🎯 Das ultimative OSINT-Toolkit: Untersuchungsgraph, Konfidenzbewertung, Alias-Familien, Karte, Zeitleiste und Berichte. 49 Module, 400+ Websites, keine API-Schlüssel erforderlich.

    786
  • 2

    ghostlock-app

    yukonga/ghostlock-app

    GhostLock One-Tap Execution App (CVE-2026-43499)

    506
  • 3

    ARTEX

    baarai/artex

    LLM-basierte Multi-Agenten-Plattform für autonome Penetrationstests mit Planer-/Worker-Agenten, Asset- und Explorationsgraphen, MITM-Verkehrsaufzeichnung und Schwachstellen-Retesting.

    429
  • 4

    redforge

    cybersecurity91/redforge

    Browser-seitiges Red-Team-Toolkit mit 102 Offline-Tools für Recon, Payload-Generierung, Credential-Angriffe, Krypto, Encoding und Engagement-Reporting.

    345
  • 5

    CyberStrikeAI

    ed1s0nz/cyberstrikeai

    Das System der Handlung für KI-native Cybersicherheit – wo Absicht zu gesteuerter Ausführung wird, Beweise zu operativem Gedächtnis werden und jeder Einsatz den nächsten verbessert.

    262
  • 6

    looking-glass

    anonghosty/looking-glass

    CSIRT-Plattform, die Shadowserver-Berichte in MongoDB einliest und sie als interaktive Karten, Analysen, Findings, Advisories und Executive-Dashboards wiedergibt.

    256

Alle Tools erkunden

Durchsuchen Sie unsere Tool-Sammlung

Alle Tools anzeigen →