 iqsec-lab/freemoca
Speicherfreies kontinuierliches Lernframework zur Malware-Klassifizierung mittels modenverbindungsbasierter Interpolation. Unterstützt klasseninkrementelle und domäneninkrementelle Szenarien auf den Datensätzen EMBER und Androzoo.

[!NOTE] Dies ist die offizielle Implementierung des Papers Continual Learning Trajectory as Memory for Replay-Free Consolidation in Malicious Code Analysis.
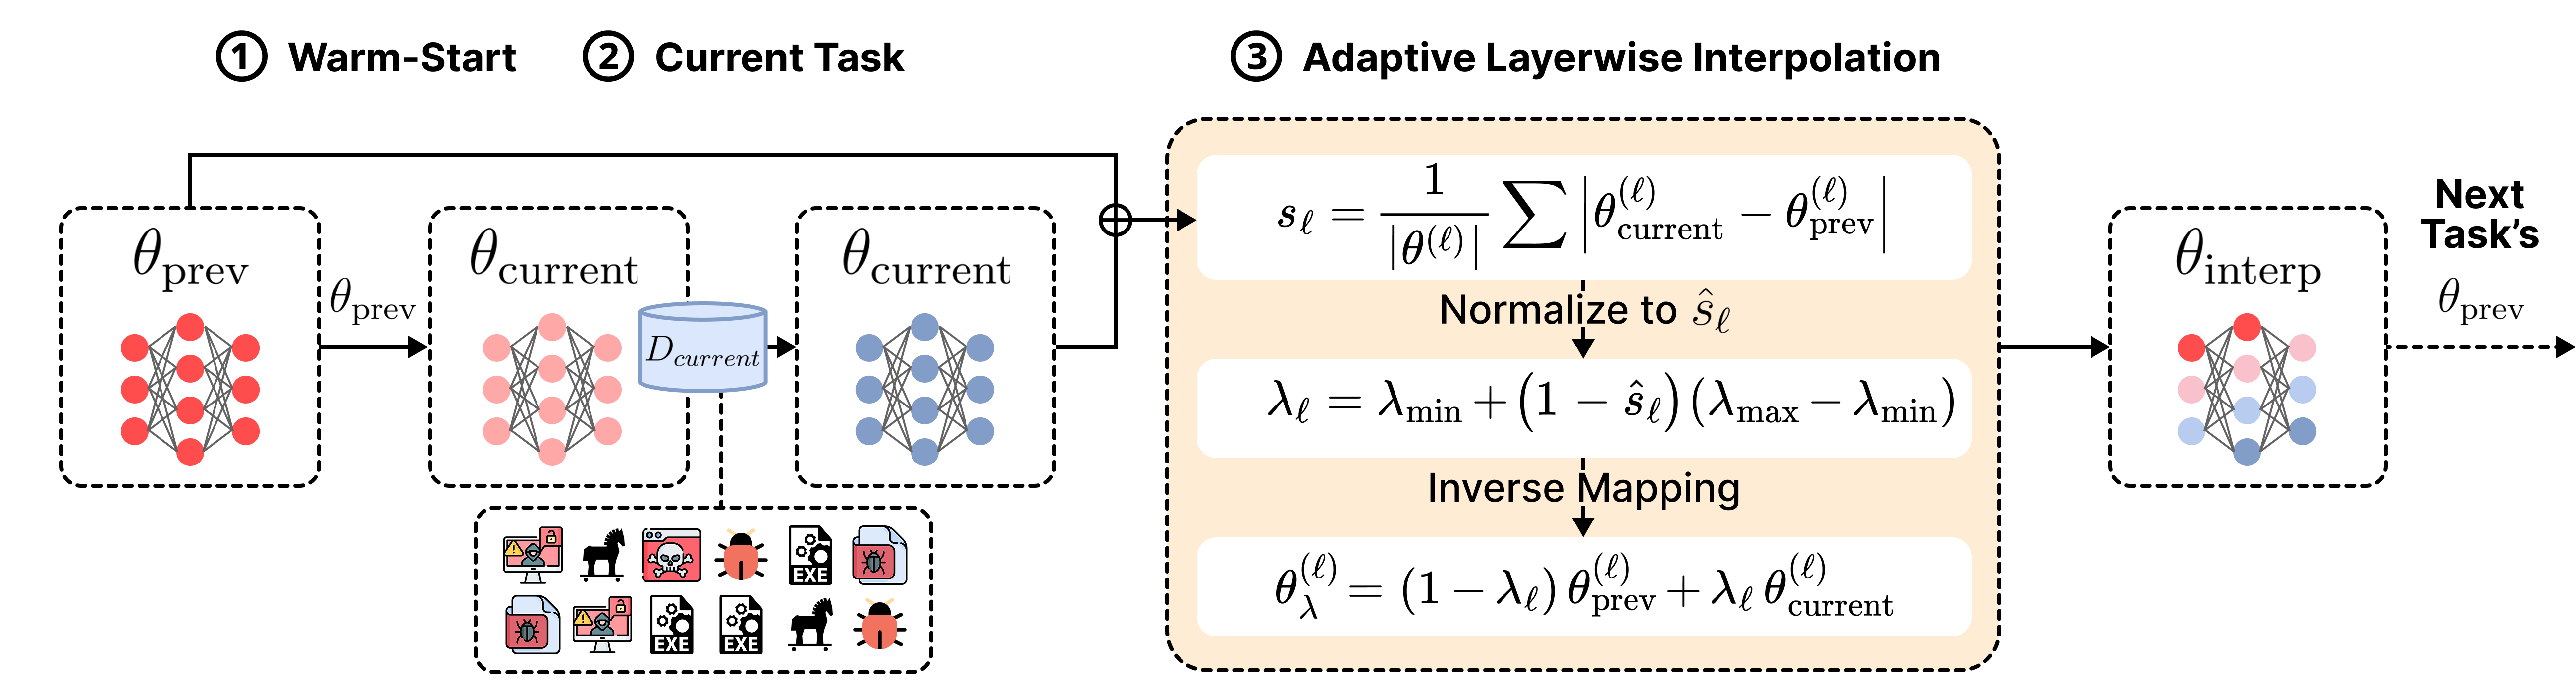
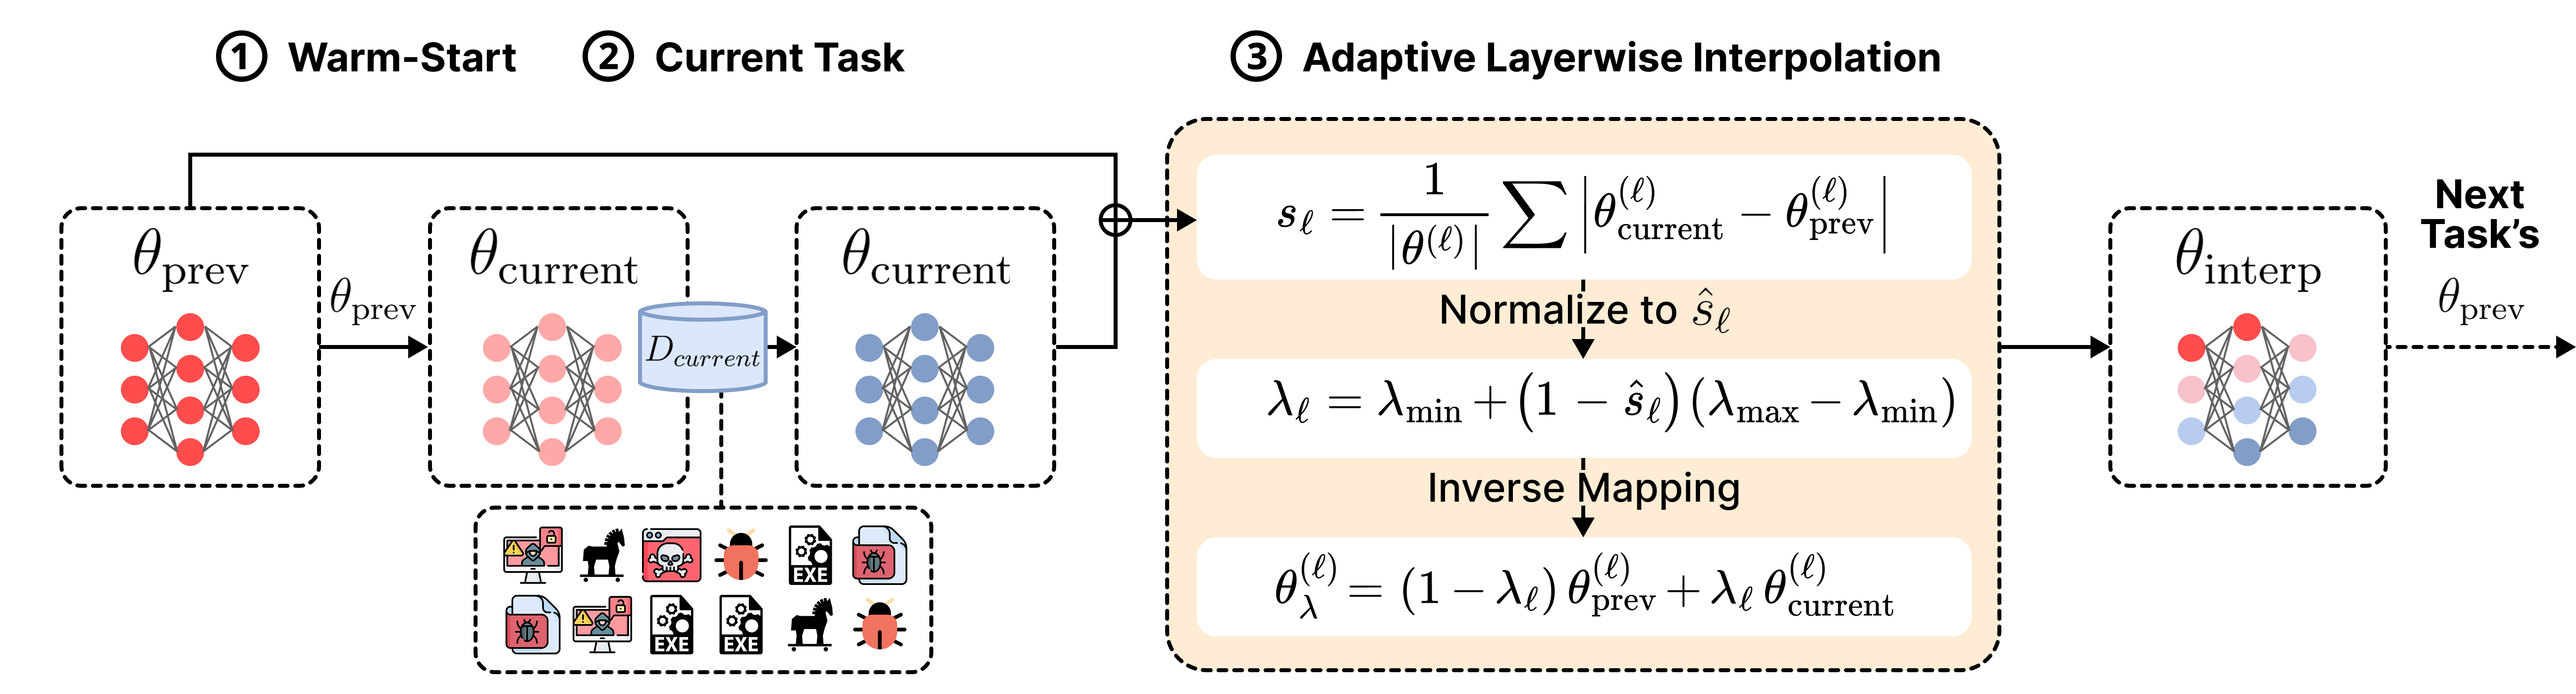
FreeMOCA arbeitet nach folgendem Prozess:
Der gesamte Prozess konstruiert eine Kette verbundener Lösungen, die auf einer Mannigfaltigkeit mit geringem Verlust liegen, und reduziert katastrophales Vergessen erheblich.
FreeMOCA wurde mit zwei großen Malware-Datensätzen evaluiert, EMBER und Androzoo. Datenquellen:
Laden Sie den Datensatz herunter und richten Sie ihn im folgenden Verzeichnis ein:
FreeMOCA/data/
├── AZ_Class
│   ├── AZ_Class_Test.npz
│   └── AZ_Class_Train.npz
│
├── AZ_Domain
│   ├── 2008_Domain_AZ_Test_Transfo...
│   ├── 2008_Domain_AZ_Train_Transfo...
│   ├── 2009_Domain_AZ_Test_Transfo...
│   └── ...
│
├── EMBER_Class
│   ├── XY_test.npz
│   └── XY_train.npz
│
└── EMBER_Domain
    ├── 2018-01
    ├── 2018-02
    ├── 2018-03
    └── ...
Dieses Repository unterstützt zwei Szenarien des kontinuierlichen Lernens:
Führen Sie folgenden Befehl aus für die
conda create -n freemoca python=3.9
conda activate freemoca
pip install -r requirements.txt
# EMBER Class-IL
cd ./FreeMOCA_Class/EMBER_Class
CUDA_VISIBLE_DEVICES=0 python main.py --train_data /path/to/data --test_data /path/to/data
# AZ Class-IL
cd ./FreeMOCA_Class/AZ_Class
CUDA_VISIBLE_DEVICES=0 python main.py --train_data /path/to/data --test_data /path/to/data
# EMBER Domain-IL
cd ./FreeMOCA_Domain/EMBER_Domain
CUDA_VISIBLE_DEVICES=0 python main.py --data_root /path/to/data/directory
# AZ Domain-IL
cd ./FreeMOCA_Domain/AZ_Domain
CUDA_VISIBLE_DEVICES=0 python main.py --data_root /path/to/data/directory
Für eine detailliertere Einrichtung der Hyperparameter sehen Sie sich Anhang A. Häufige Argumente für FreeMOCA an.
Um die Hyperparameter oder experimentellen Einstellungen anzupassen, verwenden Sie die folgenden Argumente:
| Argument | Beschreibung |
|---|---|
--init_classes | Anzahl der Klassen bei Aufgabe 0 |
--epochs | Epochen pro Aufgabe |
--batchsize | Batch-Größe |
--lr | Lernrate |
--momentum | SGD-Momentum |
--weight_decay | Weight Decay |
--lambda_min | Minimales Interpolationsgewicht |
--lambda_max | Maximales Interpolationsgewicht |
Um die Standardeinstellung der Argumente zu ändern, sehen Sie sich die Datei arguments.py an.
Unser Repository unterstützt Experimente mit den folgenden Standard-Baselines:
Sie können es mit folgendem Befehl ausführen:
cd /path/to/experiment/directory
CUDA_VISIBLE_DEVICES=0 python none.py --arugment_you_want
CUDA_VISIBLE_DEVICES=0 python joint.py --arugment_you_want
und folgenden früheren Arbeiten:
Sie können Baselines mit folgendem Befehl ausführen:
# CLeWI for EMBER-Class
cd ./baselines/CLeWI
CUDA_VISIBLE_DEVICES=6 python main.py --model="clewi" \
  --dataset="seq_ember" --n_tasks=11 \
  --lr=0.001 --buffer_size=500 --n_epochs=50 \
  --seed=42 --optim_wd=0.0 --optim_mom=0.0 \
  --batch_size=512 --sub_dataset="ember"

# CLeWI for AZ-Class
cd ./baselines/CLeWI
CUDA_VISIBLE_DEVICES=6 python main.py --model="clewi" \
  --dataset="seq_ember" --n_tasks=11 \
  --lr=0.001 --buffer_size=500 --n_epochs=50 \
  --seed=42 --optim_wd=0.0 --optim_mom=0.0 \
  --batch_size=512 --sub_dataset="az"
# WSC for EMBER-Class
cd ./baselines/WSC
MODEL_NAME=wsc_20_ember
python main.py --config=./exps/wsc_memory/$MODEL_NAME.json
# WSC for AZ-Class
cd ./baselines/WSC
MODEL_NAME=wsc_20_az
python main.py --config=./exps/wsc_memory/$MODEL_NAME.json
# GR for EMBER-Class
cd ./baselines/GR_EWC_LwF_iCaRL_EMBER
CUDA_VISIBLE_DEVICES=0 python main.py --data_set=EMBER --tasks=11 --replay=generative --metrics --logger_file gr --scenario=class

# GR for AZ-Class
cd ./baselines/GR_EWC_LwF_iCaRL_AZ
CUDA_VISIBLE_DEVICES=0 python main.py --data_set=ANDROZOO --tasks=11 --replay=generative --metrics --logger_file gr --scenario=class
# EWC for EMBER-Class
cd ./baselines/GR_EWC_LwF_iCaRL_EMBER
CUDA_VISIBLE_DEVICES=0 python main.py --data_set=EMBER --tasks=11 --ewc --lambda=50 --metrics --logger_file ewc --scenario=class
