 d-diaa/swordstamp
Semantisches Wasserzeichen mit ordnungsrobuster Erkennung über Teilsatz-Einheiten

SwordStamp ergänzt ordnungsrobuste Erkennung und semantische Span-Einheiten zu einbettungsbasierten semantischen Wasserzeichen. Dieses Artefakt enthält die exakte Konfiguration aus dem Paper, den Code für Generierung und Erkennung, die unveränderte Angriffssuite, die Qualitätsbewertung sowie die deterministische Ergebnis-Extraktion und -Visualisierung.
Paper: Semantic Watermarking with Order-Robust Detection over Sub-sentence Units (arXiv:2608.27666)
Bei einer Falsch-Positiv-Rate von 5 % und einer Anforderung von 90 % Inhaltserhalt erzielt der schemespezifische Embedding-Displacement-Angriff (EDA-S):
| Wasserzeichen | Erfolgsrate des EDA-S-Angriffs |
|---|---|
| SemStamp | 47,9 % |
| k-SemStamp | 33,3 % |
| PMark | 46,1 % |
| SAMark | 32,6 % |
| SwordStamp | 18,7 % |
| k-SwordStamp | 10,8 % |
Im Vergleich zu ihren veröffentlichten Baselines reduzieren SwordStamp und k-SwordStamp den EDA-S-Erfolg um 29,2 bzw. 22,5 Prozentpunkte, bei Kosten für die saubere Wiedergabetreue von 1,8 bzw. 4,4 Punkten. Ihre Erkennungsraten bei sauberem Text betragen 94,9 % bzw. 97,0 %. Im stärkeren Stresstest EDA-D mit Detektorzugriff beträgt der maximale qualitätsbeschränkte Erfolg 39,7 % bei k-SwordStamp gegenüber 65,5 % bei k-SemStamp.
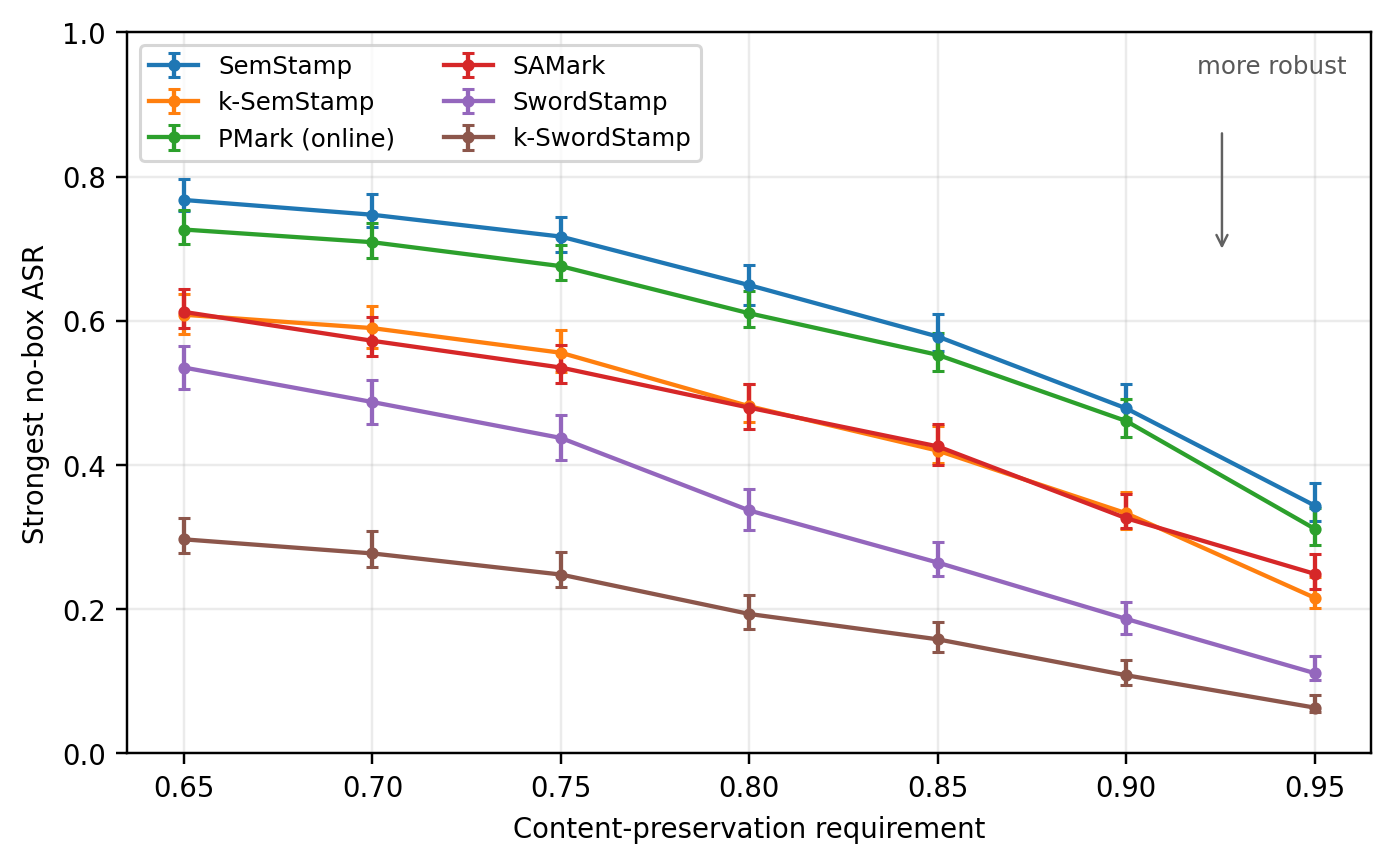
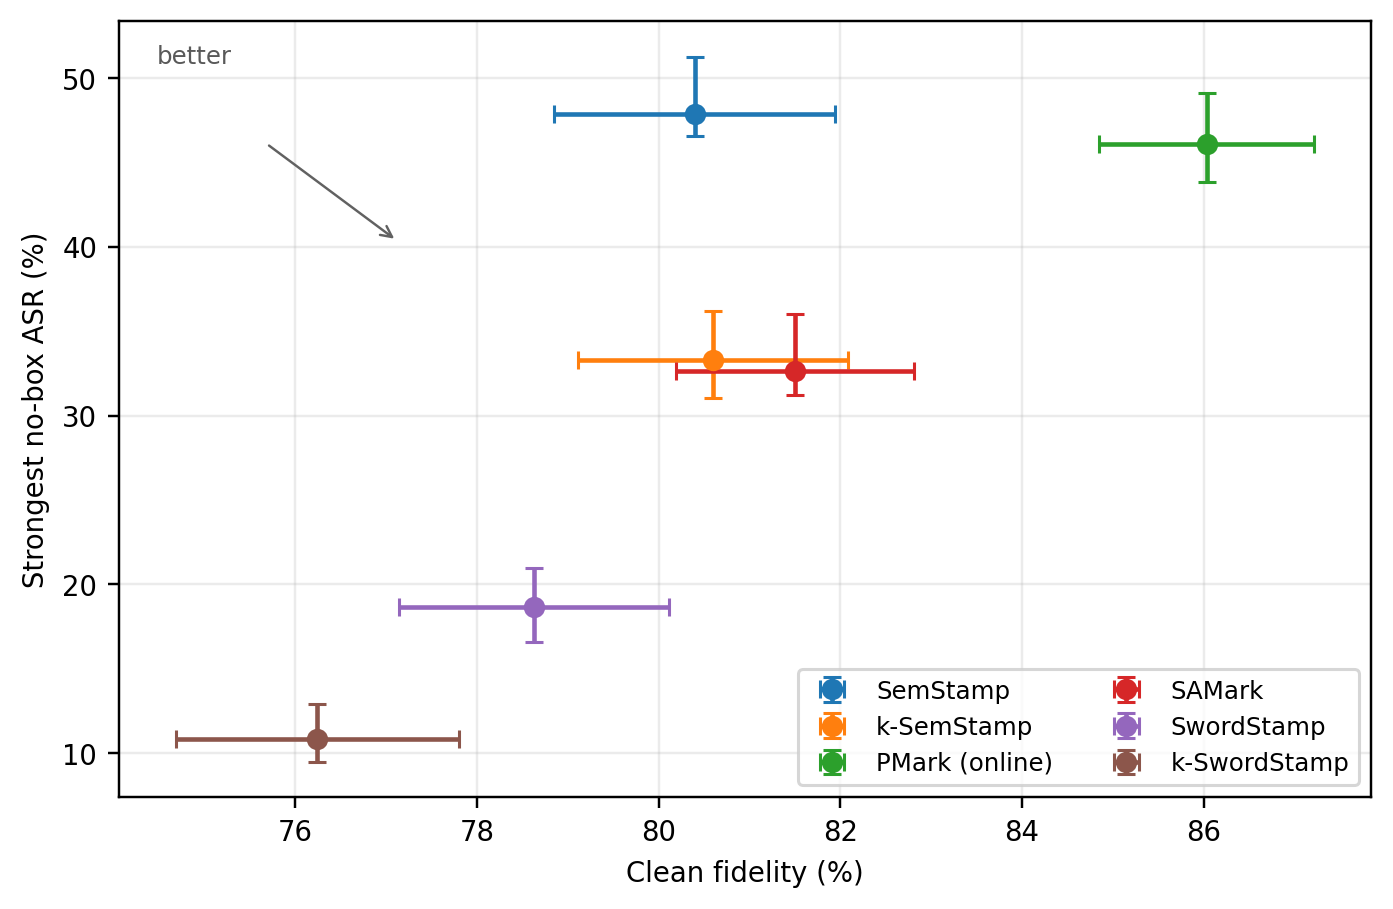
Diese Ergebnisse umfassen englische Nachrichtenfortsetzungen, ein Anbietermodell, zwei Anbieter-Encoder und ein EDA-Paraphrasierer-/Surrogat-Paar.
visualization verarbeitet ausschließlich das kompilierte CSV/Parquet-Bundle. Bei fehlenden Paper-Zellen schlägt es fehl, anstatt eine unvollständige Abbildung zu zeichnen.
uv sync --frozen --only-group plot --no-install-project
uv run --no-sync python -m visualization extract \
  --bundle results/paper --output results/paper
uv run --no-sync python -m visualization render \
  --bundle results/paper --output results/paper
Dies schreibt auditierbare Tabellen unter results/paper/tables/ und sieben Abbildungen im
PNG- und PDF-Format unter results/paper/figures/. Der anonyme Review-Branch enthält
das kompilierte Bundle; ein vollständiger Lauf im Release-Branch erzeugt dieselben Dateien
mit python -m visualization compile.
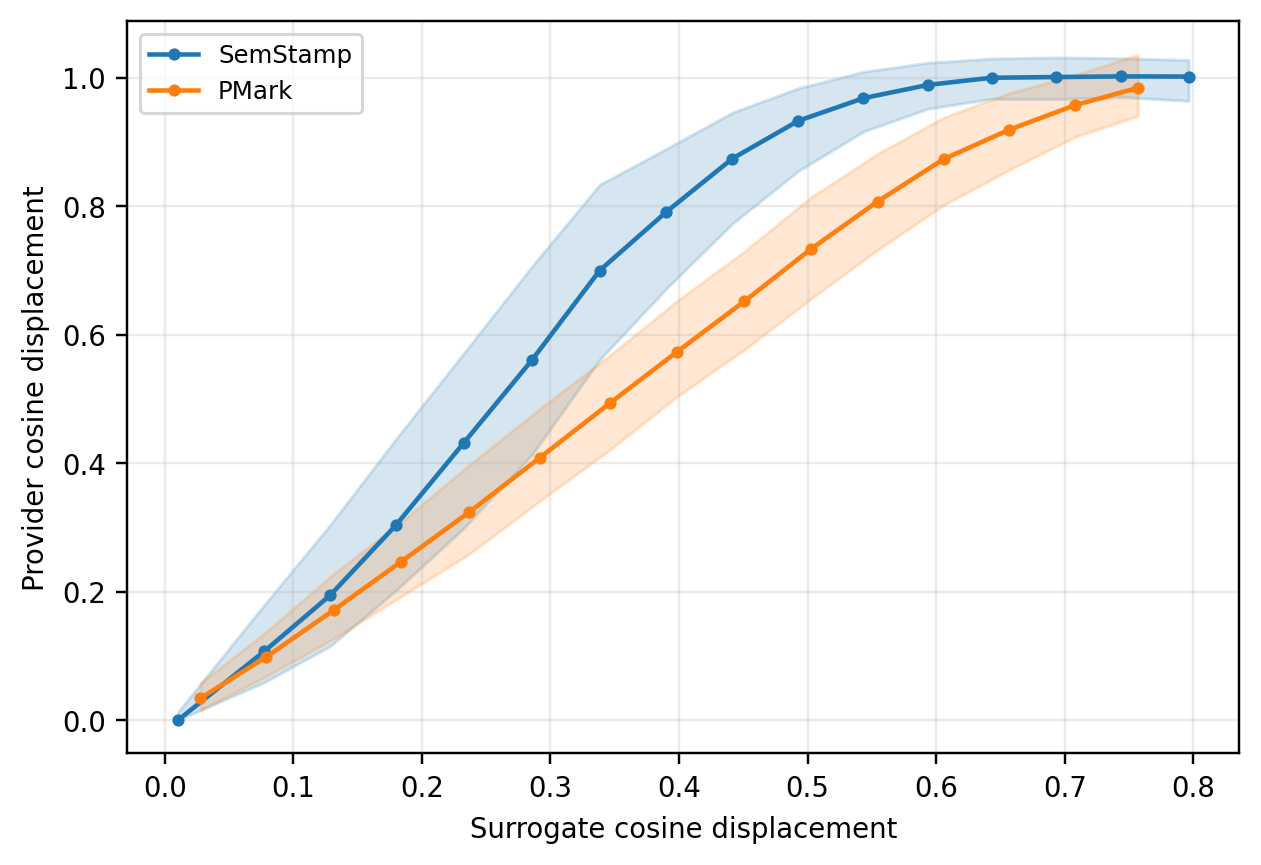
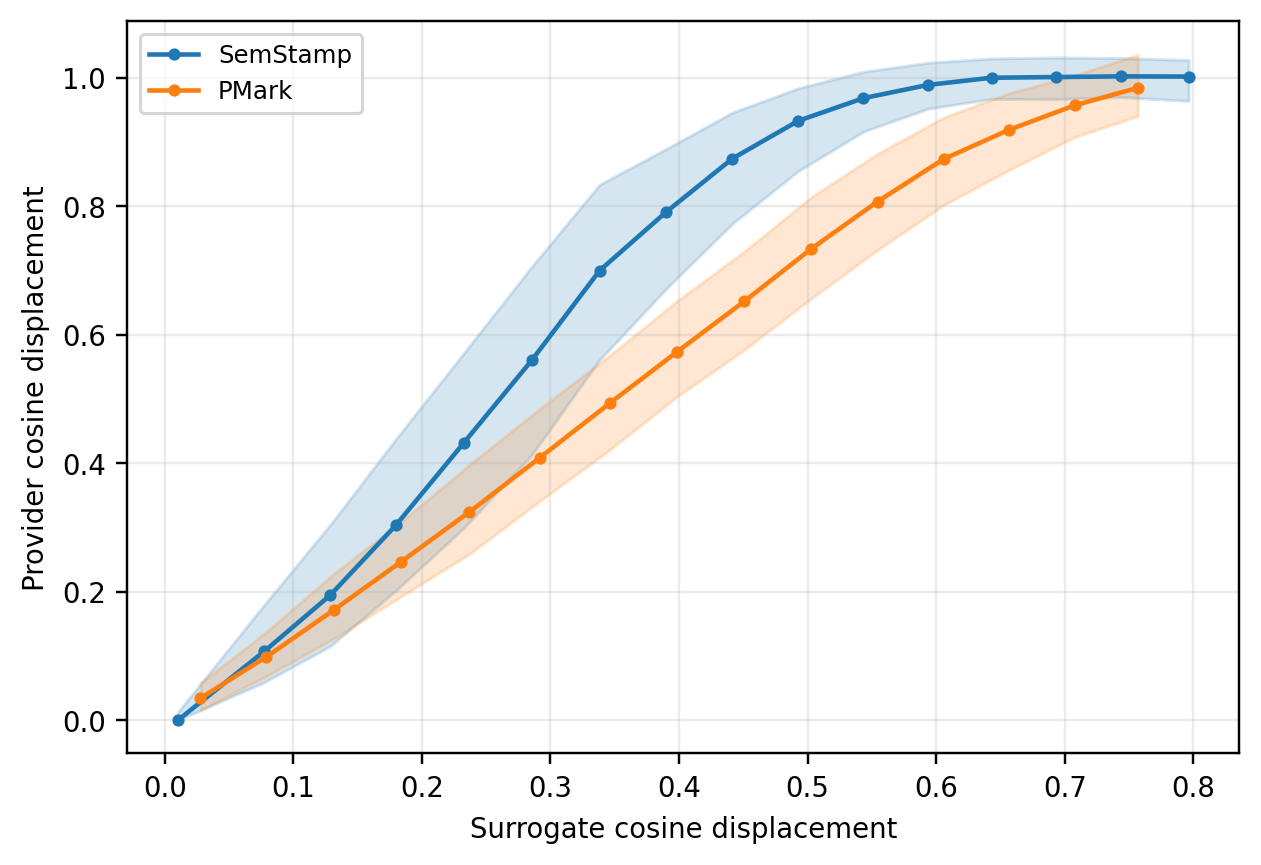
Der Embedding-Displacement-Angriff (EDA) ist ein adaptiver Ganztext-Paraphrasierungs-
Angriff. Bei jeder Ausgabeeinheit
sampelt er K Fortsetzungen und behält den Kandidaten mit der größten Kosinus-
Verschiebung von seinem Quellanker unter einem Surrogat-Encoder. Da jeder
Kandidat das vollständige Rewrite-Präfix fortsetzt, kann ein Ziel gleichzeitig Inhalte umformulieren,
sie umordnen und Detektor-Einheiten aufteilen oder zusammenführen.
No-Box-EDA sieht den markierten Text und das öffentliche Watermark-Design. Es fragt weder den Detektor noch den Generator ab und erhält keinen geheimen Schlüssel, keinen Provider-Encoder oder ein Qualitäts-Orakel.
| Variante | Anker und Einheit | Konfiguration |
|---|---|---|
| EDA-P | positioneller Satz | adaptive, anchor=positional, Angreifer-Einheit sentence |
| EDA-S | öffentliches Design des Ziels | positionelle Sätze für SemStamp, k-SemStamp und PMark; Bag/Sentence für SAMark; Bag/Semspan für beide SwordStamp-Varianten |
| EDA-D | Provider-Detektor | oracle; erbt den Verteidiger-Encoder, die Partition und die Segmentierung |
Für Bag-Anchoring verwendet das Paper attack.bag_agg=min: Maximierung des Abstands vom
nächstgelegenen Quellanker. Berichtete No-Box-Läufe verwenden
Qwen/Qwen2.5-3B-Instruct, BAAI/bge-base-en-v1.5,
K={1,2,4,8,16,32,64}, Temperatur 1.0, Top-p 0.95, höchstens 96 Tokens pro
Kandidat und höchstens 512 Rewrite-Tokens.
Andere Watermark-Designer können EDA direkt aufrufen:
from attacks.paraphrasing.adaptive import adaptive_attack_paraphrase

attacked = adaptive_attack_paraphrase(
    texts,
    base_model="Qwen/Qwen2.5-3B-Instruct",
    surrogate_model="BAAI/bge-base-en-v1.5",
    num_candidates=32,
    anchor="positional",       # EDA-P; use "bag" for an order-robust design
    bag_agg="min",
    segmentation_type="sentence",
    segmentation_backend="nltk",
)
Für den SwordStamp-bewussten EDA-S des Papers setzen Sie anchor="bag",
segmentation_type="semspan", semcut_max_words=15 und
semcut_window=5. Innerhalb dieses Repositorys ist das entsprechende CLI:
uv run python -m attacks DATA_PATH --config PRESET \
  --set attack.paraphraser=adaptive \
  --set attack.custom_model=Qwen/Qwen2.5-3B-Instruct \
  --set attack.surrogate_model=BAAI/bge-base-en-v1.5 \
  --set attack.num_candidates=32 \
  --set attack.anchor=bag --set attack.bag_agg=min \
  --set segmentation.attacker_type=semspan \
  --set segmentation.attacker_backend=nltk
DATA_PATH ist immer das Basiskorpus und PRESET identifiziert die wasserzeichenmarkierte
Zelle. Siehe attacks/README.md für alle beibehaltenen Angriffe und Konfigurationsfelder.
config/paper.py ist die einzige Quelle der Wahrheit. Für jeweils LSH und k-means
führt scripts/experiments/swordstamp.sh diese fünfstufige additive Leiter mit 64
Provider-Kandidaten aus:
Das Raster enthält nur diese zehn Zellen und eine Baseline ohne Wasserzeichen. PMark ist
nur online verfügbar; SAMark verwendet ein Flag-Muster pro Lauf. EDA-D-Budgets sind
K={4,8,16,32,64}.
Die Vergleichs-Submodule passen die öffentlichen PMark- und SAMark-Evaluierungsquellen nur an ihren Datensatz-/Ergebnisgrenzen und bei der gemeinsamen False-Positive-Kalibrierung an; die Wasserzeichen-Algorithmen bleiben unverändert.
Voraussetzungen sind Git, uv, Python 3.11, CUDA für Modellläufe, Zugriff auf die festgelegten Modellrevisionen und Scratch-Speicher.
git clone --recurse-submodules [email protected]:D-Diaa/SwordStamp.git
cd SwordStamp
bash scripts/setup.sh
uv run --frozen python scripts/check_artifact.py
Die deterministischen, disjunkten C4-Partitionen vorbereiten:
uv run --frozen python scripts/prepare_c4.py --output-dir data
Den festgelegten Scheduler installieren und konfigurieren. Der Installer gibt seine Auswirkungen auf Benutzerebene aus, bevor er etwas ändert:
bash scripts/install_gpu_scheduler.sh --print-plan
bash scripts/install_gpu_scheduler.sh --yes
gpu-scheduler init --gpus 0,1
gpu-scheduler start
Vorschau anzeigen und dann jeden physischen Shard übermitteln:
