

Krawl v2.3.0
Krawl ist ein anpassbarer, leichter, cloud-nativer Web-Täuschungsserver und Anti-Crawler, der gefälschte Webanwendungen mit offensichtlichen Schwachstellen erstellt, indem realistische, zufällig generierte Köderdaten und KI-generierte HTML-Vorlagen verwendet werden.
Krawl
Ein moderner, anpassbarer Web-Honeypot-Server, der darauf ausgelegt ist, bösartige Aktivitäten von Angreifern und Web-Crawlern durch täuschende Webseiten, gefälschte Zugangsdaten und Canary-Tokens zu erkennen und zu verfolgen.



Inhaltsverzeichnis
- Demo
- Was ist Krawl?
- Krawl-Dashboard
- Bereitstellungsmodi
- Krawl-Banlist
- Schnellstart
- Konfiguration
- Bösartige IPs sperren
- IP-Reputation
- Betrieb hinter einem Reverse Proxy oder CDN
- Metriken & Monitoring
- Zusätzliche Dokumentation
- Täuschung mithilfe von KI
- Mitwirken
Demo
Tipp: Crawle die Pfade in der robots.txt für zusätzlichen Spaß
Krawl-URL: http://demo.krawlme.com
Dashboard ansehen http://demo.krawlme.com/das_dashboard
Was ist Krawl?
Krawl ist ein Cloud-nativer Täuschungsserver, der darauf ausgelegt ist, bösartige Angreifer, Web-Crawler und automatisierte Scanner zu erkennen, zu verzögern und zu analysieren.
Er erstellt realistische gefälschte Webanwendungen, die mit leicht erreichbaren Zielen wie Admin-Panels, Konfigurationsdateien und offengelegten gefälschten Zugangsdaten gefüllt sind, um verdächtige Aktivitäten anzulocken und zu identifizieren.
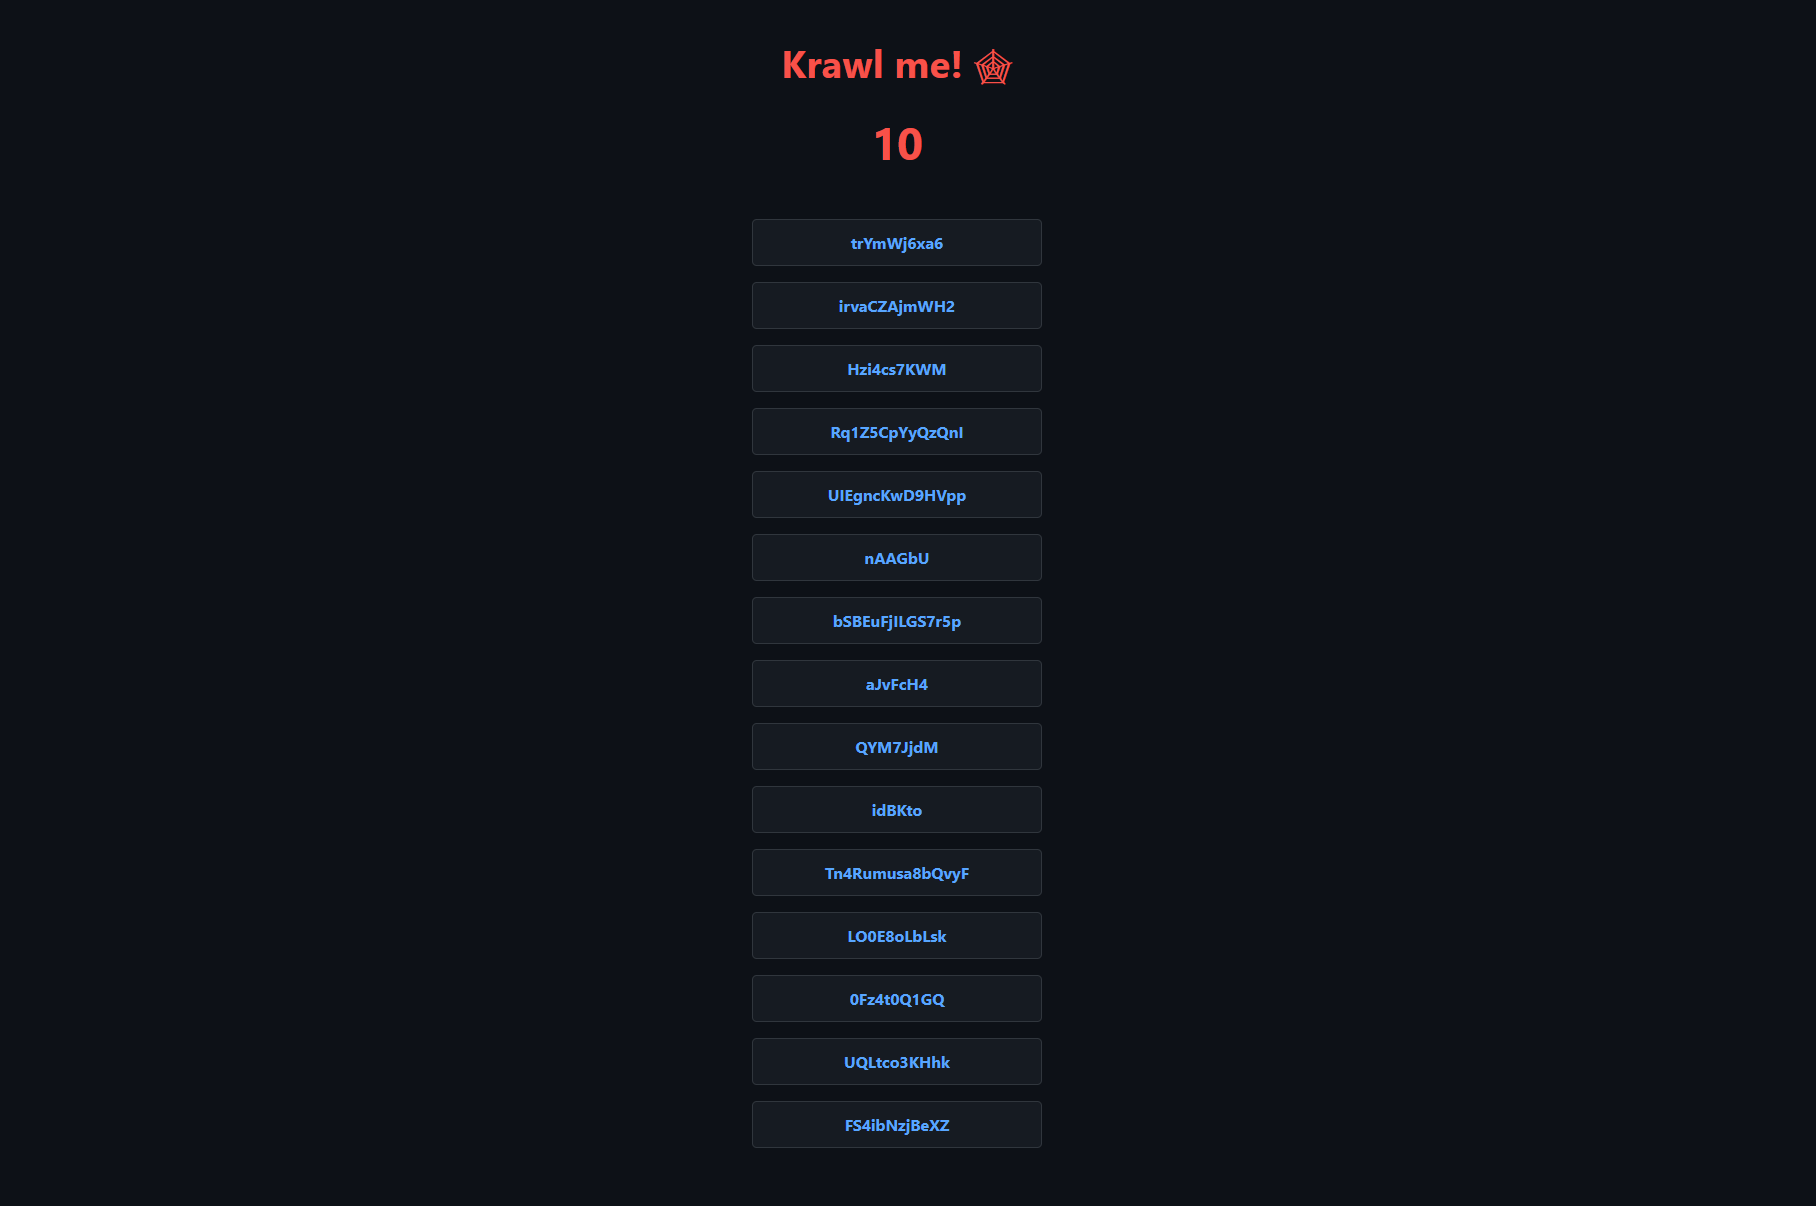
Indem Krawl Angreiferressourcen verschwendet, hilft es, bösartiges Verhalten klar von legitimen Crawlern zu unterscheiden.
Es bietet:
- KI-generierte Täuschungsseiten: Lass Angreifer dabei helfen, deine gefälschte verwundbare Angriffsfläche zu generieren
- Spider-Trap-Seiten: Unendlich viele zufällige Links, um Crawler-Ressourcen zu verschwenden, basierend auf dem spidertrap-Projekt
- Gefälschte Anmeldeseiten: WordPress, phpMyAdmin, Admin-Panels
- Honeypot-Pfade: In der robots.txt beworben, um Scanner zu fangen
- Gefälschte Zugangsdaten: Realistisch aussehende Benutzernamen, Passwörter, API-Schlüssel
- Canary-Token-Integration: Auslösen externer Alarme
- Zufällige Server-Header: Verwirren von Angriffen basierend auf Server-Header und Version
- Echtzeit-Dashboard: Überwachung verdächtiger Aktivitäten
- Anpassbare Wortlisten: Einfache JSON-basierte Konfiguration
- Zufällige Fehlerinjektion: Nachahmung des Verhaltens eines echten Servers
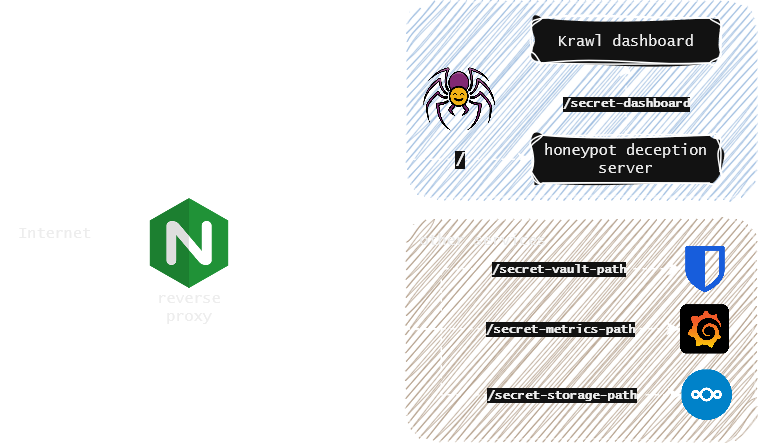
Du kannst Krawl problemlos neben deinen anderen Diensten bereitstellen, um sie mithilfe eines Reverse Proxy vor Web-Crawlern und bösartigen Nutzern zu schützen. Weitere Details findest du in der Reverse-Proxy-Dokumentation.
Krawl-Dashboard
Krawl bietet ein umfassendes Dashboard, das unter einem zufälligen geheimen Pfad, der beim Start generiert wird, oder unter einem benutzerdefinierten Pfad, der über KRAWL_DASHBOARD_SECRET_PATH konfiguriert wird, erreichbar ist. Dadurch bleibt das Dashboard vor Angreifern verborgen, die deinen Honeypot scannen.
Das Dashboard ist in sechs Tabs organisiert:
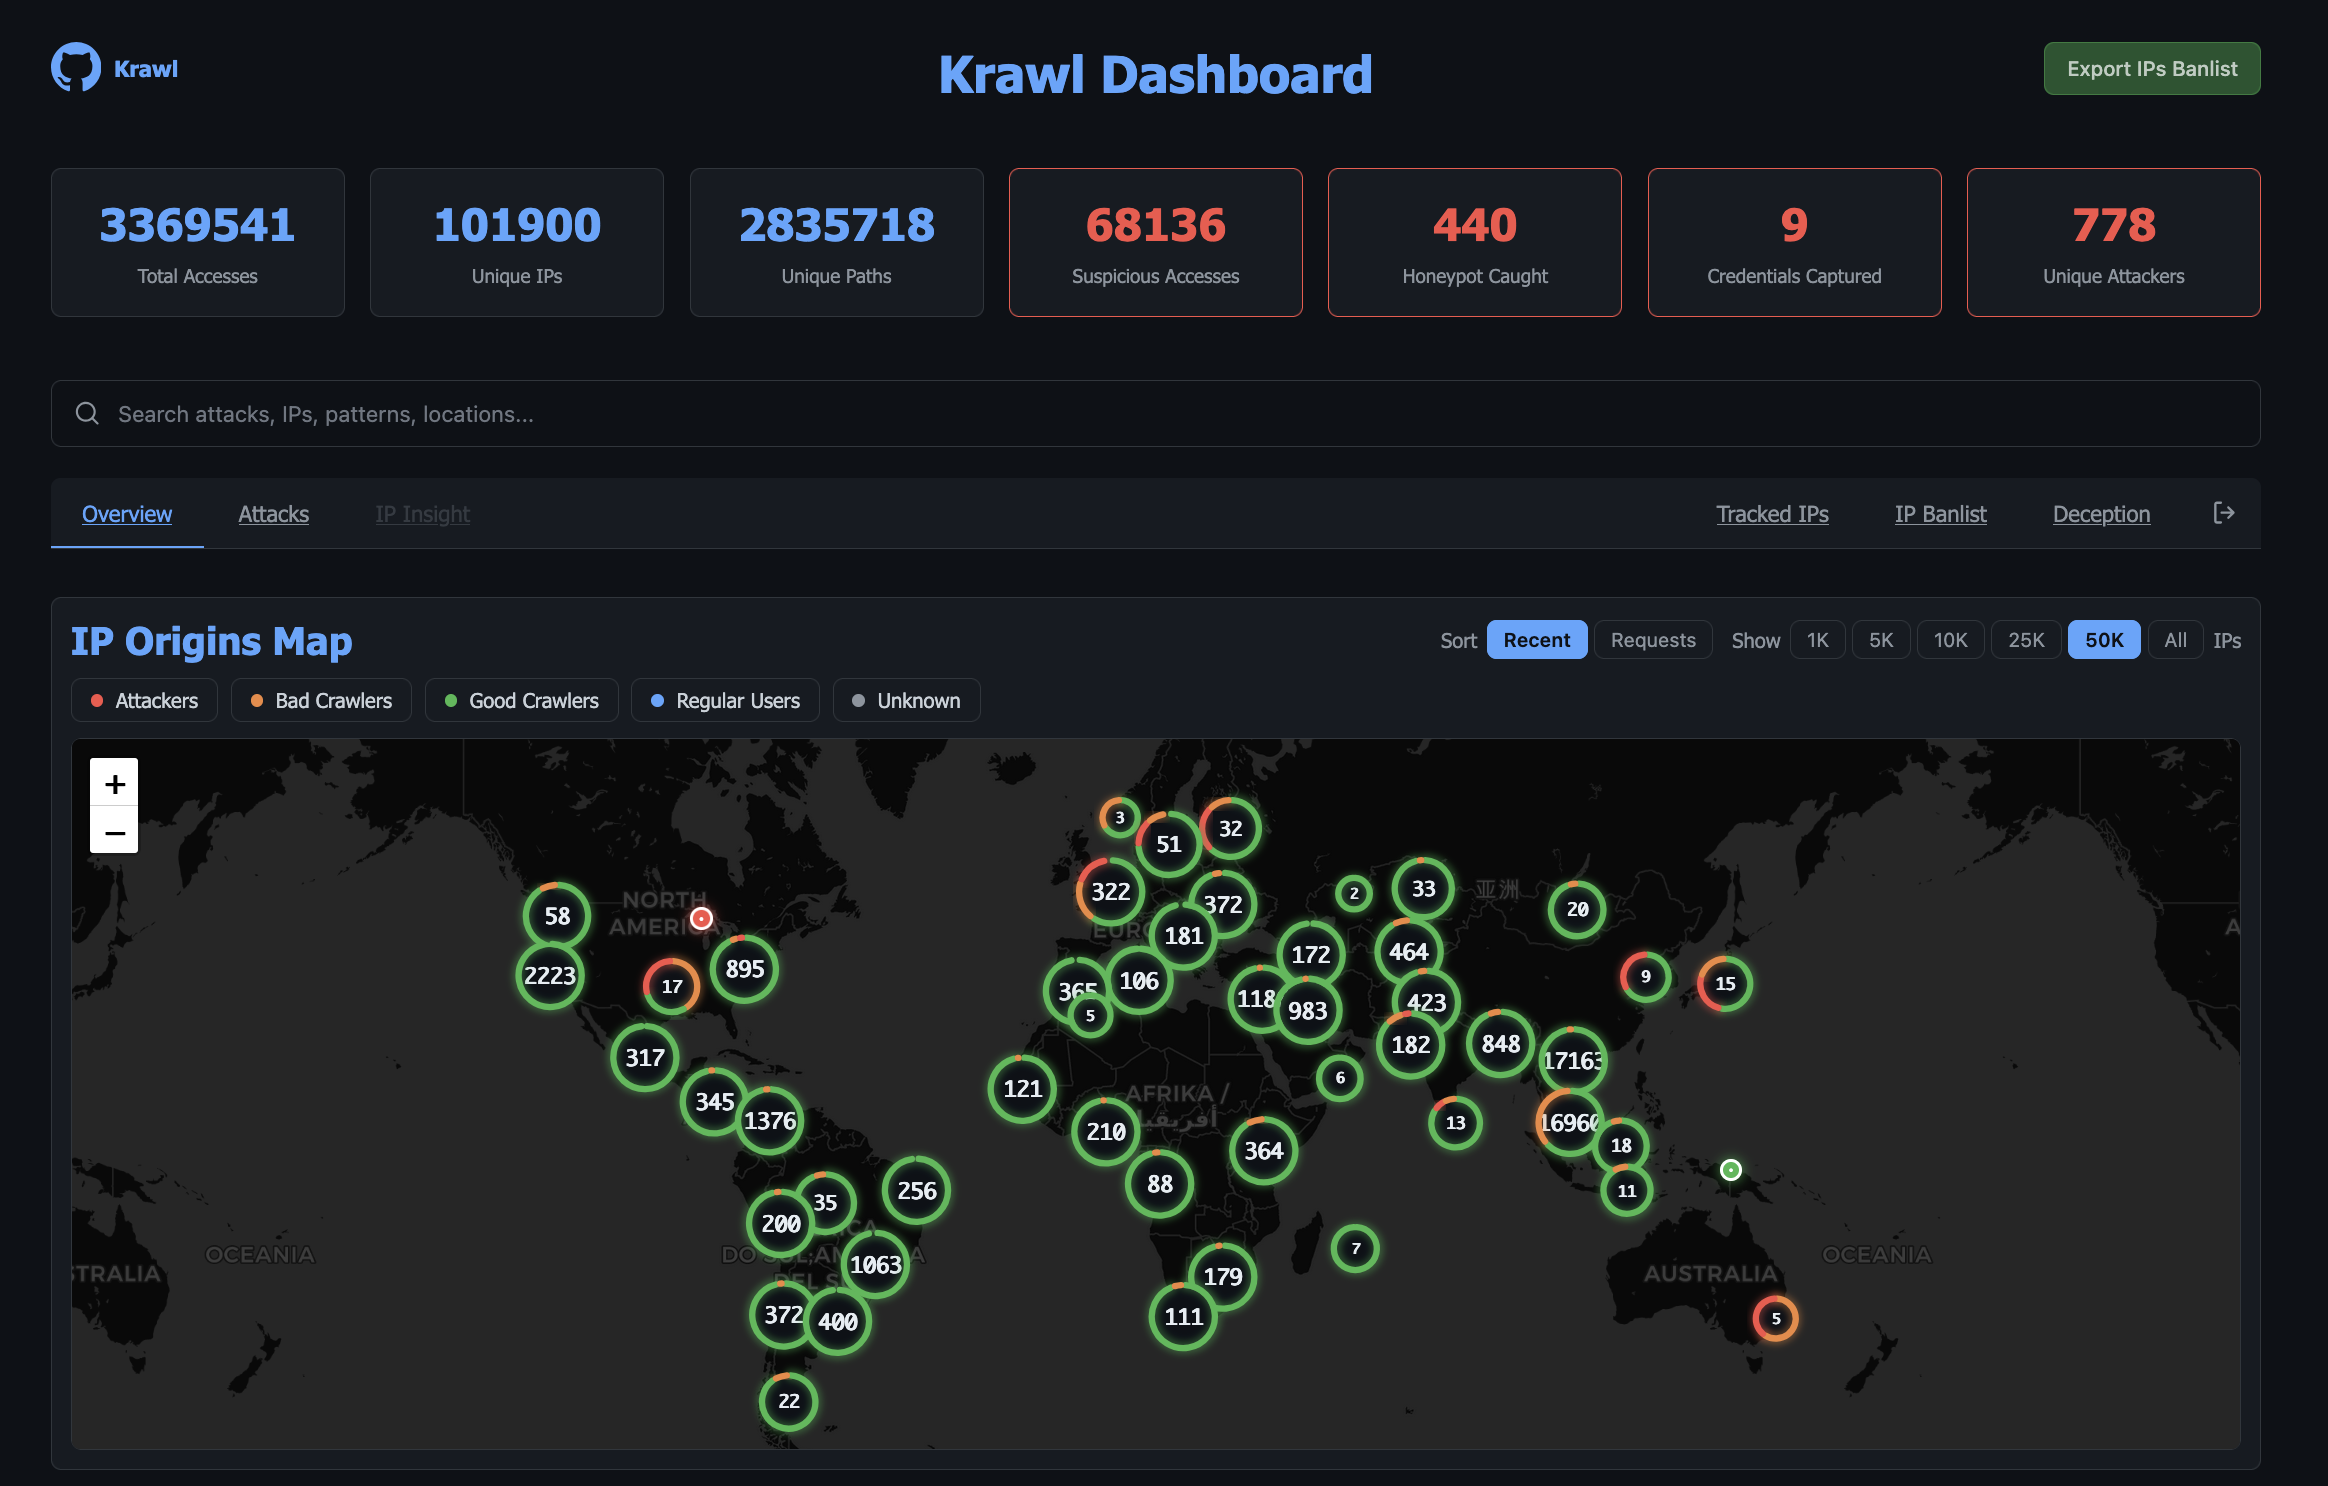
- Übersicht: Eine übergeordnete Ansicht der Angriffsaktivität: eine interaktive Karte der IP-Herkünfte, aktuelle verdächtige Anfragen und die Top-IPs, User-Agents und Pfade.
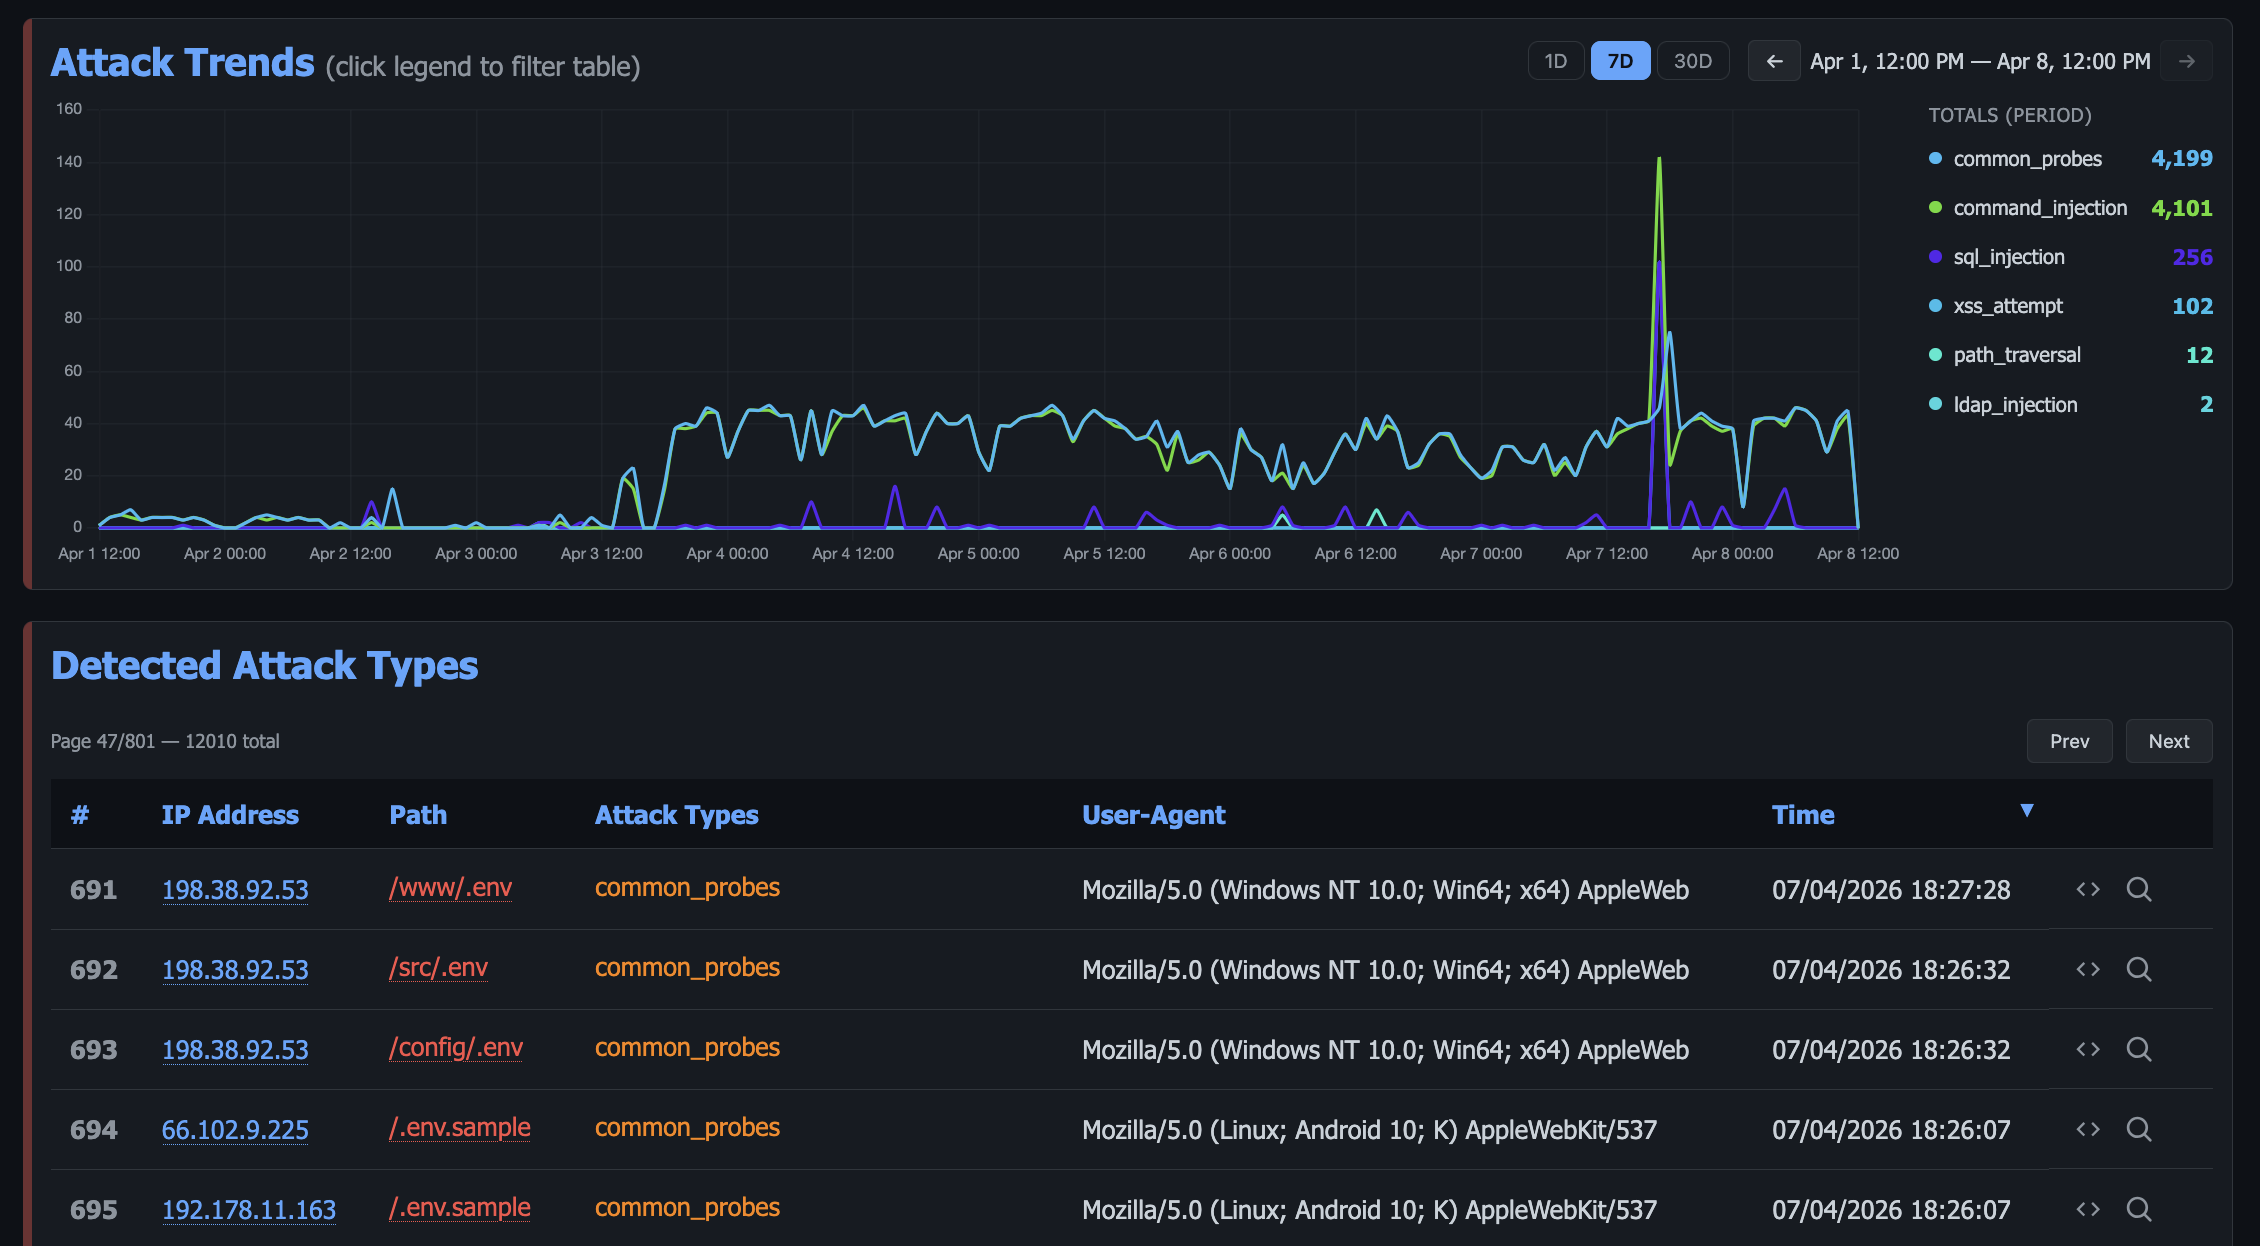
- Angriffe: Detaillierte Aufschlüsselung der erfassten Zugangsdaten, Honeypot-Auslöser und erkannten Angriffstypen (SQLi, XSS, Path Traversal usw.) mit Diagrammen und Tabellen.
-
Bedrohungen: Payloads, die durch TLSH-Fuzzy-Hashing in Kampagnen gruppiert werden, sodass eine Webshell und ihre bearbeiteten Varianten als eine Kampagne statt als unzusammenhängende Treffer gelesen werden, mit einem Index jeder erfassten Datei.
-
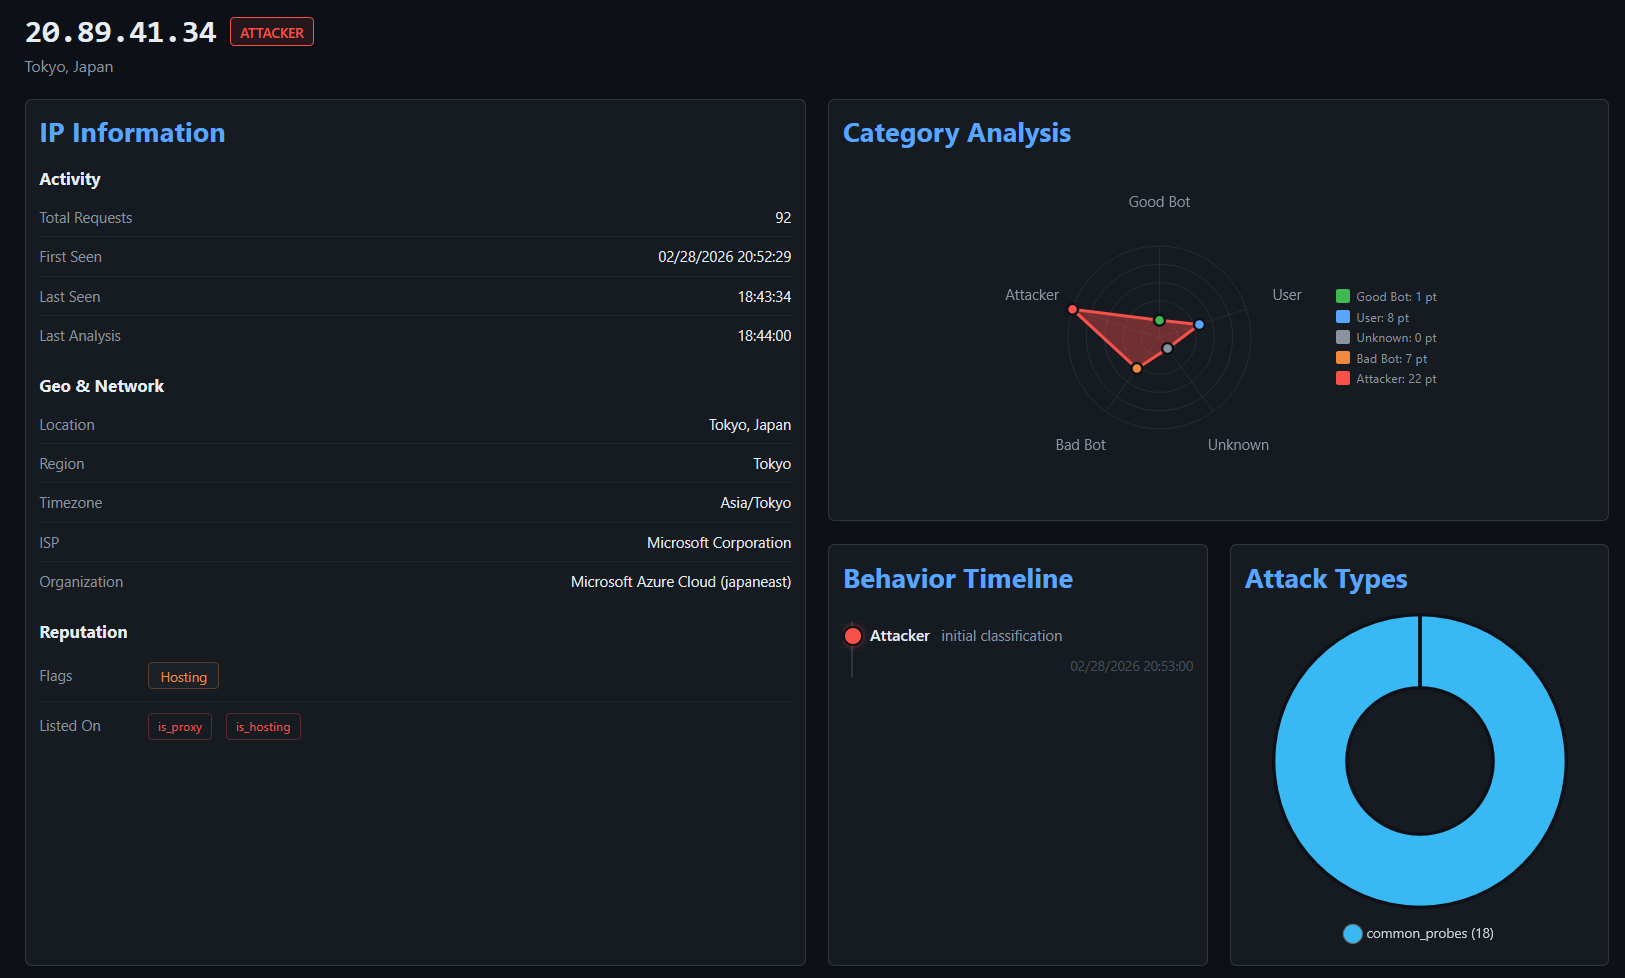
IP-Einblick: Detaillierte forensische Ansicht einer ausgewählten IP: Geolokalisierung, ISP/ASN-Informationen, Reputationsflags, Verhaltens-Zeitachse, Verteilung der Angriffstypen, Referer-Verlauf, erfasste Dateien und Zugangsdaten sowie vollständiger Zugriffsverlauf.
Darüber hinaus werden nach der Authentifizierung mit dem Dashboard-Passwort geschützte Tabs verfügbar:
- Verfolgte IPs: Führe eine Beobachtungsliste von IP-Adressen, die du im Laufe der Zeit überwachen möchtest.
- IP-Banlist: Verwalte IP-Sperren, sieh dir erkannte Angreifer an und exportiere die Banlist im Raw- oder IPTables-Format.
- Zeitlich gesperrte IPs: Überprüfe die IPs, die derzeit im Tarpit festgehalten werden, und nimm alle aus, die es nicht sein sollten.
- Täuschung: Verwalte KI-generierte Seiten, exportiere sie oder importiere neue.
- Webhooks: Leite Sperren an CloudFlare und andere Firewalls weiter.
Die Symbole in der Kopfzeile öffnen die API-Dokumentation, den Banlist-Export und ein Einstellungsfenster, das die laufende Konfiguration sowie eine Wartungsseite zum bedarfsgesteuerten Ausführen geplanter Aufgaben anzeigt.
Weitere Details findest du in der Dashboard-Dokumentation.
Bereitstellungsmodi
Krawl unterstützt zwei Bereitstellungsmodi, die über die Einstellung mode in config.yaml oder die Umgebungsvariable KRAWL_MODE gesteuert werden.
| Standalone | Skalierbar | |
|---|---|---|
| Datenbank | SQLite (WAL-Modus) | PostgreSQL |
| Cache | In-Memory-Python-Dict | Redis (mehrstufige TTL) |
| Replikate | 1 (einzelne Instanz) | 1+ (horizontale Skalierung) |
| Externe Abhängigkeiten | Keine | PostgreSQL + Redis |
| Am besten für | Entwicklung, Homelabs, <500k Anfragen | Produktion, HA, >500k Anfragen |