
 blessedrebus/krawl
Krawl ist ein anpassbarer, leichter, cloud-nativer Web-Täuschungsserver und Anti-Crawler, der gefälschte Webanwendungen mit offensichtlichen Schwachstellen erstellt, indem realistische, zufällig generierte Köderdaten und KI-generierte HTML-Vorlagen verwendet werden.

<h1 align="center">Krawl</h1>
<h3 align="center">
<a name="readme-top"></a>
<img
src="https://raw.githubusercontent.com/blessedrebus/krawl/HEAD/img/krawl-svg.svg"
height="250"
>
</h3>
<div align="center">
<p align="center">
Ein moderner, anpassbarer Web-Honeypot-Server, der darauf ausgelegt ist, bösartige Aktivitäten von Angreifern und Web-Crawlern durch täuschende Webseiten, gefälschte Zugangsdaten und Canary-Tokens zu erkennen und zu verfolgen.
</p>
<div align="center">
<a href="https://github.com/blessedrebus/krawl/blob/main/LICENSE">
<img src="https://img.shields.io/github/license/blessedrebus/krawl" alt="License">
</a>
<a href="https://github.com/blessedrebus/krawl/releases">
<img src="https://img.shields.io/github/v/release/blessedrebus/krawl" alt="Release">
</a>
</div>
<div align="center">
<a href="https://ghcr.io/blessedrebus/krawl">
<img src="https://img.shields.io/badge/ghcr.io-krawl-blue" alt="GitHub Container Registry">
</a>
<a href="https://kubernetes.io/">
<img src="https://img.shields.io/badge/kubernetes-ready-326CE5?logo=kubernetes&logoColor=white" alt="Kubernetes">
</a>
<a href="https://github.com/BlessedRebuS/Krawl/pkgs/container/krawl-chart">
<img src="https://img.shields.io/badge/helm-chart-0F1689?logo=helm&logoColor=white" alt="Helm Chart">
</a>
</div>
</div>
## Inhaltsverzeichnis
- [Demo](#demo)
- [Was ist Krawl?](#what-is-krawl)
- [Krawl-Dashboard](#krawl-dashboard)
- [Bereitstellungsmodi](#deployment-modes)
- [Krawl-Banlist](#krawl-banlist)
- [Schnellstart](#quickstart)
- [Docker Run](#docker-run)
- [Docker Compose](#docker-compose)
- [Kubernetes](#kubernetes)
- [Uvicorn (Python)](#uvicorn-python)
- [Konfiguration](#configuration)
- [config.yaml](#configuration-via-configyaml)
- [Umgebungsvariablen](#configuration-via-environmental-variables)
- [Bösartige IPs sperren](#use-krawl-to-ban-malicious-ips)
- [IP-Reputation](#ip-reputation)
- [Betrieb hinter einem Reverse Proxy oder CDN](#running-behind-a-reverse-proxy-or-cdn)
- [Metriken & Monitoring](#metrics--monitoring)
- [Zusätzliche Dokumentation](#additional-documentation)
- [Täuschung mithilfe von KI](#ai-generated-deception-pages)
- [Mitwirken](#contributing)
## Demo
Tipp: Crawle die Pfade in der `robots.txt` für zusätzlichen Spaß
### Krawl-URL: [http://demo.krawlme.com](http://demo.krawlme.com)
### Dashboard ansehen [http://demo.krawlme.com/das_dashboard](http://demo.krawlme.com/das_dashboard)
## Was ist Krawl?
**Krawl** ist ein Cloud-nativer Täuschungsserver, der darauf ausgelegt ist, bösartige Angreifer, Web-Crawler und automatisierte Scanner zu erkennen, zu verzögern und zu analysieren.
Er erstellt realistische gefälschte Webanwendungen, die mit leicht erreichbaren Zielen wie Admin-Panels, Konfigurationsdateien und offengelegten gefälschten Zugangsdaten gefüllt sind, um verdächtige Aktivitäten anzulocken und zu identifizieren.
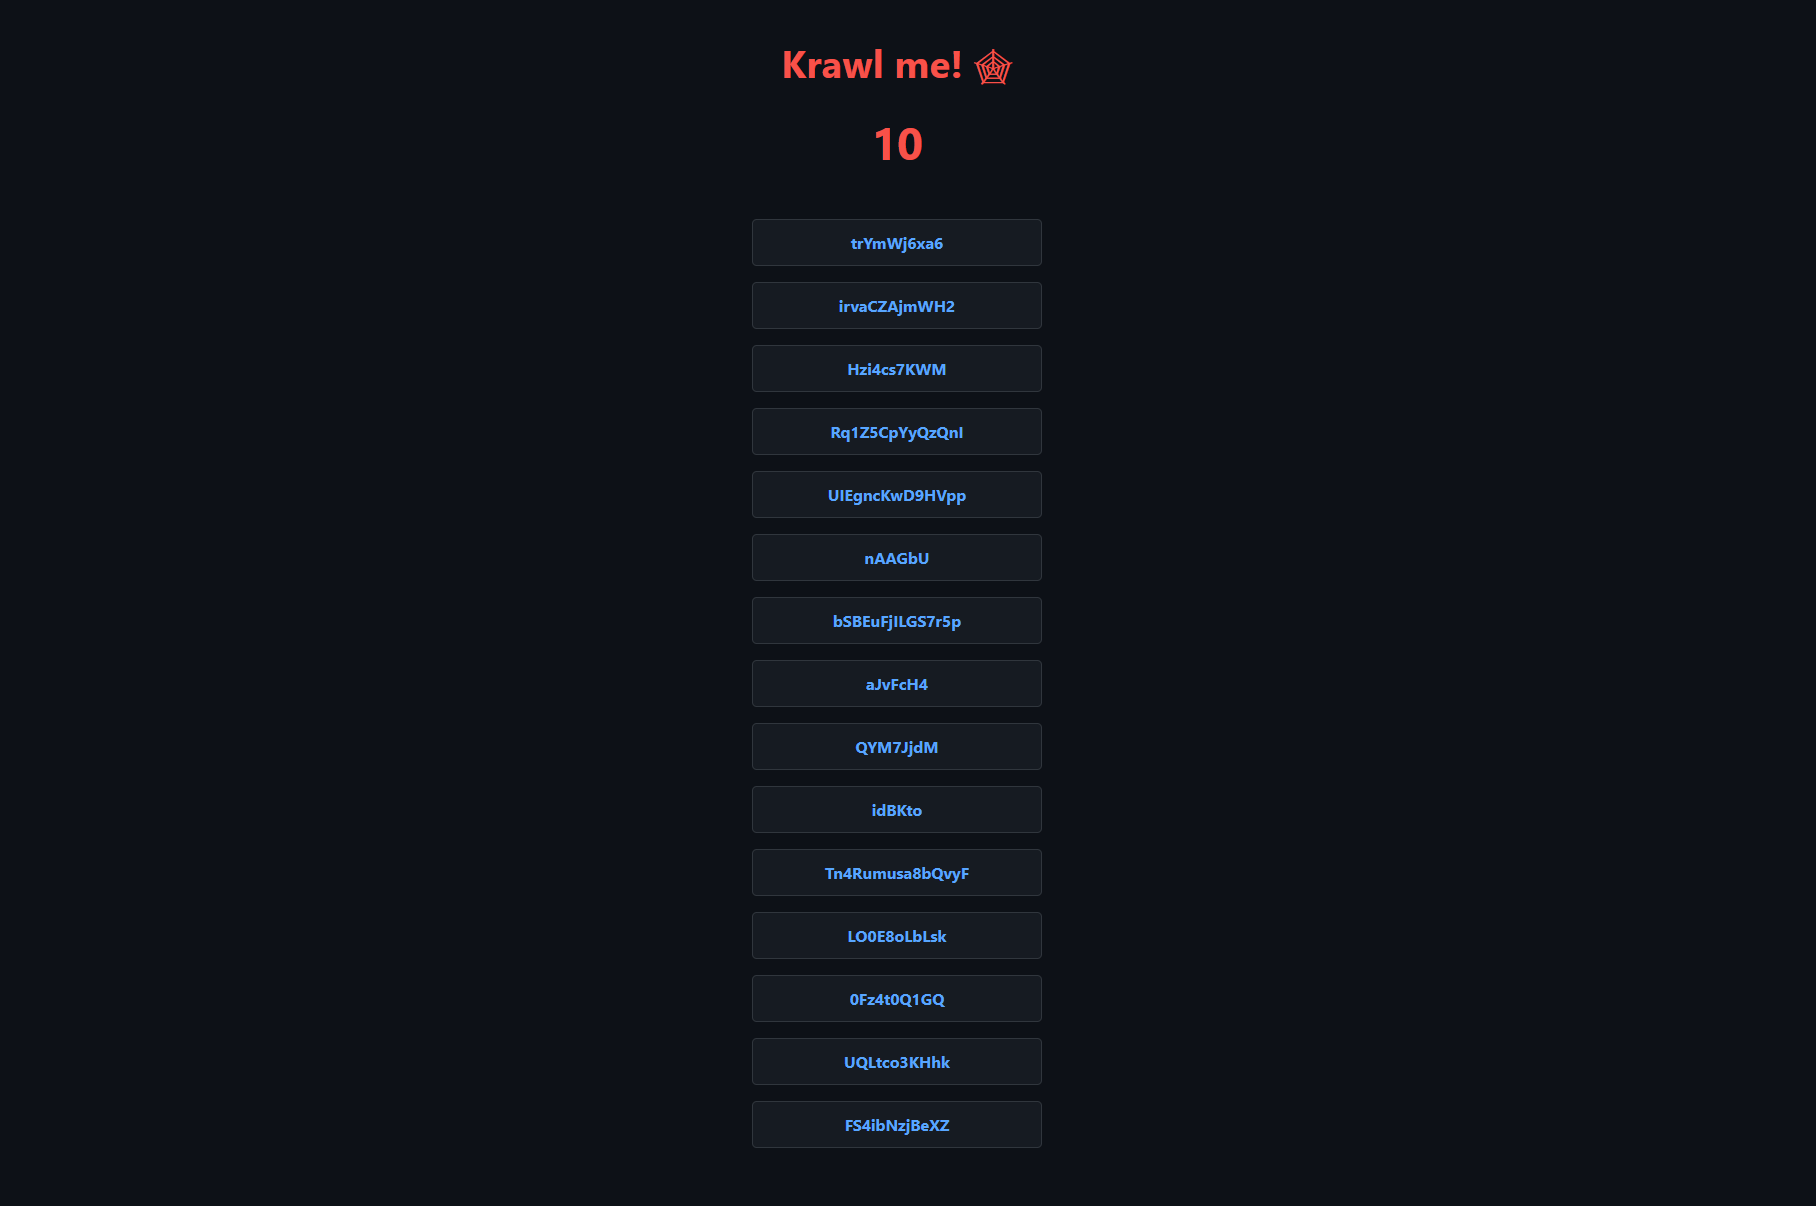
Indem Krawl Angreiferressourcen verschwendet, hilft es, bösartiges Verhalten klar von legitimen Crawlern zu unterscheiden.
Es bietet:
- **[KI-generierte Täuschungsseiten](https://github.com/blessedrebus/krawl/blob/main/docs/ai_generation.md)**: **Lass Angreifer dabei helfen, deine gefälschte verwundbare Angriffsfläche zu generieren**
- **Spider-Trap-Seiten**: Unendlich viele zufällige Links, um Crawler-Ressourcen zu verschwenden, basierend auf dem [spidertrap-Projekt](https://github.com/adhdproject/spidertrap)
- **Gefälschte Anmeldeseiten**: WordPress, phpMyAdmin, Admin-Panels
- **Honeypot-Pfade**: In der robots.txt beworben, um Scanner zu fangen
- **Gefälschte Zugangsdaten**: Realistisch aussehende Benutzernamen, Passwörter, API-Schlüssel
- **[Canary-Token](https://github.com/blessedrebus/krawl/blob/main/docs/canary-token.md)-Integration**: Auslösen externer Alarme
- **Zufällige Server-Header**: Verwirren von Angriffen basierend auf Server-Header und Version
- **Echtzeit-Dashboard**: Überwachung verdächtiger Aktivitäten
- **Anpassbare Wortlisten**: Einfache JSON-basierte Konfiguration
- **Zufällige Fehlerinjektion**: Nachahmung des Verhaltens eines echten Servers
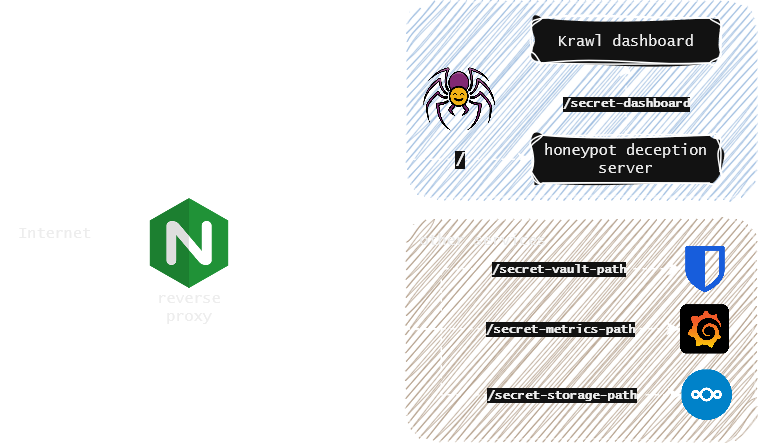
Du kannst Krawl problemlos neben deinen anderen Diensten bereitstellen, um sie mithilfe eines Reverse Proxy vor Web-Crawlern und bösartigen Nutzern zu schützen. Weitere Details findest du in der [Reverse-Proxy-Dokumentation](https://github.com/blessedrebus/krawl/blob/main/docs/reverse-proxy.md).
## Krawl-Dashboard
Krawl bietet ein umfassendes Dashboard, das unter einem **zufälligen geheimen Pfad**, der beim Start generiert wird, oder unter einem **benutzerdefinierten Pfad**, der über `KRAWL_DASHBOARD_SECRET_PATH` konfiguriert wird, erreichbar ist. Dadurch bleibt das Dashboard vor Angreifern verborgen, die deinen Honeypot scannen.
Das Dashboard ist in sechs Tabs organisiert:
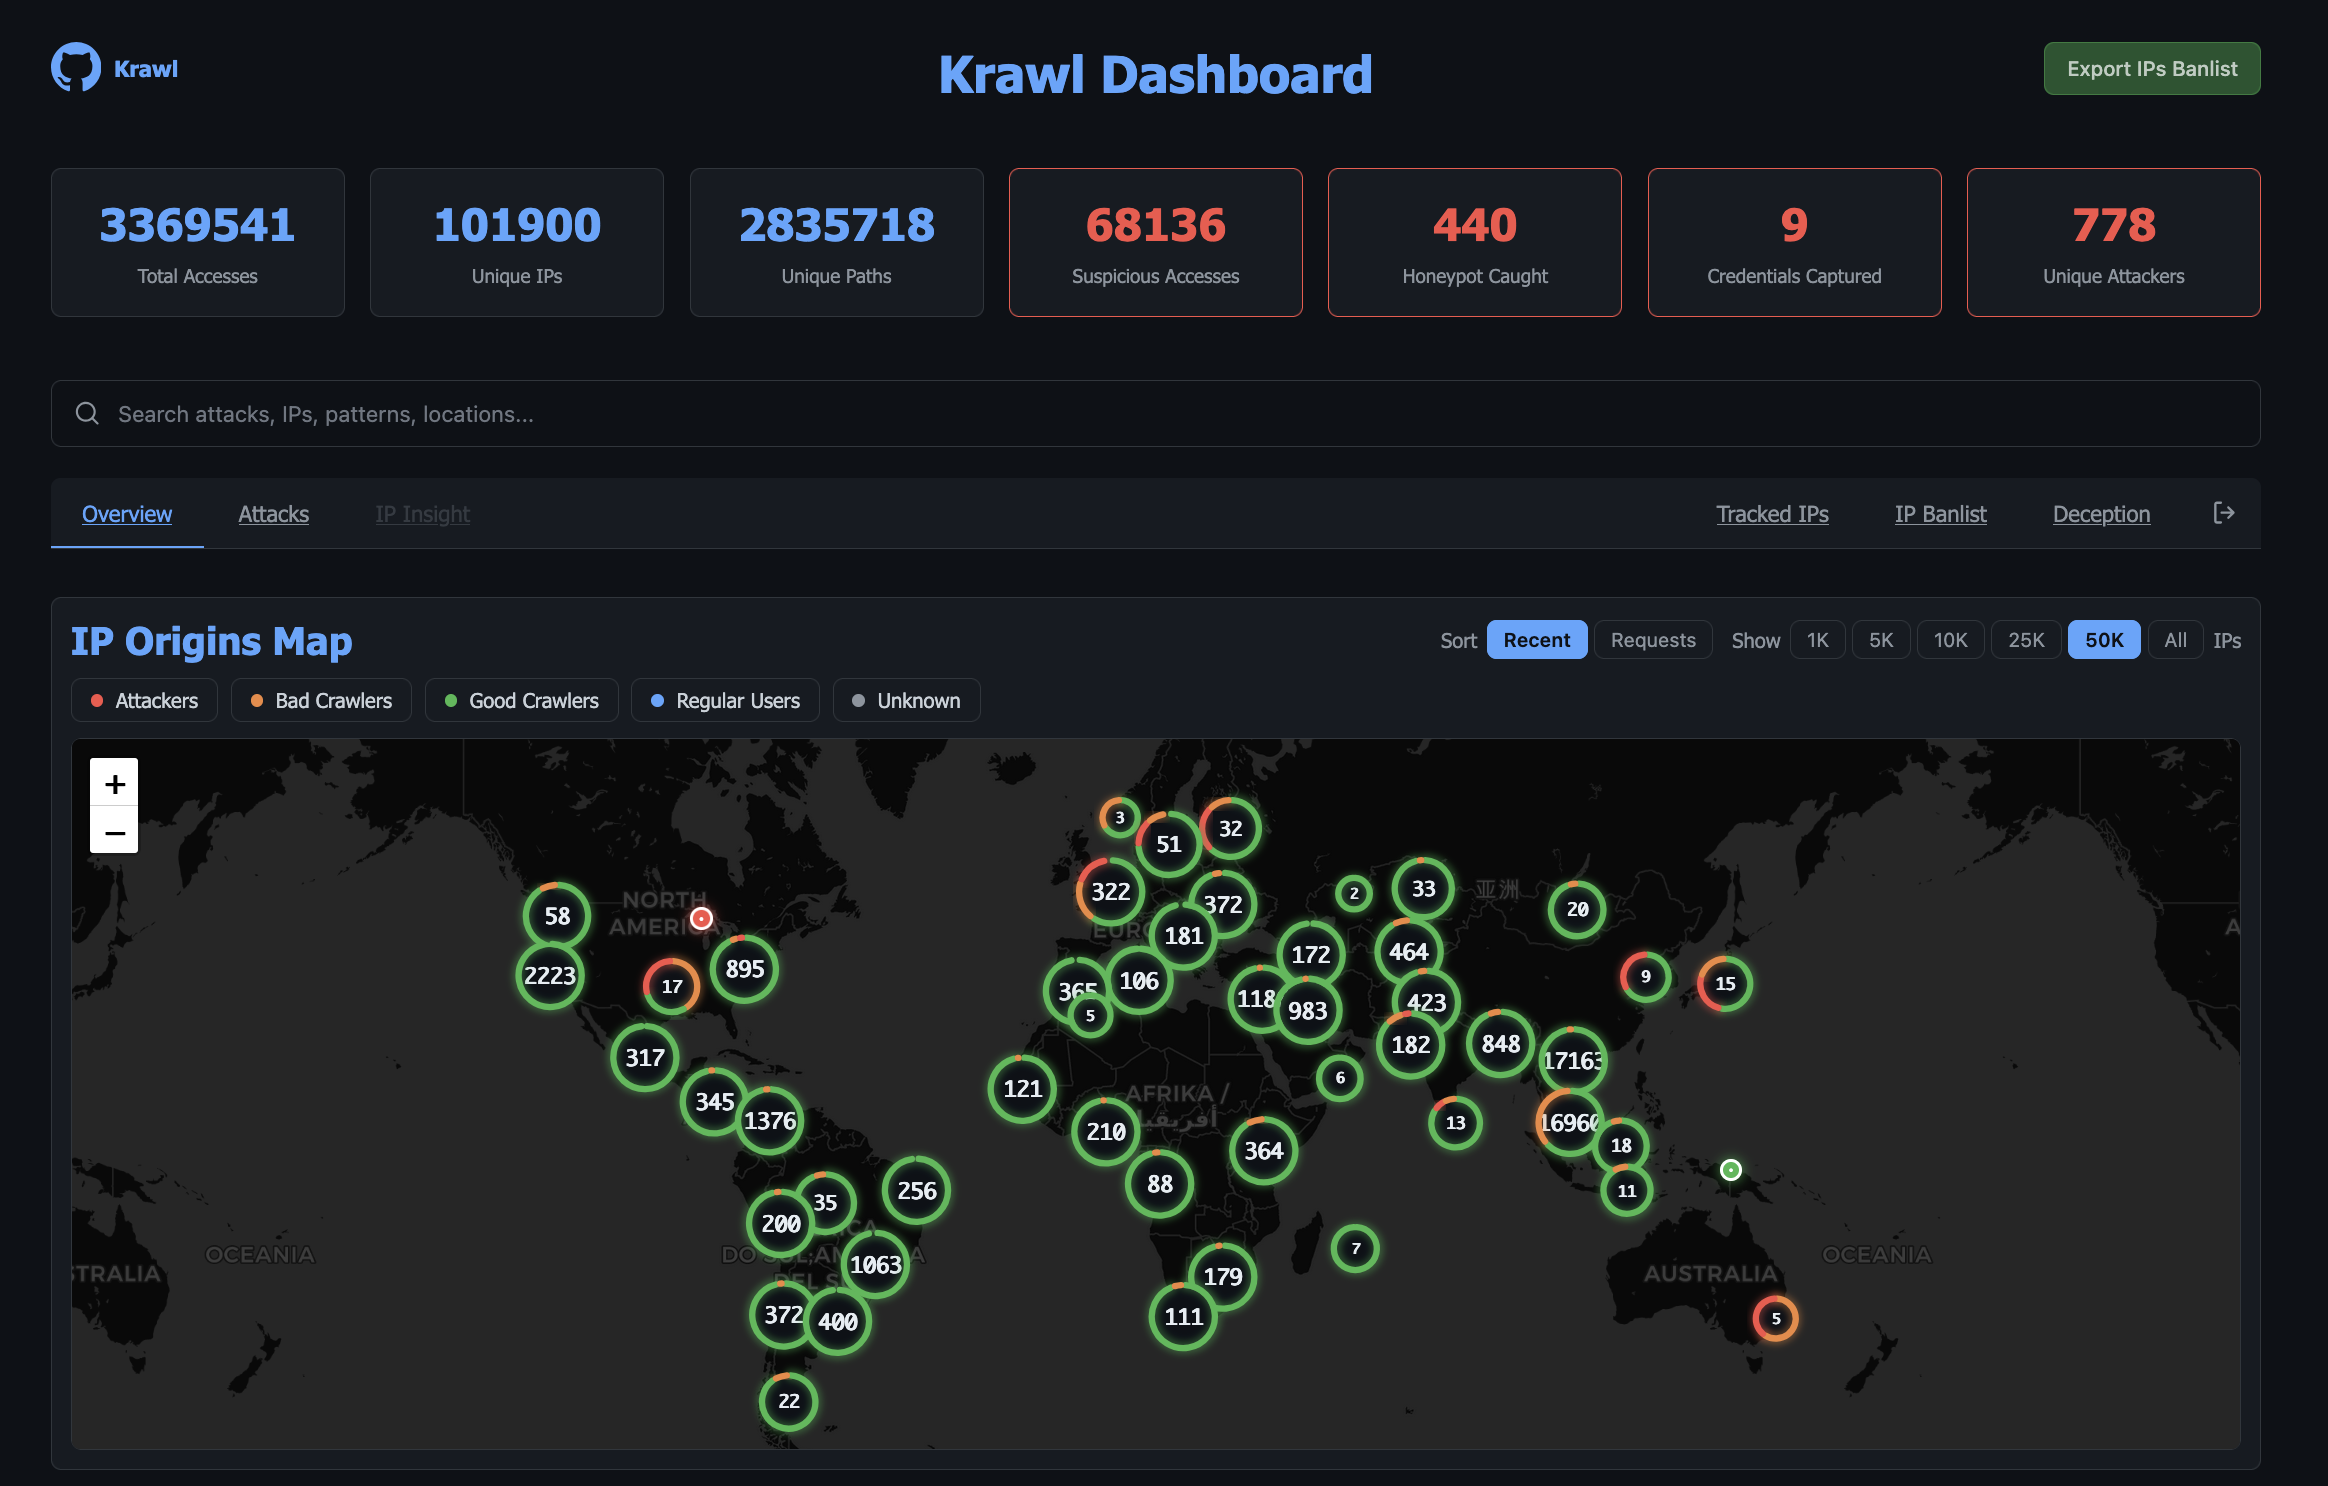
- **Übersicht**: Eine übergeordnete Ansicht der Angriffsaktivität: eine interaktive Karte der IP-Herkünfte, aktuelle verdächtige Anfragen und die Top-IPs, User-Agents und Pfade.
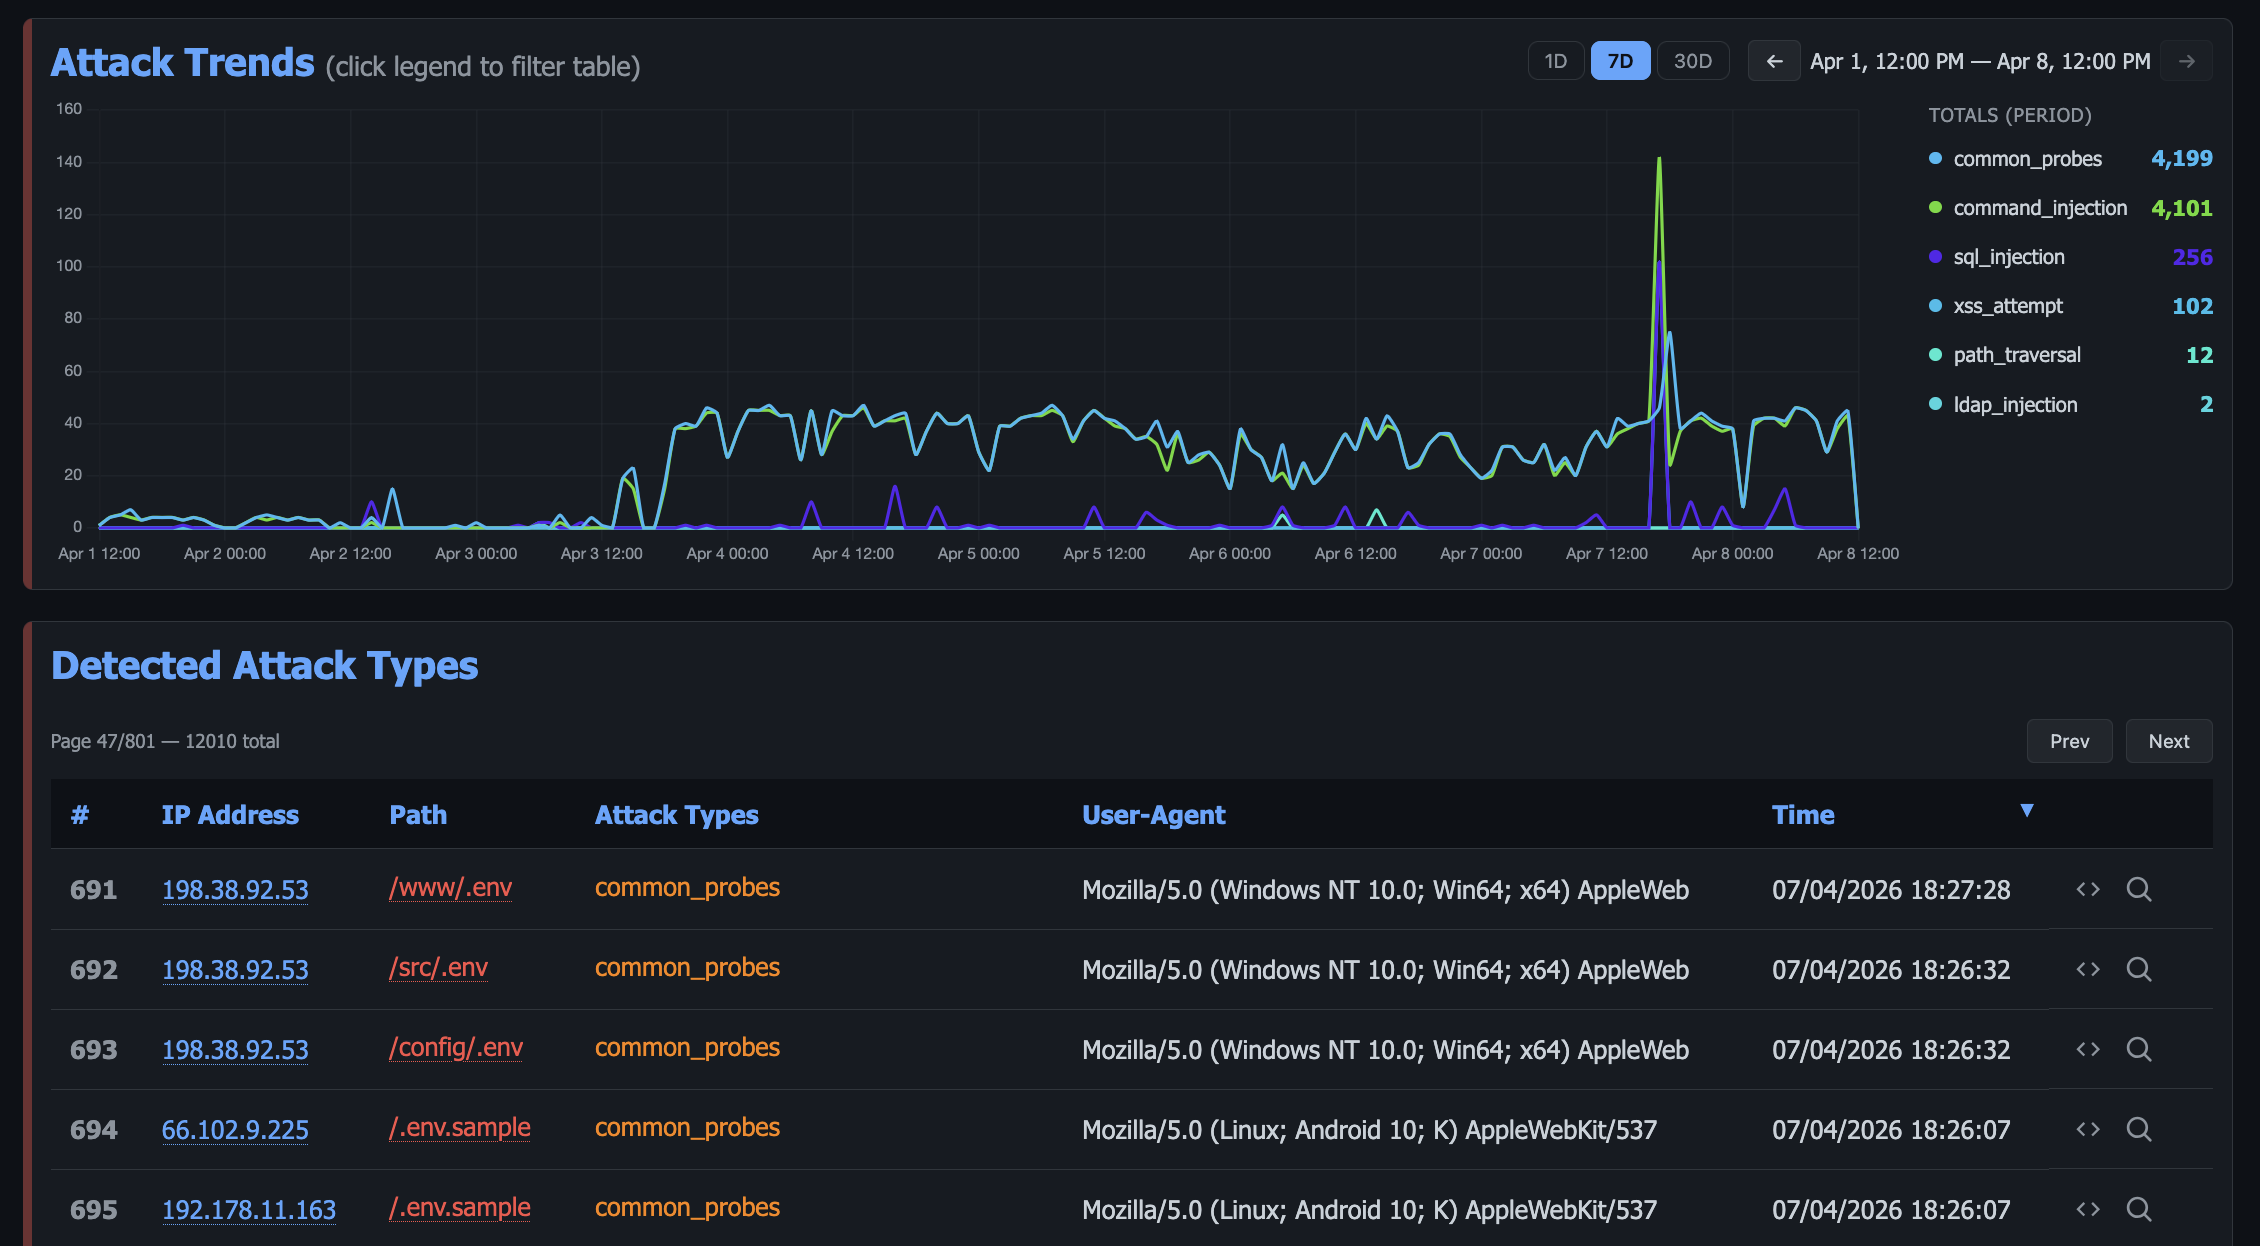
- **Angriffe**: Detaillierte Aufschlüsselung der erfassten Zugangsdaten, Honeypot-Auslöser und erkannten Angriffstypen (SQLi, XSS, Path Traversal usw.) mit Diagrammen und Tabellen.
- **Bedrohungen**: Payloads, die durch TLSH-Fuzzy-Hashing in Kampagnen gruppiert werden, sodass eine Webshell und ihre bearbeiteten Varianten als eine Kampagne statt als unzusammenhängende Treffer gelesen werden, mit einem Index jeder erfassten Datei.
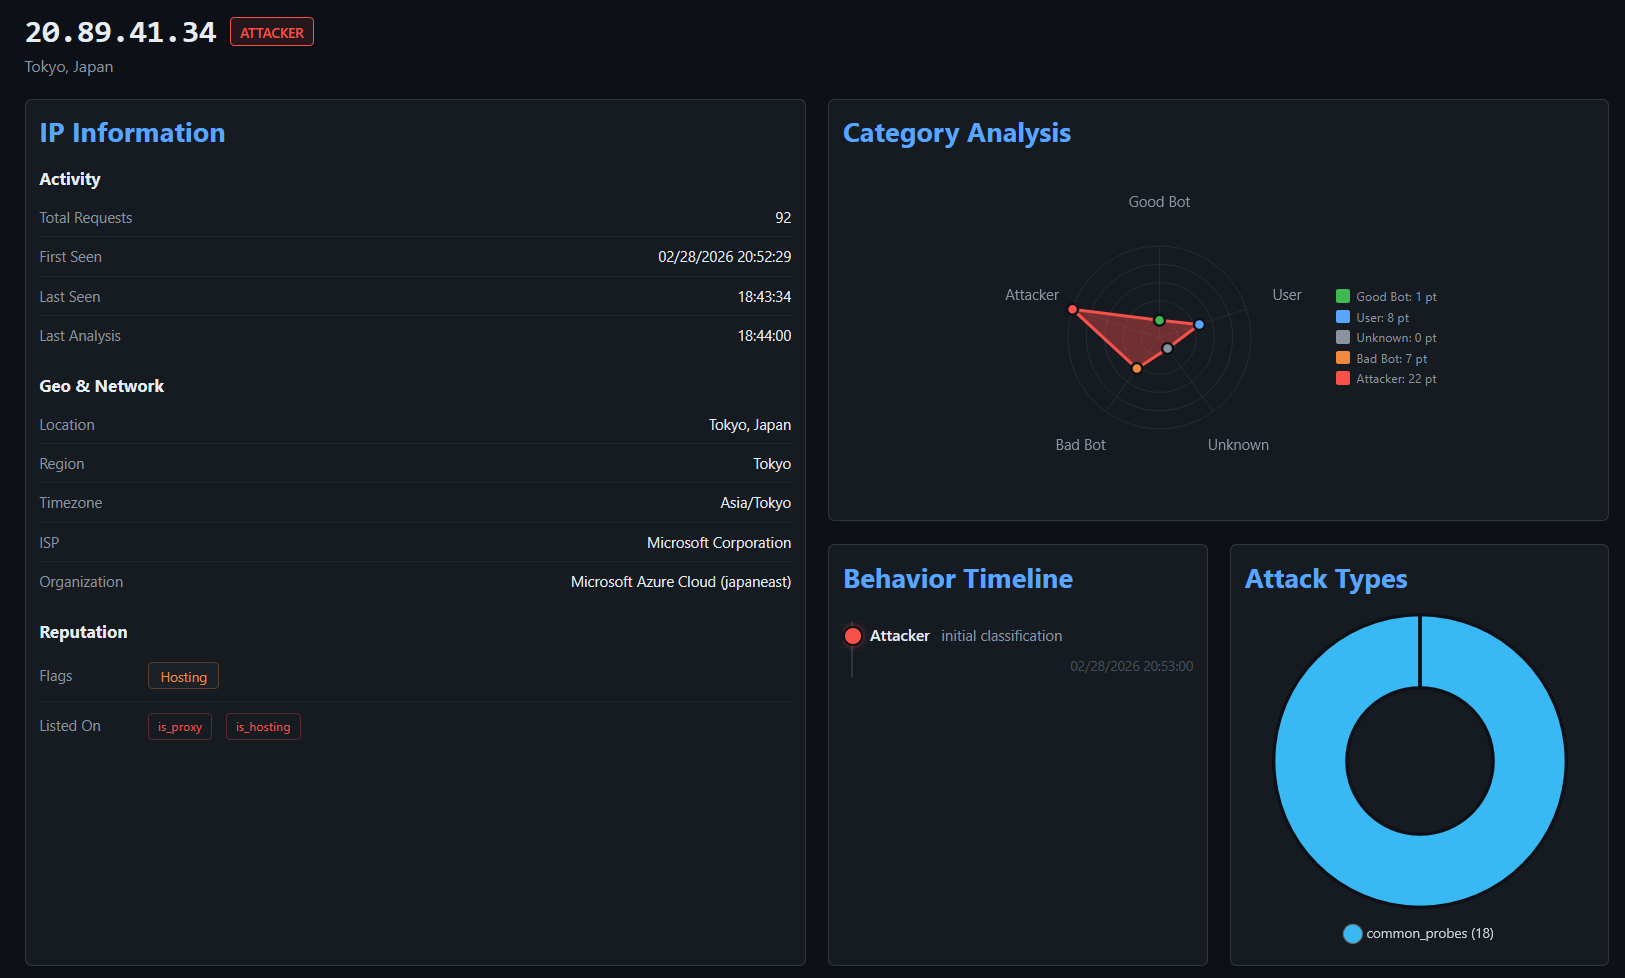
- **IP-Einblick**: Detaillierte forensische Ansicht einer ausgewählten IP: Geolokalisierung, ISP/ASN-Informationen, Reputationsflags, Verhaltens-Zeitachse, Verteilung der Angriffstypen, Referer-Verlauf, erfasste Dateien und Zugangsdaten sowie vollständiger Zugriffsverlauf.
Darüber hinaus werden nach der Authentifizierung mit dem Dashboard-Passwort geschützte Tabs verfügbar:
- **Verfolgte IPs**: Führe eine Beobachtungsliste von IP-Adressen, die du im Laufe der Zeit überwachen möchtest.
- **IP-Banlist**: Verwalte IP-Sperren, sieh dir erkannte Angreifer an und exportiere die Banlist im Raw- oder IPTables-Format.
- **Zeitlich gesperrte IPs**: Überprüfe die IPs, die derzeit im Tarpit festgehalten werden, und nimm alle aus, die es nicht sein sollten.
- **Täuschung**: Verwalte KI-generierte Seiten, exportiere sie oder importiere neue.
- **Webhooks**: Leite Sperren an CloudFlare und andere Firewalls weiter.
Die Symbole in der Kopfzeile öffnen die API-Dokumentation, den Banlist-Export und ein Einstellungsfenster, das die laufende Konfiguration sowie eine Wartungsseite zum bedarfsgesteuerten Ausführen geplanter Aufgaben anzeigt.
Weitere Details findest du in der [Dashboard-Dokumentation](https://github.com/blessedrebus/krawl/blob/main/docs/dashboard.md).
## Bereitstellungsmodi
Krawl unterstützt zwei Bereitstellungsmodi, die über die Einstellung `mode` in `config.yaml` oder die Umgebungsvariable `KRAWL_MODE` gesteuert werden.
| | Standalone | Skalierbar |
|---|---|---|
| **Datenbank** | SQLite (WAL-Modus) | PostgreSQL |
| **Cache** | In-Memory-Python-Dict | Redis (mehrstufige TTL) |
| **Replikate** | 1 (einzelne Instanz) | 1+ (horizontale Skalierung) |
| **Externe Abhängigkeiten** | Keine | PostgreSQL + Redis |
| **Am besten für** | Entwicklung, Homelabs, <500k Anfragen | Produktion, HA, >500k Anfragen |
**Standalone**: Ideal für Entwicklungsumgebungen oder Homelabs mit geringer Anfragezahl. Keine zusätzliche Konfiguration erforderlich, starte einfach Krawl und es funktioniert.
- Bereitstellung in einem einzigen Container ohne externe Abhängigkeiten
- Geringerer RAM- und Ressourcenverbrauch
**Skalierbar**: Entwickelt für Produktionsumgebungen oder Honeypots mit hohem Datenverkehr. Das Helm-Chart verwendet standardmäßig diesen Modus.
- Schnelleres, reaktionsfähigeres Dashboard dank mehrstufigem Redis-Caching
- Geringere Festplatten-I/O, da Redis als Hot-Path-Cache vor PostgreSQL fungiert
- Horizontale Skalierung erhöht die Anzahl der Krawl-Replikate hinter einem Load Balancer
Detaillierte Konfiguration, Docker-Compose-Beispiele, Kubernetes/Helm-Einrichtung und schrittweise Migrationsanweisungen findest du in der [Dokumentation zu den Bereitstellungsmodi](https://github.com/blessedrebus/krawl/blob/main/docs/deployment-modes.md).
## Krawl-Banlist
Krawl führt eine regelmäßig aktualisierte [`banlist.txt`](https://github.com/blessedrebus/krawl/blob/main/banlist.txt) mit IP-Adressen von **Angreifern, die seine Honeypot-Fallen ausgelöst haben**. Die Banlist wird wöchentlich veröffentlicht und steht zum Download bereit, um der Community zu helfen, bekannte bösartige Akteure präventiv zu blockieren, auch ohne Krawl zu verwenden.
Die Banlist kann auch direkt abgerufen werden von:
[https://demo.krawlme.com/das_dashboard/api/export-ips?categories=attacker&fwtype=raw](https://demo.krawlme.com/das_dashboard/api/export-ips?categories=attacker&fwtype=raw).
### Banlists zwischen Instanzen teilen
Krawl-Instanzen können ihre Banlists föderieren: Jede kann ihre eigene Liste unter einem
nicht authentifizierten Pfad veröffentlichen und Listen von anderen Instanzen (oder beliebige Klartext-IP-Listen) abrufen.
Abgerufene IPs werden in die lokalen Sperrentscheidungen eingefügt und im Dashboard angezeigt.```yaml
banlist:
# Public, unauthenticated download path for this instance's banlist.
# Supports the same ?categories= and ?fwtype= parameters as the main API.
# Empty = disabled.
export_path: "/public_banlist.txt"
# Upstream banlists to fetch and merge. Plain ".txt" lists work too.
sources:
- "https://demo.krawlme.com/das_dashboard/api/export-ips?categories=attacker&fwtype=raw"
- "https://krawl.example.com/public_banlist.txt"
refresh_interval: 3600 # seconds between fetches
```
## Schnellstart
### Docker Run
Führe Krawl im Standalone-Modus mit dem neuesten Image aus:```bash
docker run -d \
-p 5000:5000 \
-e KRAWL_DASHBOARD_SECRET_PATH="/my-secret-dashboard" \
-e KRAWL_DASHBOARD_PASSWORD="my-secret-password" \
-v krawl-data:/app/data \
--name krawl \
ghcr.io/blessedrebus/krawl:latest
```
Greife auf den Server unter `http://localhost:5000` zu
### Docker Compose
Erstelle eine `docker-compose.yaml` mit einem der beiden Bereitstellungsmodi.
**Standalone**: nur der Krawl-Server mit Sqlite-Speicher:```yaml
services:
krawl:
image: ghcr.io/blessedrebus/krawl:latest
container_name: krawl-server
ports:
- "5000:5000"
environment:
- CONFIG_LOCATION=config.yaml
# - KRAWL_DASHBOARD_PASSWORD=my-secret-password
volumes:
- ./config.yaml:/app/config.yaml:ro
- krawl-data:/app/data
restart: unless-stopped
volumes:
krawl-data:
```
**Skalierbar**: mit PostgreSQL und Redis:
> [!CAUTION]
> Das folgende Beispiel verwendet **Standardpasswörter** (`krawl`/`krawl`). **Ändern Sie diese, bevor Sie in die Produktion deployen.**```yaml
services:
postgres:
image: postgres:16-alpine
environment:
POSTGRES_DB: krawl
POSTGRES_USER: krawl
POSTGRES_PASSWORD: krawl
volumes:
- postgres_data:/var/lib/postgresql/data
restart: unless-stopped
healthcheck:
test: ["CMD-SHELL", "pg_isready -U krawl -d krawl"]
interval: 10s
timeout: 5s
retries: 5
redis:
image: redis:7-alpine
volumes:
- redis_data:/data
restart: unless-stopped
healthcheck:
test: ["CMD", "redis-cli", "ping"]
interval: 10s
timeout: 5s
retries: 5
krawl:
image: ghcr.io/blessedrebus/krawl:latest
container_name: krawl-server
ports:
- "5000:5000"
environment:
- CONFIG_LOCATION=config.yaml
- KRAWL_MODE=scalable
- KRAWL_POSTGRES_HOST=postgres
- KRAWL_POSTGRES_PORT=5432
- KRAWL_POSTGRES_USER=krawl
- KRAWL_POSTGRES_PASSWORD=krawl
- KRAWL_POSTGRES_DATABASE=krawl
- KRAWL_REDIS_HOST=redis
- KRAWL_REDIS_PORT=6379
# - KRAWL_DASHBOARD_PASSWORD=my-secret-password
volumes:
- ./config.yaml:/app/config.yaml:ro
restart: unless-stopped
depends_on:
postgres:
condition: service_healthy
redis:
condition: service_healthy
volumes:
postgres_data:
redis_data:
```
Zum Bereitstellen einfach ausführen```bash
docker compose up -d
```
Produktionsreife Compose-Dateien sind auch im Verzeichnis [`docker/`](https://github.com/blessedrebus/krawl/blob/main/docker) verfügbar. Für die **Entwicklung** (Builds aus dem Quellcode mit Hot-Reload) verwenden Sie die Compose-Dateien in [`docker/dev/`](https://github.com/blessedrebus/krawl/blob/main/docker/dev).
Weitere Details zu beiden Modi finden Sie unter [Deployment-Modi](https://github.com/blessedrebus/krawl/blob/main/docs/deployment-modes.md).
### Kubernetes
**Krawl ist auch nativ auf Kubernetes verfügbar**. Die Installation kann entweder [über ein Manifest](https://github.com/blessedrebus/krawl/blob/main/kubernetes/README.md) oder [mithilfe des Helm-Charts](https://github.com/blessedrebus/krawl/blob/main/helm/README.md) erfolgen.
Das Helm-Chart **verwendet standardmäßig den skalierbaren Modus** mit gebündeltem PostgreSQL und Redis:```bash
helm install krawl oci://ghcr.io/blessedrebus/krawl-chart --version 2.4.0 \
-n krawl-system --create-namespace \
--set postgres.password=your-password \
--set redis.password=your-redis-password \
--set dashboardPassword=your-dashboard-password \
--set config.dashboard.secret_path=/my-secret-dashboard
```
Minimale Beispiel-Werte-Dateien werden für beide Modi bereitgestellt:
- [`values-minimal.yaml`](https://github.com/blessedrebus/krawl/blob/main/helm/values-minimal.yaml) ---> Skalierbar (Standard)
- [`values-standalone.yaml`](https://github.com/blessedrebus/krawl/blob/main/helm/values-standalone.yaml) ---> Standalone
Siehe [Deployment-Modi](https://github.com/blessedrebus/krawl/blob/main/docs/deployment-modes.md) und [Chart-Dokumentation](https://github.com/blessedrebus/krawl/blob/main/helm/README.md) für die vollständige Konfiguration und Migrationsanweisungen.
### Uvicorn (Python)
Führe Krawl direkt mit Python 3.13+ und uvicorn für die lokale Entwicklung oder Tests aus:```bash
pip install -r requirements.txt
uvicorn app:app --host 0.0.0.0 --port 5000 --app-dir src --no-server-header
```
Zugriff auf den Server unter `http://localhost:5000`
## Konfiguration
Krawl verwendet eine **Konfigurationshierarchie**, bei der **Umgebungsvariablen Vorrang vor der Konfigurationsdatei haben**. Dieser Ansatz wird für Docker-Bereitstellungen und eine schnelle Anpassung direkt nach dem Auspacken empfohlen.
### Konfiguration über config.yaml
Sie können die Datei [config.yaml](https://github.com/blessedrebus/krawl/blob/main/config.yaml) für erweiterte Konfigurationen verwenden, z. B. für Docker-Compose- oder Helm-Chart-Bereitstellungen.
### Konfiguration über Umgebungsvariablen
Alle Einstellungen können als Umgebungsvariablen angegeben werden, die `config.yaml` überschreiben.
Der Variablenname ist `KRAWL_` plus der Einstellungspfad in Großbuchstaben, sodass `dashboard.password`
zu `KRAWL_DASHBOARD_PASSWORD` wird.
<details>
<summary><b>Server und Link-Generierung</b> (11 Variablen)</summary>
Wie Krawl sich präsentiert und das Labyrinth der generierten Seiten formt.
| Umgebungsvariable | Beschreibung | Standard |
|----------------------|-------------|---------|
| `CONFIG_LOCATION` | Pfad zur yaml-Konfigurationsdatei | `config.yaml` |
| `KRAWL_PORT` | Server-Listening-Port | `5000` |
| `KRAWL_DELAY` | Antwortverzögerung in Millisekunden | `100` |
| `KRAWL_SERVER_HEADER` | HTTP-Server-Header zur Täuschung | `""` |
| `KRAWL_LINKS_LENGTH_RANGE` | Linklängenbereich als `min,max` | `5,15` |
| `KRAWL_LINKS_PER_PAGE_RANGE` | Links pro Seite als `min,max` | `10,15` |
| `KRAWL_CHAR_SPACE` | Zeichen, die für die Link-Generierung verwendet werden | `abcdefgh...` |
| `KRAWL_MAX_COUNTER` | Anfangswert des Zählers | `10` |
| `KRAWL_PROBABILITY_ERROR_CODES` | Wahrscheinlichkeit einer Fehlerantwort (0-100 %) | `0` |
| `KRAWL_INFINITE_PAGES_FOR_MALICIOUS` | Unendlich viele Seiten an bösartige IPs ausliefern | `true` |
| `KRAWL_MAX_PAGES_LIMIT` | Maximales Seitenlimit für Crawler | `250` |
| `KRAWL_BAN_DURATION_SECONDS` | Sperrdauer in Sekunden für ratenbegrenzte IPs | `600` |
</details>
<details>
<summary><b>Dashboard, Metriken und Logging</b> (13 Variablen)</summary>
Dashboard-Zugriff, Cache-Warmup, Prometheus und Log-Level.
| Umgebungsvariable | Beschreibung | Standard |
|----------------------|-------------|---------|
| `KRAWL_DASHBOARD_SECRET_PATH` | Benutzerdefinierter Dashboard-Pfad | Automatisch generiert |
| `KRAWL_DASHBOARD_PASSWORD` | Passwort für geschützte Dashboard-Bereiche | Automatisch generiert |
| `KRAWL_DASHBOARD_CACHE_WARMUP` | Dashboard-Daten alle 5 Minuten vorberechnen für sofortiges Laden der Seiten | `true` |
| `KRAWL_DASHBOARD_WARMUP_PAGES` | Anzahl der Seiten, die pro Tabellenbereich vorgewärmt werden | `10` |
| `KRAWL_DASHBOARD_WARMUP_AGGREGATION` | Vollständige top_paths/top_ua-Aggregationen vorberechnen für abfragefreie Auslieferung | `false` |
| `KRAWL_DASHBOARD_TOP_N_MIN_COUNT` | Mindestzugriffszahl für die Bereiche top paths/user agents (auf 1 setzen zum Deaktivieren) | `5` |
| `KRAWL_DASHBOARD_BRAND_NAME` | Name im Dashboard-Schriftzug und in der Überschrift | `Krawl` |
| `KRAWL_DASHBOARD_BRAND_URL` | Wohin der Schriftzug verlinkt (leer rendert ihn als reinen Text) | Krawls Repository |
| `KRAWL_DASHBOARD_BRAND_LOGO` | Bild-URL, die anstelle der GitHub-Marke angezeigt wird | Nicht gesetzt |
| `KRAWL_DASHBOARD_BRAND_SHOW_VERSION` | Version neben dem Namen anzeigen | `true` |
| `KRAWL_DASHBOARD_BRAND_CONTACT` | Kontakt, der unter dem Schriftzug angezeigt wird (Adresse, URL oder reiner Text) | Nicht gesetzt |
| `KRAWL_METRICS_ENABLED` | Prometheus-Metriken unter `/<dashboard_path>/metrics` bereitstellen | `true` |
| `KRAWL_LOG_LEVEL` | Anwendungs-Log-Level (`DEBUG`, `INFO`, `WARNING`, `ERROR`) | `INFO` |
</details>
<details>
<summary><b>Datenbank, Aufbewahrung und Backups</b> (12 Variablen)</summary>
Speicherort, wie lange Daten aufbewahrt werden und der Dump-Job.
| Umgebungsvariable | Beschreibung | Standard |
|----------------------|-------------|---------|
| `KRAWL_DATABASE_PATH` | Speicherort der Datenbankdatei | `data/krawl.db` |
| `KRAWL_DATABASE_PERSIST_SUSPICIOUS_ONLY` | Nur verdächtige Anfragen im Zugriffsprotokoll speichern | `false` |
| `KRAWL_MAP_TILE_URL` | Tile-URL-Vorlage für die Dashboard-Karte (`{z}/{x}/{y}`, optional `{s}`/`{r}`) | Esri dark canvas |
| `KRAWL_MAP_TILE_ATTRIBUTION` | Auf der Karte angezeigte Attribution | Esri/OSM |
| `KRAWL_MAP_API_KEY` | Wird an jede Tile-Anfrage als Query-Parameter angehängt — von CARTO erforderlich | _(leer)_ |
| `KRAWL_MAP_API_KEY_PARAM` | Name dieses Query-Parameters (`api_key`, `apikey`, `key`) | `api_key` |
| `KRAWL_IPV6_IGNORE` | IPv6-Anfragen vollständig verwerfen: weiterhin auf stdout protokolliert, nie gespeichert, ban-geprüft oder exportiert | `false` |
| `KRAWL_IPV6_PURGE_EXISTING` | Beim nächsten Start auch vorhandene IPv6-Zeilen löschen (unwiderruflich; erfordert `KRAWL_IPV6_IGNORE`) | `false` |
| `KRAWL_DATABASE_RETENTION_DAYS` | Anzahl der Tage, die Daten in der Datenbank aufbewahrt werden | `30` |
| `KRAWL_BACKUPS_PATH` | Pfad, in dem Datenbank-Dumps gespeichert werden | `backups` |
| `KRAWL_BACKUPS_CRON` | Cron-Ausdruck zur Steuerung des Backup-Job-Zeitplans | `*/30 * * * *` |
| `KRAWL_BACKUPS_ENABLED` | Boolescher Wert zum Aktivieren des DB-Dump-Jobs | `true` |
</details>
<details>
<summary><b>Fallen: Tarpit, Täuschungsseiten und Canary</b> (6 Variablen)</summary>
Opt-in-Fallen und die Seiten, die Angreifern ausgeliefert werden.
| Umgebungsvariable | Beschreibung | Standard |
|----------------------|-------------|---------|
| `KRAWL_TARPIT_ENABLED` | KI-Agenten mit langsamen Antworten und zufälligem Text ködern | `false` |
| `KRAWL_TARPIT_DELAY_SECONDS` | Zusätzliche Verzögerung in Sekunden pro Antwort, wenn der Tarpit aktiv ist | `5` |
| `KRAWL_DECEPTION_IMPORT_PAGES` | Täuschungsseiten beim Start automatisch aus `src/templates/deception/` importieren | `true` |
| `KRAWL_CUSTOM_TEMPLATE_PATH` | Pfad innerhalb des Containers zu einer benutzerdefinierten HTML-Vorlage. Die Vorlage muss die Platzhalter `{counter}` und `{content}` enthalten. | `/templates/custom_page.html` |
| `KRAWL_CANARY_TOKEN_URL` | Externe Canary-Token-URL | Keine |
| `KRAWL_CANARY_TOKEN_TRIES` | Anfragen, bevor das Canary-Token angezeigt wird | `10` |
</details>
<details>
<summary><b>IP-Reputationsanalysator</b> (6 Variablen)</summary>
Schwellenwerte, die darüber entscheiden, wie eine IP klassifiziert wird.
| Umgebungsvariable | Beschreibung | Standard |
|----------------------|-------------|---------|
| `KRAWL_HTTP_RISKY_METHODS_THRESHOLD` | Schwellenwert für die Erkennung riskanter HTTP-Methoden | `0.1` |
| `KRAWL_VIOLATED_ROBOTS_THRESHOLD` | Schwellenwert für robots.txt-Verstöße | `0.1` |
| `KRAWL_UNEVEN_REQUEST_TIMING_THRESHOLD` | Schwellenwert des Variationskoeffizienten für das Timing | `0.5` |
| `KRAWL_UNEVEN_REQUEST_TIMING_TIME_WINDOW_SECONDS` | Zeitfenster für die Analyse des Anfrage-Timings in Sekunden | `300` |
| `KRAWL_USER_AGENTS_USED_THRESHOLD` | Schwellenwert für die Erkennung mehrerer User Agents | `2` |
| `KRAWL_ATTACK_URLS_THRESHOLD` | Schwellenwert für die Erkennung von Angriffs-URLs | `1` |
</details>
<details>
<summary><b>Threat-Intel-Erfassung</b> (4 Variablen)</summary>
Erfasste Payloads (Dateien und markierte Anfrage-Bodies) per Fuzzy-Hash
verarbeiten und nahezu identische Varianten zu Kampagnen-Clustern gruppieren.
Erfordert `py-tlsh`.
Das Hashing läuft als geplante Hintergrundaufgabe `hash-payloads` (siehe
`src/tasks/hash_payloads.py`), die jeden erfassten Angriff einmal hasht — neue
Treffer zum Zeitpunkt der Erfassung und einen einmaligen rückwärtigen Durchlauf
der bestehenden Historie, der durch einen `payload_hash_watermark`-High-Water-Mark
verfolgt wird — und dann die Digests zu Kampagnen mit wiederkehrenden Mustern
clustert.
| Umgebungsvariable | Beschreibung | Standard |
|----------------------|-------------|---------|
| `KRAWL_TLSH_ENABLED` | Hochgeladene Dateien und markierte Anfrage-Bodies mit TLSH für Near-Duplicate-Clustering hashen | `true` |
| `KRAWL_TLSH_CLUSTER_THRESHOLD` | TLSH-Distanz, unterhalb derer ein Payload einer bestehenden Kampagne beitritt (0 = identische Bytes; Varianten einer Webshell unterscheiden sich typischerweise um < 100) | `150` |
| `KRAWL_TLSH_CAMPAIGN_MIN_EVENTS` | Wie oft ein Payload gesehen werden muss, bevor seine Kampagne im Threats-Tab erscheint | `10` |
| `KRAWL_REFERER_ENABLED` | Den eingehenden HTTP-Referer in den Zugriffsprotokollen aufzeichnen, für die Verfolgung von Köderketten | `true` |
</details>
<details>
<summary><b>Banlist und ignorierte IPs</b> (4 Variablen)</summary>
Banlists mit anderen Instanzen teilen und Traffic, der nie verfolgt werden soll.
| Umgebungsvariable | Beschreibung | Standard |
|----------------------|-------------|---------|
| `KRAWL_IGNORED_IPS` | Kommagetrennte IPs/CIDRs, die nie verfolgt, gesperrt oder exportiert werden | Loopback, RFC1918, Link-Local, CGNAT |
| `KRAWL_BANLIST_EXPORT_PATH` | Öffentlicher Download-Pfad für die Banlist, z. B. `/public_banlist.txt` (leer = deaktiviert) | `""` |
| `KRAWL_BANLIST_SOURCES` | Kommagetrennte Upstream-Banlist-URLs zum Abrufen und Zusammenführen | Krawl-Community-Banlist |
| `KRAWL_BANLIST_REFRESH_INTERVAL` | Sekunden zwischen Abrufen der Upstream-Banlist | `3600` |
</details>
<details>
<summary><b>KI-generierte Täuschungsseiten</b> (10 Variablen)</summary>
Siehe die [Dokumentation zur KI-Generierung](https://github.com/blessedrebus/krawl/blob/main/docs/ai_generation.md).
| Umgebungsvariable | Beschreibung | Standard |
|----------------------|-------------|---------|
| `KRAWL_AI_ENABLED` | KI-generierte Täuschungsseiten aktivieren | `false` |
| `KRAWL_AI_PROVIDER` | KI-Anbieter (`"openrouter"` oder `"openai"`) | `"openrouter"` |
| `KRAWL_AI_OPENAI_BASE_URL` | Optionale OpenAI-Basis-URL für benutzerdefinierte API-Endpunkte | `"https://api.openai.com/v1"` |
| `KRAWL_AI_API_KEY` | API-Schlüssel für den KI-Anbieter | `None` |
| `KRAWL_AI_MODEL` | KI-Modell, das für die Seitengenerierung verwendet wird | `"nvidia/nemotron-3-super-120b-a12b:free"` |
| `KRAWL_AI_TIMEOUT` | Anfrage-Timeout in Sekunden für KI-API-Aufrufe | `60` |
| `KRAWL_AI_MAX_DAILY_REQUESTS` | Maximale Anzahl KI-generierter Seiten pro Tag (0 = unbegrenzt) | `0` |
| `KRAWL_AI_PROMPT` | Benutzerdefinierte Prompt-Vorlage für die KI-Seitengenerierung | Standard-Prompt |
| `KRAWL_AI_REASONING_ENABLED` | Reasoning-Tokens aktivieren (nur OpenRouter-Reasoning-Modelle) | `false` |
| `KRAWL_AI_REASONING_EFFORT` | Reasoning-Aufwand (`none`, `minimal`, `low`, `medium`, `high`, `xhigh`) | `"medium"` |
</details>
<details>
<summary><b>Skalierbarer Modus: PostgreSQL und Redis</b> (13 Variablen)</summary>
Wird nur verwendet, wenn `KRAWL_MODE=scalable`. Siehe [Bereitstellungsmodi](https://github.com/blessedrebus/krawl/blob/main/docs/deployment-modes.md).
| Umgebungsvariable | Beschreibung | Standard |
|----------------------|-------------|---------|
| `KRAWL_MODE` | Bereitstellungsmodus (`standalone` oder `scalable`) | `standalone` |
| `KRAWL_POSTGRES_HOST` | PostgreSQL-Hostname | `localhost` |
| `KRAWL_POSTGRES_PORT` | PostgreSQL-Port | `5432` |
| `KRAWL_POSTGRES_USER` | PostgreSQL-Benutzername | `krawl` |
| `KRAWL_POSTGRES_PASSWORD` | PostgreSQL-Passwort | `krawl` |
| `KRAWL_POSTGRES_DATABASE` | PostgreSQL-Datenbankname | `krawl` |
| `KRAWL_REDIS_HOST` | Redis-Hostname | `localhost` |
| `KRAWL_REDIS_PORT` | Redis-Port | `6379` |
| `KRAWL_REDIS_DB` | Redis-Datenbanknummer | `0` |
| `KRAWL_REDIS_PASSWORD` | Redis-Passwort | Keine |
| `KRAWL_REDIS_CACHE_TTL` | TTL in Sekunden für Dashboard-Warmup-Daten | `600` |
| `KRAWL_REDIS_HOT_TTL` | TTL in Sekunden für Hot-Path-Daten (Ban-Informationen, IP-Kategorien) | `30` |
| `KRAWL_REDIS_TABLE_TTL` | TTL in Sekunden für paginierte Dashboard-Tabellen | `120` |
</details>
Zum Beispiel```bash
# Set canary token
export CONFIG_LOCATION="config.yaml"
export KRAWL_CANARY_TOKEN_URL="http://your-canary-token-url"
# Set number of pages range (min,max format)
export KRAWL_LINKS_PER_PAGE_RANGE="5,25"
# Set analyzer thresholds
export KRAWL_HTTP_RISKY_METHODS_THRESHOLD="0.2"
export KRAWL_VIOLATED_ROBOTS_THRESHOLD="0.15"
# Set custom dashboard path and password
export KRAWL_DASHBOARD_SECRET_PATH="/my-secret-dashboard"
export KRAWL_DASHBOARD_PASSWORD="my-secret-password"
```
Beispiel für einen Docker-Lauf mit Umgebungsvariablen (Standalone-Modus):```bash
docker run -d \
-p 5000:5000 \
-e KRAWL_MODE=standalone \
-e KRAWL_PORT=5000 \
-e KRAWL_DELAY=100 \
-e KRAWL_DASHBOARD_PASSWORD="my-secret-password" \
-e KRAWL_CUSTOM_TEMPLATE_PATH="/templates/custom_page.html" \
-e KRAWL_CANARY_TOKEN_URL="http://your-canary-token-url" \
--name krawl \
ghcr.io/blessedrebus/krawl:latest
```
## Krawl zum Sperren bösartiger IPs verwenden
Krawl verwendet ein reputationsbasiertes System, um Angreifer-IP-Adressen zu klassifizieren, und bietet zwei Möglichkeiten, IP-Listen für die Firewall-Integration zu exportieren.
Der Endpunkt `/api/export-ips` fragt die Datenbank direkt ab und unterstützt die Filterung nach IP-Kategorie (`attacker`, `bad_crawler`, `regular_user`, `good_crawler`) und Ausgabeformat (`raw`, `iptables`, `nftables`):```bash
curl "https://your-krawl-instance/<DASHBOARD-PATH>/api/export-ips?categories=attacker&fwtype=raw"
```
Dies ermöglicht die automatische Blockierung von bösartigem Datenverkehr auf verschiedenen Plattformen:
* [OPNsense und pfSense](https://ipv64.net/v64_blocklist_integration_guide)
* [RouterOS](https://rentry.co/krawl-routeros)
* [IPtables](https://github.com/blessedrebus/krawl/blob/main/plugins/iptables/README.md) und [Nftables](https://github.com/blessedrebus/krawl/blob/main/plugins/nftables/README.md)
* [Fail2Ban](https://github.com/blessedrebus/krawl/blob/main/plugins/fail2ban/README.md)
Vollständige API-Parameter, Beispiele und das Hinzufügen benutzerdefinierter Firewall-Formate finden Sie in der [Firewall Exporters-Dokumentation](https://github.com/blessedrebus/krawl/blob/main/docs/firewall-exporters.md).
Krawl kann gesperrte IPs auch direkt in eine Cloudflare Account IP List zur Verwendung in WAF-Regeln übertragen. Die Synchronisierung läuft als Hintergrundaufgabe und aktualisiert die Liste durch vollständigen Austausch in einem konfigurierbaren Intervall. Siehe die Dokumentation [Cloudflare Banlist Sync](https://github.com/blessedrebus/krawl/blob/main/docs/cloudflare_banlist.md).
## IP-Reputation
Krawl [verwendet Aufgaben, die den aktuellen Datenverkehr analysieren, um eine IP-Reputation](https://github.com/blessedrebus/krawl/blob/main/src/tasks/analyze_ips.py) aufzubauen und kontinuierlich zu aktualisieren. Sie läuft regelmäßig und bewertet jede aktive IP-Adresse anhand mehrerer Verhaltensindikatoren, um sie als Angreifer, Crawler oder regulären Benutzer zu klassifizieren. Die Schwellenwerte sind vollständig anpassbar.
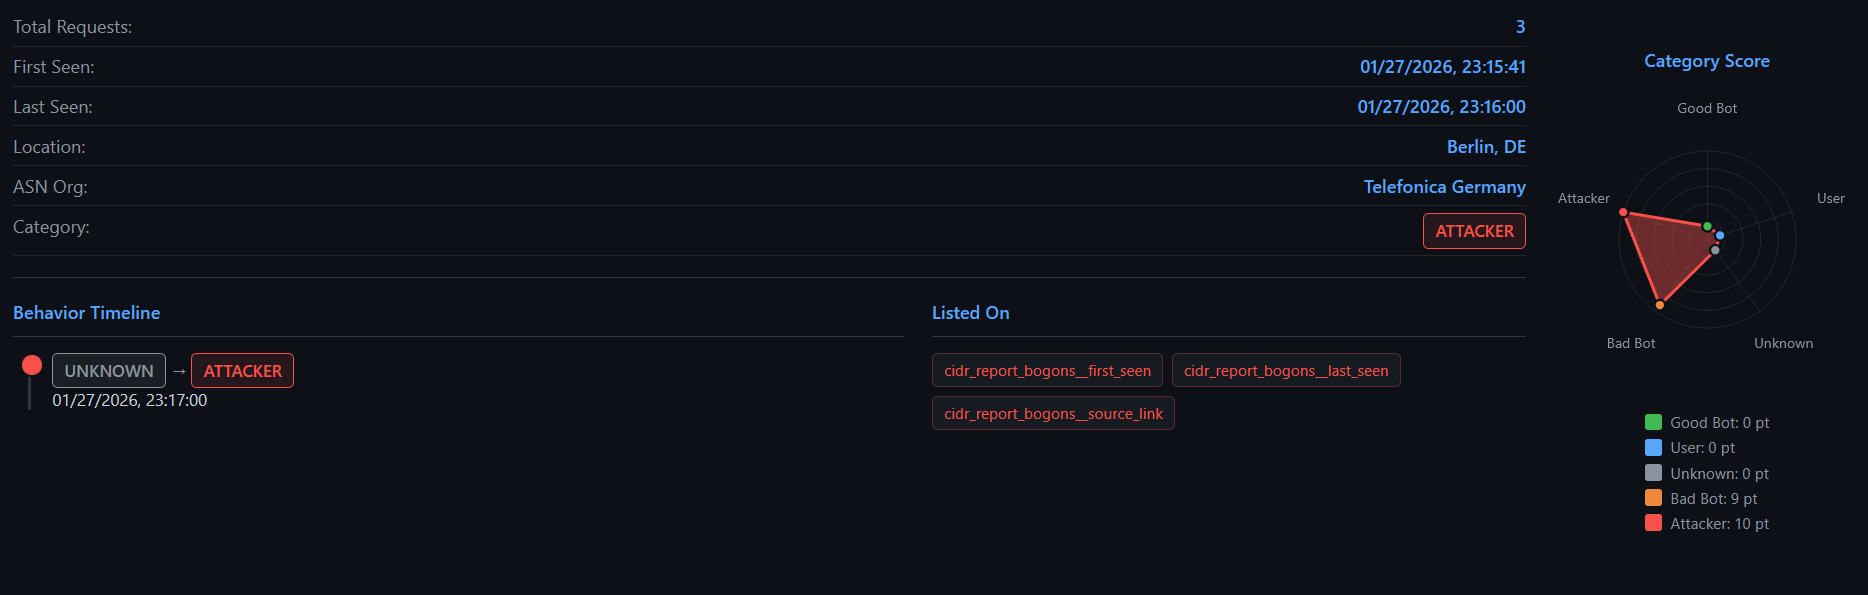
Die Analyse umfasst:
- **Nutzung riskanter HTTP-Methoden** (z. B. Anteile von POST, PUT, DELETE)
- **Robots.txt-Verstöße**
- **Anomalien beim Anfrage-Timing** (bursty oder unregelmäßige Muster)
- **User-Agent-Konsistenz**
- **Erkennung von Angriffs-URLs** (z. B. SQL-Injection, XSS-Muster)
Jedes Signal trägt zu einem gewichteten Bewertungsmodell bei, das eine Reputationskategorie zuweist:
- `attacker`
- `bad_crawler`
- `good_crawler`
- `regular_user`
- `unknown` (bei unzureichenden Daten)
Die resultierenden Bewertungen und Metriken werden in der Datenbank gespeichert und von Krawl verwendet, um Dashboards, Reputationsverfolgung und automatisierte Gegenmaßnahmen wie IP-Sperrung oder Firewall-Integration zu steuern.
## KI-generierte Täuschungsseiten
Krawl kann automatisch realistische Täuschungsseiten mithilfe von KI-Modellen von **OpenRouter**- oder **OpenAI**-APIs generieren. Diese Funktion erstellt einzigartige, plausible Honeypot-Seiten on-the-fly, um Angreifer zu täuschen, ohne manuelle Seitenerstellung.
**Hauptfunktionen:**
- **Dynamische Generierung**: Erstellt einzigartige HTML-Seiten für jeden Anfragepfad
- **Intelligentes Caching**: Zwischenspeichert generierte Seiten, um redundante API-Aufrufe zu vermeiden
- **Tägliche Ratenbegrenzung**: Kontrolliert API-Kosten mit konfigurierbaren Anfragelimits
- **Mehrere Anbieter**: Unterstützung für OpenRouter (kostenlose Optionen) und OpenAI
- **Sanfter Fallback**: Fällt auf Standard-Honeypot zurück, wenn deaktiviert oder Limit erreicht
- **Zwischengespeicherte Bereitstellung**: Zuvor generierte Seiten werden auch bei deaktivierter KI bereitgestellt
**Schnelle Einrichtung:**```yaml
ai:
enabled: true
provider: "openrouter"
openai_base_url: "your-custom-base-url"
api_key: "your-api-key"
model: "nvidia/nemotron-3-super-120b-a12b:free"
timeout: 60
max_daily_requests: 10
```
Für eine detaillierte Konfiguration und Nutzung siehe die [AI Generation-Dokumentation](https://github.com/blessedrebus/krawl/blob/main/docs/ai_generation.md).
Du kannst auch **Deception-Templates beitragen**, indem du einen PR öffnest, siehe [Contributing Deception Templates](https://github.com/blessedrebus/krawl/blob/main/docs/deception_pages.md#contributing-deception-templates-via-pr).
## Betrieb hinter einem Reverse Proxy oder CDN
```
---
[Read more](https://github.com/blessedrebus/krawl)
