#1
Tools für LLM-Sicherheit, Prompt-Injection, Modellextraktion, adversariales KI und KI-Red-Teaming.
Kitploit empfohlen
 microsoft/ai-red-teaming-playground-labs
KI-Red-Teaming-Übungsplattform mit Labs zur Durchführung von KI-Red-Teaming-Schulungen, einschließlich Infrastruktur.
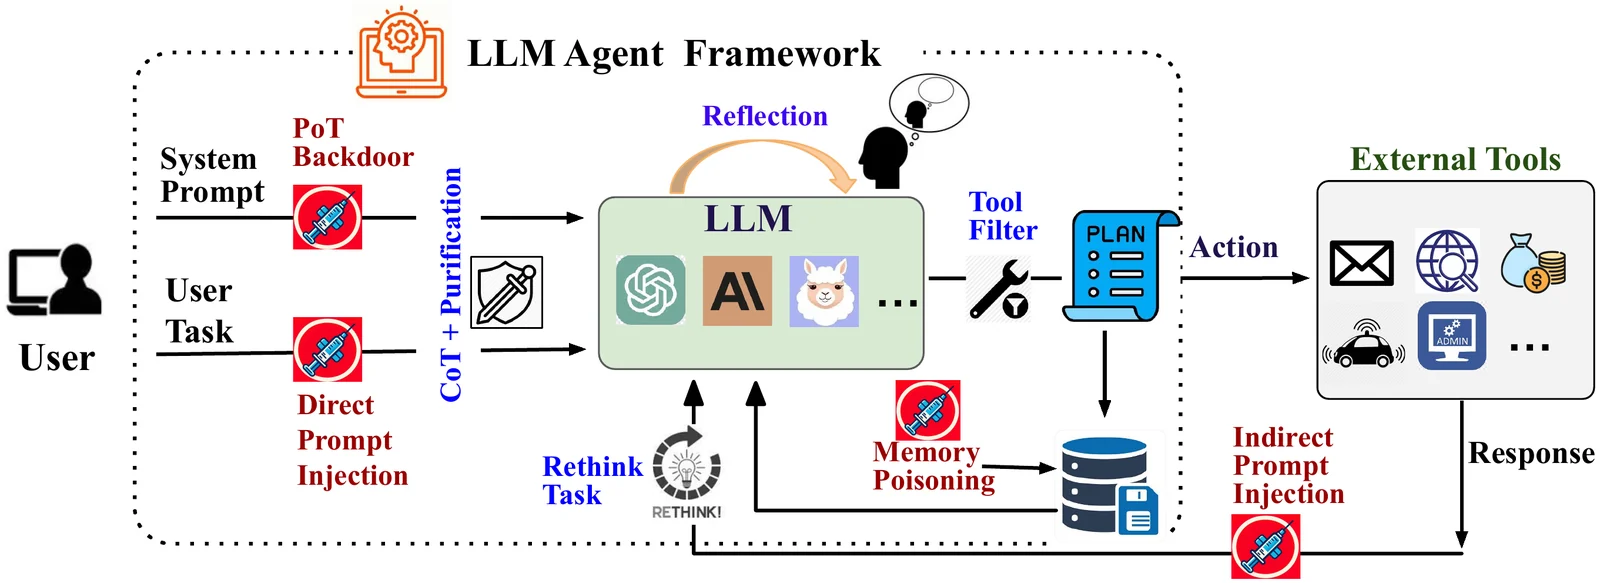 xiaoyan-lisa/defenses-for-tool-integrated-llm
Forschungscode und Experimente zur Verteidigung von tool-integrierten LLM-Agenten gegen adversariale Angriffe, die das Agent Security Bench um neue…
 db-ol/cuaharm
Benchmark zur Bewertung von Sicherheitsrisiken computernutzender Agenten, mit 104 realistischen Missbrauchsszenarien in sieben bösartigen Kategorien,…
 alphawarheads/watermark_spoofing
Forschungscode und Datensatz (WSD) zur Bewertung der Auswirkungen von Audio-Wasserzeichen auf Anti-Spoofing, unter Verwendung von wav2vec2 XLS-R und…
 trinib/zorg-jailbreak-prompt-text
Umgehe eingeschränkte und zensierte Inhalte bei KI-Chat-Prompts 😈
 doubangotelecom/facelivenessdetection-sdk
3D Passive Face Liveness Detection (Anti-Spoofing) & Deepfake-Erkennung. Ein einzelnes Bild wird benötigt, um den Liveness-Score zu berechnen. 99,67…
 trailofbits/privacyraven
Datenschutz-Testbibliothek für Deep-Learning-Systeme, die die Bewertung der Anfälligkeit für Membership-Inference-Angriffe, Modellextraktion und…
 aaryanbhujang/cve-2024-3660-poc
Ein PoC für CVE-2024-3660. Beliebige Codeausführung in Keras.
 adityabhatt3010/cve-2025-54794-hijacking-claude-ai-with-a-prompt-injection-the-jailbreak-that-talked-back
Eine Schwachstelle durch Prompt Injection mit hohem Schweregrad in Claude AI beweist, dass selbst die intelligentesten Sprachmodelle zu Waffen werden…
 jpts/cve-2025-23266-poc
Proof-of-Concept-Exploit für CVE-2025-23266 (NVIDIAScape), der den NVIDIA-AI-Container-Runtime angreift. Demonstriert Container-Escape über eine…
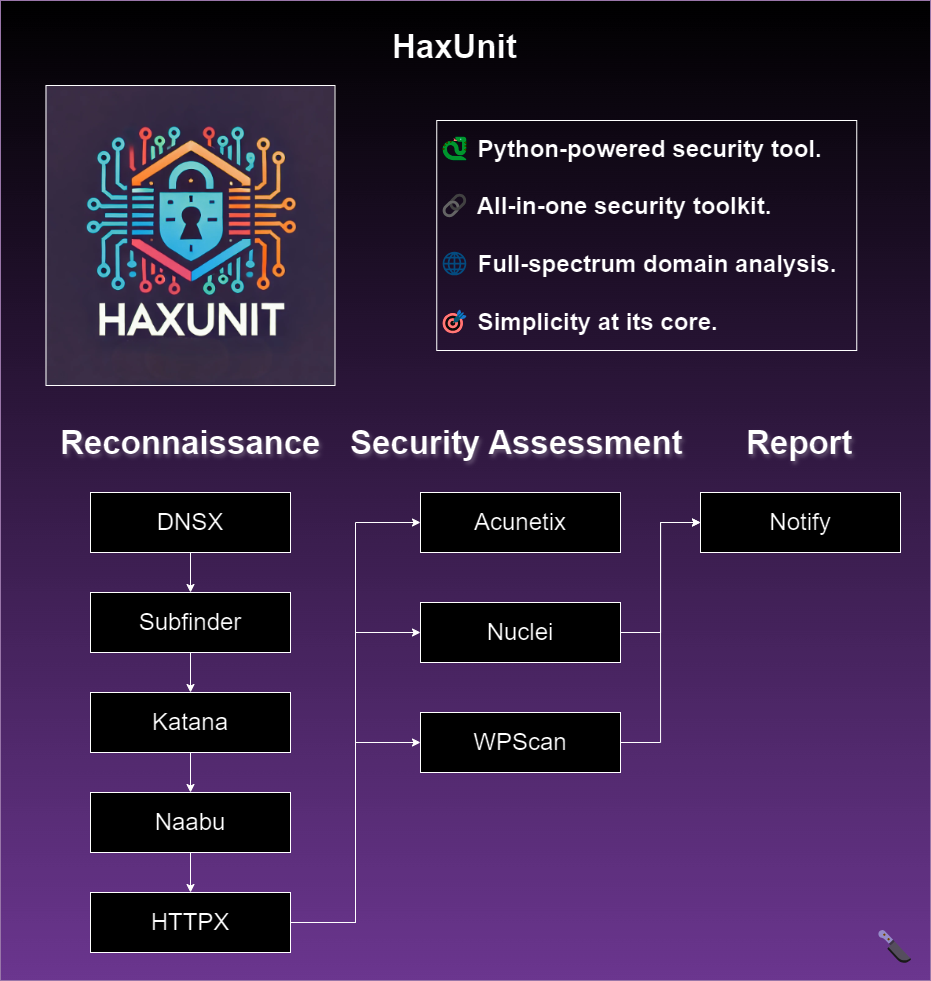 bandit-haxunit/haxunit
Automatisiertes Web-Domain-Reconnaissance- und Sicherheitsbewertungstool, das Subdomain-Enumeration, Port-Scanning, Schwachstellenscan und…
 rooobeam/pickle-deserialization-exploit-in-transformers
Diese Studie analysiert Schwachstellen in der Deserialisierung von Python-Pickles, mit Fokus auf CVE-2024-3568 in Hugging Face Transformers'…
 sej2020/manipulating-web-agents
Forschungsdemonstration von indirekten Prompt-Injection-Angriffen zur Kontrolle autonomer LLM-basierter Web-Agenten, mit Werkzeugen zur…
 daryllundy/cve-2025-32711
PowerShell-basiertes Erkennungs- und Behebungstoolkit für CVE-2025-32711 (EchoLeak), eine kritische Zero-Click-AI-Befehlsinjektionsschwachstelle in…
 0xgh057r3c0n/cve-2025-3248
Exploit für Langflow AI Remote Code Execution (Unauthenticated)
 stair-lab/certified-unlearning-neural-networks-icml-2025
Code für das Paper Certified Unlearning for Neural Networks, ICML 2025
 hondamunigeprasannasilva/attack-attention
[CVPR 2025-ADVML] Offizielles Repository für `Attacking Attention of Foundation Models Effectively Disrupts Downstream Tasks`
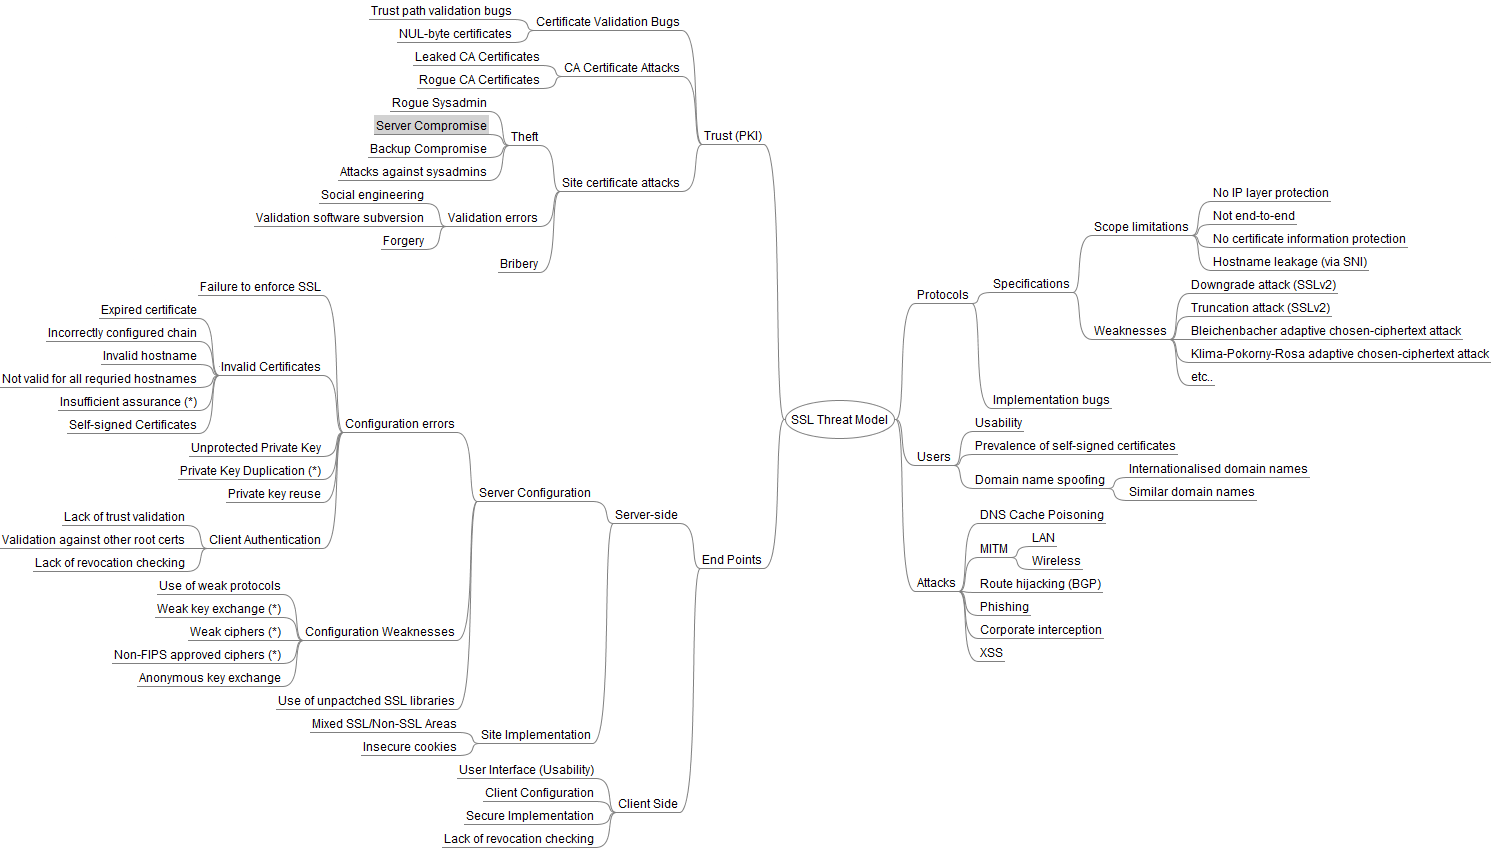 taleliyahu/threat_model_examples
Eine Sammlung realer Bedrohungsmodell-Beispiele aus verschiedenen Technologien, die praktische Einblicke in die Identifizierung und Minderung von…