██╗     ███████╗███████╗████████╗
██║     ██╔════╝██╔════╝╚══██╔══╝
██║     █████╗  █████╗     ██║
██║     ██╔══╝  ██╔══╝     ██║
███████╗███████╗███████╗   ██║
╚══════╝╚══════╝╚══════╝   ╚═╝

 ██████╗ ██████╗ ███████╗██╗   ██╗███████╗ ██████╗ █████╗ ████████╗ ██████╗ ██████╗
██╔═══██╗██╔══██╗██╔════╝██║   ██║██╔════╝██╔════╝██╔══██╗╚══██╔══╝██╔═══██╗██╔══██╗
██║   ██║██████╔╝█████╗  ██║   ██║███████╗██║     ███████║   ██║   ██║   ██║██████╔╝
██║   ██║██╔══██╗██╔══╝  ██║   ██║╚════██║██║     ██╔══██║   ██║   ██║   ██║██╔══██╗
╚██████╔╝██████╔╝██║     ╚██████╔╝███████║╚██████╗██║  ██║   ██║   ╚██████╔╝██║  ██║
 ╚═════╝ ╚═════╝ ╚═╝      ╚═════╝ ╚══════╝ ╚═════╝╚═╝  ╚═╝   ╚═╝    ╚═════╝ ╚═╝  ╚═╝

A simple obfuscator for C/C++ x64 and x86 code
这是作为 LLVM 分支制作的,因此你需要实际的源代码才能进行混淆。它不是任意可执行文件的混淆器。它是编译器的修改版本。
如果你想查看结果,我用它制作并混淆了 2 个 crackme。你可以在 releases 中获取它们,以及预编译的 clang 二进制文件。
所有这些都使用 -O3 标志编译,所有截图均来自 IDA Pro 9.4。我也用 Binary Ninja 和 Ghidra 测试过,结果要么相同要么更差。
在编译时加密字符串,并在每次使用加密字符串时插入一个解密函数。这完全禁用了在二进制文件中搜索任何字符串的能力。并且每个字符串在解密函数中都有自己唯一的硬编码密钥,这使得转储和解密它们变得更加困难。这些解密函数也会被内联。(下面未内联仅用于展示)
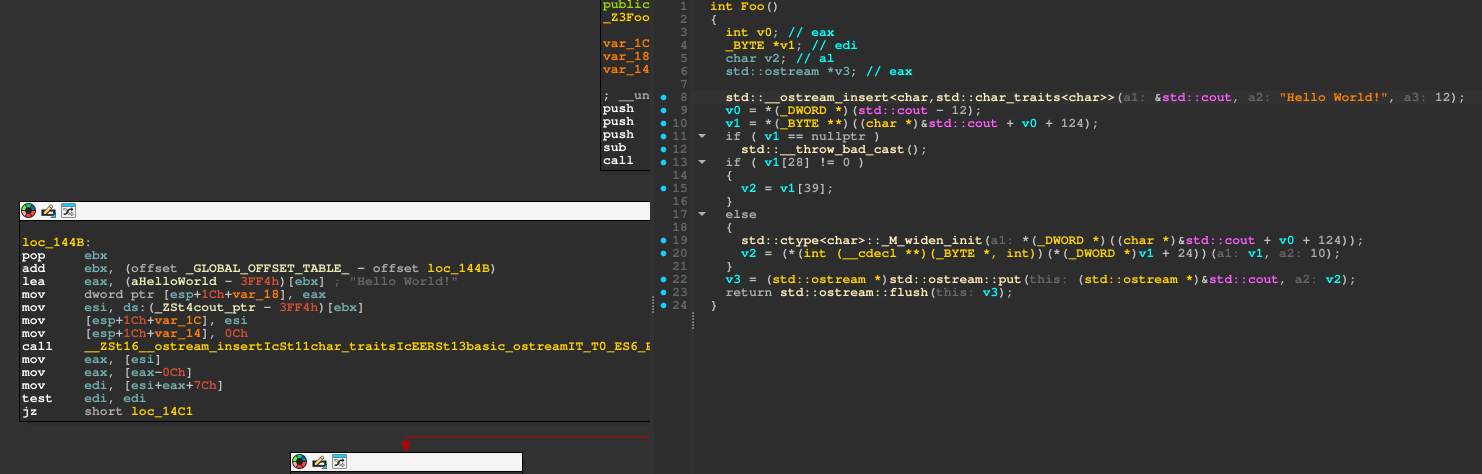 Pass 之前 |
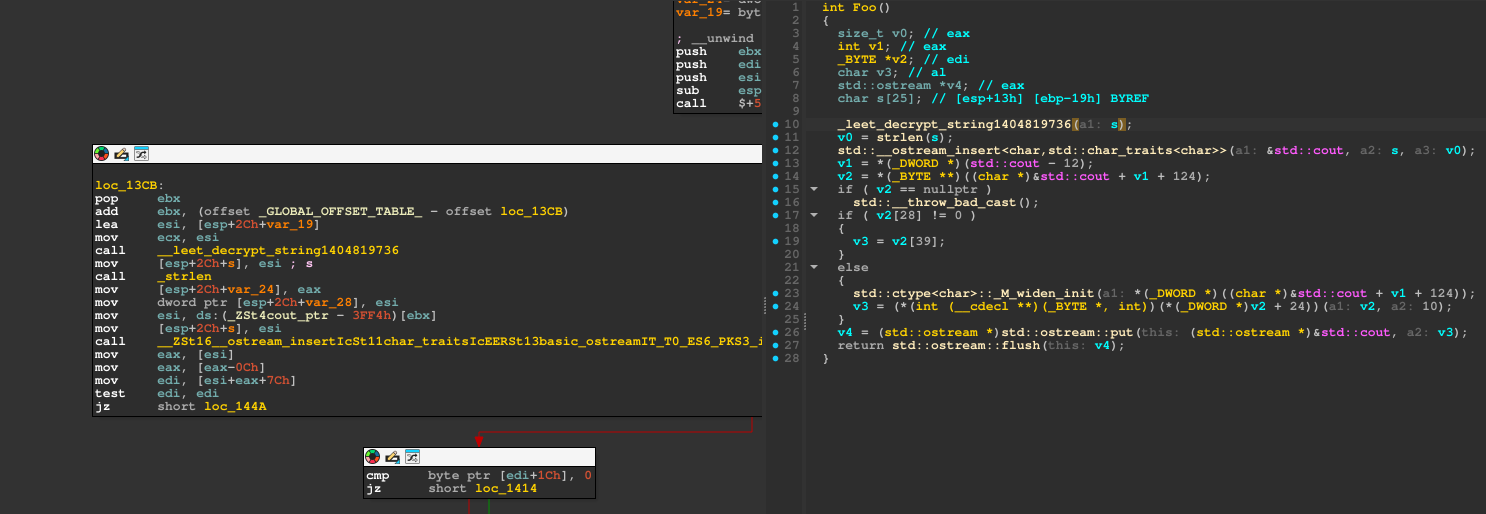 之后 |
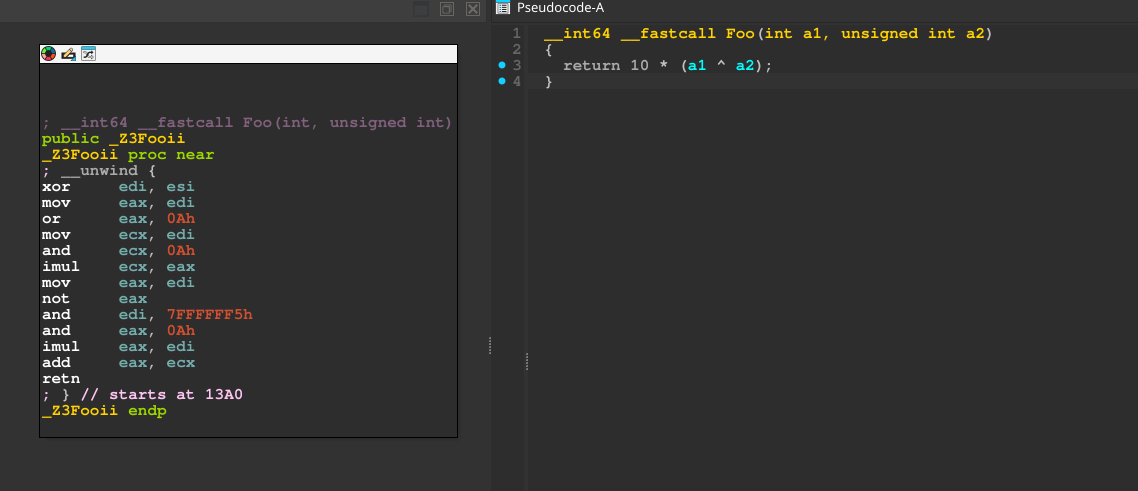
将算术运算替换为其 MBA 等价形式。除非你先通过 MBA 反混淆器运行它,否则基本上不可能看出原始操作做了什么。当然这种混淆有点弱,因为 MBA 是最古老的把戏,所以有很多工具可以处理它,例如 CoBRA,它会成功将其反混淆为原始表达式:
./cobra-cli --mba "((x^y) - (((x^y)&0xFF)&0xA) + 10) * ((x^y) - ((x^y)|0xA) + 10) + ((x^y) - (((x^y)&0xFF)|0xFFFFFFF5) - 11) * (~(x^y) - (~(x^y)|0xA) + 10)" --bitwidth 32

10 * (x ^ y)
这就是我实现 AAMBA pass 的原因。
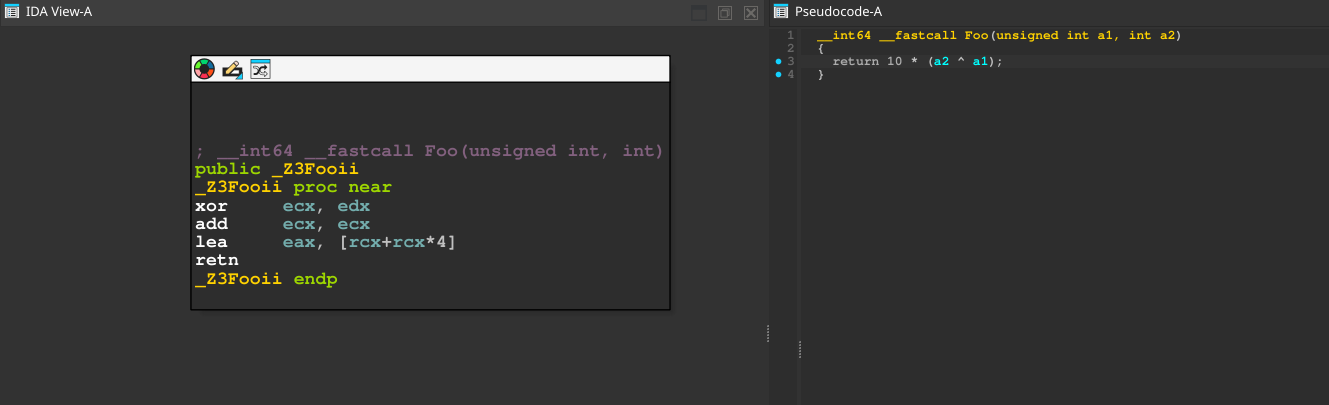 Pass 之前 |
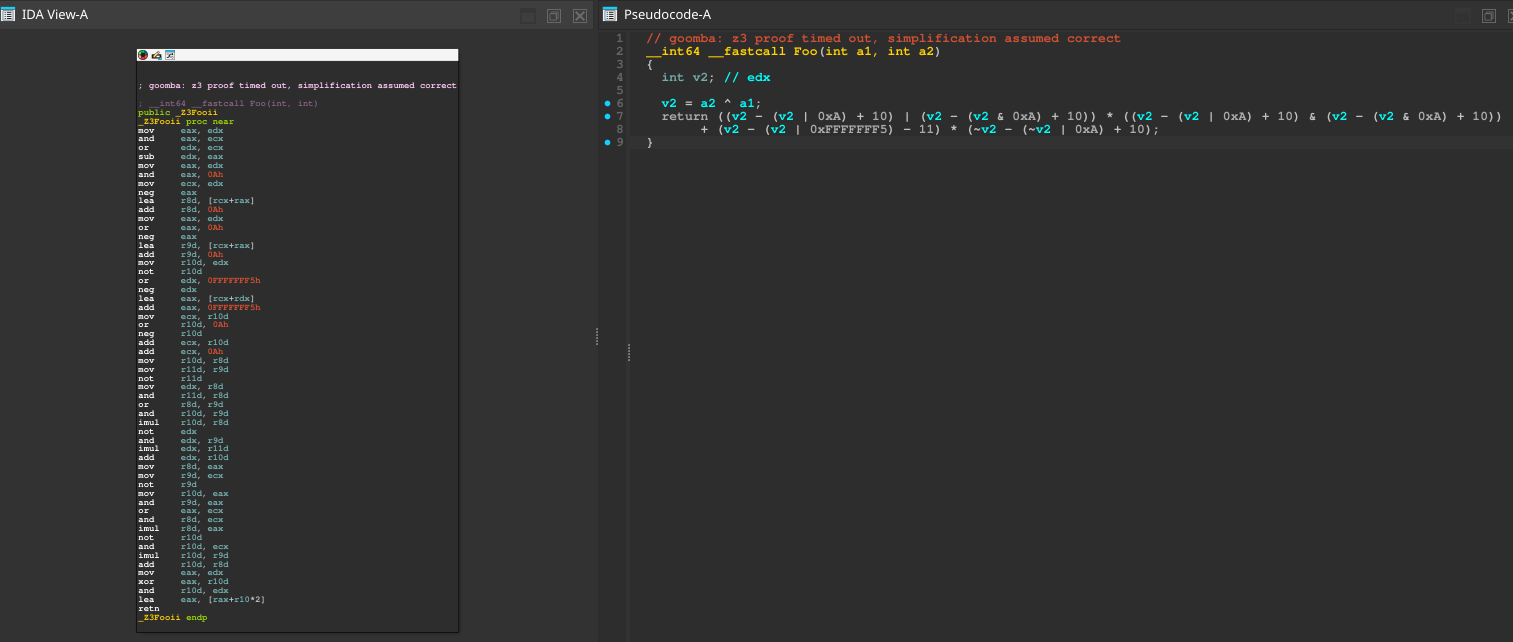 之后 |
将二元运算的操作数替换为 ADC(X, 255) - 255 - CF 和 SBB(X, 255) + 255 + CF。当然,它始终求值为 X,但它使表达式依赖于进位标志。除非反编译器跟踪 CF 的状态(有时这是不可能的),否则它会变得非常困惑,无法折叠这些表达式。它与之前的 MBA pass 配合得非常好,能进一步混淆算术运算。如下所示,反编译器创建了一些额外的变量,并使用了大量 __PAIR64__ 和 __CFADD__ 调用,因此将其粘贴到 CoBRA 等工具中变得困难得多(但仍非不可能),IDA 的 gooMBA 插件在简化此内容方面也无济于事。此外,IDA 的反编译器确实在一定程度上跟踪进位标志,但将其与控制流混淆结合使用,使得在没有执行的情况下跟踪基本上不可能,因为你不知道之前的操作是什么,也许它将 CF 设置为 1,也许没有,因此后续的 pass 会在此基础上进一步叠加。
|
Pass 之前 |
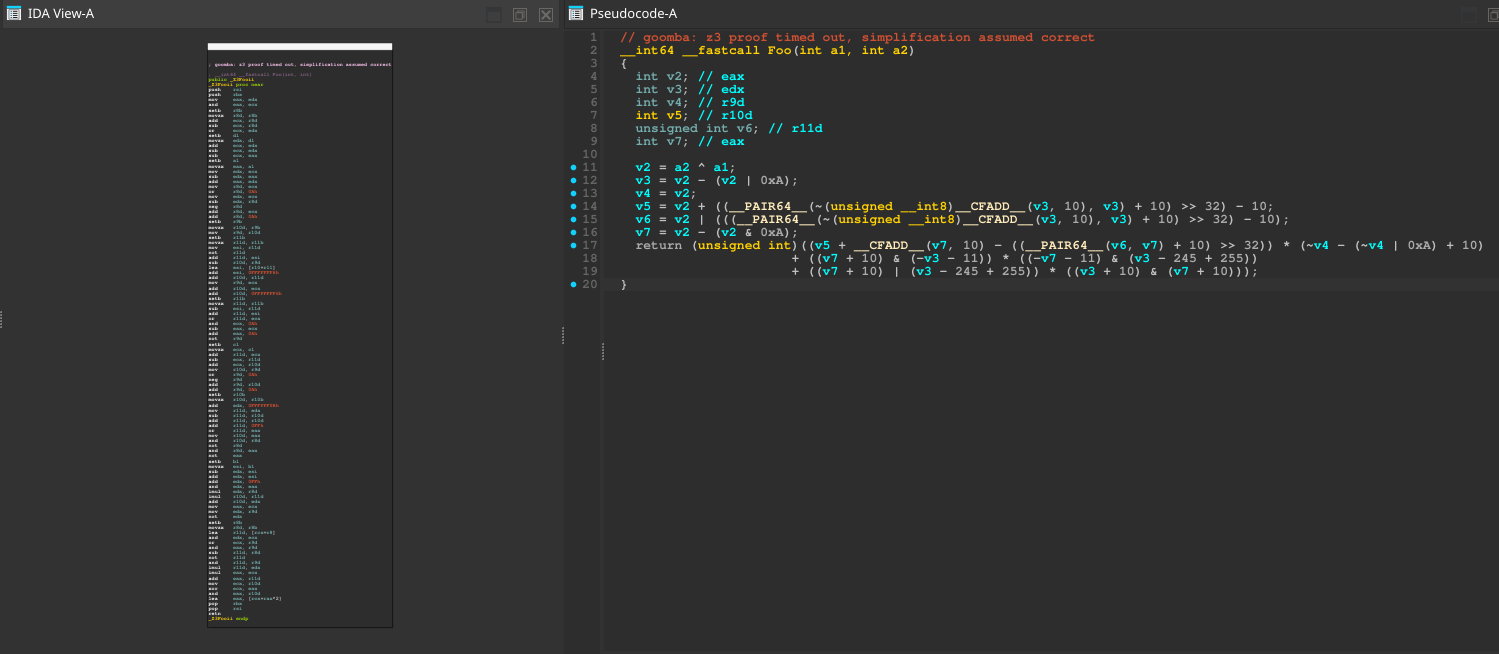 之后 |
收集函数内的所有基本块,并将它们变成一个巨大的状态机,它在函数开头创建一个跳转表,并将所有基本块指针放入其中。然后,每个基本块末尾不再是正常的跳转,而是所有内容都通过使用间接跳转的分发器进行路由,这些间接跳转在没有执行的情况下几乎不可能静态解析。它还会将寄存器降级到栈上,因此如果你将一个基本块分成两半,前一个基本块中的所有变量都将位于栈上,这意味着每个表达式中都会有大量变量。如果你通过 CoBRA 运行单个基本块的操作,它将无法进行太多反混淆,因为会有太多未知变量。
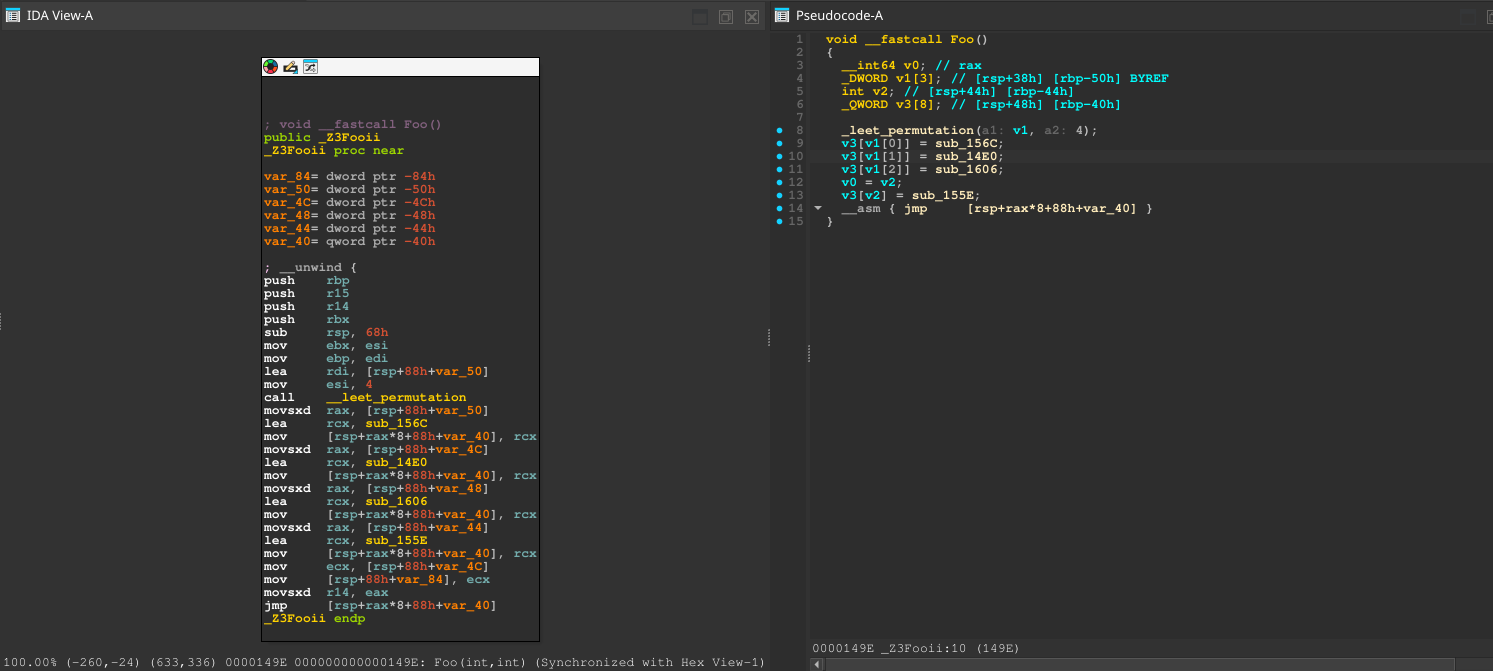
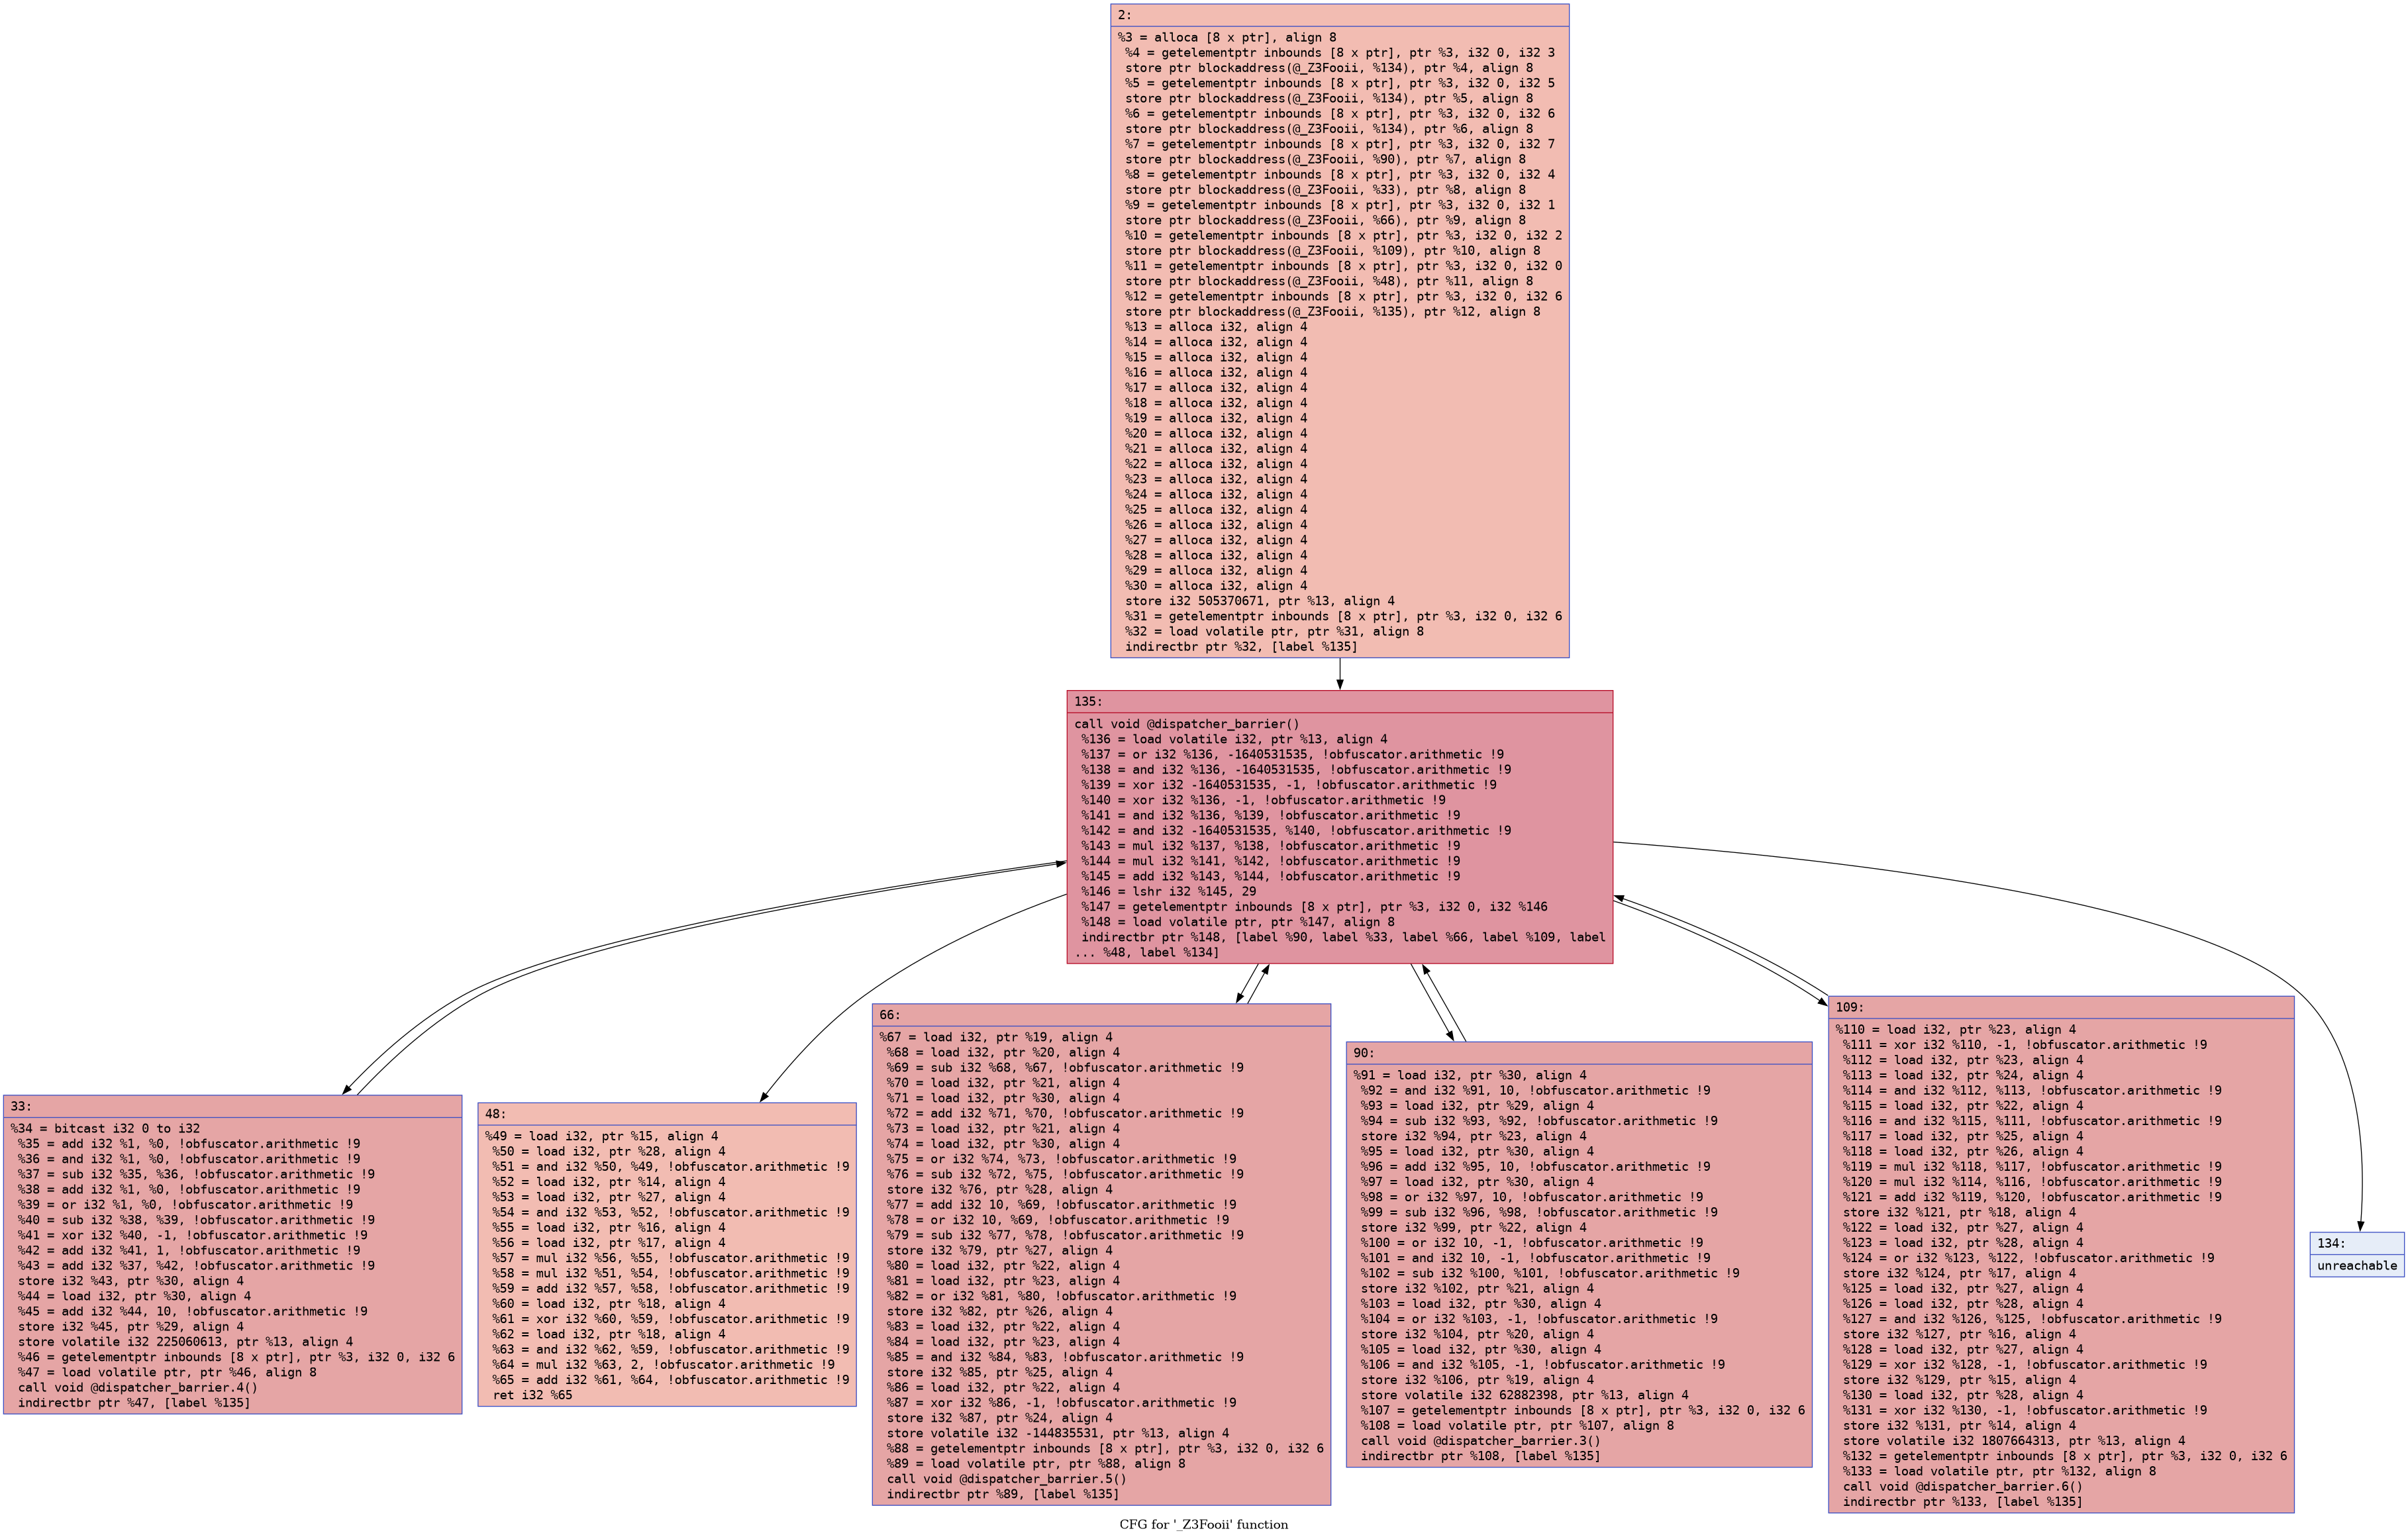
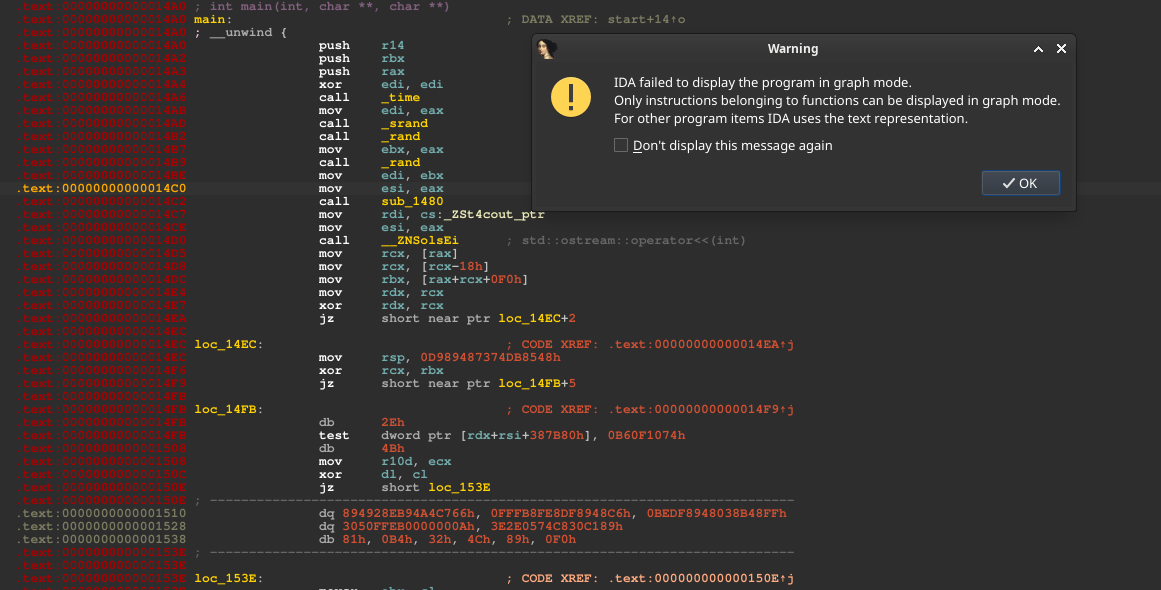
创建一堆包含无效汇编的虚假基本块。这极大地干扰了反汇编器,因为如果反汇编器遇到一个技术上无效但永远不会被执行的字节,它仍然会尝试理解它。因此,如果该字节不完整,它将从紧随其后的任何字节创建一条指令,实质上消耗了它们。这会造成不同步,破坏其后的每条指令。在 Windows 二进制文件上,IDA 能够在一定程度上恢复,在极少数情况下能够生成图形并反编译它所能反编译的内容(尽管它将是损坏且不完整的),而在 Linux 二进制文件上,它会完全破坏图形视图并禁用反编译。此外,它还会插入 RDTSC 计时器和一些其他反调试检查,如果检测到调试器,就会崩溃。
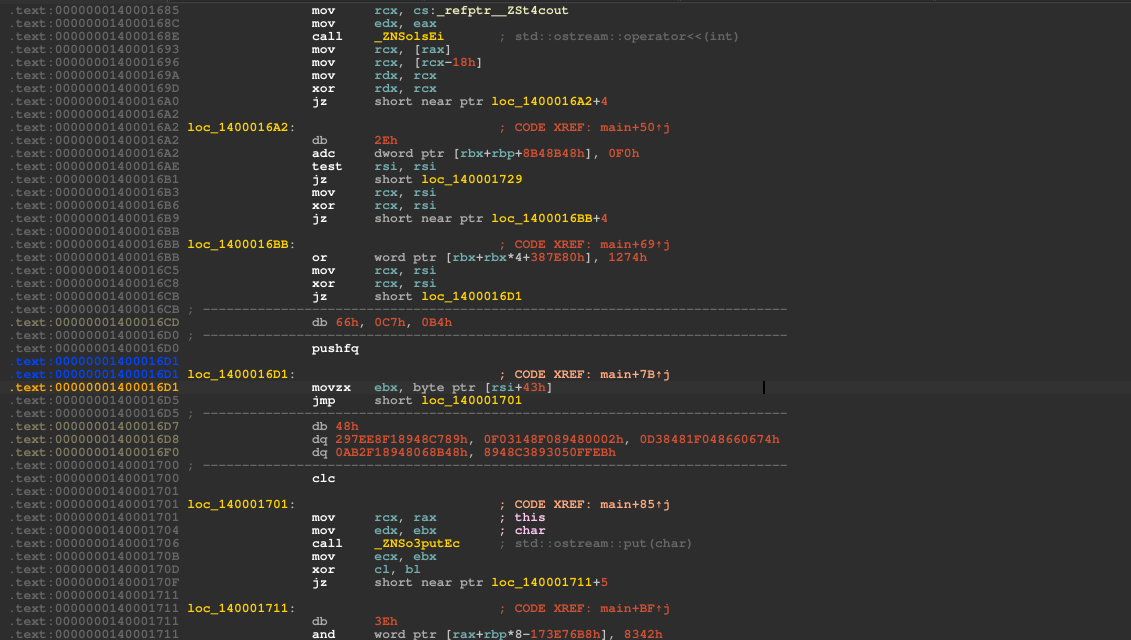 Windows |
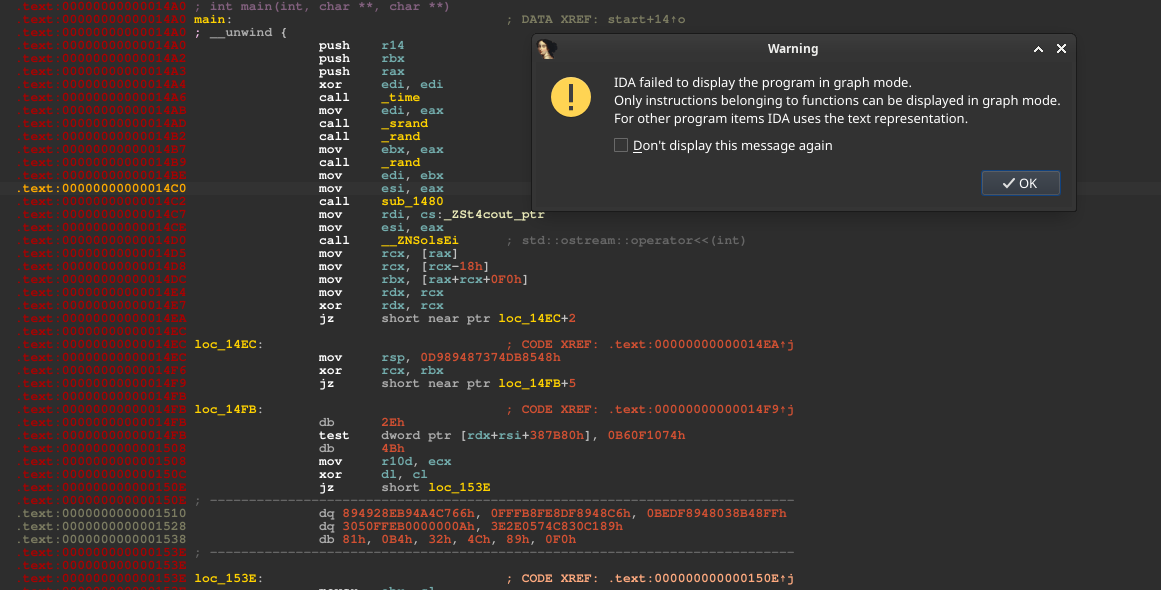 Linux |
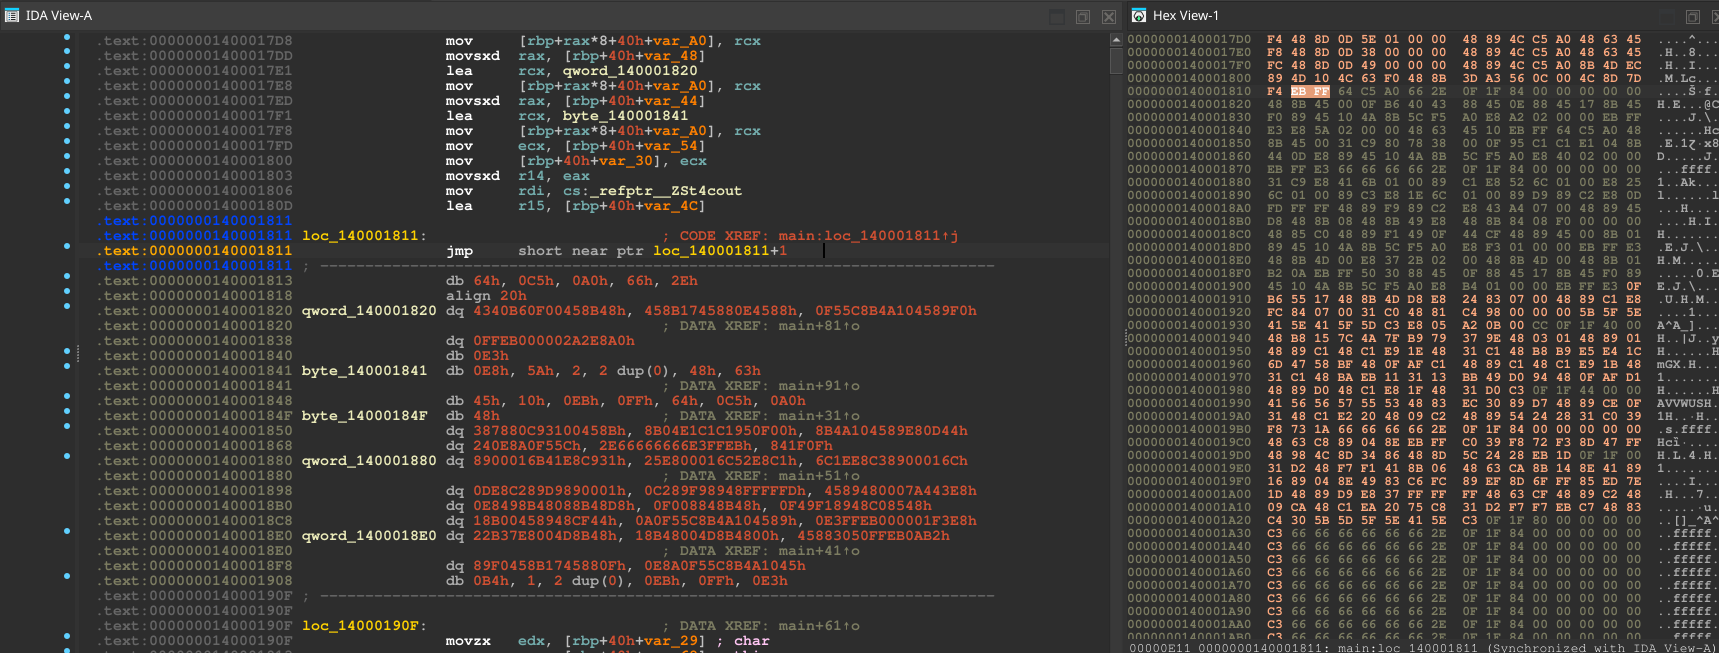
除此之外,如果该 pass 遇到任何以 0xFF 开头的指令,它会在其前面插入一个 0xEB 字节。这会创建 JMP RIP+1,因此控制流保持不变(RIP 只是前进一个字节进入原始指令),但反汇编器会再次失去同步。
以 0xFF 开头的指令主要是 INC/DEC 和间接 JMP/CALL。遗憾的是,大多数普通调用和跳转都是相对的(0xE8/0xE9/0xEB),不受影响。但该技术在调度器 pass 中特别有用,因为那里的一切都使用间接跳转。不过它对调用就没那么有用了,受此影响的调用只有间接调用,通常是虚调用、通过函数指针的调用,以及一些外部/库调用。
将变量拆分为多个部分,并对每个部分单独执行操作,与 MBA pass 配合得非常好,使简单的逻辑比原本更加复杂。简单来说,int32 可以拆分为 4 个 int8,如果对其执行任何受支持的操作(AND, OR, XOR, ADD, SUB, ICMP),该操作将逐个作用于这些 int8,而不是原始的 int32。
 该 pass 之前 |
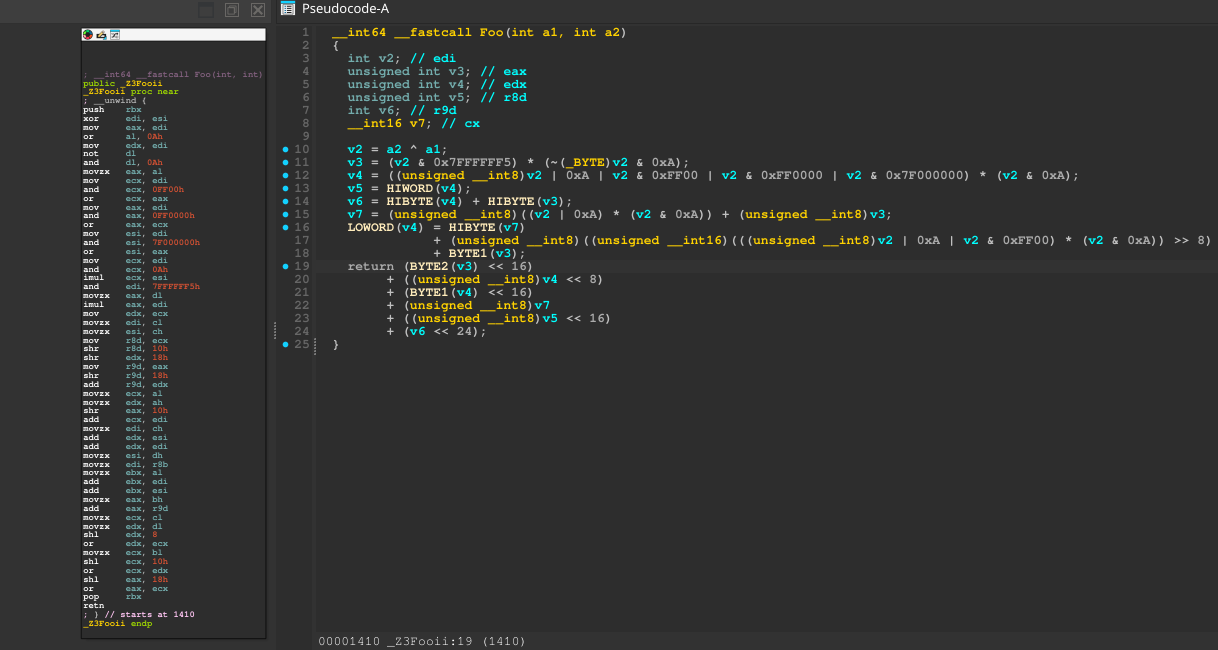 之后 |
将函数中的每个栈局部变量都放入一个大的共享栈缓冲区,其索引在每次运行时随机化并在运行时计算。这样反编译器就无法对变量进行别名分析,导致对同一变量的多次访问显示为访问不同的值。这与调度器和变量拆分 pass 配合得非常好。调度器将寄存器降级到栈上,而变量拆分将它们拆分为多个变量,因此会有大量这样的栈槽。
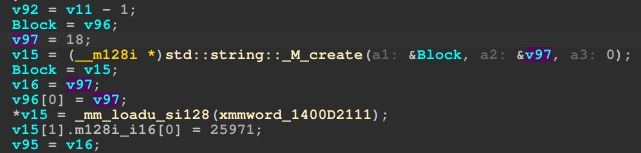 该 pass 之前 |
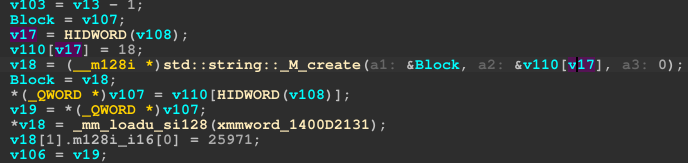 之后 |
通过异常来混淆控制流。它将所有调用替换为 int3 陷阱。当陷阱被触发时,控制流转到异常处理程序,该处理程序调整 RIP 到实际的调用。它还会在陷阱之后立即插入无效字节,以进一步使反汇编器失去同步。
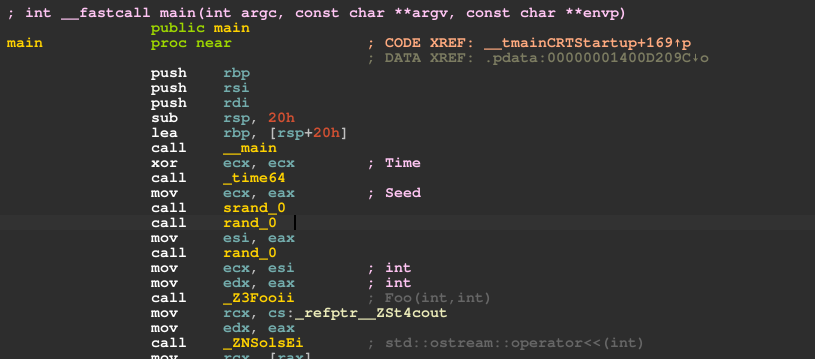 该 pass 之前 |
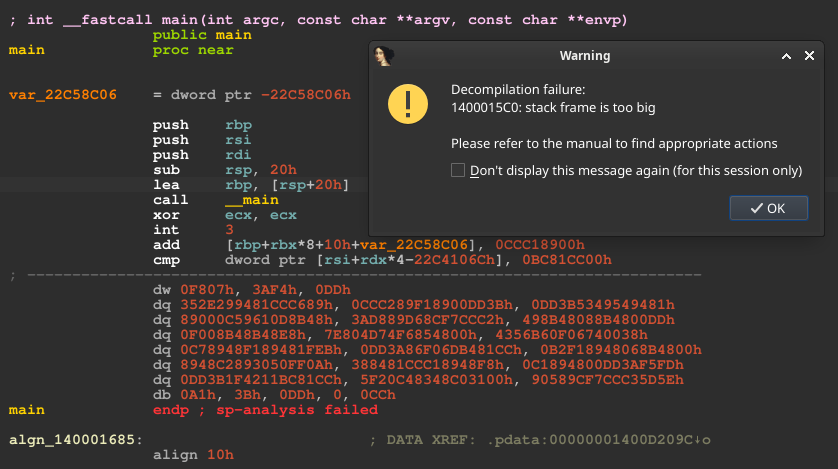 之后 |
通过组合所有 pass,如果没有一些额外的工具来对此进行反混淆,静态分析将变得非常困难。即使你设法将所有无效字节 nop 掉,并且能够将其反编译为某种伪代码或至少获得图形视图,你仍然要面对通过异常和调度器实现的控制流混淆,即使你突破了这些,还有堆积如山的冗余 MBA、虚假块、拆分的栈变量和字符串加密来混淆实际的操作。以下是包含之前那个简单 xor Foo 函数的简单程序的主入口点在三大反汇编器中的截图。如你所见,它们对此无能为力。
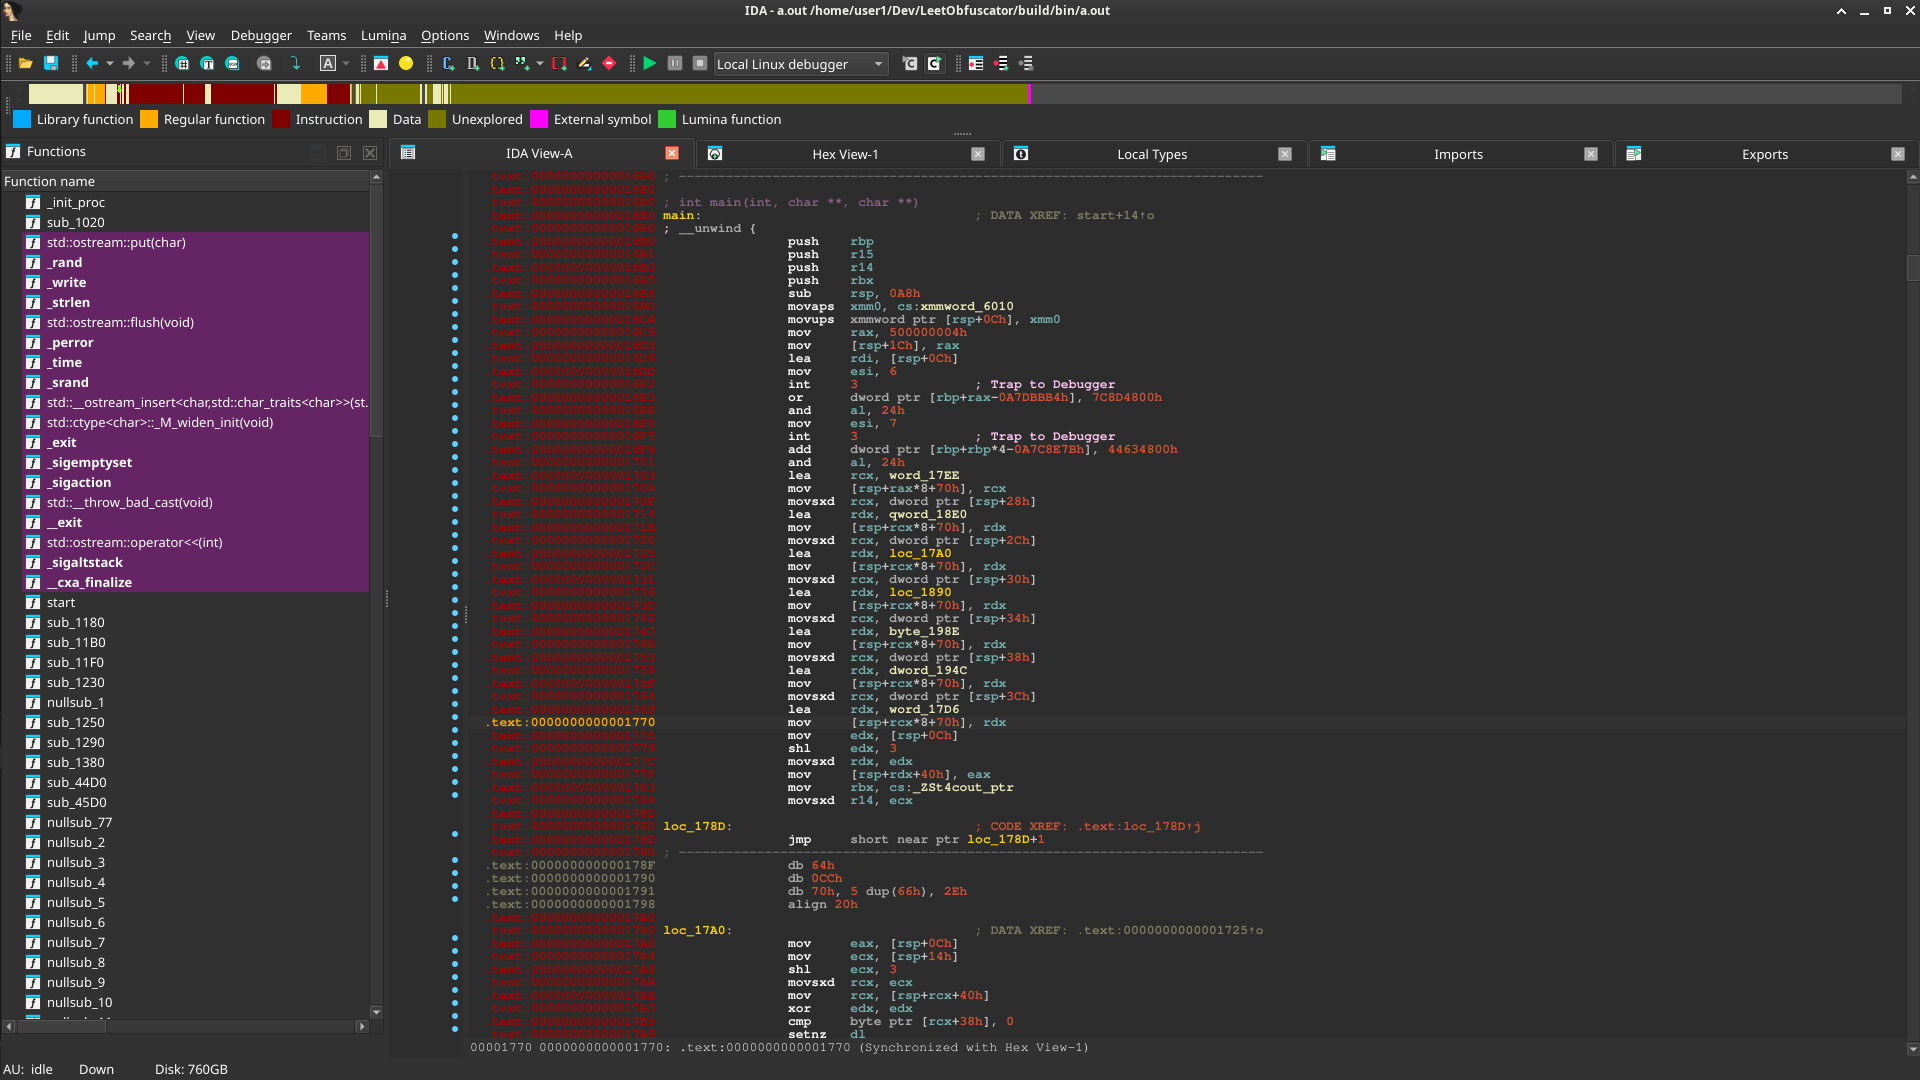 IDA Pro 9.4 |
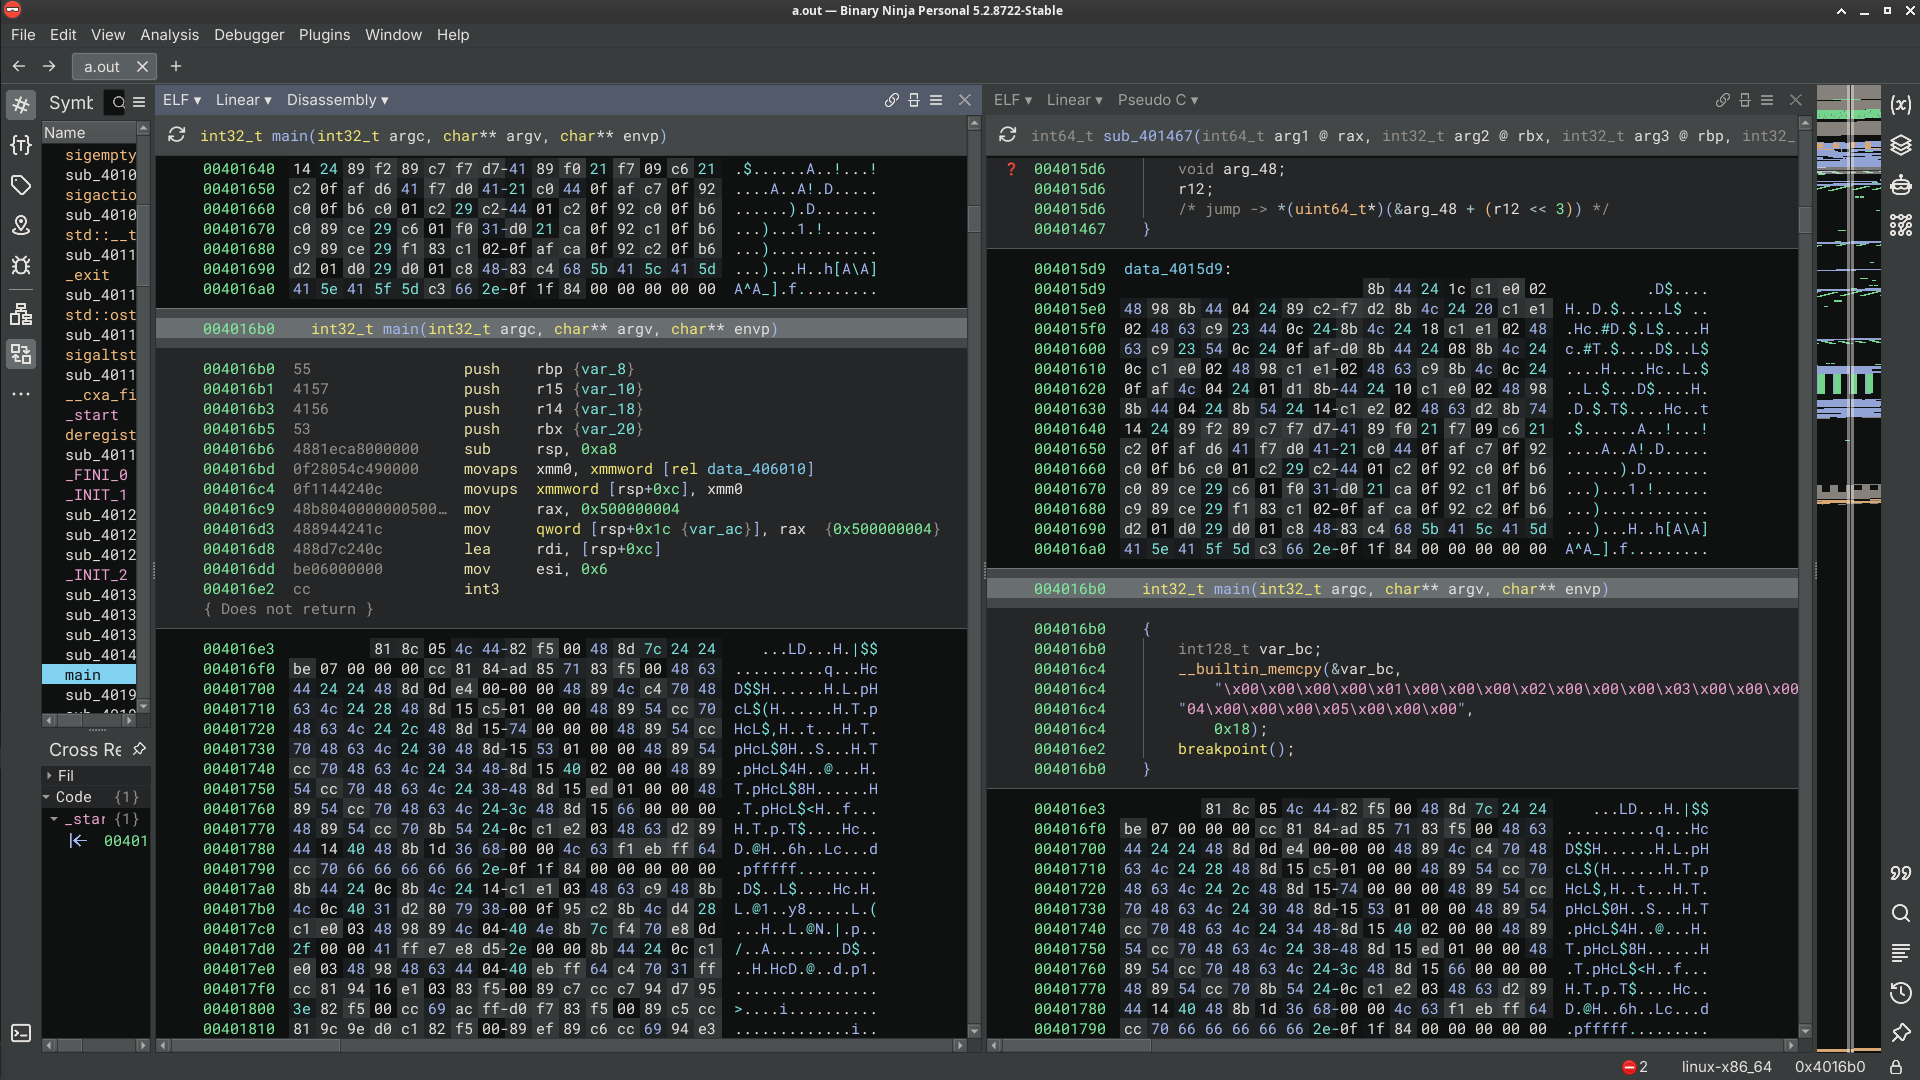 Binary Ninja Personal 5.2 |
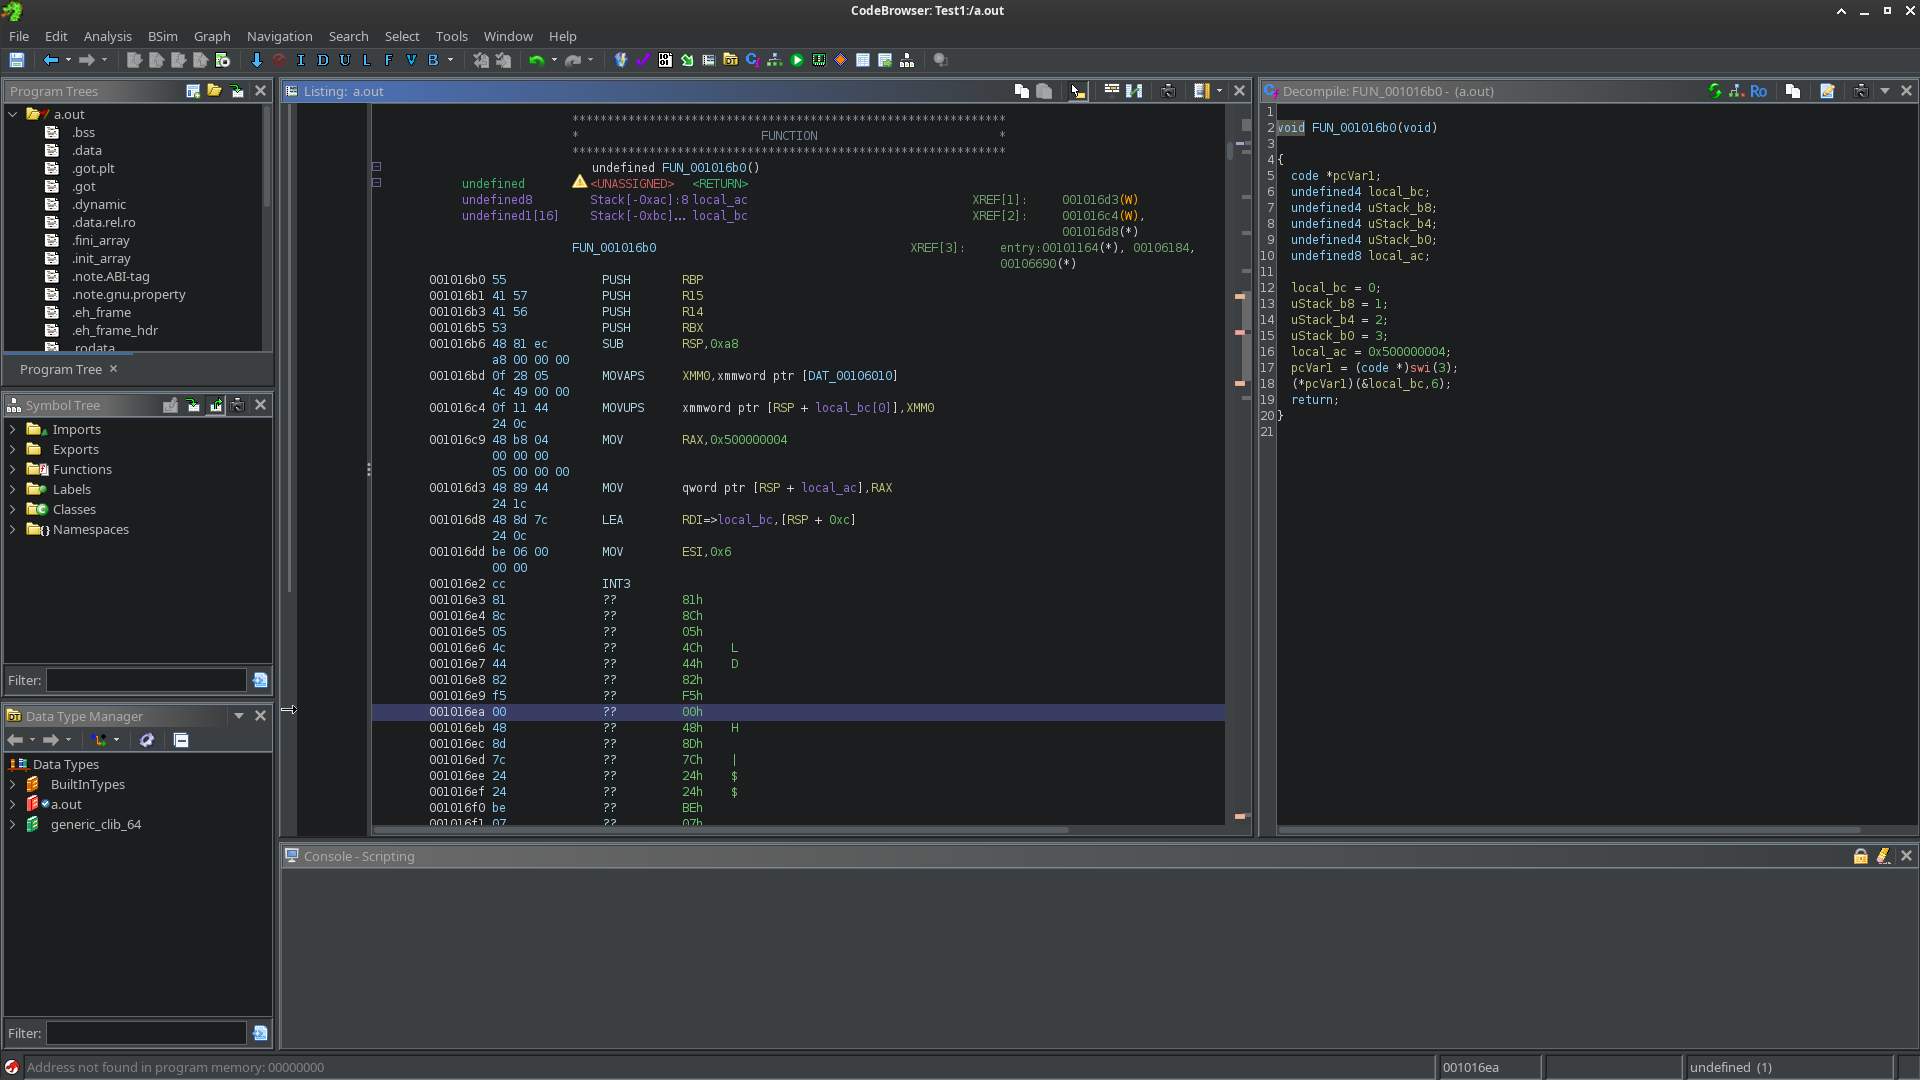 Ghidra 12.1.2 |