
 soxoj/telegram-bot-dumper
转储 Telegram 机器人。像 Telegram Web 一样浏览它。具有 Web 界面的取证 CLI 工具

轻松导出 Telegram 机器人的全部内容。
输入:仅需机器人 token。
输出:机器人名称与信息、所有聊天的文本历史与媒体、机器人的用户信息与照片。
这是一个 Python 实现。
📖 完整文档:https://telegram-bot-dumper.readthedocs.io
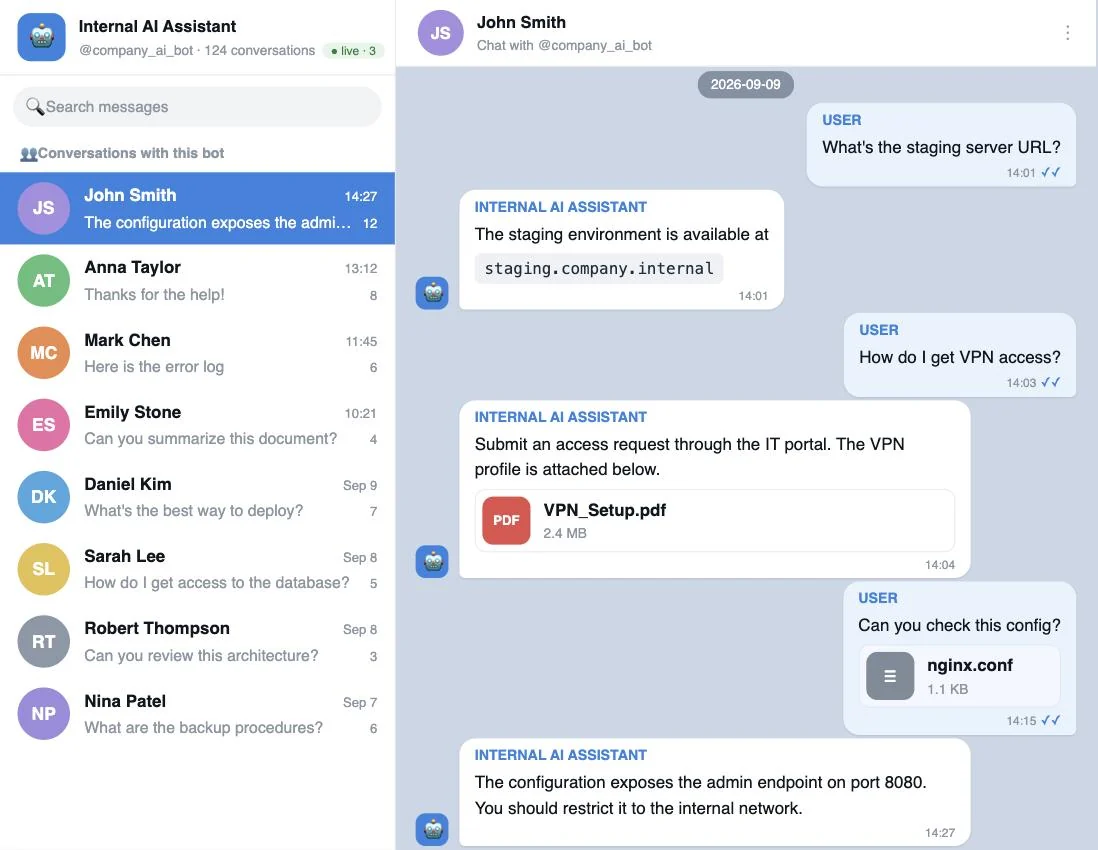
一个类似 Telegram Web 的浏览器界面,用于查看导出数据:聊天列表、带内联媒体的完整消息历史、带照片轮播的用户资料,以及跨所有会话的全局搜索。支持实时模式:它在后台运行导出工具,并将新消息实时推送到浏览器。
打开一个会话并选择 Download chat,即可将其历史记录、媒体和照片保存为 dump_<bot_id>_<chat_id>.zip。该压缩包保留 <bot_id>/<chat_id>/ 目录结构,并排除其他聊天和机器人级别的文件。
使用场景——对泄露的机器人 token 进行渗透测试。 Telegram 机器人 token 在渗透测试中屡见不鲜——硬编码在移动端/桌面应用中、提交到代码仓库,或存在于 CI 日志、配置文件或客户端打包文件中。单独来看,一个 token 似乎只是低危发现;但在这里加载它,就能揭示真正的爆炸半径。对于内部机器人(支持台、IT/DevOps 助手、AI 助手)而言,这意味着与它的每一次员工对话——内部主机名、VPN 配置、凭据和基础设施细节——都可浏览、可搜索,从而让你界定影响范围,并在报告中为发现提供证据。
docker run --rm -p 127.0.0.1:8010:8010 -v "$PWD:/data" soxoj/telegram-bot-dumper-web
docker compose up --build # builds and serves on http://127.0.0.1:8010
pip install -r requirements.txt
python webapp/server.py        # serves dumps from the repository folder on :8010
./run-viewer.sh                # live mode + dumping new bots, API_ID/API_HASH from .env
打开 http://127.0.0.1:8010 并粘贴 bot token 以打开其 dump:它必须与该 dump 的 bot.json 中保存的 token 匹配。只读查看无需 API 凭据。实时模式 额外需要来自 my.telegram.org 的 API_ID/API_HASH,通过环境变量传入——绝不要烘焙进镜像:
# one-off container
docker run --rm -p 127.0.0.1:8010:8010 -v "$PWD:/data" \
  -e API_ID=123456 -e API_HASH=abc... soxoj/telegram-bot-dumper-web

# or with docker compose: put them in a local .env (see .env.example)
cp .env.example .env && $EDITOR .env && docker compose up
PORT 和 HOST 环境变量会覆盖默认值(8010、127.0.0.1)。
默认情况下,查看器只会打开已有转储的机器人。使用 --allow-new-dumps(在 Docker 中为 ALLOW_NEW_DUMPS=1)启动它后,尚未有转储的 token 会通过 Telegram 进行检查,获取其文件夹和 bot.json,并且实时模式会将其完整历史直接转储到浏览器中。这需要 API_ID/API_HASH。
任何能打开该页面的人都可以让你的服务器在你的 API_ID 下转储任意机器人,因此当此标志在非回环 HOST 上启用时,查看器会拒绝启动。在 Docker 中,容器内的 HOST 始终为 0.0.0.0,因此请添加 ALLOW_PUBLIC=1(--allow-public),并自行将端口保持在回环地址上:
docker run --rm -p 127.0.0.1:8010:8010 -v "$PWD:/data" \
  -e API_ID=123456 -e API_HASH=abc... -e ALLOW_NEW_DUMPS=1 -e ALLOW_PUBLIC=1 \
  soxoj/telegram-bot-dumper-web
--down / --start-from-id)遍历消息 ID 来转储机器人消息及其媒体内容。--listen-only):实时接收新消息,并提供从首个观测到的 ID 向下转储历史记录的功能。[from:USER][group:CHAT]。机器人发出的私聊消息会标记为 [to:USER]。--listen-only 会实时转储这些消息。在启用隐私模式(默认设置)的情况下,机器人只能看到命令、提及和回复。requirements.txt)API_ID 和 API_HASHpip install -r requirements.txt
# Telegram API credentials from https://my.telegram.org (read from the environment)
export API_ID=123456
export API_HASH=abc...
以每批 200 个的方式向上遍历 id 1..∞,下载每条消息、所有媒体以及所有用户头像。默认情况下,转储器在转储完成后会继续监听新的传入消息。若要在历史转储完成后立即退出(非常适合脚本和 cron 任务),请传入 --no-listen。
./dumper.py --token 12345678:ABCe2rPVteUWZ7wLeCqCb3CH3ilUY_fLabc
对于活跃的机器人,向上遍历会撞上一大段已被修剪(删除/过期)的旧 id,然后放弃。从最新的 id 向下遍历则高效得多。--down 会自动探测上界(10 的幂,最高到 10⁹),并从它找到的最高非空 id 开始:
./dumper.py --token TOKEN --down
注意。 Telegram 不会永久保留机器人消息历史。根据实际经验,只有最近几十万条消息仍然可访问——在我们的测试中,一个繁忙的机器人大约只暴露了最近 500K 条消息,之后
messages.getMessages对更早的 id 开始只返回MessageEmpty。如果你的机器人历史上处理的消息量超过这个数量,那么更早的历史在服务端已经不存在了,任何标志都无法恢复它。
如果你已经知道一个较新的消息 id(例如你实时看到过的某个 id),你可以跳过探测,直接从该 id 开始:
./dumper.py --token TOKEN --start-from-id 11922524
不导出任何内容;只观察到达的消息。收到第一条传入消息时,脚本会提示从该 id 开始向下导出:
./dumper.py --token TOKEN --listen-only
当你只需要一份与机器人交谈过的用户名单时很有用——不需要 zip 文件、不需要 jpeg 图片、也不需要逐聊天的 *_history.txt。
./dumper.py --token TOKEN --down --users-csv --no-photos --no-media --no-history
输出:<bot_id>/users.csv,包含列 id, username, first_name, last_name, phone, lang_code, bot, premium, verified, scam, fake。
向下遍历会将下一批边界保存到 <bot_id>/last_message_id.txt。
如果运行被中断,请在现有转储文件夹中继续,无需再次探测:
./dumper.py --token TOKEN --resume
使用与原始运行相同的 --output 目录(如果已设置)。已保存的聊天记录和会话文件会被保留。缺失或无效的检查点会在连接前产生错误。--resume 不能与 --listen-only 或 --start-from-id 组合使用;它意味着向下遍历。
若要改为手动选择起始点,请使用 Requesting message ids X..Y ... 中最后打印的下界:
./dumper.py --token TOKEN --start-from-id <Y>
较小的批次 → 日志中的反馈更快,FloodWait 后的恢复窗口更短。较大的批次 → 在扫描稀疏 / 已裁剪的 id 范围时往返次数更少。在实践中,最大到 1000 的值都能正常工作。
./dumper.py --token TOKEN --down --batch-size 50
./dumper.py --token TOKEN --down --batch-size 500
./dumper.py --token TOKEN --down --batch-size 1000
| 标志 | 作用 |
|---|---|
--lookahead N | 在一个全空的批次之后,继续扫描 N 个批次再放弃。当 id 稀疏时很有用。 |
--no-photos | 跳过下载用户头像(avatars)。 |
--no-media | 跳过下载消息内的照片和文档;元数据仍会写入文本历史记录。 |
--no-history | 不写入每个聊天的 <chat_id>_history.txt。与 --users-csv 组合使用可实现最轻量的运行。 |
--users-csv | 将用户写入单个 <bot_id>/users.csv,而不是 <user_id>/<user_id>.json 目录。 |
--tor | 通过本地 127.0.0.1:9050 上的 Tor SOCKS5 代理进行路由(绕过 Telegram 封锁)。 |
运行 ./dumper.py --help 查看完整列表。
机器人在历史记录完全导出之前就退出了。
如果某些消息已被用户删除,一个批次可能返回完全为空,脚本可能会过早停止。此外,如果机器人处理了非常大量的流量,旧消息已不再由 Telegram 服务器返回——它们已被清理,任何标志都无法恢复它们。对于稀疏但确实存在的历史记录,请调高 --lookahead 以继续扫描越过空档:
# check additionally 5*200 = 1000 ids
./dumper.py --token TOKEN --lookahead 5
或者直接使用 --down,它受旧 id 间隙的影响要小得多。
未导出群聊(基础群组、超级群组)的历史记录。
messages.getMessages 只返回机器人的私聊历史记录;超级群组历史记录需要按频道逐个调用,而机器人通常无法进行此类调用。如果群组隐私已关闭(参见功能特性),群组消息仍会在 --listen-only 模式下实时捕获。
离线单元测试(无网络、无令牌):
pip install -r test-requirements.txt
pytest tests/ --ignore=tests/bot_test.py
针对真实 bot 的集成测试(需要可用的 bot token):
TEST_TOKEN=12345678:... pytest tests/bot_test.py
Dorks 示例:telepot.bot






