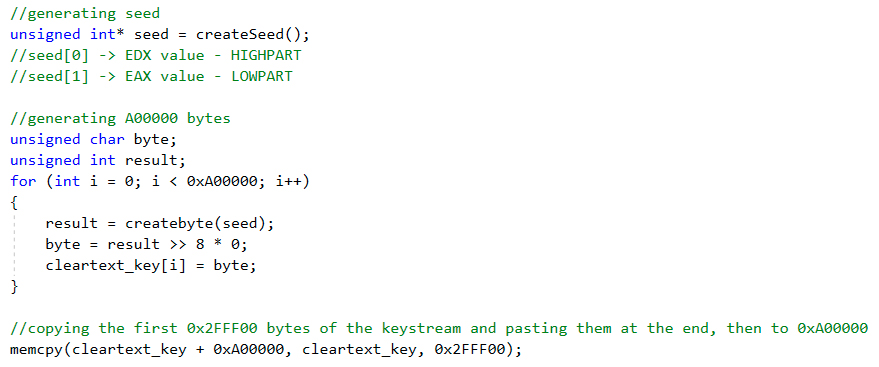
# HiveV5 密钥流解密器 PoC ## 简介 本文档中分析并引用的 Hive 样本是从[此列表](https://github.com/rivitna/Malware/blob/main/Hive/Hive_samples.txt)中随机选取的,该列表由[@rivitna](https://twitter.com/rivitna2)创建,在此向他致以最诚挚的感谢。相关样本可在 VirusTotal 平台上获取。 本文档以 a0h2uih3d2.exe 文件作为参考。 MD5: 15CF5E0DA094ACDD751A513402A8C941 SHA-1: 72E15AC4473903C814E65E3C06F54EB0399580AA SHA-256: 335D2E4A743D059955760ECF2EC25EE86D36AA60B096C9180E860C64EF78EE55 要了解该勒索软件的复杂性,请查阅由 Microsoft 威胁情报中心 (MSTIC) 发布的[这篇分析文章](https://www.microsoft.com/security/blog/2022/07/05/hive-ransomware-gets-upgrades-in-rust/)。 在开始动手编写代码之前,请仔细阅读整篇文档! ## Hive v5 简要概述 近几个月来,我将大部分精力投入到 Hive v5 加密算法的研究与逆向工程中。我有幸与一位出色的恶意软件分析师和逆向工程师[@rivitna](https://twitter.com/rivitna2)合作,他过去曾分析过 Hive 的早期版本,并发布了相关加密机制的代码和 PoC。他为识别 Hive v5 加密操作中涉及的组件做出了(不小的)贡献,而由于 Hive v5 使用 RUST 编写,分析起来更加困难。我发现它与 Babuk(另一款非常重要的勒索软件,其源码于 2021 年 6 月泄露)有一些共同之处: - 密钥交换算法; - 在启动 1256 个加密线程之前需要关闭的进程列表。 在受害者系统上运行的 Hive v5 勒索软件会基于 *QueryPerformanceCounter* 和 *QueryPerformanceFrequency* Windows API,使用下文证据中所示的算法生成两个明文密钥。 有关 *QueryPerformanceCounter* API 的更多信息,请参阅微软的[此页面](https://docs.microsoft.com/en-us/windows/win32/api/profileapi/nf-profileapi-queryperformancecounter);有关 *QueryPerformanceFrequency* 的更多信息,请参阅[此处](https://docs.microsoft.com/en-us/windows/win32/api/profileapi/nf-profileapi-queryperformancefrequency)。 *QueryPerformanceCounter* 是一个非常精确的时间计数器。调用时,它返回自 PC 上次开机以来经过的时间。 *QueryPerformanceFrequency* 返回性能计数器的值(频率)。其固定值为 0x989680。这意味着 *QueryPerformanceCounter* 的值每秒更新 0x989680 次,即 10,000,000 次。 这两个明文密钥的大小为 0xCFFF00 字节,每次按字节逐个生成。下面是可以创建 0xA00000 字节数组的代码片段,该数组是所谓的**明文密钥**的最大组成部分,Hive 使用它来加密受害者 PC 上的文件。 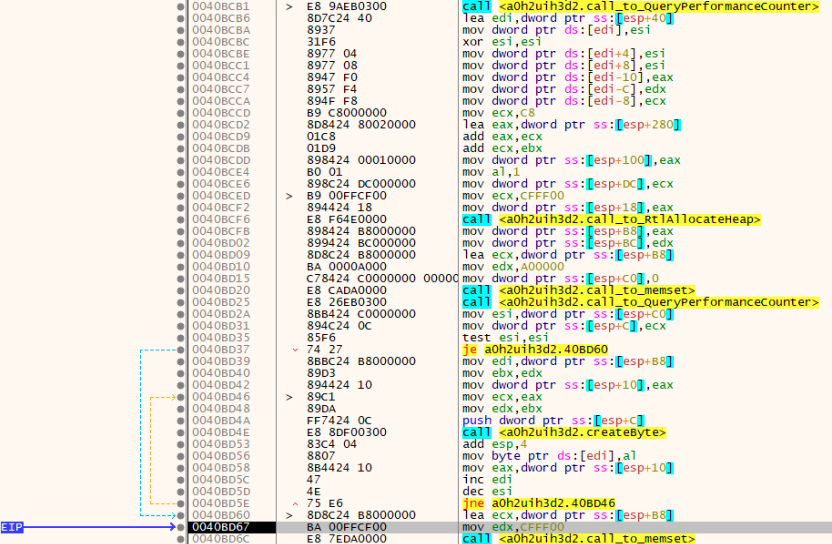 密钥的每个字节都是通过取 AL 寄存器的值获得的。EAX 寄存器包含 0044ADE0 函数(已重命名为 *createByte*)的结果,该函数计算当前时间点与初始种子值之间的差值,而初始种子值是在第一次调用函数 0044A850(已重命名为 *call_to_QueryPerformanceCounter*)时计算得到的。 下面是用 C++ 编写、用于生成明文密钥的代码: 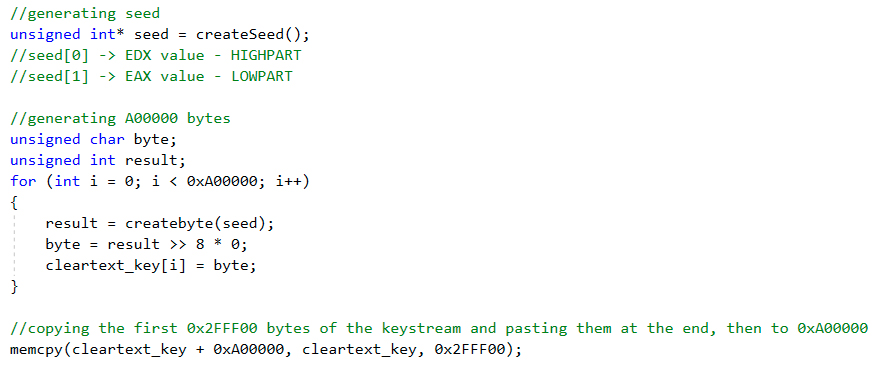 该算法非常简单,尽管在 0044ADE0 函数内部插入了一些执行冗余操作和各种条件跳转的指令,试图在生成明文密钥期间延长代码的执行时间: 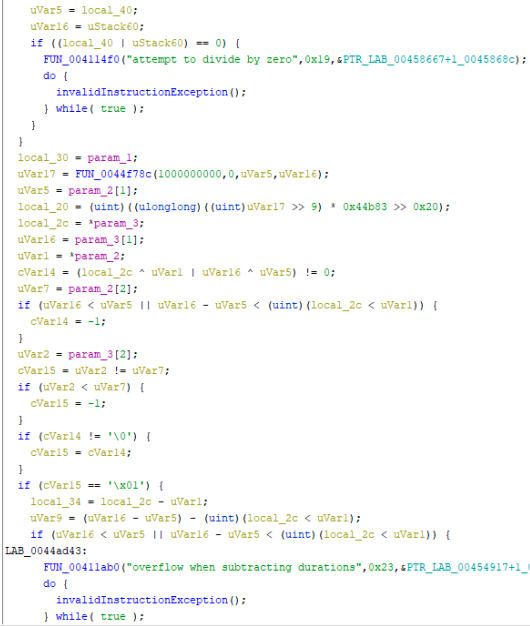 在 **HiveRansomwareV5_custom_keygen_PoC** 文件夹中,你可以找到从所分析的 Hive v5 样本中还原出来的原始代码。它不像恶意软件中的代码那样经过优化,因为我需要确保不遗漏编译版本中的任何一行代码。 在 **HiveRansomwareV5_custom_keygen_PoC-optimized** 文件夹中,你可以找到从上述原始代码派生出的优化代码。该版本的代码比原始代码更易于阅读,以便理解其所实现的功能。 **在运行之前,这两个版本都需要根据你的用户进行自定义,才能将生成的明文密钥保存到你的桌面上。** 两个明文密钥均使用相同的算法生成。 一个明文密钥由 0xA00000 个~~安全随机生成~~的字节组成。然后将前 0x2FFF00 个字节复制到末尾,形成最终大小为 0xCFFF00 字节的明文密钥。 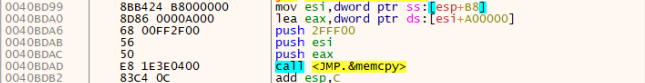 然后 Hive 使用生成的两个密钥来加密文件,但首先,Hive v5 勒索软件会将生成的密钥加密到自定义结构中(下文称为**密钥流**),并以 .key 扩展名将它们放置在它所加密的每个驱动器的根目录下。例如,如果你的系统安装了 C 和 D 两个驱动器,那么每个驱动器的根目录下都会存在加密后的密钥流。 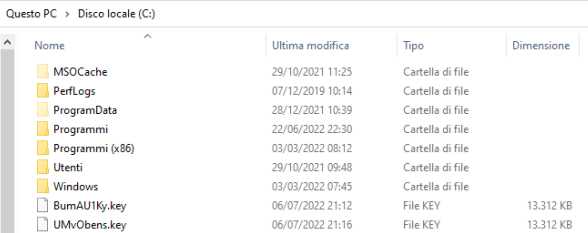 Hive v5 勒索软件使用生成的明文密钥,通过 XOR 指令对文件进行加密,因此在现代 x86/x64 CPU 上,这是一种非常快速的对称加密。 ## Hive v5 如何保护自身,明文密钥如何变为密钥流 Hive v5 勒索软件需要保护生成的明文密钥,对其进行两次加密,下文我们将这两次加密称为**轮次**。需要经过两轮加密才能得到最终的密钥流。 为实现此目的,每一轮都会执行以下步骤: 1. 使用与逐字节生成密钥相同的算法,生成一个 32 字节的私钥; 2. 使用 Curve25519 椭圆曲线算法进行 Diffie-Hellman 密钥交换,Hive 从刚生成的私钥推导出公钥; 3. 再次使用 Curve25519,Hive 从刚生成的私钥和 Hive 联盟成员(affiliate)的公钥(在每个 Hive v5 样本中都不同)生成共享密钥; 4. 使用与私钥和明文密钥相同的算法,生成一个 24 字节的 nonce,类似于一种 IV; 5. 使用 HChaCha20 算法,推导出用于加密所生成明文密钥的密钥; 6. 使用步骤 5 中创建的密钥和步骤 4 中创建的 nonce,Hive 使用 XChaCha20 算法加密明文密钥。此操作还会生成一个 16 字节的 MAC(消息认证码),以确保加密过程的完整性。 步骤 3 保证了所创建的密钥流可以由两对私钥打开:一对是 Hive 在加密过程中生成的私钥,另一对是 Hive 联盟成员在为我们编译勒索软件时生成的私钥。 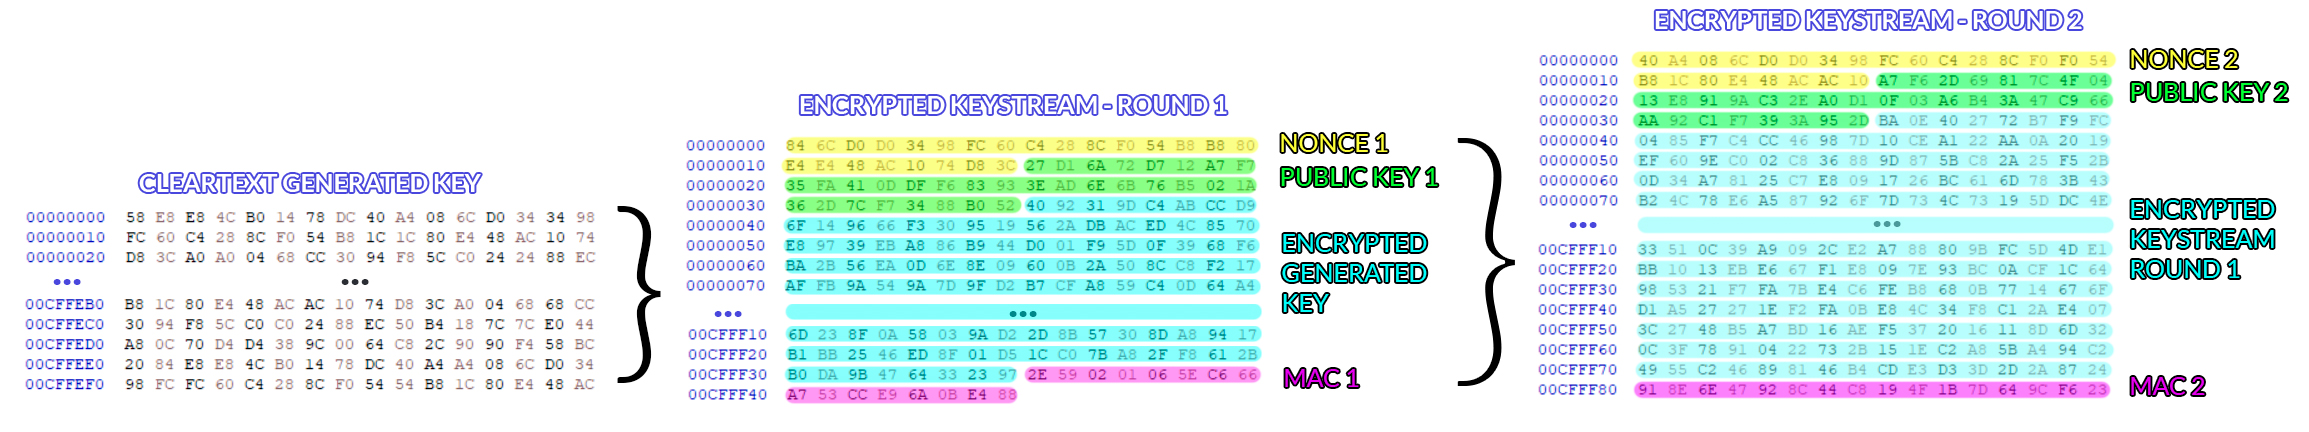 ## 暴力破解背后的思路 在这段描述的最后,有一点非常明显:明文密钥、私钥以及两轮加密所使用的 nonce 都是由上述同一个函数(0044ADE0,即 *createByte*)生成的。**函数 0044ADE0 的执行受 CPU 在 for 循环内执行所调用代码所需时间的影响。** 查看上方突出显示两轮加密后密钥流结构的图,很明显我们只能自由访问 **nonce**(否则 Hive 联盟成员将不知道如何解密文件)。 因此,让我们聚焦于长度为 24 字节的 NONCE: NONCE: 40 A4 08 6C D0 D0 34 98 FC 60 C4 28 8C F0 F0 54 B8 1C 80 E4 48 AC AC 10 **nonce 中一个字节与下一个字节之间的差值(绝对值)表示相邻两次迭代之间经过的时间。我们以此定义引入指纹(fingerprint)的概念。** NONCE 指纹:64 9c 64 64 00 9c 64 64 9c 64 9c 64 64 00 9c 64 9c 64 64 9c 64 00 9c 如果我们分析所获得的值,就会发现代码的执行时间几乎相同,只有细微差异,这尤其取决于所用处理器的技术(在我的测试中,我使用了第 10 代 i7 处理器和第 5 代 i5 处理器;在其他系统上,此指纹可能会有所不同)。 如果我们考虑到 nonce 是由生成明文密钥(尤其是私钥)的同一个函数生成的,那么这一发现就非常重要。由于上述这些值也将遵循同样的原则,即 nonce 各个字节之间的差值是可预测的,那么私钥和明文密钥的值也将是可预测的。 然而,分析表明,生成一个 0xA00000 字符的数组并期望得到与 Hive 计算出的原始明文密钥相同的字节是非常困难的:CPU 和内存负载的变化会影响代码的执行速度,而且 Hive PE 计算出的原始明文密钥通常与我们计算出的密钥不同(即使只是几个字节的差异)。 我们使用这个 nonce 指纹,与从生成的可能长度为 0xA00000 字节的字典中获得的指纹进行比较(这个数字是经过一系列测试后凭经验确定的;统计表明,在这个字节数范围内包含两轮加密所需的两个各 32 字节的私钥)。如果 nonce 指纹包含在字典指纹中,我们就找到了正确的字典,可以开始对两个私钥进行暴力破解。 事情并没有就此结束,因为通过对 nonce、明文密钥以及私钥生成过程进行的动态分析,已经验证:与其他几乎所有值都同质化的字节相比,第一个字节与第二个字节之间的平均距离是不同的。让我们详细看看:  正如你所看到的,第一个字节之后的指纹值变化极小,也就是说,私钥第一个字节和第二个字节之间的绝对距离,大多数时候其值都超出指纹其余部分的值范围。 这可能是因为 CPU 中存在一些优化算法,在 for 循环的第一次迭代之后会加速代码的执行。 ## 一种可能的解决方案 所提出的代码会读取每轮密钥流加密的 nonce,确定其指纹,并生成一个包含可能私钥的候选密钥字典列表。 为了解决指纹第一个字节始终与密钥其余部分不同的问题,我想到的做法如下: 1. 提取生成字典前 0x110 个字节中的唯一值,创建一个包含可能的开头字节的字典; 2. 从生成字典的第二个字节开始,取所有可能的组合,创建一个 31 字节的列表; 3. 将开头字节与生成的其余 31 个字节进行组合,创建可能的 32 字节私钥组合,再据此推导出公钥,并与我们所拥有的、密钥流中的公钥进行比较。 当两个公钥一致时,我们就找到了用于第二轮(即最后一轮)加密的私钥。通过再次迭代上述操作,我们将获得解密第一轮加密密钥流的私钥,并最终提取出原始的明文密钥。 ## 使用方法 在 **HiveRansomwareV5-keystream_decryptor** 文件夹中,你可以找到 VS 2017 的 sln 解决方案文件和一个定制的 [monocypher](https://monocypher.org/) 库。该程序允许你选择要执行的操作。 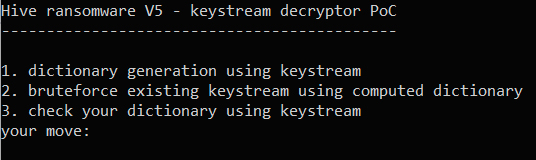 选项 "1" 是应该首先选择的选项,因为它允许你为 PC 处理器创建"量身定制"的字节字典,因此它应该在被加密的机器上执行,因为这样你更有可能获得与其密钥流中相同的值。  或者,如果第一个选项不起作用,你可以通过在调试器中(在已感染的同一台 PC 上)运行恶意软件,直到明文密钥生成结束(就在 for 循环之外),然后保存包含明文密钥的内存内容,从而生成自己的字典。在这种情况下,你可以使用选项 "3" 来验证你的字典:  一旦你拥有适用于密钥流的正确字典,选项 "2" 也可以在更强大的计算机上执行,因为这样可以减少暴力破解字节组合所需的时间,并且完全不影响私钥字节的值。  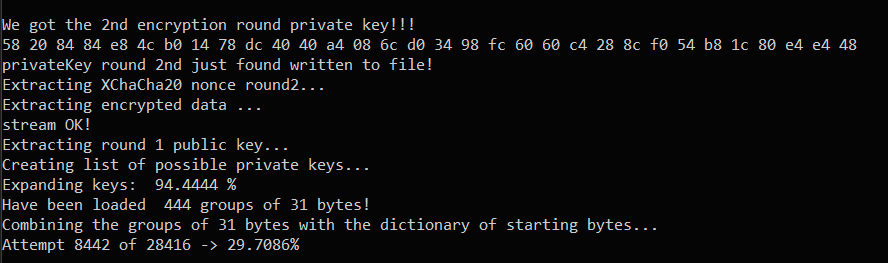  要正确执行选项 2 中的功能,必须提取公钥。由于并非所有 Hive 样本都相同,创建一个通用的公钥提取器并不容易。不过,一种已知有效的方法是在 nonce 创建之后的反汇编代码的这一部分设置断点。在下面的证据中,公钥被传递给函数 44E3D8,以便使用 curve25519 推导共享密钥。这是整个恶意软件执行过程中唯一暴露公钥的地方。 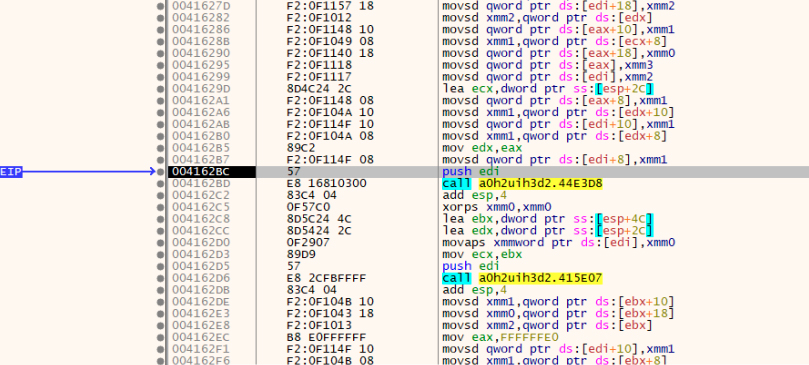 在使用 Visual Studio 选项时请务必注意。如果你在调试(debug)和发布(release)之间切换,诸如字典生成的字节等程序输出可能会发生变化。 如果你想加快暴力破解过程,可以修改代码中的 *dictionary_dimension* 值,但请注意,减小字典大小也可能会降低找到私钥的几率。 另外,如果你决定使用通过运行 Hive 并从内存中转储获得的明文字节数组,请记得在 *dictionary_dimension* 变量中设置转储的大小。 为了测试解密工具,我在 **dummy_data_PoC** 文件夹中提供了一些文件供你使用: - *BumAU1Ky.key*(第一个密钥流) - *UMvObens.key*(第二个密钥流) - *a0h2uih3d2_01058000.bin*(Hive 执行过程中转储的明文密钥,用作字典) - *dictionary.bin*(示例字典) - *public_key.txt*(包含 Hive 联盟成员的公钥) 祝你好运! ## 参考资料 <https://github.com/rivitna/Malware/blob/main/Hive/Hive_samples.txt> <https://www.virustotal.com/gui/file/335d2e4a743d059955760ecf2ec25ee86d36aa60b096c9180e860c64ef78ee55> <https://www.microsoft.com/security/blog/2022/07/05/hive-ransomware-gets-upgrades-in-rust/> <https://docs.microsoft.com/en-us/windows/win32/sysinfo/acquiring-high-resolution-time-stamps> <https://monocypher.org/manual/x25519> <https://monocypher.org/manual/advanced/poly1305> <https://monocypher.org/manual/advanced/chacha20> <https://monocypher.org/manual/aead>