 jaidedai/easyocr
即用型 OCR,支持 80 多种语言及所有主流书写文字,包括拉丁文、中文、阿拉伯文、天城文、西里尔文等。



开箱即用的 OCR,支持 80 多种受支持的语言以及所有主流书写系统,包括:拉丁文、中文、阿拉伯文、天城文、西里尔文等。
已通过 Gradio 集成到 Huggingface Spaces 🤗 中。试用 Web 演示:
2024 年 9 月 24 日 - 版本 1.7.2
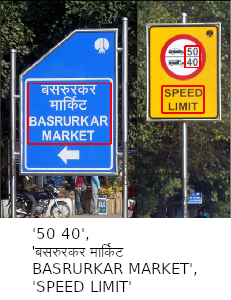
使用 pip 安装
获取最新稳定版本:
pip install easyocr
获取最新开发版本:
pip install git+https://github.com/JaidedAI/EasyOCR.git
注 1:对于 Windows,请先按照此处的官方说明 https://pytorch.org 安装 torch 和 torchvision。在 pytorch 网站上,请务必选择与你匹配的正确 CUDA 版本。如果你打算仅在 CPU 模式下运行,请选择 CUDA = None。
注 2:我们还在此处提供了 Dockerfile 链接。
注 3:可选的 DBNet 检测器(detect_network='dbnet18')会在首次使用时编译其 C++/CUDA 算子,这需要 Ninja 构建工具。要将其与 EasyOCR 一起安装,请使用 pip install "easyocr[dbnet]"。
import easyocr
reader = easyocr.Reader(['ch_sim','en']) # this needs to run only once to load the model into memory
result = reader.readtext('chinese.jpg')
输出将采用列表格式,每一项分别表示一个边界框、检测到的文本以及置信度水平。
[([[189, 75], [469, 75], [469, 165], [189, 165]], '愚园路', 0.3754989504814148),
 ([[86, 80], [134, 80], [134, 128], [86, 128]], '西', 0.40452659130096436),
 ([[517, 81], [565, 81], [565, 123], [517, 123]], '东', 0.9989598989486694),
 ([[78, 126], [136, 126], [136, 156], [78, 156]], '315', 0.8125889301300049),
 ([[514, 126], [574, 126], [574, 156], [514, 156]], '309', 0.4971577227115631),
 ([[226, 170], [414, 170], [414, 220], [226, 220]], 'Yuyuan Rd.', 0.8261902332305908),
 ([[79, 173], [125, 173], [125, 213], [79, 213]], 'W', 0.9848111271858215),
 ([[529, 173], [569, 173], [569, 213], [529, 213]], 'E', 0.8405593633651733)]
注 1:['ch_sim','en'] 是你想要读取的语言列表。你可以一次传入多种语言,但并非所有语言都能一起使用。英语与每种语言都兼容,而共享相同字符的语言通常彼此兼容。
注 2:除了文件路径 chinese.jpg,你还可以传入 OpenCV 图像对象(numpy 数组)或作为字节的图像文件。指向原始图像的 URL 也是可以接受的。
注 3:reader = easyocr.Reader(['ch_sim','en']) 这一行用于将模型加载到内存中。这需要一些时间,但只需运行一次。
你也可以设置 detail=0 以获得更简单的输出。
reader.readtext('chinese.jpg', detail = 0)
结果:
['愚园路', '西', '东', '315', '309', 'Yuyuan Rd.', 'W', 'E']
所选语言的模型权重将自动下载,你也可以从模型中心手动下载,并将其放入 '~/.EasyOCR/model' 文件夹中
如果你没有 GPU,或者 GPU 内存较低,可以通过添加 gpu=False 以仅使用 CPU 模式运行模型。
reader = easyocr.Reader(['ch_sim','en'], gpu=False)
$ easyocr -l ch_sim en -f chinese.jpg --detail=1 --gpu=True
对于识别模型,请阅读此处。
对于检测模型(CRAFT),请阅读此处。
reader = easyocr.Reader(['en'], detection='DB', recognition = 'Transformer')
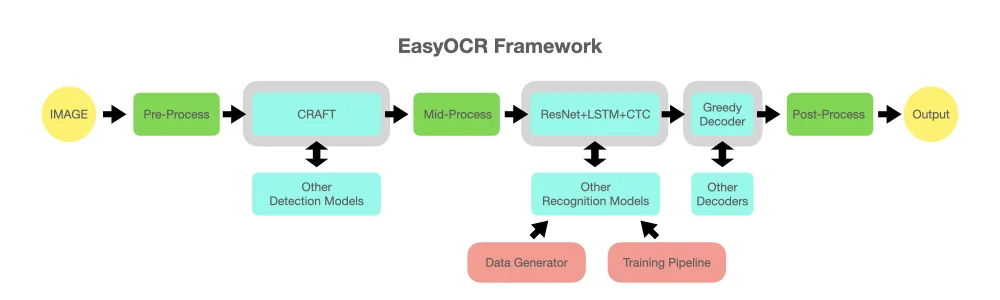
这个想法是能够将任何最先进的模型接入 EasyOCR。有很多天才正在努力打造更好的检测/识别模型,但我们并不打算在这里成为天才。我们只是想让他们的成果能够快速、免费地向公众开放……(好吧,我们相信大多数天才都希望自己的成果能尽可能快速、广泛地产生积极影响)整个流程应该类似于下图。灰色槽位是可替换的浅蓝色模块的占位符。
本项目基于多篇论文和开源仓库的研究与代码。
所有深度学习执行均基于 Pytorch。❤️
检测执行使用来自此官方仓库及其论文的 CRAFT 算法(感谢来自 @clovaai 的 @YoungminBaek)。我们还使用了他们的预训练模型。训练脚本由 @gmuffiness 提供。
识别模型是 CRNN(论文)。它由 3 个主要组件构成:特征提取(我们目前使用 Resnet)和 VGG、序列标注(LSTM)以及解码(CTC)。识别执行的训练流程是 deep-text-recognition-benchmark 框架的修改版本。(感谢来自 @clovaai 的 @ku21fan)这个仓库是一颗值得更多认可的瑰宝。
束搜索代码基于此仓库及其博客。(感谢 @githubharald)
数据合成基于 TextRecognitionDataGenerator。(感谢 @Belval)
以及一篇来自 distill.pub 关于 CTC 的优质读物,见此处。
让我们一起推进人类进步,让 AI 惠及每个人!
三种贡献方式:
开发者: 对于小 bug/改进,请发送 PR。对于较大的改动,请先开一个 issue 与我们讨论。有一系列可能的 bug/改进 issue 被标记为 'PR WELCOME'。
用户: 告诉我们 EasyOCR 如何惠及你/你的组织,以鼓励进一步的开发。同时请在 Issue 区发布失败案例,以帮助改进未来的模型。
技术负责人/大师: 如果你觉得这个库有用,请帮忙传播!(参见 Yann Lecun 关于 EasyOCR 的帖子)
要请求一种新语言,我们需要你发送一个包含以下 2 个文件的 PR:
如果您的语言具有独特元素(例如 1. 阿拉伯语:字符相连时会改变形态,并且从右向左书写 2. 泰语:部分字符需要位于行上方,部分需要位于行下方),请尽可能向我们提供说明和/或提供有用的链接。要构建一个真正可用的系统,关注这些细节非常重要。
最后,请理解我们的优先级将不得不放在热门语言或字符之间共享比例较大的语言组上(如果您的语言属于这种情况,也请告诉我们)。开发一个新模型至少需要一周时间,因此新模型的发布可能需要等待一段时间。
参见开发中的语言列表
由于资源有限,超过 6 个月的 issue 将被自动关闭。如果问题至关重要,请重新提交 issue。
如需企业级支持,Jaided AI 提供定制 OCR/AI 系统的全套服务,涵盖实现、训练/微调以及部署。点击此处联系我们。