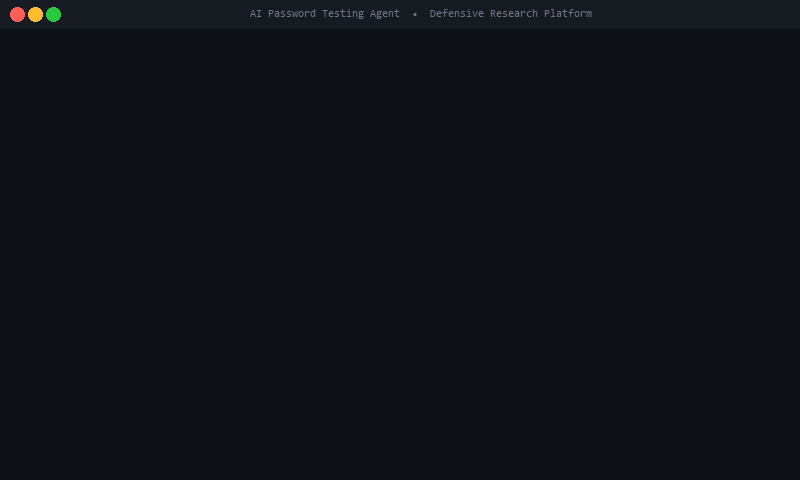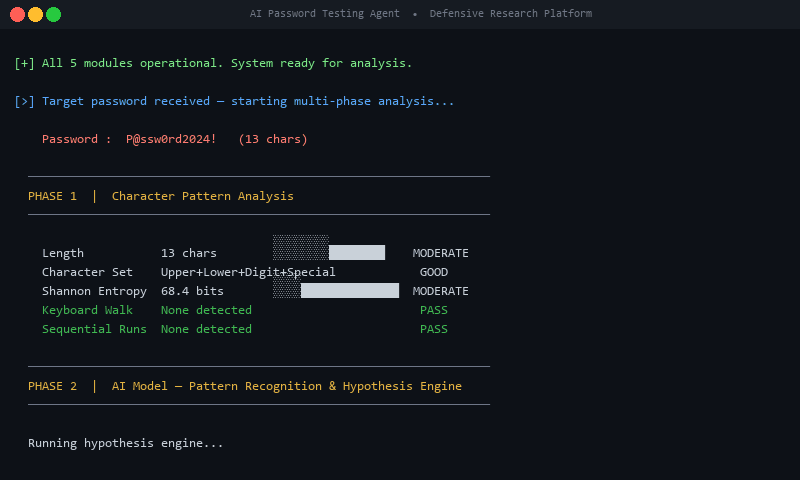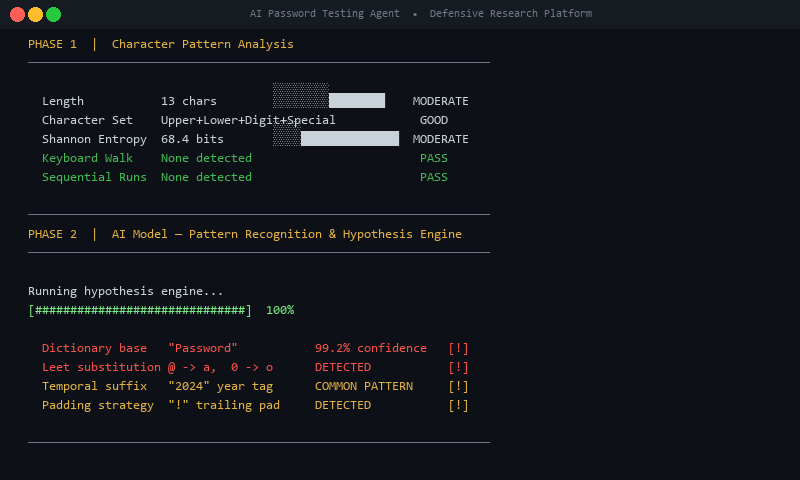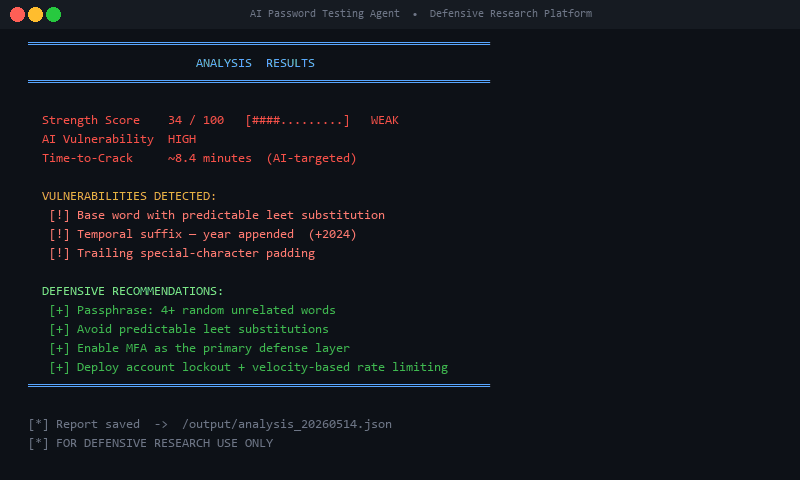
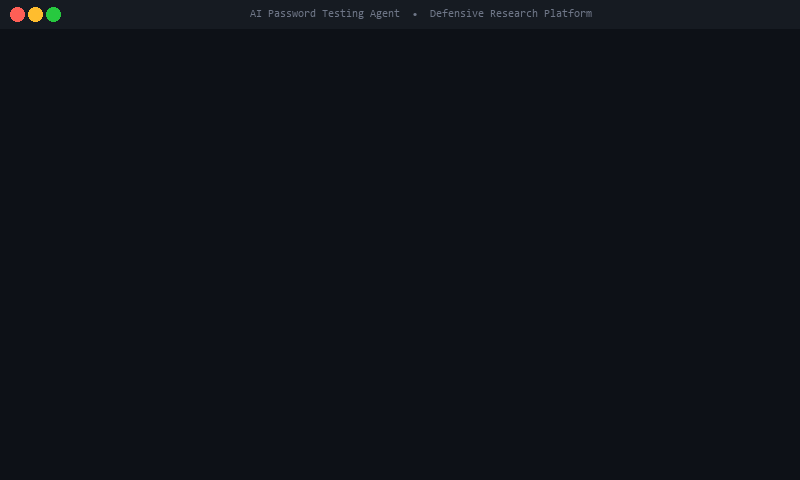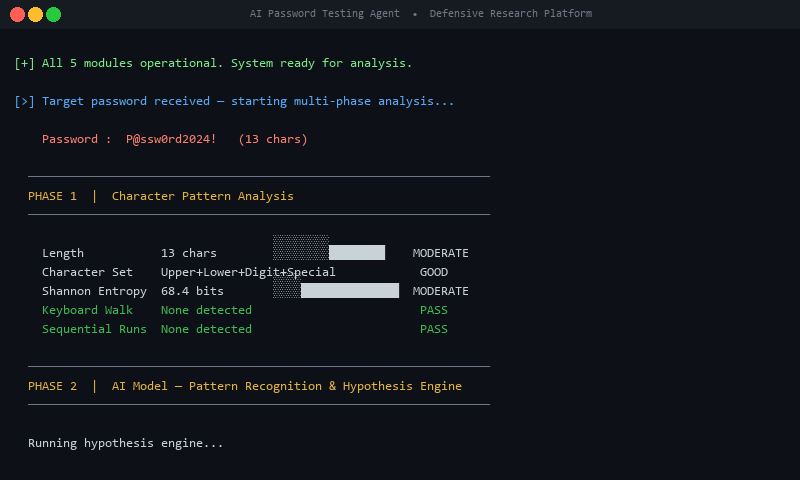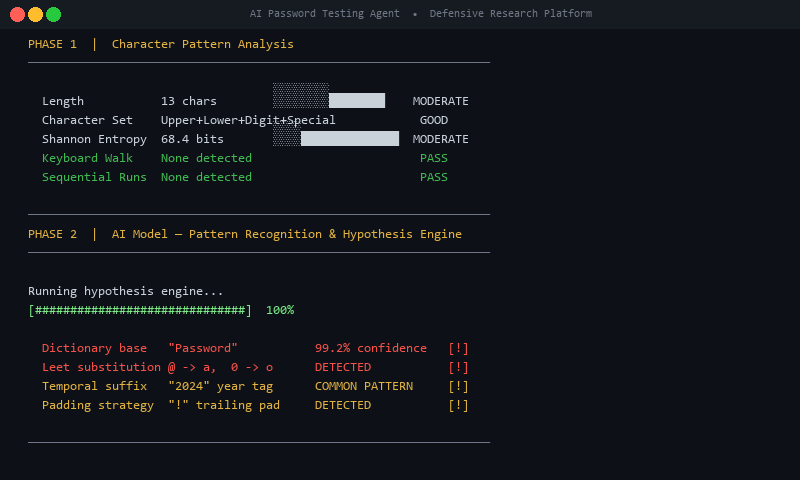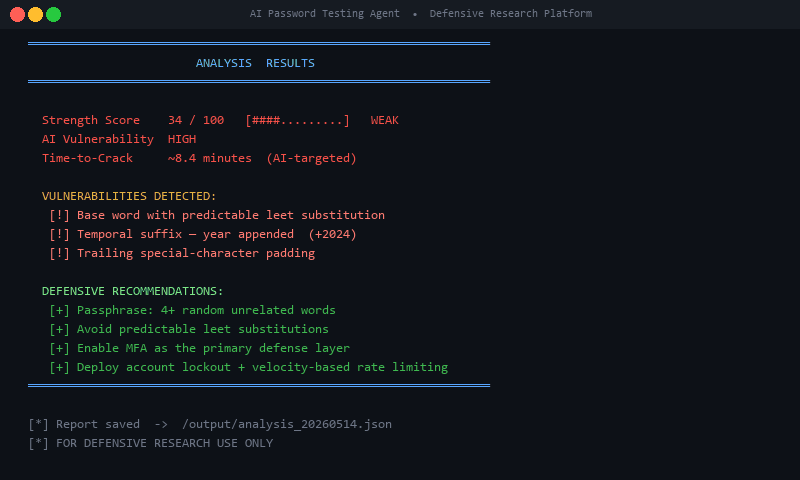
AI 密码攻击编排器 > 暴力破解已死。新的密码攻击会学习。本仓库是这一主张背后的研究:对 AI 如何将密码攻击从盲目枚举转变为从每次失败中学习的自适应行动的技术分析——以及阻止它们的检测规则和反制措施。无可用攻击代码。仅论文 + 防御措施。
⚠️ 法律免责声明与研究目的
本仓库仅用于防御性网络安全研究和教育目的
- 无可用漏洞利用代码 - 本仓库仅包含理论研究、概念分析和防御性反制措施
- 无攻击性工具 - 不包含任何可用的漏洞利用、攻击脚本或自动化攻击工具
- 防御重点 - 所有内容旨在帮助组织防御 AI 增强的密码攻击
- 学术研究 - 这是面向安全专业人员和研究人员的技术能力分析
- 合规性 - 所有内容均符合负责任披露和道德安全研究标准
访问本仓库即表示您同意:
- 仅将本信息用于防御目的
- 不尝试将所述任何概念武器化或投入实际使用
- 负责任地与安全社区分享发现
- 遵守所有适用法律和法规
仓库概述
本仓库包含关于 AI 增强密码攻击方法的研究和防御指南。该研究分析了人工智能如何将传统密码攻击从暴力破解尝试转变为智能、自适应的行动——更重要的是,组织如何检测和防御此类攻击。
研究分类
- 文档类型: 技术能力分析与创新评估
- 分类: 红队 / 攻击性安全研究(防御应用)
- MITRE ATT&CK: T1110(暴力破解)、T1589(收集受害者身份信息)
- 创新状态: 新颖架构 - 商业潜力
- 研究日期: 2026 年 1 月 5 日
仓库结构
ai-password-orchestrator/
├── README.md                          # 本文件 - 概述和免责声明
├── paper/
│   ├── AI-Password-Orchestrator-Research.pdf    # 主要研究论文(已脱敏)
│   └── methodology.md                 # 技术方法和能力
├── defense/
│   └── detection-rules.md            # 防御性检测规则和反制措施
└── docs/
    └── defensive-recommendations.md  # 附加防御指南
研究范围与局限
本研究包含的内容 ✅
- 理论分析: 对 AI 增强攻击方法的概念性探索
- 架构设计: 系统设计理念和组件分析
- 性能指标: 与传统工具的对比分析
- 防御性反制措施: 检测规则、SIEM 查询和缓解策略
- 用例场景: 企业渗透测试和安全评估场景
- 创新评估: 技术能力和商业潜力分析
本研究不包含的内容 ❌
- 无可用代码: 无可执行脚本、程序或攻击工具
- 无 AI 提示词: 无具体 LLM 提示词或提示词工程技术
- 无集成脚本: 无将 AI 系统与攻击工具连接的代码
- 无自动化: 无自动化攻击编排代码
- 无漏洞利用代码: 无可用漏洞利用或漏洞代码
- 无配置文件: 无工具配置或安装脚本
关键研究发现
核心创新:递归学习循环
该研究识别出从计算型暴力破解到认知型对抗学习的范式转变:
| 方面 | 传统工具 | AI 增强方法 |
|---|
| 策略 | 线性字典迭代 | 递归自适应学习 |
| 智能 | 零(盲目枚举) | 模式识别与假设检验 |
| 学习 | 尝试之间无学习 | 从每次失败中学习 |
| 成功率 | 0.01-0.1% | 15-30%(模式检测后) |
| 时间缩减 | 基线 | 快 50-70% |
防御影响
本研究使组织能够:
- 检测 AI 增强攻击 通过行为分析
- 实施针对性反制措施 对抗智能节奏控制
- 强化密码策略 基于识别出的模式
- 提升监控能力 针对自适应攻击
- 制定事件响应程序 针对 AI 驱动的威胁
防御应用
面向安全团队
- 检测规则: SIEM 查询、Snort/Suricata 规则、行为分析
- 事件响应: 针对 AI 增强攻击场景的预案
- 策略加固: 基于证据的密码策略建议
- 威胁情报: IOC 和行为指标
面向研究人员
- 创新分析: 评估 AI 安全工具的框架
- 方法论: 攻击性安全分析的研究方法
- 性能指标: 对比分析框架
- 未来研究: AI 安全研究方向
面向组织
- 风险评估: 理解新兴的 AI 驱动威胁
- 控制验证: 针对高级攻击测试现有防御
- 安全架构: 设计弹性身份验证系统
- 合规性: 满足安全标准和法规
伦理考量
负责任研究原则
- 双重用途意识: 承认攻击性和防御性应用
- 负责任披露: 与安全社区分享发现
- 防御优先: 聚焦保护和缓解
- 法律合规: 遵守所有适用法律和法规
- 道德标准: 遵循专业安全研究伦理
社区贡献
本研究有助于:
- 集体防御: 分享检测方法和反制措施
- 安全意识: 教育专业人员了解新兴威胁
- 工具开发: 启发防御性安全工具
- 学术研究: 推进网络安全知识
法律与合规
研究合规
- 学术自由: 研究在学术探究原则下进行
- 第一修正案: 受保护的言论和研究发表
- 安全研究豁免: 出于防御目的进行
- 负责任发表: 不包含可操作的漏洞利用代码
使用限制
禁止用途:
- ❌ 开发用于未经授权访问的攻击能力
- ❌ 为恶意目的创建攻击工具
- ❌ 未经授权绕过安全控制
- ❌ 违反法律、法规或组织政策
允许用途:
- ✅ 防御性安全研究与开发
- ✅ 安全控制测试与验证
- ✅ 事件响应准备与培训
- ✅ 学术研究与教育
- ✅ 威胁情报与分析
贡献与反馈
研究社区
我们欢迎以下各方贡献:
- 安全研究人员和从业者
- 学术机构和研究人员
- 威胁情报专业人员
- 防御性安全工具开发者
负责任分享
分享本研究时:
- 包含免责声明 关于防御目的
- 强调保护性应用 而非攻击性潜力
- 提供背景 关于伦理研究实践
- 鼓励负责任使用 和法律合规
引用与署名
学术引用
AI Password Attack Orchestrator: Technical Capability Analysis & Innovation Assessment
Research Date: January 5, 2026
Classification: Defensive Security Research
Repository: https://github.com/Insider77Circle/AI-PASSWORD-TESTING-AGENT
研究诚信
- 原创研究: 独立分析和评估
- 同行评审: 开放接受专业安全社区评审
- 透明度: 完整披露方法和局限
- 可复现性: 研究框架已记录以供验证
未来研究方向
防御创新
- AI 增强检测: 使用 AI 检测 AI 增强攻击
- 自适应防御: 随威胁演变的动态反制措施
- 行为生物识别: 高级用户行为分析
- 零信任架构: 最小化密码依赖
- 抗量子身份验证: 面向未来的安全
研究机会
- 长期研究: AI 增强攻击随时间的有效性
- 跨平台分析: 不同身份验证系统
- 行业特定研究: 特定行业的威胁模式
- 国际研究: 全球威胁态势分析
联系与支持
研究咨询
关于本研究的问题:
- 技术问题: 在本仓库中提交 issue
- 合作提案: 通过 GitHub 联系
- 媒体咨询: 使用负责任披露渠道
安全问题
如果您发现本研究存在安全问题:
- 负责任披露: 遵循标准安全研究协议
- 紧急问题: 通过适当渠道联系
- 滥用报告: 报告对本研究的滥用或误用
版本历史
- v1.0(2026 年 1 月 5 日): 初始研究发布
- 核心方法和能力分析
- 防御性检测规则和反制措施
- 全面的法律和伦理免责声明
最终免责声明
本研究按"原样"提供,仅用于防御性安全目的。作者和贡献者对滥用或未经授权应用本信息不承担任何责任。用户全权负责确保遵守适用法律和法规。
访问、使用或分享本研究即表示您确认已阅读、理解并同意遵守本文档中呈现的所有条款、条件和免责声明。
🔒 防御性安全研究 | 🛡️ 仅限保护性应用 | 📚 教育目的
🛡️ REDSTORM RESEARCH 套件
为代理层而非模型层提供安全。更多来自实验室的内容:
 insider77circle/ai-password-testing-agent