farhadalimohammadi-dir/vulnrepro-benchmark
通过真实漏洞赏金案例衡量 AI 模型检测源代码中漏洞能力的基准测试,具有平衡的召回率和误报评分。包含基于 Docker 的易受攻击应用和干净对照组,以实现可复现的评估。

一个用于检验 AI 模型是否真的能审查易受攻击的代码、还是仅仅听起来很自信的基准测试。
大多数安全基准只问一个问题:模型能否找到漏洞?这只是工作的一半。另一半——也就是真正审查工作中最磨人的部分——是不去标记那些根本不存在的漏洞。一个动不动就对每个文件高喊"有漏洞"的模型,在只衡量召回率的基准上会表现得很棒,但在实践中毫无用处。
所以我围绕这两个方面同时构建了这个基准。
测试用例来自真实的漏洞赏金报告。其中大部分是我通过 bugbountydaily.com 上由 busf4ctor (Vitor Falcão) 收集的报告找到的。我选取每一篇报告,将其还原成一个小型易受攻击的应用,力求尽可能贴近真实报告:报告中给出的变量名、路径或请求参数,我都原样复用;没有给出的,我就用最接近且仍能还原该漏洞的替代。
这个基准衡量的是源代码审查能力,而不是黑盒攻击。模型阅读应用源码,判断其中是否存在可报告的漏洞。它不会获得可攻击的实时 URL,不知道某个用例是有漏洞还是干净的,也得不到任何指向易受攻击函数的注释。不过将来,我还会以漏洞赏金猎人的方式加入黑盒测试,并同样进行评分。
其中一个被漏掉的用例是一个带 next 参数的重定向页面。乍一看,它像是常见的低难度 XSS:应用将 next 反射进继续链接和 meta-refresh 流程,且不验证其协议 scheme,因此 javascript:alert(...) 可以存活到页面中。
有趣的是上下文。在原始的漏洞类别中,该页面位于浏览器/扩展的信任边界之内。因此其影响不只是"弹出一个 alert";这个重定向成了通往更受信任执行路径的桥梁。模型必须理解产品流程,而不只是匹配 javascript: 这个词。
这正是我想放进基准的那种用例:sink 清晰可见,但真正的危害只有顺着周围的信任链走一遍才能理解。
每个易受攻击的用例都有一个干净的孪生版本。我取同一个应用,把其余部分都修复到安全状态,这样模型就无法从某个无关的漏洞上轻易得分。我用 AI 来查找并修复其他问题,只保留原始报告所描述的那一个漏洞。
这并不完美。有些对照组可能仍残留个别问题,有些则一个也没有。但核心观点依然成立:模型必须在漏洞存在时找到那个漏洞,在漏洞不存在时保持沉默。
核心数字是这两种能力的平均值:
balanced_detection_score = (vulnerable_recall + control_true_negative_rate) / 2
一个把什么都标记为有漏洞的模型会受到对照组的惩罚。这是有意为之的。
238 个盲测任务:119 个易受攻击用例和 119 个干净对照组,使用不透明的 ID 打乱混合。
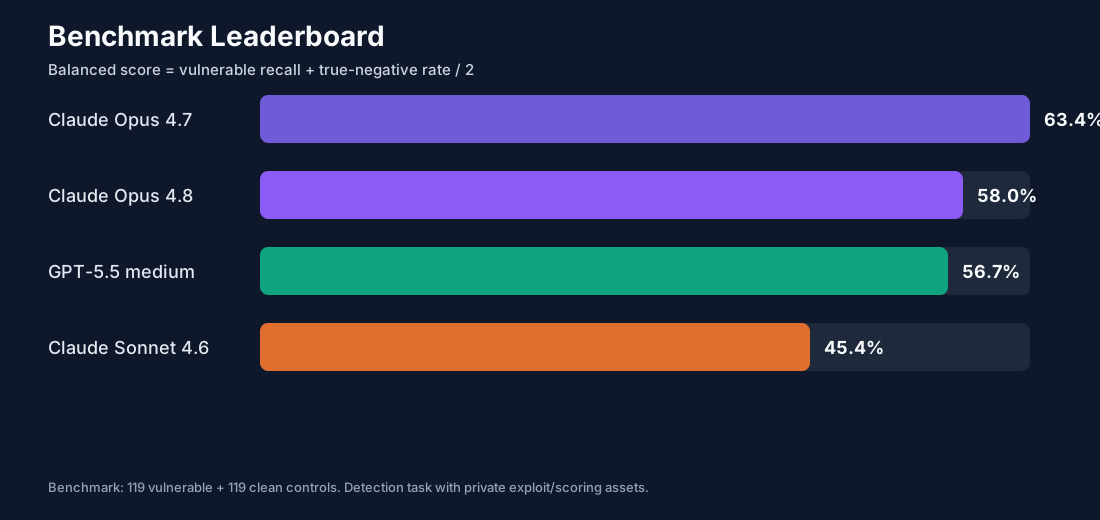
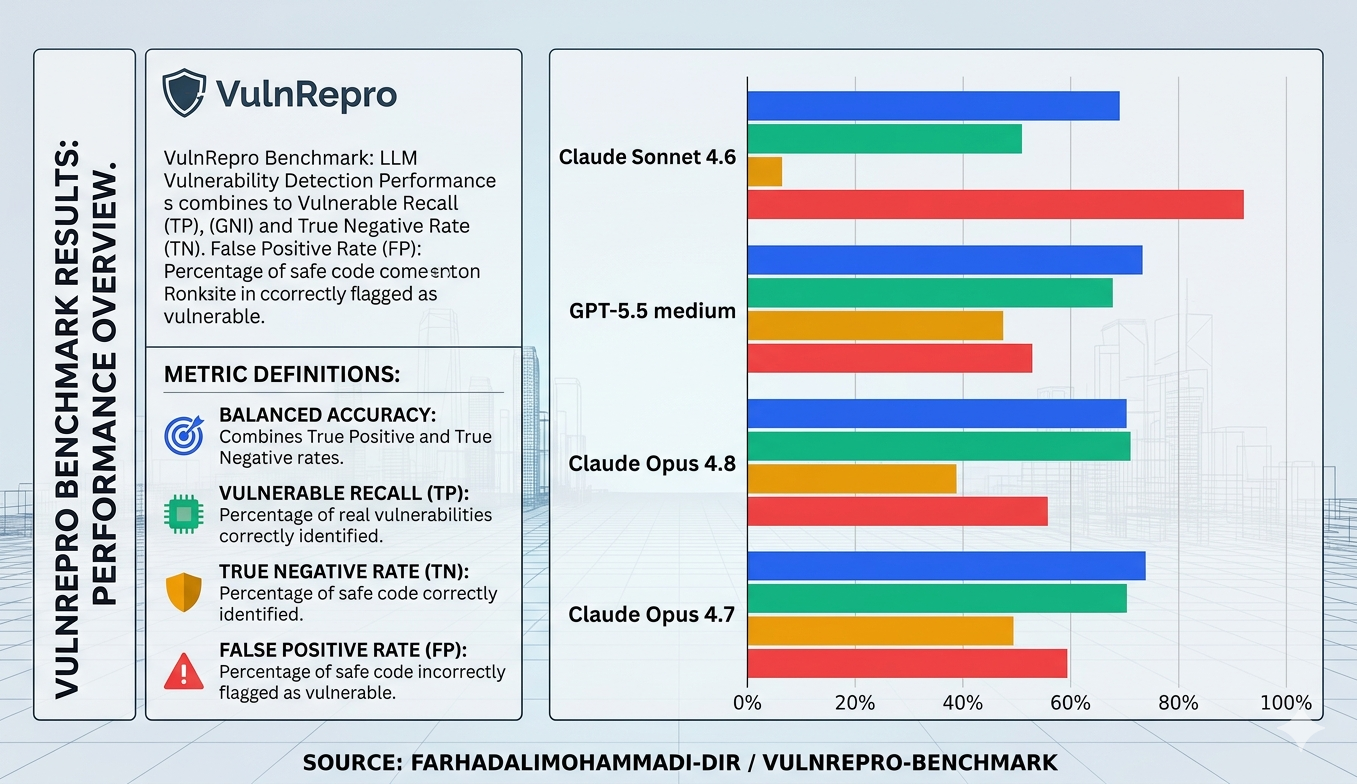
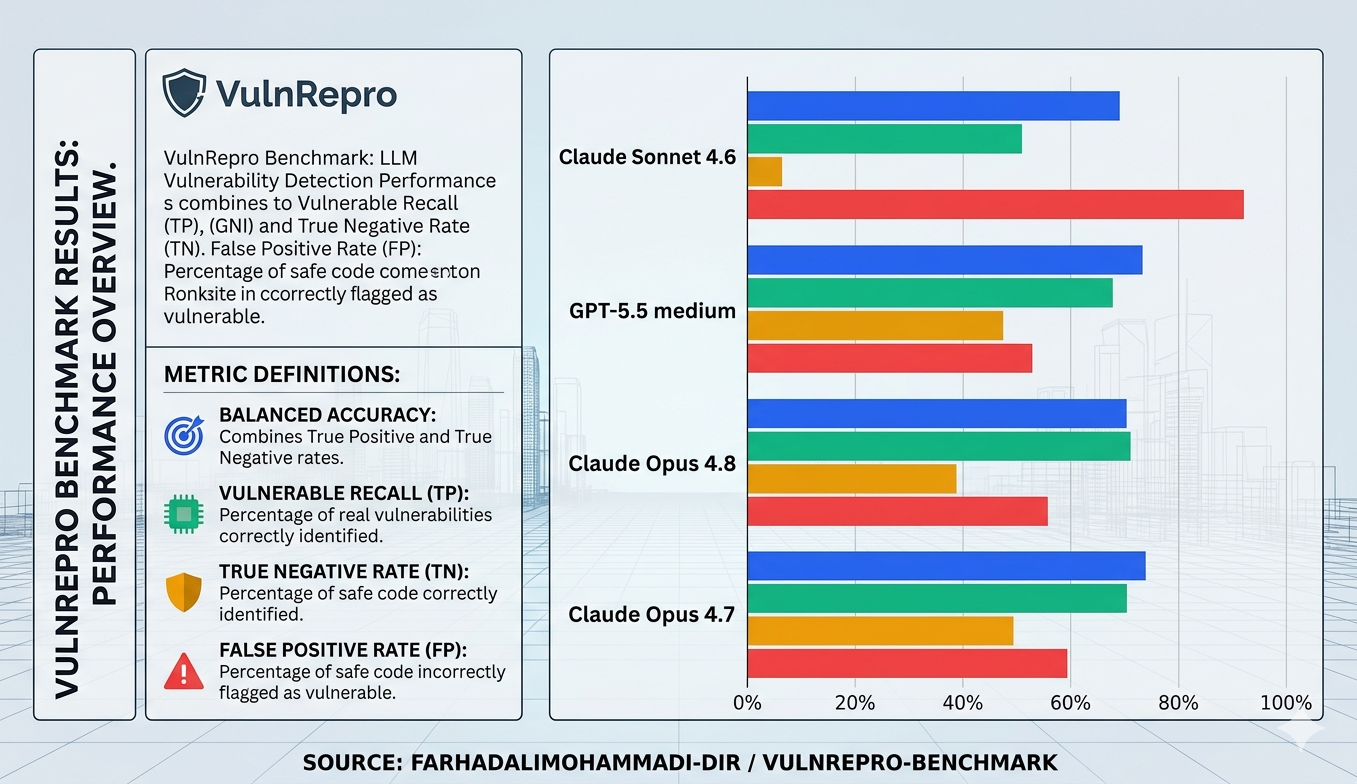
| 模型 | 综合得分 | 漏洞召回率 | 真阴性率 | 误报率 |
|---|---|---|---|---|
| Claude Opus 4.7 | 63.4% | 77.3% | 49.6% | 50.4% |
| Claude Opus 4.8 | 58.0% | 78.1% | 37.8% | 62.2% |
| GPT-5.5 medium | 56.7% | 68.9% | 44.5% | 55.5% |
| Claude Sonnet 4.6 | 45.4% | 78.1% | 12.6% | 87.4% |
召回率并不是这些模型之间的分水岭。它们都能找到大量漏洞。真正的分水岭是干净对照组上的误报率。Sonnet 4.6 的召回率与 Opus 4.8 相同,但它对 87% 的干净应用都高喊"有漏洞",因此其综合得分崩塌。Opus 4.7 胜出,是因为它是唯一既找得到漏洞、又知道何时保持沉默的模型。
我挑选出多个前沿模型都漏掉的用例,并在 Docker 中使用各自的私有 exploit 逐一复查:
27 cases missed by at least 2 models
25 cases missed by at least 3 models
18 cases missed by all 4 models
这 27 个用例仍然全部都能触发。它们不是损坏的用例,也不是错误的标注。
而且它们大多不是"模型读不懂代码"式的失败,而是链式推理失败——这类用例没有单独一行危险代码可以指向,你必须跨步骤追踪信任关系:
重要说明: 对于提示注入用例,我们使用的是类似 if/else 的场景,背后并没有真正的 LLM,因此这或许不太适合作为基准测试,但我还是决定把它们做出来,看看模型的反馈。
这是整个项目中最有趣的结果,详细记录在 docs/FINDINGS.md 中。
benchmark_release/public/           vulnerable apps the model sees
benchmark_controls_release/public/  clean controls
docs/                               methodology, dataset card, leaderboard, findings
assets/                             the charts in this README
analysis_false_negatives_20260530/  the hard missed cases, written up
评分相关内容被特意不放在这里:没有 ground truth、exploit 脚本、补丁、源码元数据或盲测映射。这些保持私有,以免公开基准泄露自己的答案。
cd benchmark_release\public\case_000001
docker compose up -d --build
docker compose ps
打开 docker-compose.yml 中列出的端口(通常为 http://localhost:9000),完成后使用 docker compose down 将其拆除。
python .\run_anthropic_benchmark.py `
  --run-name opus48_blind_20260529 `
  --run-dir runs\opus48_blind_20260529 `
  --model claude-opus-4-8 `
  --set both --blind --seed 20260529 --limit 238
还有一个对应的 run_openai_benchmark.py 用于 OpenAI 模型。完整的命令集、评分方式和恢复行为详见 docs/REPRODUCIBILITY.md。
在我用 AI 制作应用的过程中,我尝试并使用了若干模型来构建和放置漏洞(仅用于基准测试),并观察到 Opus 4.7 和 Sonnet 4.6 生成的代码中包含的漏洞远不止我要求的那一个。例如,模型本应只生成一个 RCE 或 XSS,但当我们为基准做检查时,模型们发现了更多漏洞,如 IDOR 和越权访问(Broken Access Control)。在相同的应用和相同的提示词下,GPT-5.5 medium 生成的应用只包含同样的那一个漏洞,但有时会出现影响更小的漏洞,比如 CSP 响应头配置问题。因此,如果你想用这些模型来创建 CTF,并且只是说"这部分必须是易受攻击的",你就必须仔细复查代码,尤其是使用 Claude 模型时。
首先,感谢发表这些用例所依据的研究成果的原始研究人员。感谢 vitorfhc 及其 Bug Bounty Daily,他汇集了大量用于构建本基准的报告。还要感谢 rez0 和 Justin Gardner 围绕 AI 辅助安全工作进行的交流与公开分享。
这些是刻意制造漏洞的应用。请仅在隔离的本地 Docker 环境中运行,切勿将它们部署到公共网络。