SMBv3从Windows 10/Server版本1903开始添加的压缩功能存在整数溢出漏洞,微软于2020年3月12日确认。攻击者可以利用该漏洞实现本地权限提升(LPE)和远程代码执行(RCE)。此处仅讨论LPE漏洞。
受影响版本:
分析srv2.sys文件,发现与解压缩相关的函数调用如下:``` js
Srv2ReceiveHandler
|
|
v
Srv2DecompressMessageAsync
|
|
v
Srv2DecompressData -------> SrvNetAllocateBuffer
|
|
v
SmbCompressionDecompress
|
|
v
memcpy
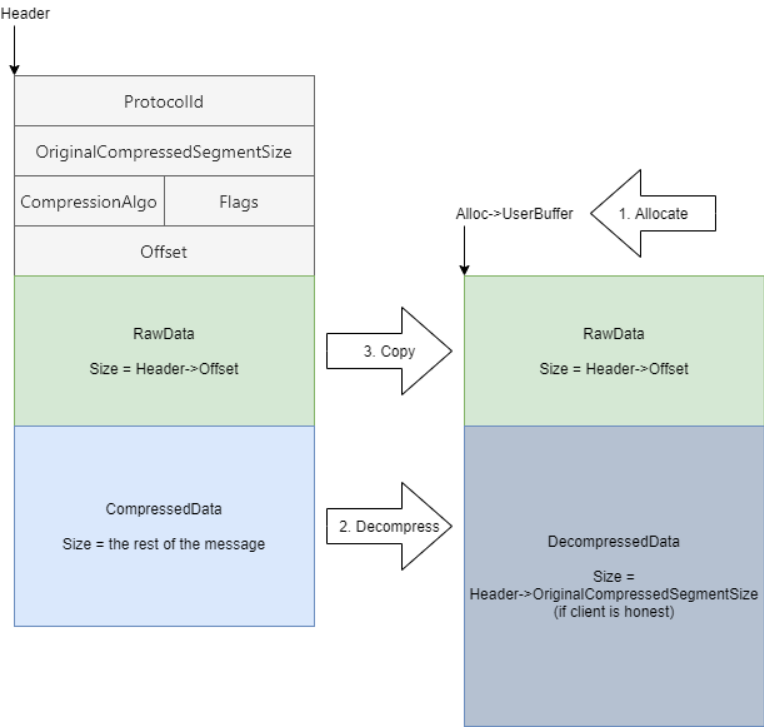
首先调用函数 `Srv2ReceiveHandler` 来接收一个 smb 数据包,并根据协议 `ProtocolId` 调用相应的函数。如果 `PrococolId` = 0x424D53FC,则会调用函数 `Srv2DecompressMessageAsync`,该函数会进一步调用 `Srv2DecompressData` 来解压数据包。函数 `Srv2DecompressData` 会调用 `SrvNetAllocateBuffer` 来分配一个 `Alloc` 用于存储解压后的数据,然后调用 `SmbCompressionDecompress` 进行解压,最后调用 `memcpy`。因此整个解压过程包括以下主要步骤:
- 1. Allocate
- 2. Decompress
- 3. Copy

根据 Microsoft 提供的文档,结构体 `COMPRESSION_TRANSFORM_HEADER` 用于在客户端和服务器之间发送和接收压缩数据。其结构如下:``` c
typedef struct _COMPRESSION_TRANSFORM_HEADER
{
   ULONG ProtocolId;
   ULONG OriginalCompressedSegmentSize;
   USHORT CompressionAlgorithm;
   USHORT Flags;
   ULONG Offset;
} ;
这里我们只关注上面的两个主要字段:
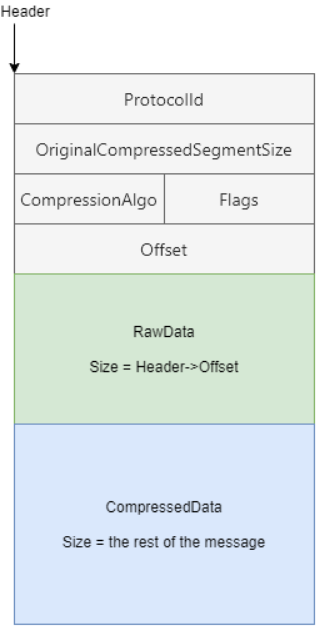
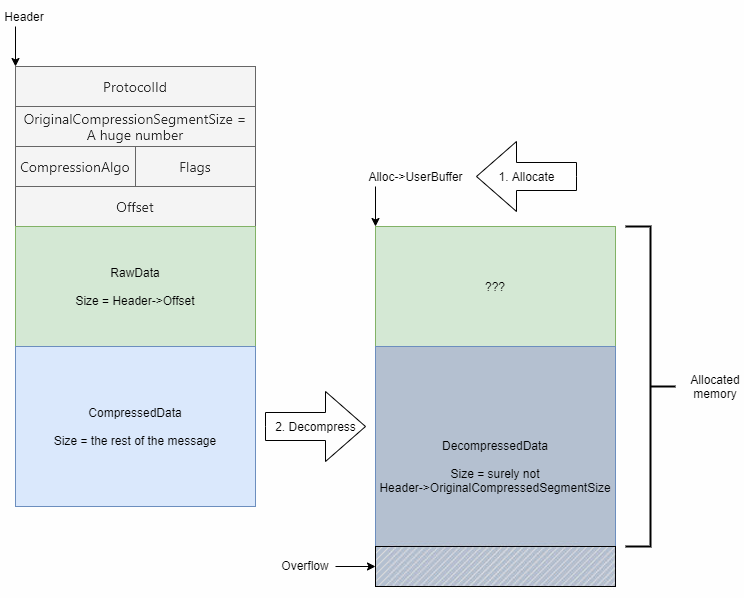
OriginalCompressedSegmentSize 是未压缩数据段的大小,以字节为单位。Offset 是压缩数据起始点与 _COMPRESSION_TRANSFORM_HEADER 结构结束点之间的字节偏移量。因此,压缩数据包的形式如下:
 ``` c
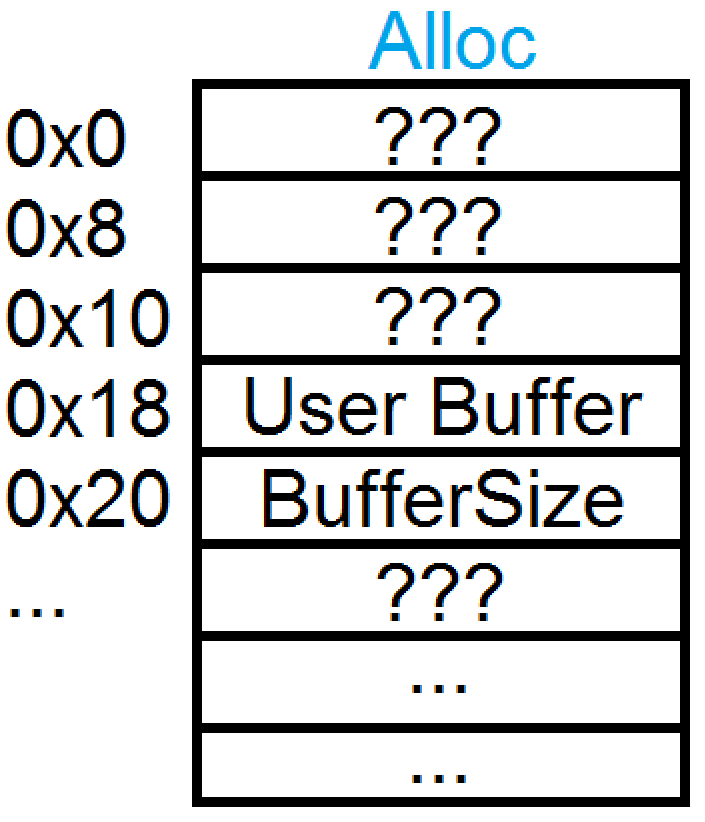
typedef struct _ALLOCATION_HEADER
{
// ...
PVOID UserBuffer;
// ...
} ALLOCATION_HEADER, *PALLOCATION_HEADER;
NTSTATUS Srv2DecompressData(PCOMPRESSION_TRANSFORM_HEADER Header, SIZE_T TotalSize) { PALLOCATION_HEADER Alloc = SrvNetAllocateBuffer( (ULONG)(Header->OriginalCompressedSegmentSize + Header->Offset), NULL); If (!Alloc) { return STATUS_INSUFFICIENT_RESOURCES; }
ULONG FinalCompressedSize = 0;

NTSTATUS Status = SmbCompressionDecompress(
    Header->CompressionAlgorithm,
    (PUCHAR)Header + sizeof(COMPRESSION_TRANSFORM_HEADER) + Header->Offset,
    (ULONG)(TotalSize - sizeof(COMPRESSION_TRANSFORM_HEADER) - Header->Offset),
    (PUCHAR)Alloc->UserBuffer + Header->Offset,
    Header->OriginalCompressedSegmentSize,
    &FinalCompressedSize);
if (Status < 0 || FinalCompressedSize != Header->OriginalCompressedSegmentSize) {
    SrvNetFreeBuffer(Alloc);
    return STATUS_BAD_DATA;
}

if (Header->Offset > 0) {
    memcpy(
        Alloc->UserBuffer,
        (PUCHAR)Header + sizeof(COMPRESSION_TRANSFORM_HEADER),
        Header->Offset);
}

Srv2ReplaceReceiveBuffer(some_session_handle, Alloc);
return STATUS_SUCCESS;
}
分析函数 `Srv2DecompressData`,发现该函数接收一个压缩数据包 `COMPRESSION_TRANSFORM_HEADER`(头部),然后通过 `SrvNetAllocateBuffer` 函数分配一块内存(Alloc),参数为 `Header->OriginalCompressedSegmentSize` + `Header->Offset` 的总和,随后解压压缩数据并将未压缩的数据复制到 `Alloc->Buffer` 中。
当 `Srv2DecompressData` 调用 `SrvNetAllocateBuffer` 时会发生整数溢出错误,`SrvNetAllocateBuffer` 实际上接收两个 64 位值,但在调用 `SrvNetAllocateBuffer` 时,`Srv2DecompressData` 仅传入两个 32 位值(ULONG)。而 `OriginalCompressedSegmentSize` 和 `Offset` 都是 ULONG 类型,当它们相加时,可能产生超过 32 位的数值。因此导致整数溢出错误(简单来说就是,将 0xffffffff(`OriginalCompressedSegmentSize`)与 0x10(`Offset`)相加会得到 0xf0000000f,但 `SrvNetAllocateBuffer` 只接收到 0x0000000f)。
整数溢出错误会导致 Alloc 内存分配错误(实际所需分配的大小小于实际大小),从而可能引发缓冲区溢出错误:
为了解缓冲区溢出是否发生以及如何发生,我们将分析 `SrvNetAllocateBuffer` 和 `SmbCompressionDecompress` 函数。``` c
PALLOCATION_HEADER SrvNetAllocateBuffer(SIZE_T AllocSize, PALLOCATION_HEADER SourceBuffer)
{
v2 = *MK_FP(__GS__, 420i64);
v3 = 0;
v4 = a2;
v5 = 0;
if ( SrvDisableNetBufferLookAsideList || allocSize > 0x100100 )
{
if ( allocSize > 0x1000100 )
return 0i64;
v11 = SrvNetAllocateBufferFromPool(allocSize, allocSize);
}
else
{
if ( allocSize > 0x1100 )
{
_RCX = allocSize - 256;
__asm
{
bsr rdx, rcx
bsf rax, rcx
}
if ( (_DWORD)_RDX == (_DWORD)_RAX )
v3 = _RDX - 12;
else
v3 = _RDX - 11;
}
v6 = SrvNetBufferLookasides[(unsigned __int64)v3];
v7 = *(_DWORD *)v6 - 1;
if ( (unsigned int)(unsigned __int16)v2 + 1 < *(_DWORD *)v6 )
v7 = (unsigned __int16)v2 + 1;
v8 = (unsigned int)v7;
v9 = *(_QWORD *)(v6 + 32);
v10 = *(_QWORD *)(v9 + 8 * v8);
if ( !*(_BYTE *)(v10 + 0x70) )
PplpLazyInitializeLookasideList(v6, *(_QWORD *)(v9 + 8 * v8));
++*(_DWORD *)(v10 + 20);
v11 = (unsigned __int64)ExpInterlockedPopEntrySList((PSLIST_HEADER)v10);
if ( !v11 )
{
++*(_DWORD *)(v10 + 24);
v12 = *(_DWORD *)(v10 + 44);
v13 = *(_DWORD *)(v10 + 40);
v14 = *(_DWORD *)(v10 + 36);
LODWORD(v15) = sub_1C00110B0(*(int (**)(void))(v10 + 48));
v11 = v15;
}
v5 = 2;
}
if ( v11 )
{
*(_WORD *)(v11 + 0x10) |= v5;
*(_WORD *)(v11 + 0x12) = v3;
*(_WORD *)(v11 + 0x14) = v2;
if ( v4 )
{
v24 = *(_DWORD *)(v4 + 0x24);
if ( v24 >= *(_DWORD *)(v11 + 0x20) )
v24 = *(_DWORD *)(v11 + 0x20);
v25 = *(void **)(v11 + 0x18);
*(_DWORD *)(v11 + 0x24) = v24;
memcpy(v25, *(const void **)(v4 + 0x18), v24);
v26 = *(_WORD *)(v4 + 0x16);
if ( v26 )
{
*(_WORD *)(v11 + 0x16) = v26;
memcpy((void *)(v11 + 0x64), (const void *)(v4 + 0x64), 0x10i64 * *(_WORD *)(v4 + 0x16));
}
}
else
{
*(_DWORD *)(v11 + 36) = 0;
}
}
return v11;
}
上面的代码来自IDA Pro的伪代码,看起来相当难以理解。然而,我们可以通过查看由Zecops重写的代码来简单理解:``` c PALLOCATION_HEADER SrvNetAllocateBuffer(SIZE_T AllocSize, PALLOCATION_HEADER SourceBuffer) { // ...
if (SrvDisableNetBufferLookAsideList || AllocSize > 0x100100) {
    if (AllocSize > 0x1000100) {
        return NULL;
    }
    Result = SrvNetAllocateBufferFromPool(AllocSize, AllocSize);
} else {
    int LookasideListIndex = 0;
    if (AllocSize > 0x1100) {
        LookasideListIndex = /* some calculation based on AllocSize */;
    }

    SOME_STRUCT list = SrvNetBufferLookasides[LookasideListIndex];
    Result = /* fetch result from list */;
}

// Initialize some Result fields...

return Result;
}
函数`SrvNetAllocateBuffer`接收需要分配的大小,然后检查该大小是否大于0x100100,如果大于则返回NULL。该函数还检查变量`SrvDisableNetBufferLookAsideList`,然而,我没有找到任何关于此变量的文档,并且它默认设置为0,所以可能不太重要。

如果条件满足,函数将继续根据输入的AllocSize计算一个索引值,然后根据计算出的索引从数组`SrvNetBufferLookasides`(该数组有9个元素)中取出一个值并进行分配。从汇编代码中,Zecops使用`python`计算出了每个索引对应的大小:``` py
>>> [hex((1 << (i + 12)) + 256) for i in range(9)]
[‘0x1100’, ‘0x2100’, ‘0x4100’, ‘0x8100’, ‘0x10100’, ‘0x20100’, ‘0x40100’, ‘0x80100’, ‘0x100100’]
因此,对于小于或等于0x1100大小的分配请求,函数将分配大小为0x1100的内存区域;对于大于0x1100且小于或等于0x2100大小的分配请求,函数将分配大小为0x2100的内存区域;更大分配请求的情况以此类推。
分配完成后,函数将返回一个地址,该地址存储了一个由Zcops命名为 ALLOCATION_HEADER 的结构体。根据研究,该结构体包含的数据如下: