全球首个自主逆向工程师。

用于逆向工程二进制文件的LLM编排
大多数任务遵循线性关系:任务越难,通常耗时越长。逆向工程(及二进制分析)是一种任务,其实际难度其实并不高,但执行时间却可能长达数小时甚至数天,即使是只有几百个函数的二进制文件也是如此。
Kong 使用NSA级别的逆向工程框架,将机械层自动化。Kong 可以接收一个完全混淆且剥离了符号的二进制文件,运行完整的分析管线:对函数进行分类、构建调用图上下文、通过LLM引导的反编译恢复类型和符号,并将结果写回 Ghidra 的程序数据库。输出的二进制文件中,某个 FUN_00401a30 变成了 parse_http_header,并恢复了结构体、参数名和调用约定。
为什么存在
剥离了符号的二进制文件丢失了所有使代码可读的上下文:函数名、类型信息、变量名、结构体布局。恢复这些上下文是大多数逆向工程任务的主要工作,而且很大程度上是模式匹配:识别标准库函数、从用法推断类型、通过调用图传播名称。
LLM 恰好擅长这类模式匹配。但直接将原始反编译器输出丢给LLM并问“这个函数是做什么的?”得到的结果平平无奇。模型缺乏调用上下文、交叉引用信息以及二进制文件结构的整体概况。此外,大多数混淆的二进制文件会引入极端的技术来阻止逆向工程。
Kong 的解决方案是:在接触LLM之前,先通过 Ghidra 的程序分析(调用图、交叉引用、字符串引用、数据流)构建丰富的上下文窗口,然后按依赖顺序编排分析,使每个函数都能从其已被命名的被调用者中受益。此外,Kong 还引入了它自己的、首创的自主反混淆管线。
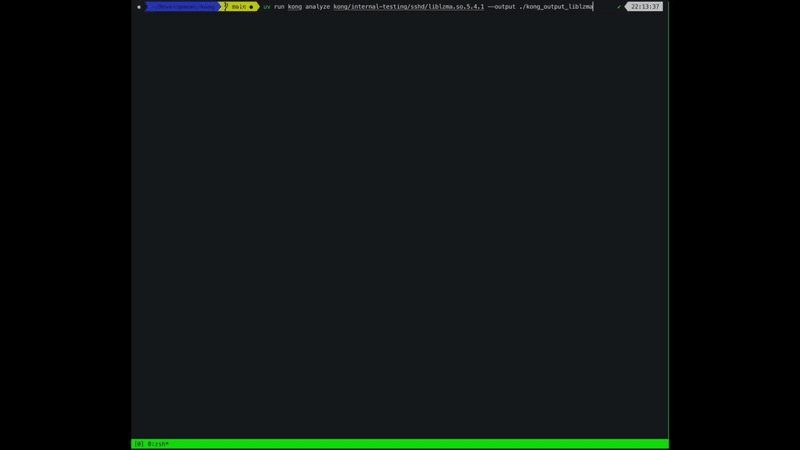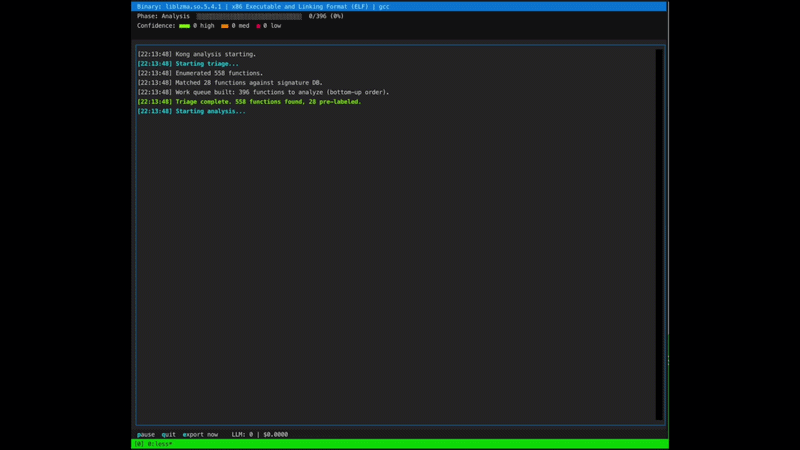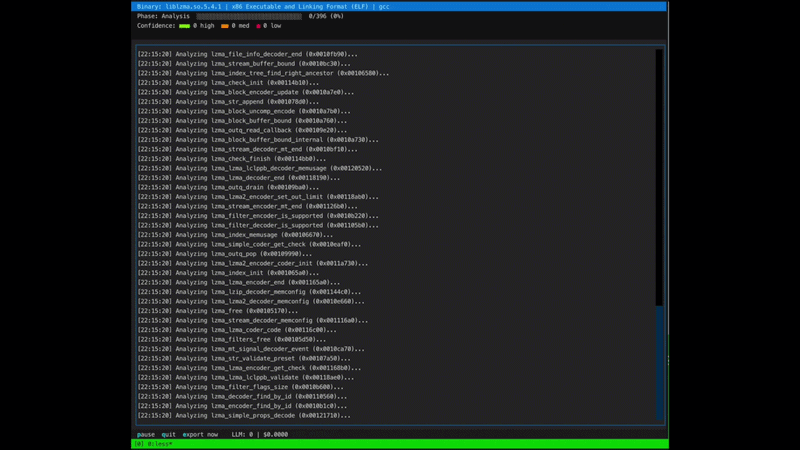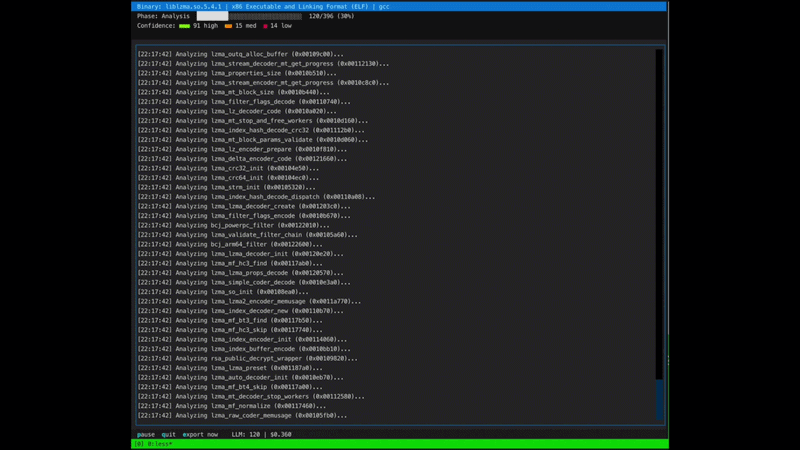
Kong 适用于大多数 Ghidra 可反编译的二进制文件(目前如此,更多架构即将推出)。
| C | C++ | Go | Rust | |
|---|---|---|---|---|
| x86 | 高 | 高 | 中 | 中 |
| x86-64 | 高 | 高 | 中 | 中 |
| ARM (32位) | 高 | 高 | 中 | 低 |
| AArch64 | 高 | 高 | 中 | 低 |
| MIPS | 中 | 中 | 低 | 低 |
| PowerPC | 中 | 中 | 低 | 低 |
高: Kong 能够可靠地反编译、去混淆并恢复名称、类型和结构。
中: 反编译可用但噪音较大。预期部分恢复和较低的置信度分数。
低: 反编译存在显著缺陷,结果将不完整、嘈杂或不可读。
注意: 二进制文件的大小与函数数量、LLM成本及完成时间正相关。然而,二进制文件的大小也与置信度负相关,因此在分析较大的二进制文件时请记住这一点。
Kong 采用由监督器协调的五阶段管线,负责协调分类、并行分析和后处理:
                    ┌──────────────────────┐
                    │       分类           │
                    │  枚举、分类、         │
                    │  构建调用图、         │
                    │  匹配签名             │
                    └──────────┬───────────┘
                               │
                               ▼
              ┌────────────────┼────────────────┐
              │                │                │
              ▼                ▼                ▼
     ┌──────────────┐ ┌──────────────┐ ┌──────────────┐
     │   分析       │ │   分析       │ │     ...      │
     │  (叶子函数)  │ │ (下一层级)   │ │              │
     └──────┬───────┘ └──────┬───────┘ └──────┬───────┘
            │                │                │
            └────────┬───────┴────────────────┘
                     │
                     ▼
            ┌──────────────────────┐
            │      清理            │
            │  规范化、去重        │
            └──────────┬───────────┘
                       │
                       ▼
            ┌──────────────────────┐
            │      综合            │
            │  统一名称、构建       │
            │  结构体、去混淆       │
            └──────────┬───────────┘
                       │
                       ▼
            ┌──────────────────────┐
            │      导出            │
            │  analysis.json +     │
            │  Ghidra 写回         │
            └──────────────────────┘
分类 枚举二进制文件中的所有函数,按大小(微小/小/中等/大)分类,构建调用图,检测源语言,并针对已知标准库和加密函数运行签名匹配。匹配签名的函数被标记为已解析,并跳过LLM分析。
分析 使用工作队列按从底向上的顺序处理调用图中的函数。对于每个函数,Kong 从 Ghidra 的程序数据库构建上下文窗口——反编译、交叉引用、字符串引用以及已分析被调用者的签名——规范化反编译器输出,并将其发送给LLM以恢复名称、类型和参数。如果在函数的反编译中检测到混淆,Kong 会运行一个带有符号工具访问权限的自主去混淆过程,然后再输出分析结果。结果会立即写回 Ghidra,以便下游调用者看到更新后的名称。
清理 统一分析过程中累积的结构体类型提议,并重试任何在分析阶段应用失败的函数签名。
综合 对所有已分析函数进行全局审视。使用一次LLM调用审查连接最多的函数,统一命名约定,从字段访问模式综合出结构体定义,并优化在更广泛上下文中看起来不一致的名称。
导出 写入最终的 analysis.json 并将所有恢复的名称、类型和签名应用回 Ghidra 的程序数据库。
# 1. 安装 Kong
uv pip install kong-re

# 2. 设置你的 API 密钥
export ANTHROPIC_API_KEY="sk-ant-..."
# 和/或
export OPENAI_API_KEY="sk-..."

# 3. 运行设置向导(仅首次)
kong setup

# 4. 分析一个二进制文件
kong analyze ./path/to/stripped_binary
设置向导让你选择要使用的 LLM 提供商,并设置默认提供商。Kong 会自动检测你的 Ghidra 和 JDK 安装位置,将二进制文件加载到进程内的 Ghidra 实例中,并运行完整的管线。
git clone https://github.com/amruth-sn/kong.git
cd kong
uv sync
uv run kong setup
uv run kong analyze ./path/to/stripped_binary
| 变量 | 是否必需 | 描述 |
|---|---|---|
ANTHROPIC_API_KEY | 至少一个 | Anthropic API 密钥(Claude) |
OPENAI_API_KEY | 至少一个 | OpenAI API 密钥(GPT-4o) |
GHIDRA_INSTALL_DIR | 否 | Ghidra 安装路径(如未设置则自动检测) |
JAVA_HOME | 否 | JDK 路径(如未设置则自动检测) |
KONG_CONFIG_DIR | 否 | 覆盖配置目录(默认:~/.config/kong) |
# 运行设置向导
kong setup

# 分析一个剥离了符号的二进制文件(使用配置的默认提供商)
kong analyze ./binary

# 使用特定提供商分析
kong analyze ./binary --provider openai

# 覆盖模型
kong analyze ./binary --provider openai --model gpt-4o-mini

# 显示二进制文件元数据而不运行分析
kong info ./binary

# 对照真实源码评估分析输出
kong eval ./analysis.json ./source.c
结果写入输出目录(默认:./kong_output_{binary_name}/):
kong_output_{binary_name}/
├── analysis.json         # 所有恢复的函数名称、类型、参数
└── events.log            # 管线执行追踪
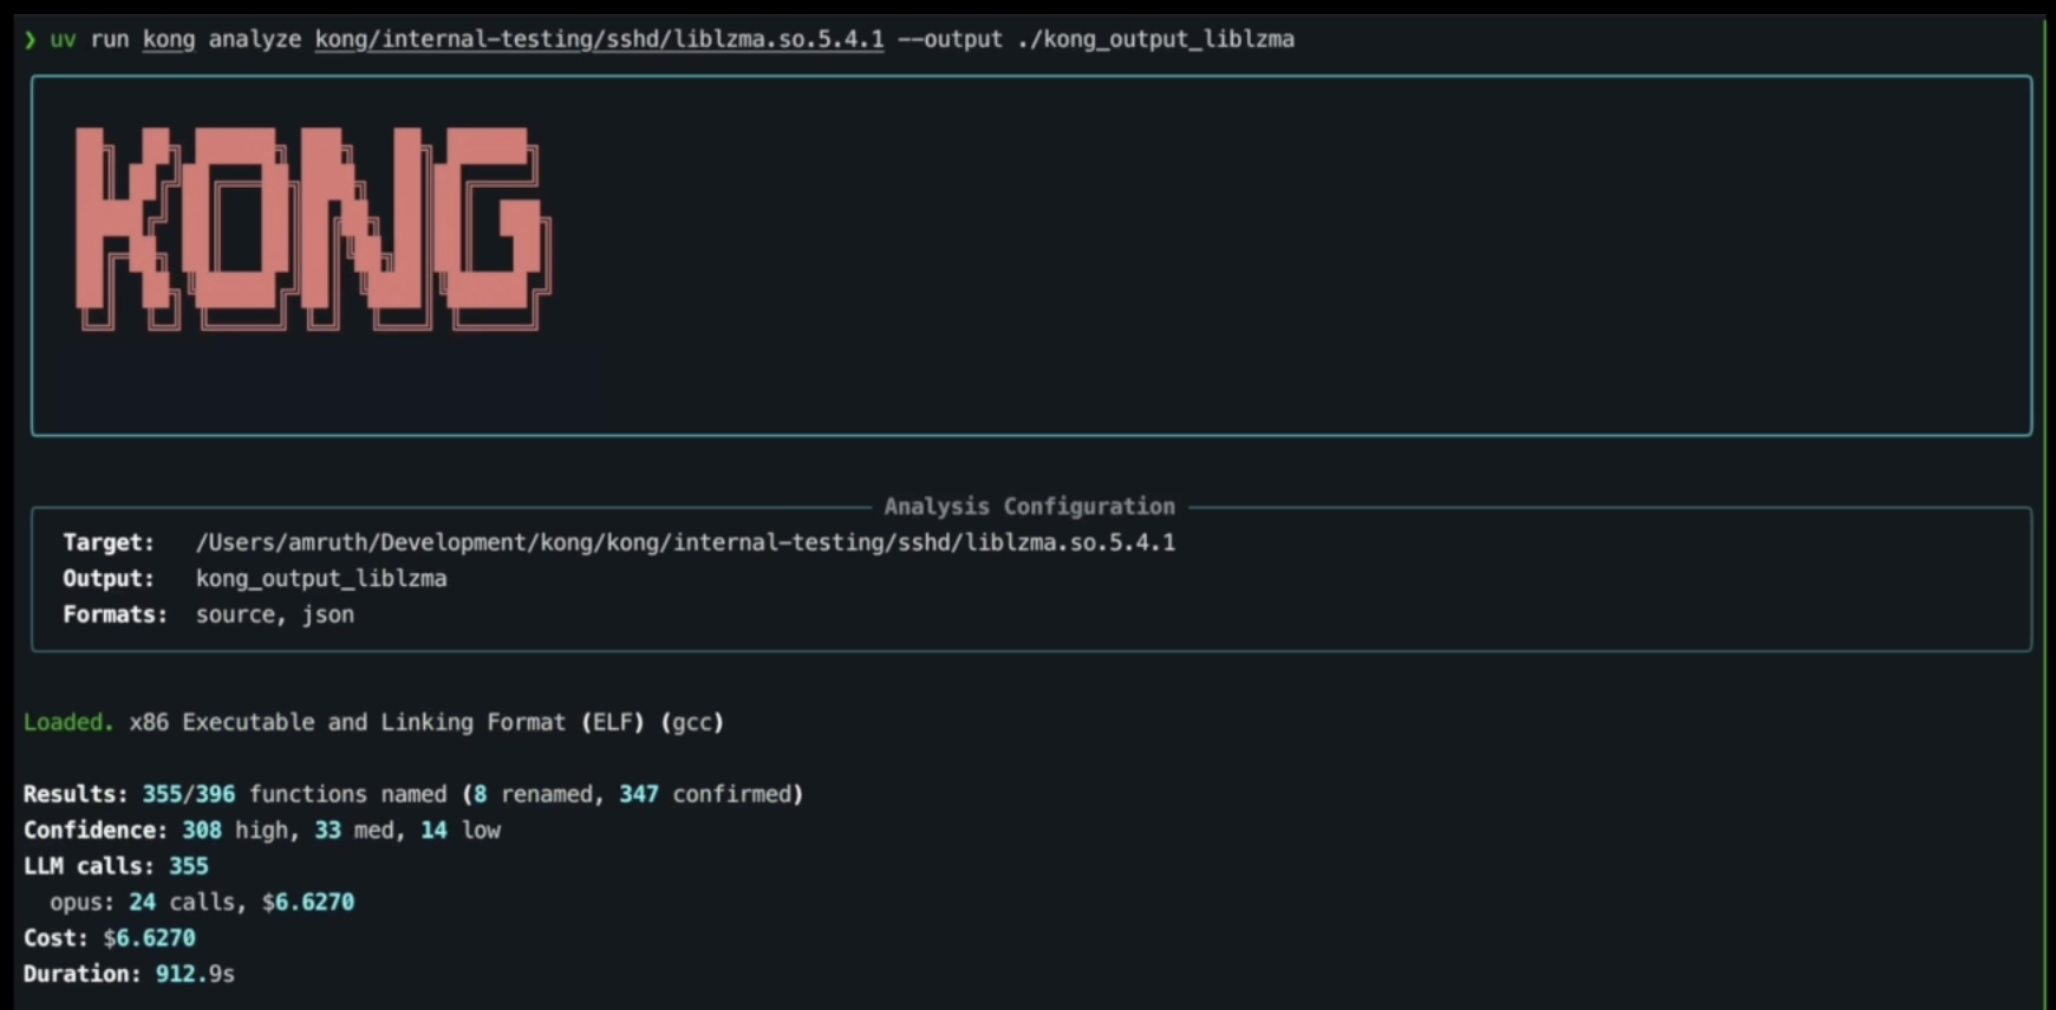
Kong 自主地从剥离了符号的 liblzma.so.5.4.1 中重构了完整的 XZ 后门(CVE-2024-3094)攻击链——在15分钟内以90-95%的置信度识别了所有五个核心植入函数,成本为 $6.63。
请参阅 BENCHMARKS.md 获取完整案例研究和复现说明。