
 seclog-open/seclog
Собирает журналы безопасности из нескольких источников в воспроизводимых сценариях атак на Docker, строит цепочки атак и предоставляет бенчмарк SecLog-Bench-216 для оценки рассуждений LLM на этапах атаки.

SecLog поддерживает исследования по рассуждению об этапах атаки на основе журналов безопасности из множества источников. Он предоставляет инструменты для сбора журналов из воспроизводимых сценариев Docker-атак и обычной активности, организации свидетельств в цепочки атак, построения размеченных наборов данных и оценки предсказаний моделей.
Релиз включает SecLog-Bench-216 — готовый к использованию бенчмарк из 216 окон свидетельств с проверенными метками этапов и эталонными цепочками рассуждений. Исследователи могут использовать предоставленный бенчмарк напрямую или запустить конвейер построения для получения новых данных.
Статья: SecLog-Bench: A Scalable Benchmark for Cybersecurity Log Reasoning with Scaffolded Evidence.
Ресурсы для построения на Zenodo: Docker-образы, исходные журналы и индексы выравнивания и построенные цепочки атак.
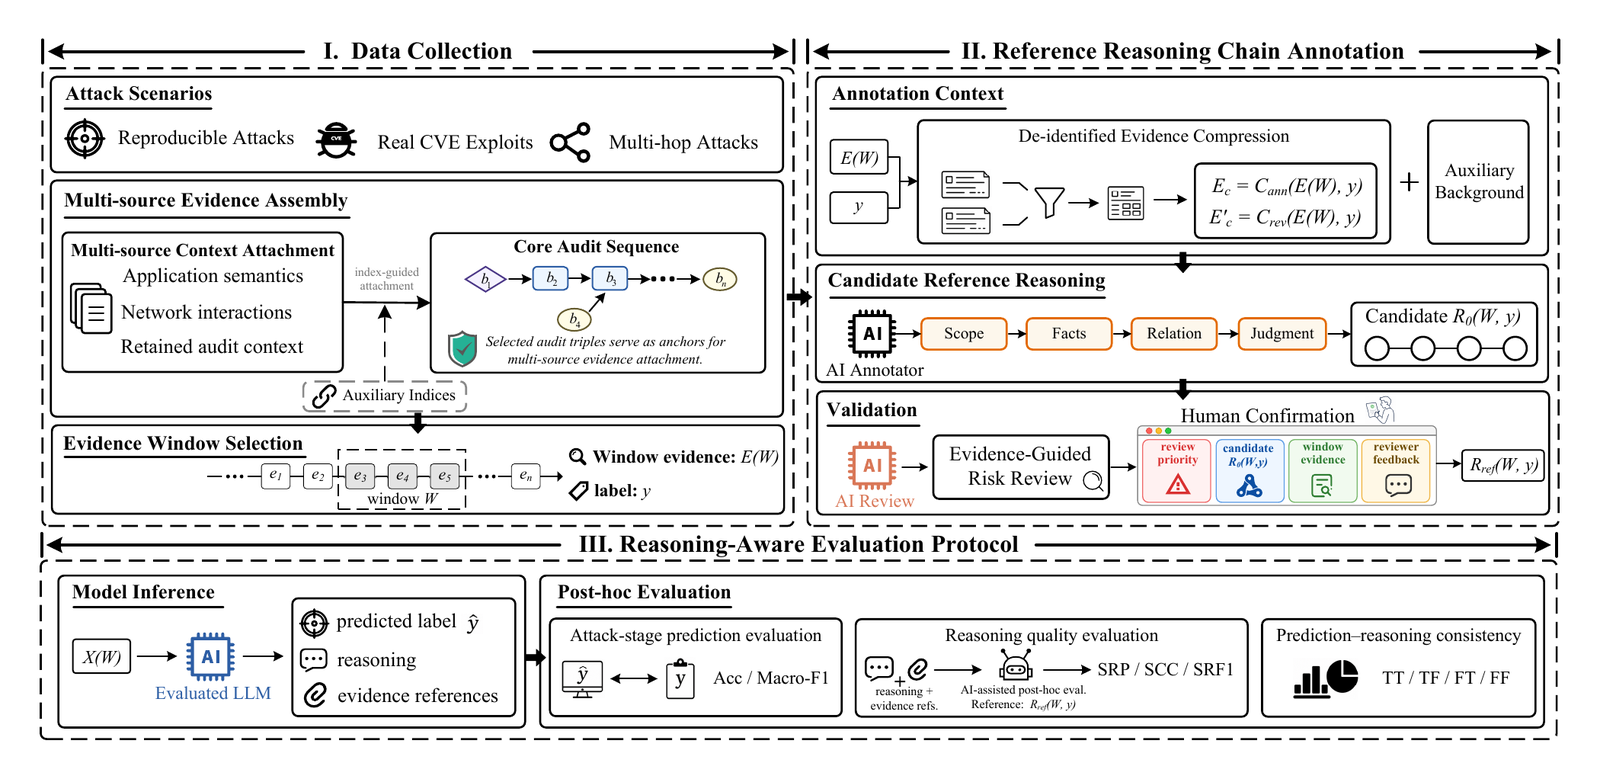
Рисунок 1. Обзор SecLog. Часть I соответствует этапам 01–04, Часть II — рабочему процессу аннотирования и проверки в 05, а Часть III — рабочему процессу оценки в 05 с SecLog-Bench-216.
| Ваша цель | Начните здесь | Окружение |
|---|---|---|
| Прочитать или повторно использовать предоставленный набор данных | SecLog-Bench-216 и примеры данных | Любое средство чтения JSONL; Python 3.11 для валидатора |
| Оценить модель на предоставленном бенчмарке | Быстрый старт | Python 3.11; конечная точка API и ключ для входящего в комплект средства запуска вывода |
| Собрать новые журналы и построить набор данных или бенчмарк | Построение данных | Ubuntu Linux, Python 3.11, Poetry, Docker и инструменты захвата |
Подробные системные пакеты, дополнительные компоненты и версии зависимостей перечислены в ENVIRONMENT_DEPENDENCIES.md.
Эти команды используют Bash и выполняются из корня проекта. Начните с изолированного окружения Python 3.11:
python3.11 -m venv ../seclog-env
source ../seclog-env/bin/activate
Приведённые ниже команды используют стандартную библиотеку Python. Для сбора журналов, аннотирования, интерфейса проверки и дополнительного анализа см. руководство по окружению.
python 05_benchmark_annotation_review_evaluation/scripts/validate_public_benchmark.py
Валидатор проверяет количество образцов, идентификаторы, распределение меток, ссылки на доказательства и хеши манифеста. При успешной проверке в выводе JSON указываются validation_passed: true и sample_count: 216.
Замените your-model-name на идентификатор модели, поддерживаемый вашим провайдером:
python 05_benchmark_annotation_review_evaluation/evaluation/run_benchmark_inference.py \
  --prompt-pack SecLog-Bench-216/data/prompt_pack.jsonl \
  --model your-model-name \
  --output ../seclog-runs/example/raw_responses.jsonl
Эта команда сообщает mode: preflight_no_api и количество промптов. Она
не обращается к провайдеру и не создаёт файл ответа, а также не
проверяет, что провайдер поддерживает выбранную модель.
Задайте OPENAI_API_KEY в окружении вашей оболочки, заменив заполнитель
ниже на ключ вашего провайдера, затем явно включите вызовы API:
export OPENAI_API_KEY="YOUR_API_KEY"
python 05_benchmark_annotation_review_evaluation/evaluation/run_benchmark_inference.py \
  --prompt-pack SecLog-Bench-216/data/prompt_pack.jsonl \
  --model your-model-name \
  --output ../seclog-runs/example/raw_responses.jsonl \
  --call-api
Раннер использует чат-эндпоинт, совместимый с OpenAI. Базовый URL по умолчанию —
https://api.openai.com/v1; передайте --base-url для другого эндпоинта и
--api-key-env для другого имени переменной с ключом. Держите выходной каталог
вне дерева релиза, как в этом примере. Используйте новый выходной путь для каждого
запуска или добавьте --resume, чтобы продолжить работу с существующим файлом ответов.
Чтобы использовать собственную систему инференса, включая модели, которые отклоняют temperature,
max_tokens или режим JSON, используйте SecLog-Bench-216/data/prompt_pack.jsonl и
формат предсказаний, затем передайте
сырые выходные данные нормализатору ниже.
python 05_benchmark_annotation_review_evaluation/evaluation/normalize_stage_reasoning_predictions.py \
  --input ../seclog-runs/example/raw_responses.jsonl \
  --output ../seclog-runs/example/predictions.jsonl

python 05_benchmark_annotation_review_evaluation/evaluation/evaluate_stage_reasoning_predictions.py \
  --gold SecLog-Bench-216/data/gold_labels.jsonl \
  --reference-chains SecLog-Bench-216/data/reference_reasoning_chains.jsonl \
  --model-input SecLog-Bench-216/data/evidence_windows.jsonl \
  --sample-index SecLog-Bench-216/data/sample_index.jsonl \
  --predictions ../seclog-runs/example/predictions.jsonl \
  --output-dir ../seclog-runs/example/evaluation
Результаты включают:
| Выходные данные | Содержимое |
|---|---|
predictions.jsonl | Нормализованные предсказания модели |
invalid_outputs.jsonl | Ответы, которые не удалось успешно нормализовать |
evaluation/metrics_summary.json | Агрегированные метрики оценки |
evaluation/per_sample_results.jsonl | Результаты по каждому образцу |
evaluation/confusion_matrix.csv | Матрица ошибок предсказания стадий |
evaluation/per_stage_metrics.csv | Метрики по стадиям |
evaluation/error_cases.jsonl | Случаи, сохранённые для анализа ошибок |
Пересечение эталонных данных и доказательств в этом оценщике носит диагностический характер. Формальная оценка качества рассуждений требует дополнительного контрольного списка и рабочего процесса проверки ассистентом в разделе Post-hoc reasoning quality.






