

 amd2g2zz/kunglao-agent
Экспертный агент по обратной разработке: планирует собственный путь анализа, выводит каждый факт из необработанных данных и сходится под механическими воротами верификации — прошивки, протоколы, web/JS, риск-контроль, бинарники.
Автономный агент обратной разработки, который работает часами без присмотра, независимо проверяет каждый вывод и сходится только тогда, когда каждый ответ выдерживает механический вердикт оракула.


🧠 сам планирует свой маршрут · 🔬 каждое утверждение проверяется машиной · ⚖️ слепая верификация всего · 📈 цикл измеряет сам себя
🚀 Быстрый старт · ✨ Ключевая технология · 🧠 kunglao × Claude Code · 🎛️ Как работает RL · 🖥️ Демонстрация · 📖 Разборы случаев · 🧪 Оценка · 🏗️ Архитектура · 🗓️ План развития
English · 简体中文
[!WARNING] v0.1.6 — последняя линейка релизов, нативная для Claude Code. Следующая веха (v0.2) полностью переносит среду выполнения на базу PI Agent — тот же цикл, те же журналы, новый субстрат движка. См. план развития.
Вы указываете kunglao-agent цель и формулируете вопросы; он планирует маршрут, распределяет специализированных исполнителей, независимо проверяет каждый вывод и останавливается только тогда, когда каждый ответ установлен механической проверкой, а не на словах модели.
Спектр целей — полный: нативные бинарники Windows/Linux, Android APK
(включая нативные слои .so), web/JS, восстановление протоколов, прошивки —
по дизайну сначала статика, с использованием любого канала выполнения, уже
имеющегося в вашей среде (VMware, ssh, docker, adb или вообще никакого для
работы только со статикой).
Он работает внутри Claude Code как плагин: Claude Code — это поверхность диалога; продукт — это цикл и база фактов, которую он производит.
[!NOTE] Каждое число, которое сообщает цикл — доли побед, апостериорные оценки, бюджеты — прослеживается до строки в журнале, доступном только для добавления. Ничто не заявляется самостоятельно.
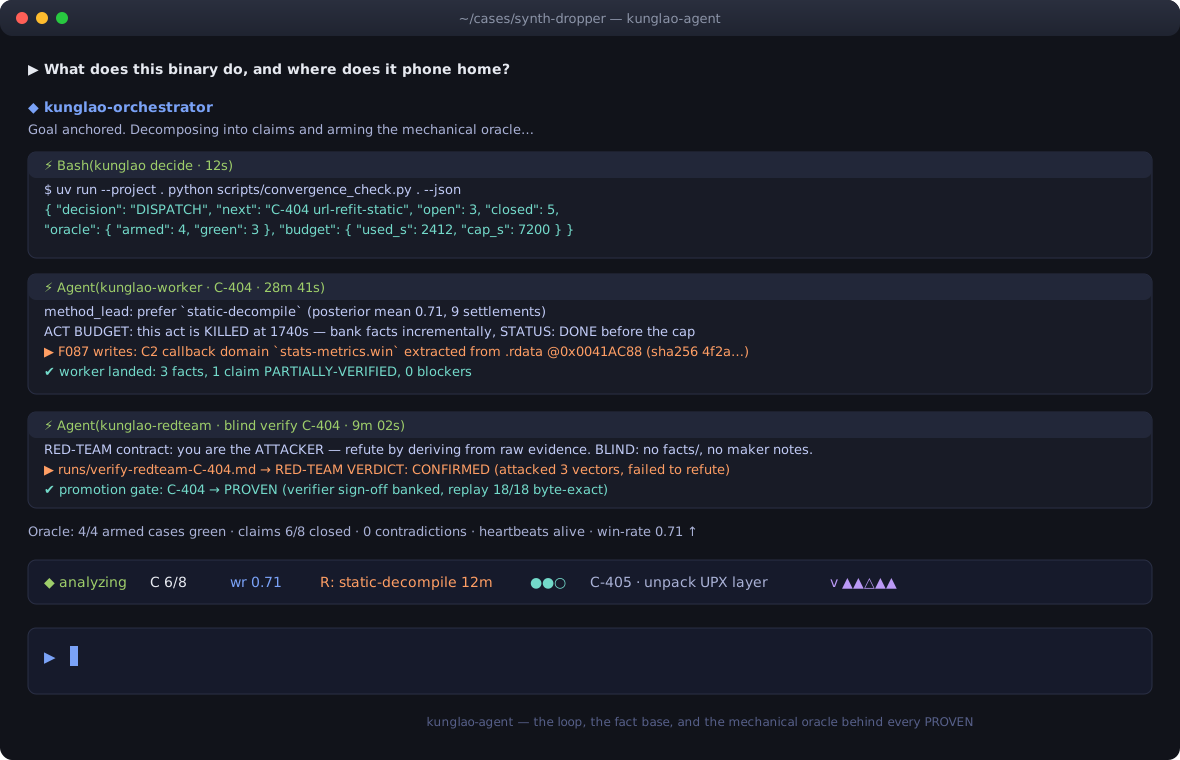
Оркестратор в работе — решение о сходимости, распределение исполнителя
с бюджетом и потоком поступающих фактов, и слепой вердикт red-team,
повышающий утверждение до PROVEN; HUD в статусной строке держит всё
взаимодействие читаемым с первого взгляда:
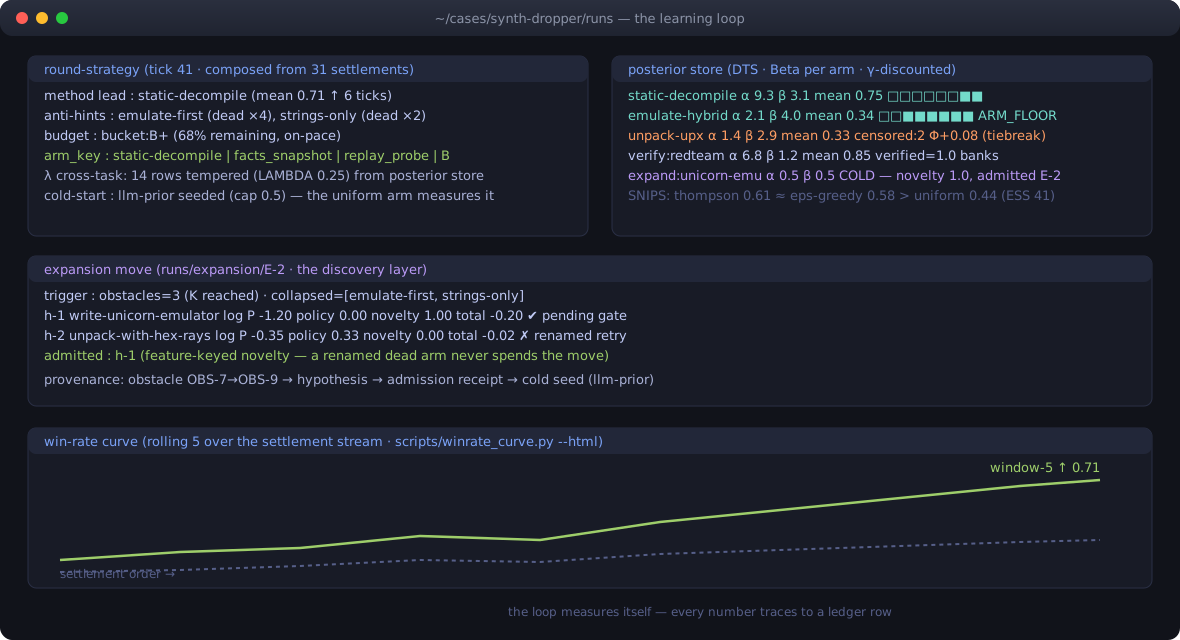
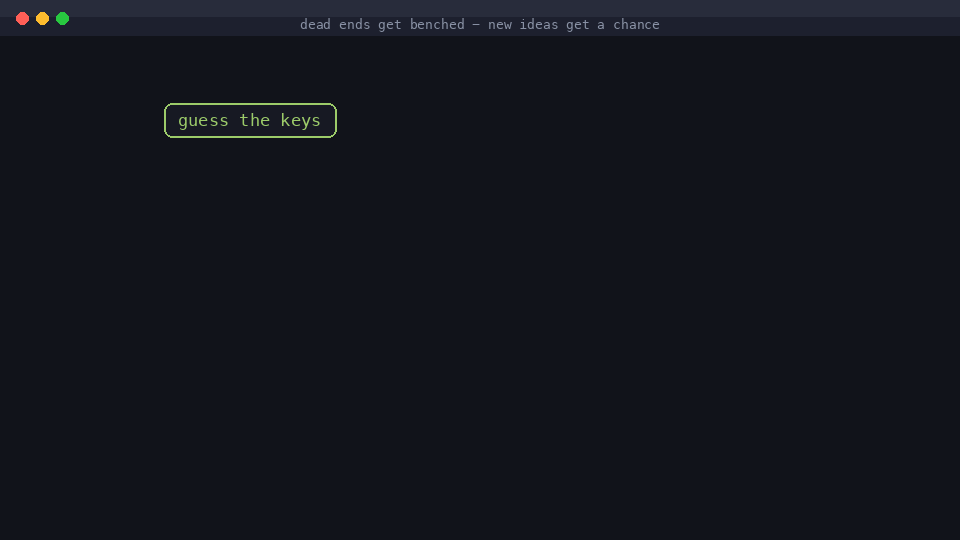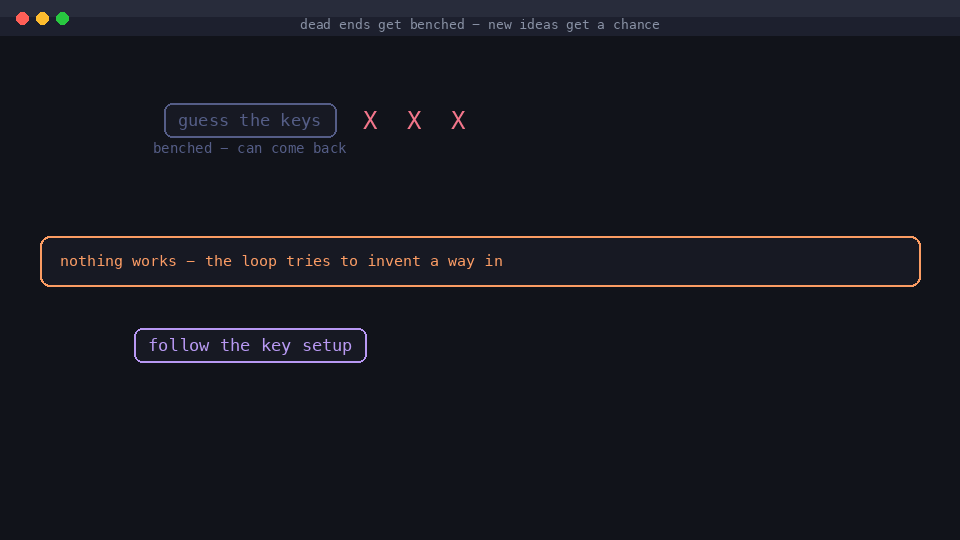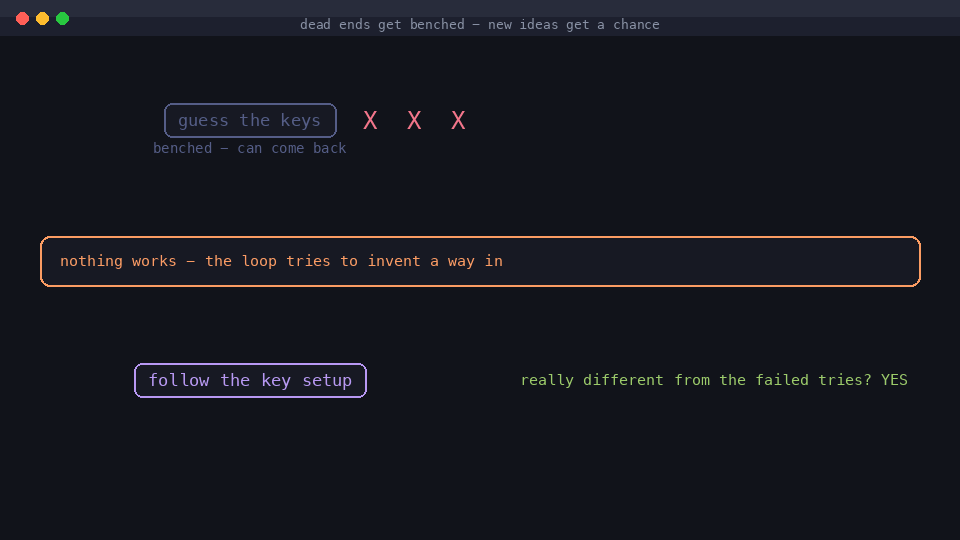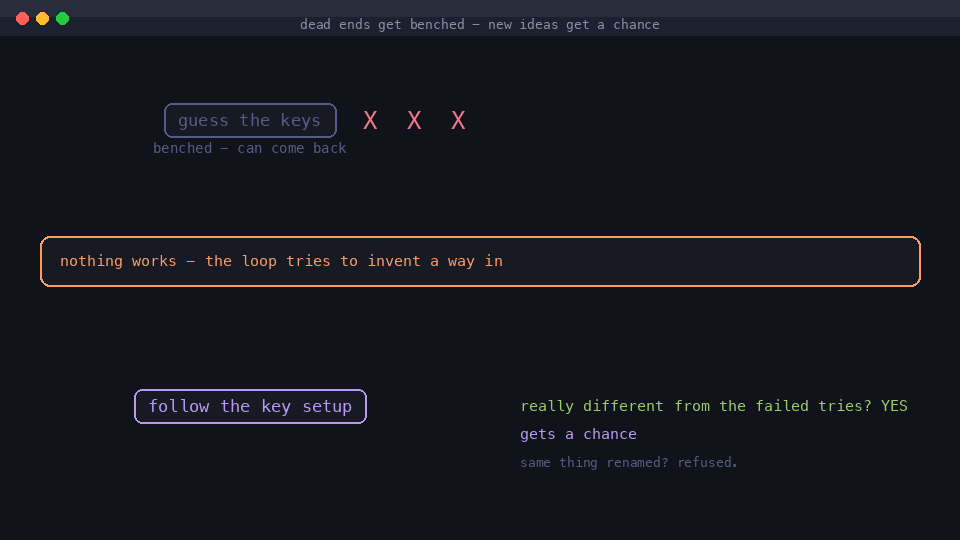
Цикл измеряет сам себя — стратегия раунда, составленная из расчётов, хранилище апостериорных оценок на дисконтированном Thompson с разрешением ничьих по цензурированным исходам, слой обнаружения, допускающий по-настоящему новую ветвь (и отвергающий переименованную повторную попытку), и кривая доли побед:
kunglao-agent — это RL-контроллер уровня действий вокруг Claude Code: Claude
Code рассуждает внутри каждого действия; kunglao решает, каким будет следующее
действие, проверяет его, оценивает его, учится на нём. Глубокий дизайн: docs/design/.
STAMP, но никогда PROVEN. Факты ссылаются на артефакты
(sha256) и несут команды reproduce:.Claude Code — это двигатель; kunglao — коробка передач, приборная панель и бортовой компьютер — следующее действие, верификация, бюджет и то, куда идёт опыт.
| голый Claude Code | + kunglao | |
|---|---|---|
| Следующий шаг | импровизация в рамках сессии | выученная политика уровня действий, апостериорные оценки сохраняются между задачами |
| Верификация | самоотчёт | механический оракул + слепой red-team |
| Длительность | одна сессия, человек наблюдает | часы без присмотра, возобновление с диска |
| Опыт | испаряется в конце сессии | журнал → апостериорные оценки → более точная начальная ставка |
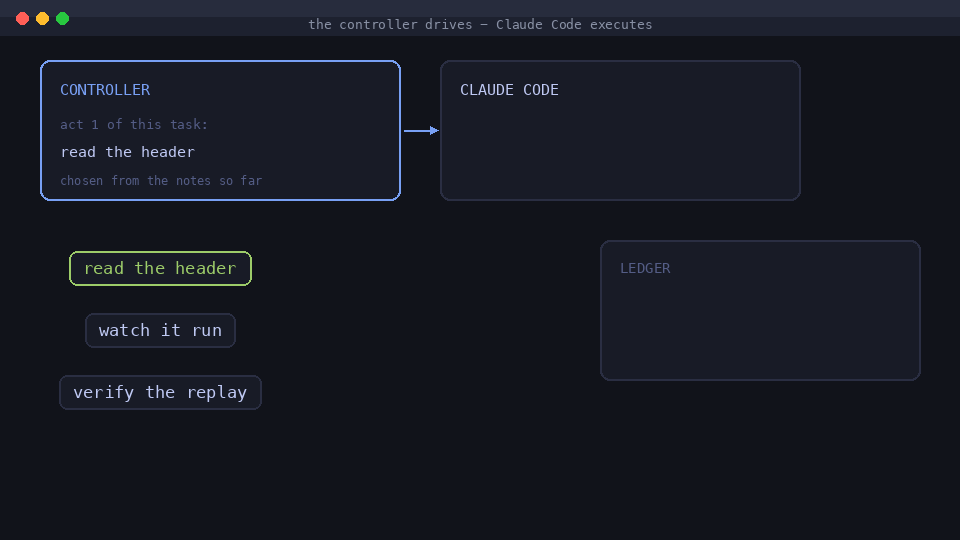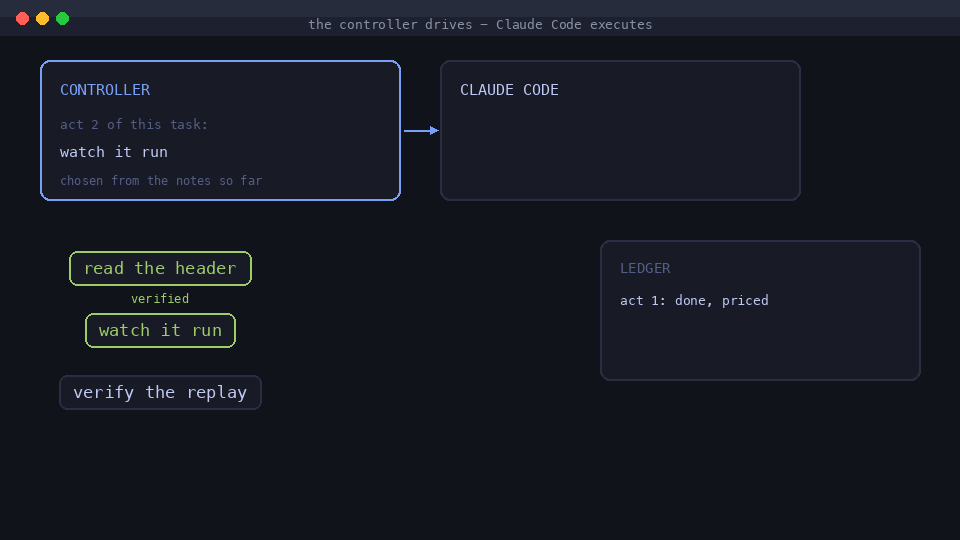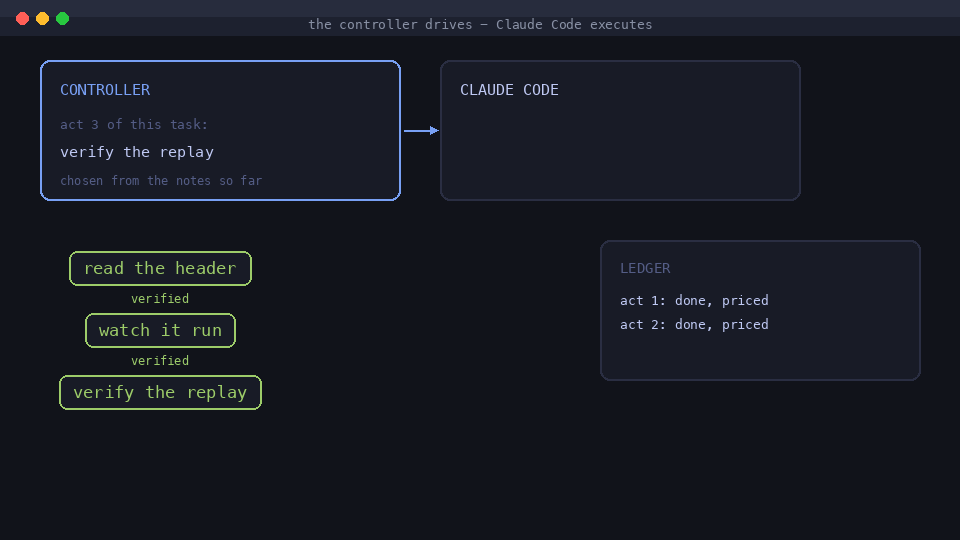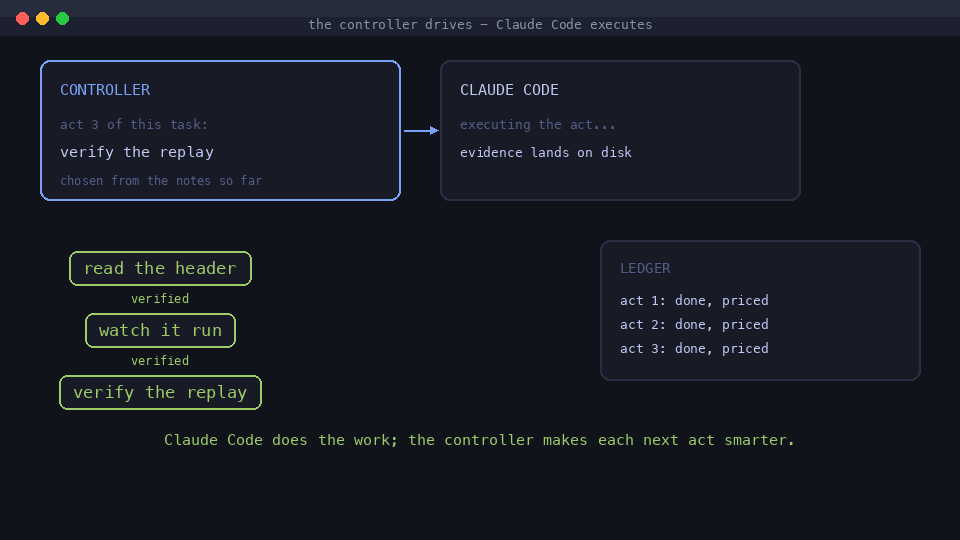
Честная граница: для простой задачи в одну сессию голый Claude Code выигрывает — таблица оценки это подтверждает. kunglao окупается на длинных горизонтах, дисциплине верификации и межзадачном накоплении.
Первая задача нового типа платит полную цену: цикл пробует метод, наблюдает его провал, пробует другой. Но каждая попытка записана — и следующая задача того же типа открывается из этих заметок, а не с нуля.
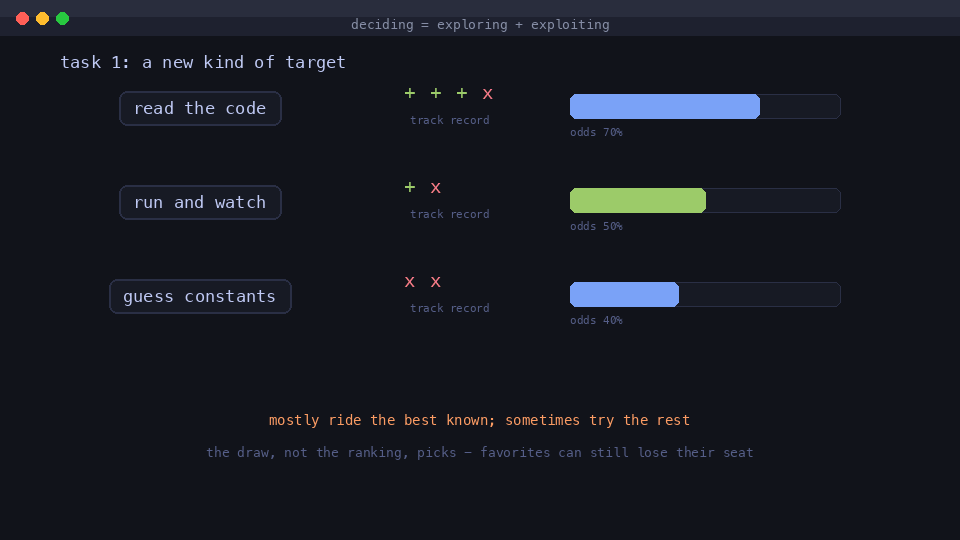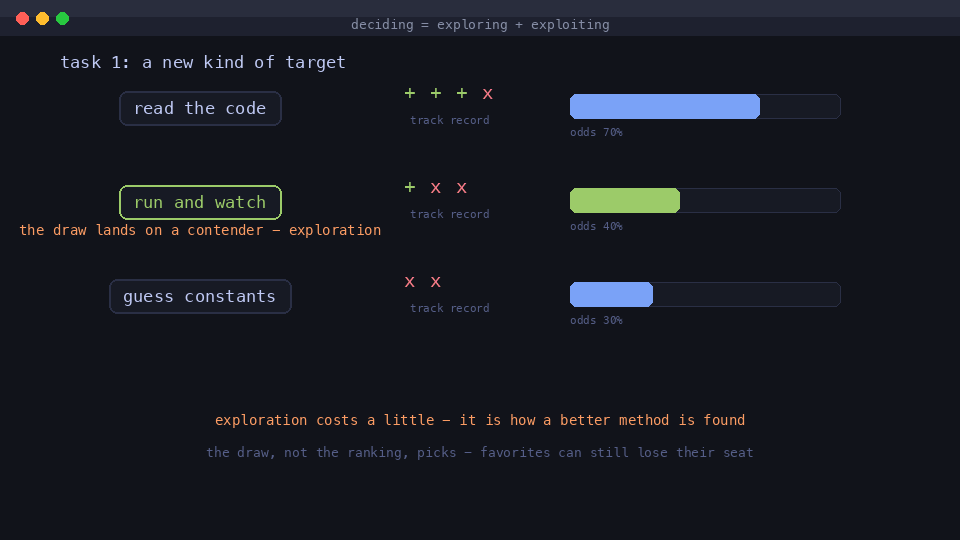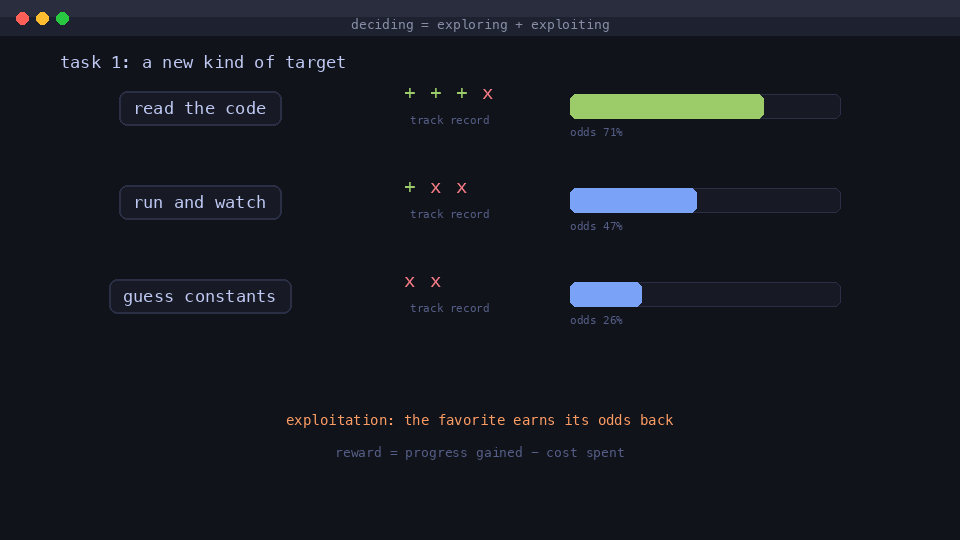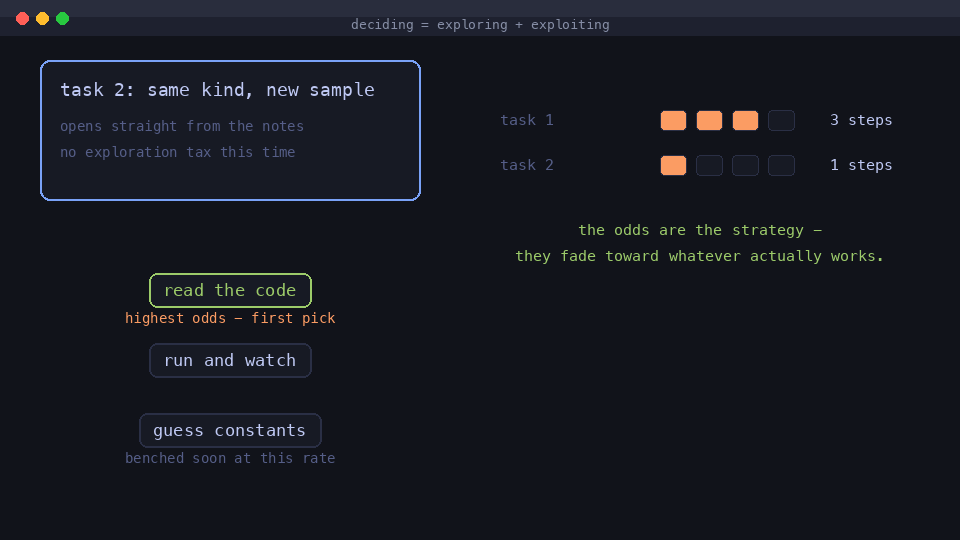
В этом вся идея онлайн-обучения с подкреплением здесь: цикл обновляет себя между действиями, прямо на работе — без обучающего набора данных, без переобучения модели, без офлайн-фазы. Опыт каждой задачи сохраняется до принятия следующего решения.
1. Правильный первый ход для каждого типа цели. Простой скрипт и укреплённое приложение не должны открываться одинаково. Цикл ведёт отдельные заметки для каждого типа цели — то, как выглядит цель, определяет, какой плейбук применяется.
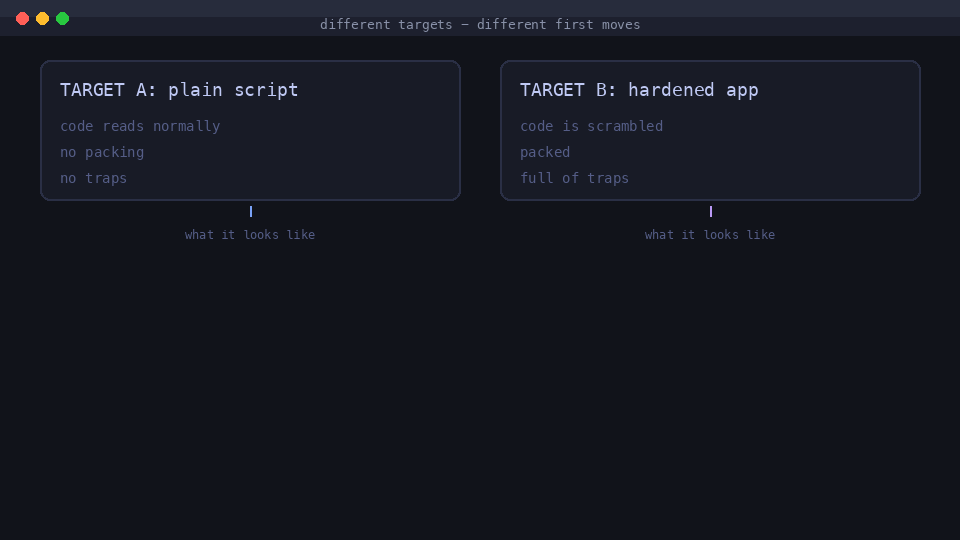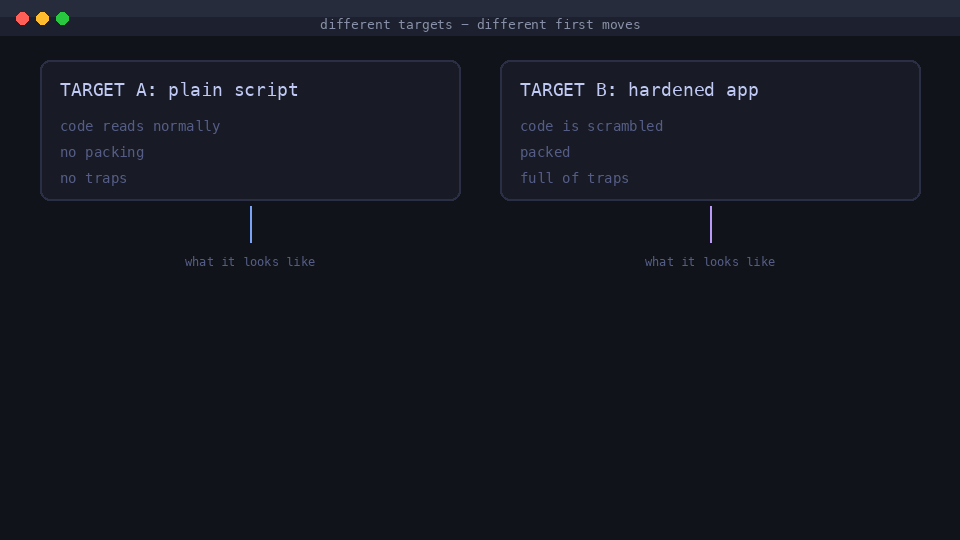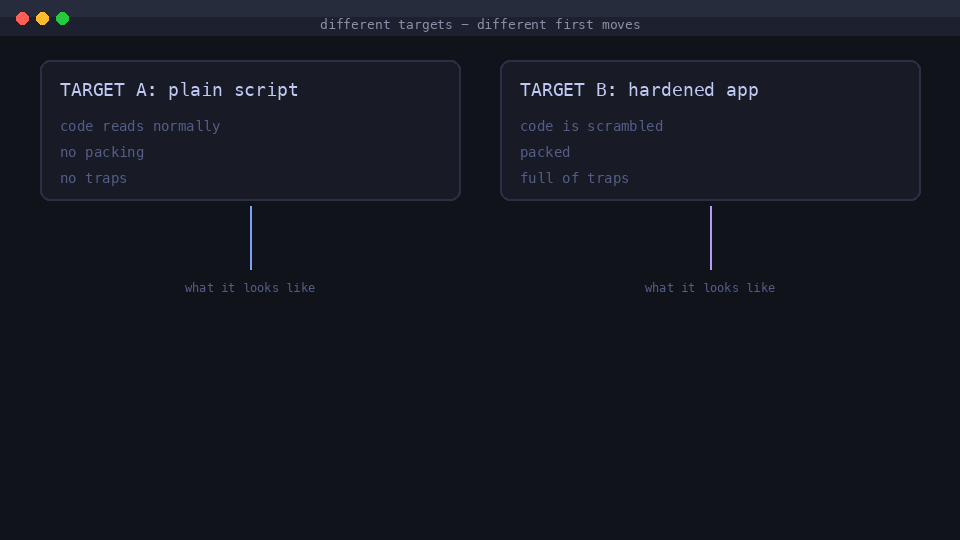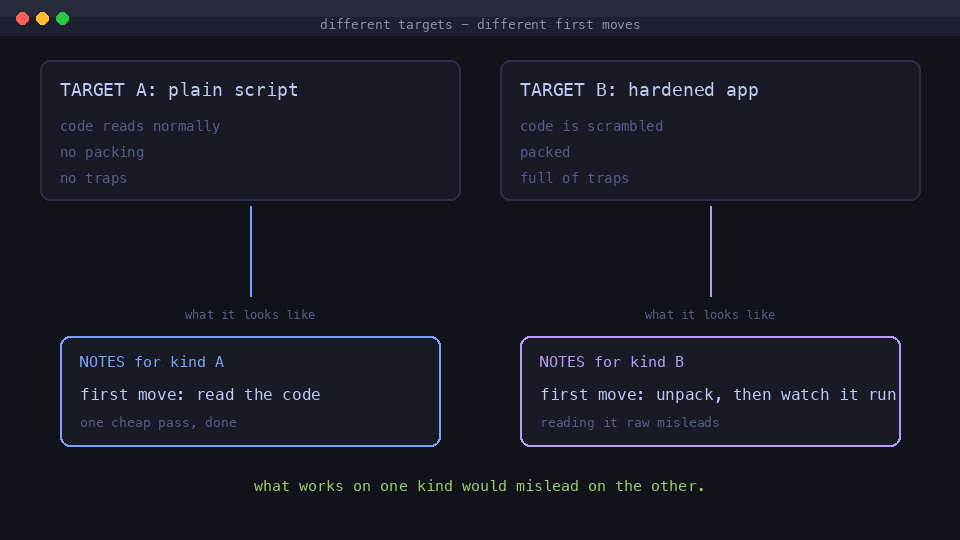
2. Какие методы мертвы. Метод, который постоянно терпит неудачу, отправляется на скамейку — он перестаёт съедать бюджет (но никогда не удаляется; если цель изменится, он может вернуться). А когда ничего не работает, цикл пытается изобрести путь внутрь: действие-открытие предлагает по-настоящему новый подход, проверяемый против неудачных попыток — та же идея под новым именем отвергается.
3. Где перепроверять. Состояния, где верификаторы постоянно получают опровержения, учатся планировать верификацию там плотнее — и расслабляются, когда серия становится честной. 4. Какие инструменты маршрутизировать. Выбор инструментов и провайдеров тоже выучивается: инструмент, который терпит неудачу, понижается на время и восстанавливается в тот момент, когда снова работает — маршрутизация следует за записанными исходами, а не за порядком в реестре.

