
 #1
Инструменты безопасности LLM, инъекции промптов, извлечения моделей, состязательного ИИ и ред-тиминга ИИ.
Рекомендация Kitploit

 foxcornlab/thc-bloodmiami
Инструмент для пентестинга AI-чат-боксов на C: отправляет в чат-интерфейсы пейлоады языковых (SQLi/NoSQL/XSS/SSTI) и промпт-инъекций и помечает те,…
 owasp/agentic-evidence
Эталонный проект OWASP для доказательств безопасности агентного ИИ: сопоставляет выполнение агентов, идентификацию, вызовы инструментов и решения об…
 owasp/agentic-vulnerability-discovery-and-validation-harness
Агентная среда, автоматизирующая обнаружение и валидацию уязвимостей, оркестрируя рабочие процессы анализа на основе ИИ для подтверждения…
 owasp/llmsec
Проект OWASP, посвящённый безопасности приложений на основе больших языковых моделей: рассматривает риски, специфичные для LLM, рекомендации по…
 owasp/robotics-security-testing-guide
OWASP guide defining a standardized penetration testing methodology for humanoid, industrial, and autonomous robots, covering ROS/ROS2, DDS, CAN bus,…
 owasp/the-agents-epistemic-baggage
Ориентированная на аудит модель риска, описывающая, как выводы, создаваемые агентами, могут менять эпистемический статус, приобретать операционные…
 cdxgen/cdxgen
Creates CycloneDX Bill of Materials (BOM) for your projects from source and container images. Supports many languages and package managers. Integrate…
 trailofbits/brotli-checker
Навык для Claude Code и Codex по поиску потенциально уязвимых копий Brotli и руководству по обновлению для CVE-2026-111497.
 gmh5225/ollama-hunter
Сканирует Shodan на предмет публично доступных серверов Ollama и llama.cpp, перечисляя хосты, местоположения и доступные модели для исследований в…
 asngs/agenttriage-open-source
Система кросс-агентной трассировки и диагностики безопасности для LLM-агентов, использующих инструменты: нормализует события трассировки, строит…
 suels-group/beyond_asr
Исследовательский код для измерения показателей успешности атак типа jailbreak (ASR и пошаговый ASR) против LLM, включая реализации таких атак, как…
 pedrobarcha/memory-injection
Исследование постоянных prompt-инъекций через функции памяти в Claude, Gemini и ChatGPT, включающее шаги воспроизведения, наборы данных и…
 xhyumiracle/sudp
Протокол делегирования использования секретов — использование секретов на уровне протокола для агентных систем
 lassnajmuldeen/balcony-jailbreaking
Уязвимость джейлбрейка на разных глубинах раннего выхода LLM. Опубликовано на NeurIPS 2026 в рамках воркшопа FLMSec
 owasp/xpsd
Триаж достижимости для сканирования уязвимостей. Передаёт результаты сканера LLM-агенту, который читает ваш исходный код и определяет, какие CVE…
 ericyoc/ai-security-literacy
Воспроизводимый конвейер Colab, который обосновывает шесть измерений компетенций AI Security Literacy на основе публичных бенчмарков и микроданных…
 tencent-hunyuan/diagsafe
Diagnostic LLM safety benchmark with 3,489 bilingual prompts, an 84-label taxonomy, and prompt-level rubric judging for explainable, fine-grained…
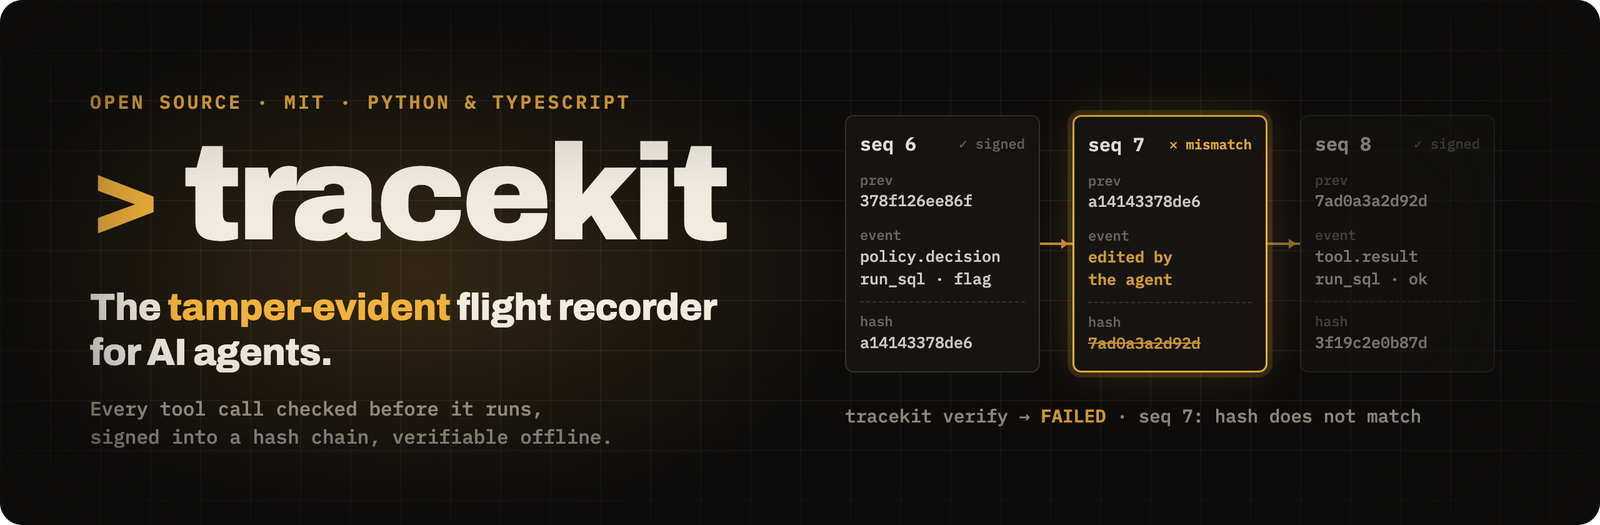 cygnux-labs/tracekit
Tamper-evident tracing, policy gates and cross-checks for AI agents: see what the agent did, and why.








