 thunlp/openattack
Um Pacote Open-Source para Ataque Adversarial Textual.



Documentação • Recursos e Usos • Exemplos de Uso • Modelos de Ataque • Design do Toolkit
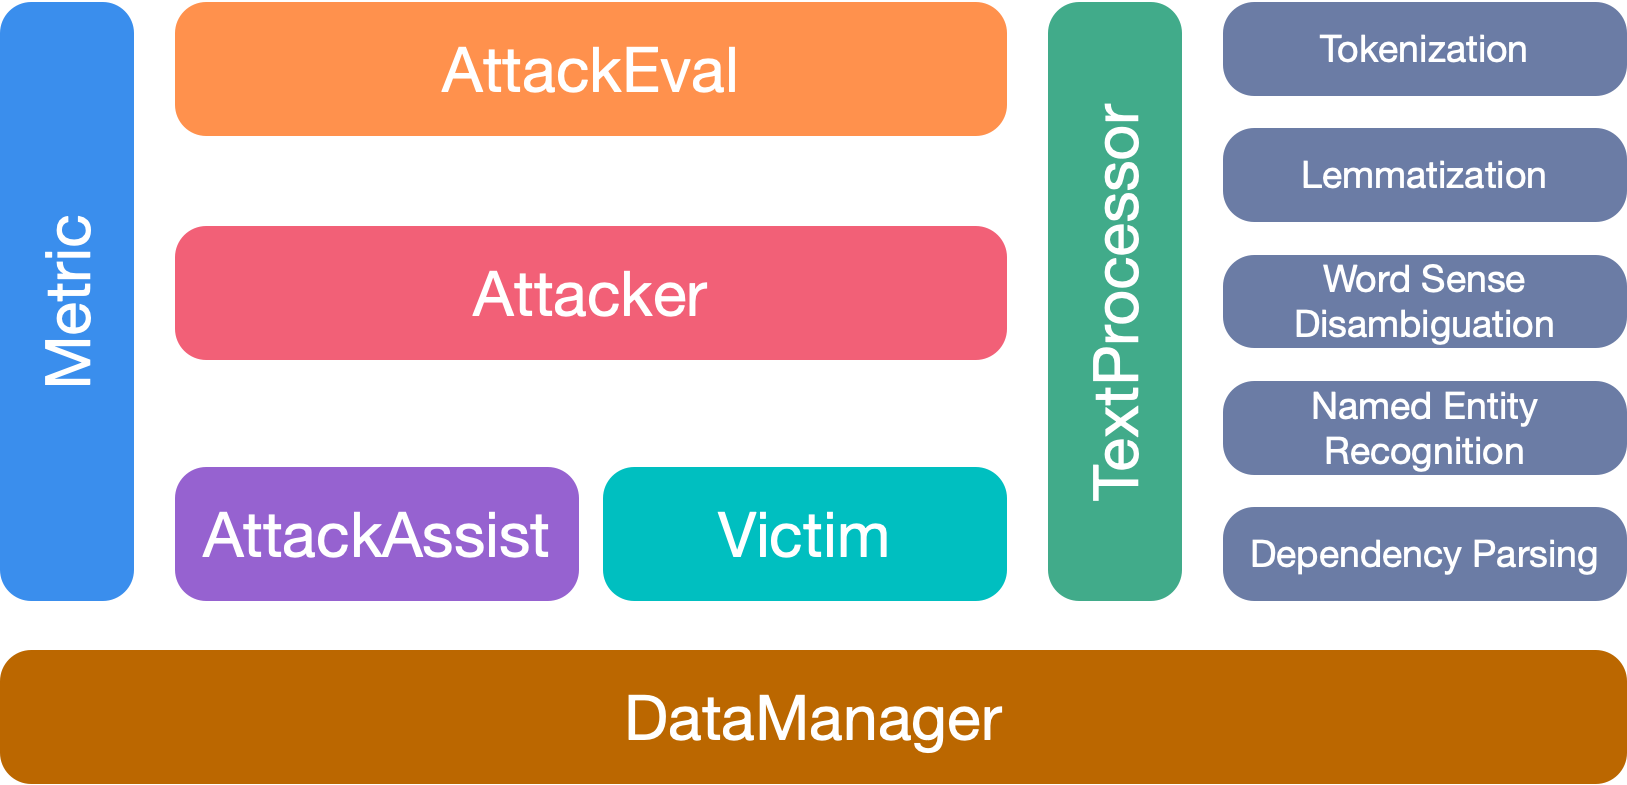
O OpenAttack é um toolkit de ataque adversarial textual de código aberto baseado em Python, que lida com todo o processo de ataque adversarial textual, incluindo pré-processamento de texto, acesso ao modelo vítima, geração de exemplos adversariais e avaliação.
⭐️ Suporte para todos os tipos de ataque. O OpenAttack suporta todos os tipos de ataque, incluindo perturbações em nível de sentença/palavra/caractere e modelos de ataque baseados em gradiente/pontuação/decisão/cego;
⭐️ Multilinguidade. O OpenAttack suporta inglês e chinês atualmente. Seu design extensível permite suporte rápido para mais idiomas;
⭐️ Processamento paralelo. O OpenAttack fornece suporte para execução multi-processo de modelos de ataque para melhorar a eficiência;
⭐️ Compatibilidade com 🤗 Hugging Face. O OpenAttack é totalmente integrado com as bibliotecas 🤗 Transformers e Datasets;
⭐️ Grande extensibilidade. Você pode facilmente atacar um modelo vítima personalizado em qualquer conjunto de dados personalizado ou desenvolver e avaliar um modelo de ataque personalizado.
✅ Fornecer várias linhas de base úteis para modelos de ataque;
✅ Avaliar modelos de ataque de forma abrangente usando suas métricas de avaliação completas;
✅ Auxiliar no rápido desenvolvimento de novos modelos de ataque com a ajuda de seus componentes comuns de ataque;
✅ Avaliar a robustez de um modelo de aprendizado de máquina contra vários ataques adversariais;
✅ Realizar treinamento adversarial para melhorar a robustez de um modelo de aprendizado de máquina, enriquecendo os dados de treinamento com exemplos adversariais gerados.
pip (recomendado)```bashpip install OpenAttack
#### 2. Clonando este repositório```bash
git clone https://github.com/thunlp/OpenAttack.git
cd OpenAttack
python setup.py install
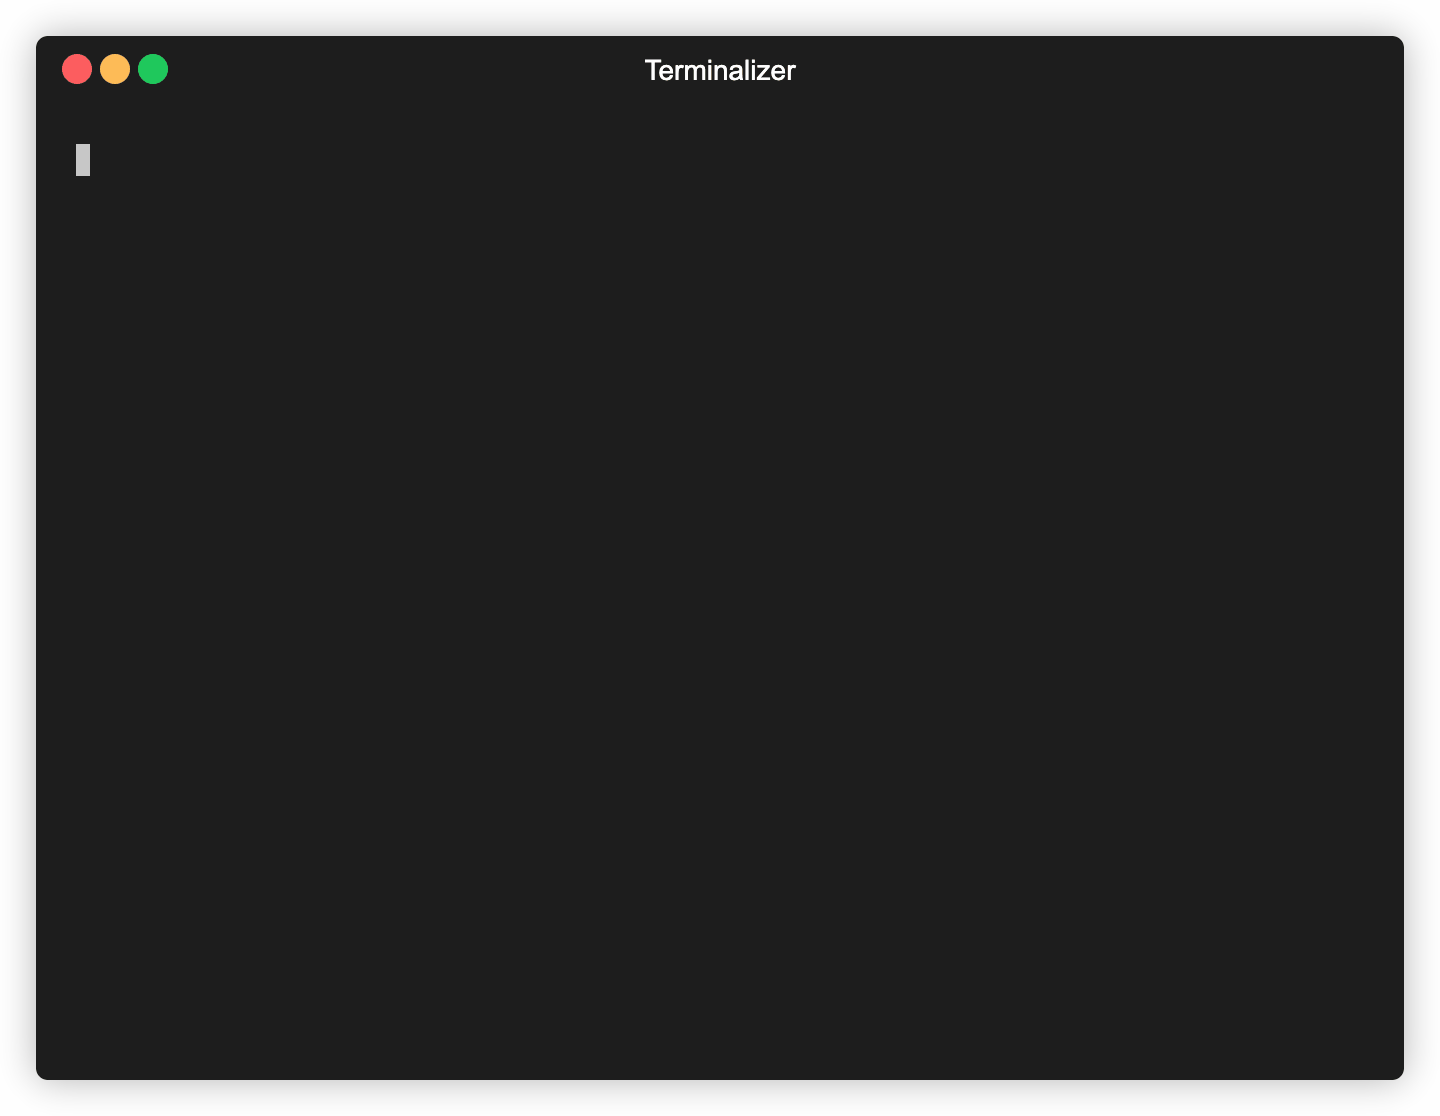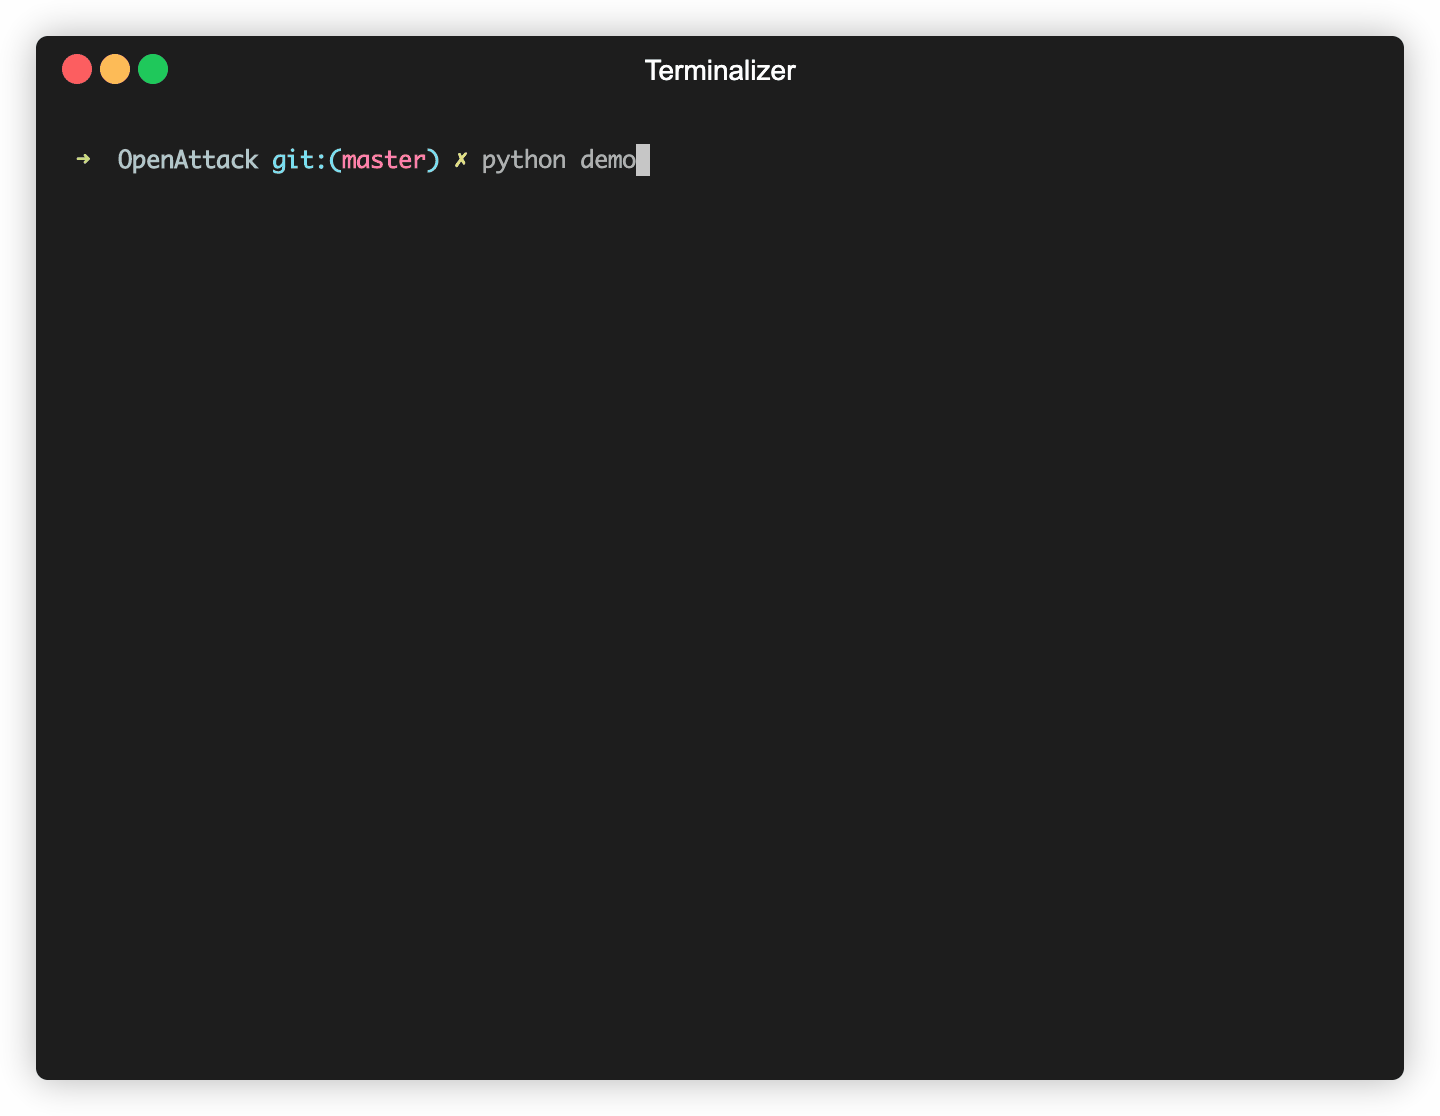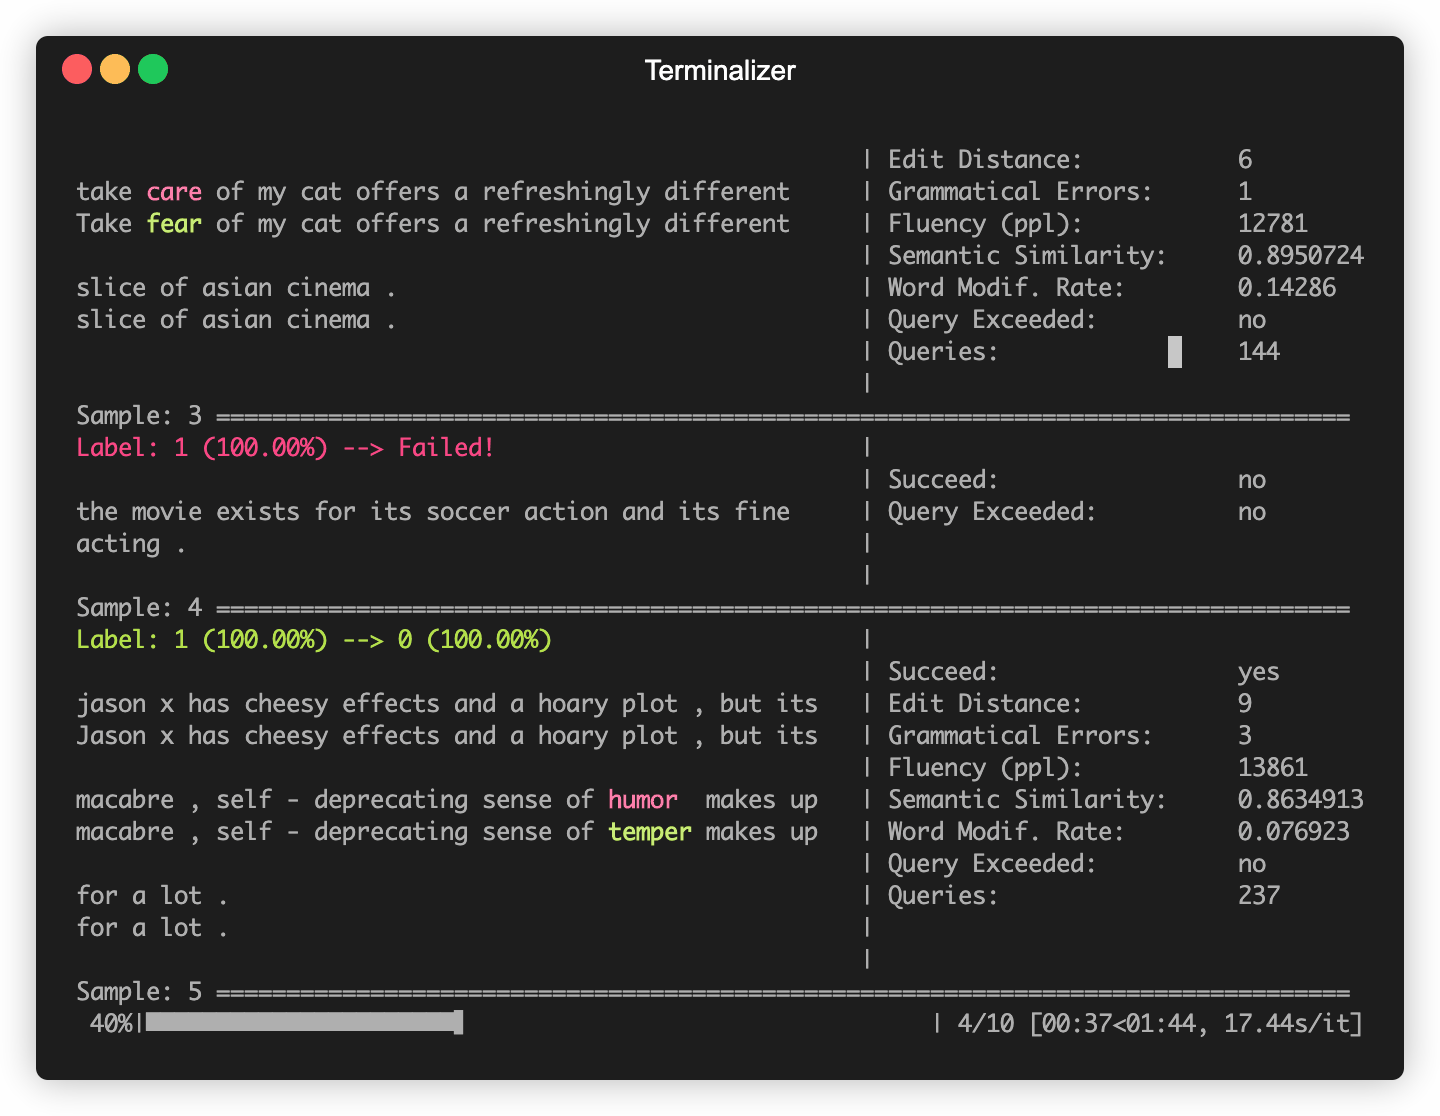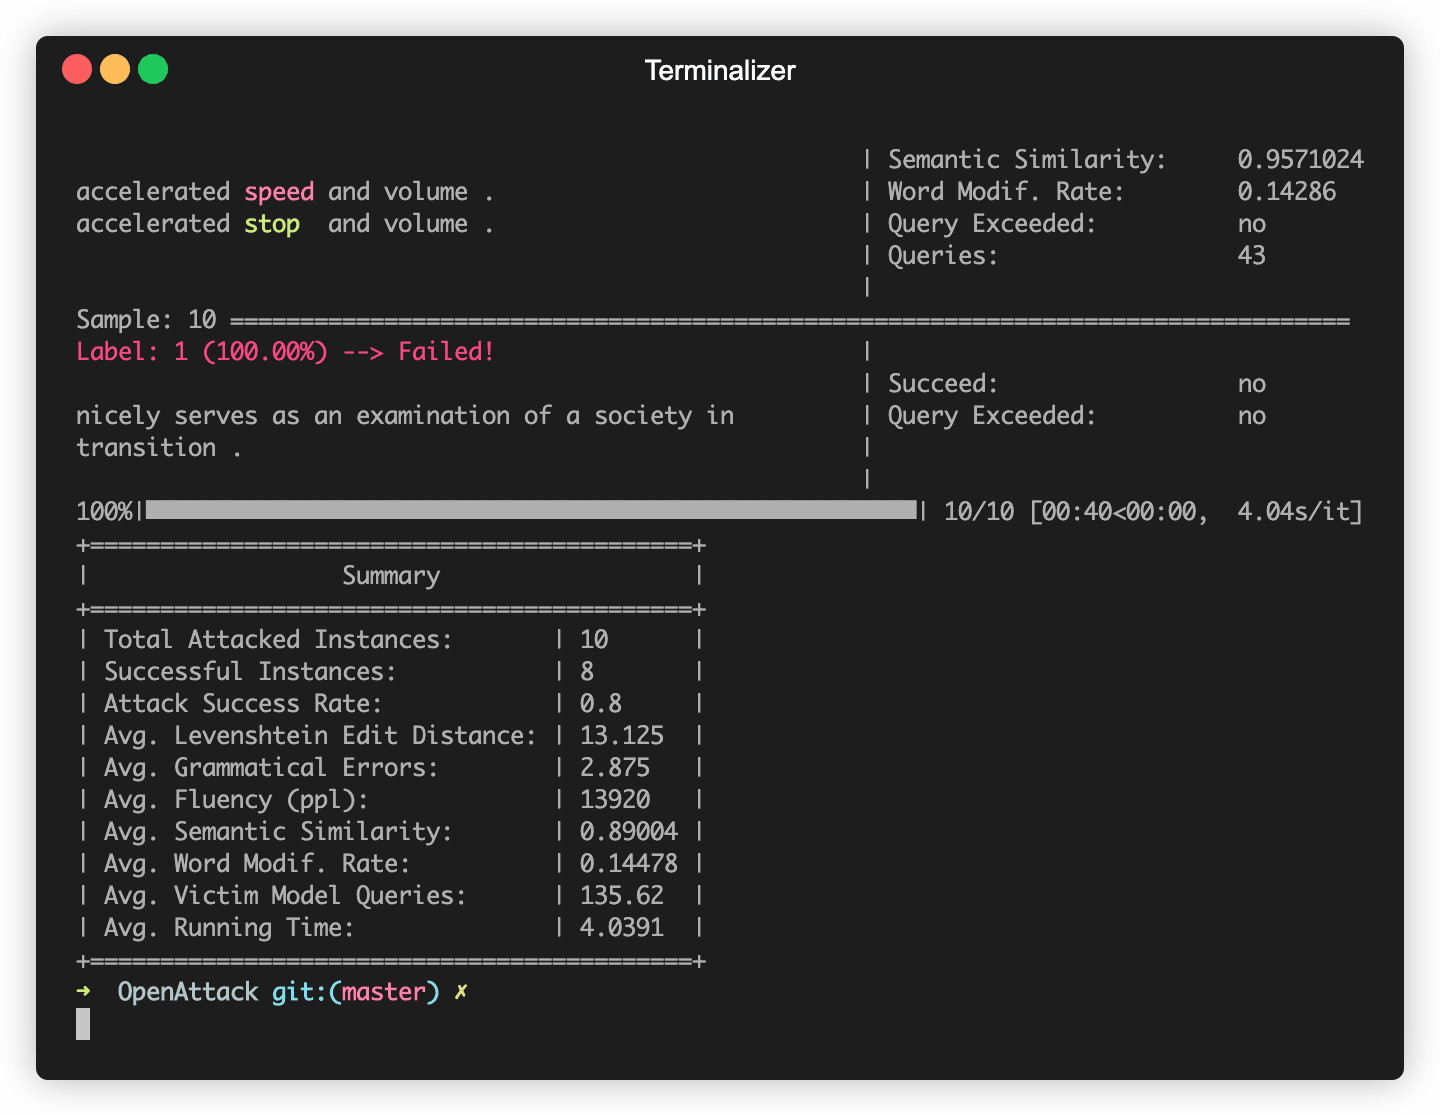
Após a instalação, você pode tentar executar demo.py para verificar se o OpenAttack funciona bem:```
python demo.py
## Exemplos de Uso
#### Atacar Modelos de Vítima Integrados
O OpenAttack incorpora alguns modelos de NLP comumente usados, como BERT ([Devlin et al. 2018](https://arxiv.org/abs/1810.04805)) e RoBERTa ([Liu et al. 2019](https://arxiv.org/abs/1907.11692)), que foram ajustados (fine-tuned) em alguns conjuntos de dados comuns (como [SST-2](https://nlp.stanford.edu/sentiment/treebank.html)). Você pode realizar ataques adversariais sem esforço contra esses modelos de vítima integrados.
O trecho de código a seguir mostra como usar o PWWS, um modelo de ataque baseado em algoritmo guloso ([Ren et al., 2019](https://www.aclweb.org/anthology/P19-1103.pdf)), para atacar o BERT no conjunto de dados SST-2 (o código executável completo está [aqui](https://github.com/thunlp/openattack/blob/master/examples/workflow.py)).```python
import OpenAttack as oa
import datasets # use the Hugging Face's datasets library
# change the SST dataset into 2-class
def dataset_mapping(x):
return {
"x": x["sentence"],
"y": 1 if x["label"] > 0.5 else 0,
}
# choose a trained victim classification model
victim = oa.DataManager.loadVictim("BERT.SST")
# choose 20 examples from SST-2 as the evaluation data
dataset = datasets.load_dataset("sst", split="train[:20]").map(function=dataset_mapping)
# choose PWWS as the attacker and initialize it with default parameters
attacker = oa.attackers.PWWSAttacker()
# prepare for attacking
attack_eval = OpenAttack.AttackEval(attacker, victim)
# launch attacks and print attack results
attack_eval.eval(dataset, visualize=True)
O trecho de código a seguir mostra como usar o PWWS para atacar um modelo de análise de sentimentos personalizado (um modelo estatístico construído no NLTK) no SST-2 (o código executável completo está aqui).
class MyClassifier(oa.Classifier): def init(self): # nltk.sentiment.vader.SentimentIntensityAnalyzer is a traditional sentiment classification model. nltk.download('vader_lexicon') self.model = SentimentIntensityAnalyzer()
def get_pred(self, input_):
    return self.get_prob(input_).argmax(axis=1)

# access to the classification probability scores with respect input sentences
def get_prob(self, input_):
    ret = []
    for sent in input_:
        # SentimentIntensityAnalyzer calculates scores of “neg” and “pos” for each instance
        res = self.model.polarity_scores(sent)

        # we use 𝑠𝑜𝑐𝑟𝑒_𝑝𝑜𝑠 / (𝑠𝑐𝑜𝑟𝑒_𝑛𝑒𝑔 + 𝑠𝑐𝑜𝑟𝑒_𝑝𝑜𝑠) to represent the probability of positive sentiment
        # Adding 10^−6 is a trick to avoid dividing by zero.
        prob = (res["pos"] + 1e-6) / (res["neg"] + res["pos"] + 2e-6)

        ret.append(np.array([1 - prob, prob]))

    # The get_prob method finally returns a np.ndarray of shape (len(input_), 2). See Classifier for detail.
    return np.array(ret)
def dataset_mapping(x): return { "x": x["sentence"], "y": 1 if x["label"] > 0.5 else 0, }
dataset = datasets.load_dataset("sst", split="train[:20]").map(function=dataset_mapping)
victim = MyClassifier()
attacker = oa.attackers.PWWSAttacker()
attack_eval = oa.AttackEval(attacker, victim)
attack_eval.eval(dataset, visualize=True)
</details>


<details>
<summary><strong>Dataset Personalizado</strong></summary>
