
 h4urek/cve-2026-50679
Análise e exploit para um estouro de buffer de heap no Windows Search (CVE-2026-50679) que alcança escalada de privilégios local por meio do sequestro da vtable de CVIQuery e do carregamento de DLL.

Em junho deste ano encontrei este heap overflow no Windows Search e percebi que era explorável. Passei alguns dias trabalhando nisso e consegui obter LPE. Quando o submeti, disseram-me que era uma duplicata :(. Foi corrigido na Patch Tuesday de julho e rastreado pela Microsoft como CVE-2026-50679. De qualquer forma, o processo de exploração foi muito divertido.
CPMExternalSearchResultIn (mensagem 245) insere um resultado de pesquisa externo em uma consulta existente. Seu corpo é composto por três DWORDs seguidos por três strings UTF-16, e cada string é descrita por um comprimento embutido no corpo:
WSP_MESSAGE_HEADER          16 bytes
queryNameLength              4 bytes
currentRowsetIndex           4 bytes
remainingRowsetCount         4 bytes
queryName                    queryNameLength UTF-16 chars, null-terminated
rowset metadata              rowsetMetadata, rowsetNameLength, sourceNameLength (12 bytes)
rowsetName                   rowsetNameLength UTF-16 chars, null-terminated
sourceName                   sourceNameLength UTF-16 chars, null-terminated
Todos os três comprimentos vêm do cliente. O transporte sabe quantos bytes chegaram, mas nada no formato da mensagem vincula os comprimentos declarados a esse número.
Antes de uma mensagem chegar a um handler, tquery!CProxyMessage::ValidateInputHeader verifica o cabeçalho. Ele valida o id da mensagem, os campos reservados, o checksum e o tamanho mínimo da mensagem para esse id. Mas não verifica se os comprimentos das strings declarados na mensagem excedem o tamanho do buffer da mensagem.
A mensagem é então despachada para tquery!CRequestServer::DoSetExternalRowset. O handler aloca um buffer de destino a partir do comprimento da mensagem externa e decodifica o buffer inline nele:
__int64 __fastcall CRequestServer::DoSetExternalRowset(CRequestServer *this, unsigned int msgSize)
{
    /* ... */
    BYTE *buffer = (BYTE *)operator new[](https://github.com/h4urek/cve-2026-50679/blob/main/msgSize);          /* outer message length */
    CPMExternalSearchResultIn *decoded =
        CPMExternalSearchResultIn::CPMExternalSearchResultIn(buffer, this + 0x270);
                                                             /* src = inline request buffer */
    /* ... */
}
O construtor é onde os comprimentos incorporados são utilizados:
CPMExternalSearchResultIn::CPMExternalSearchResultIn(BYTE *dst, BYTE *src)
{
    /* dst: buffer sized by the outer message length */
    /* src: per-connection inline request buffer */
    /* ... */
    DWORD queryNameLength = *(DWORD *)(src + 0x10);
    *(DWORD *)(dst + 0x10) = queryNameLength;
    *(DWORD *)(dst + 0x14) = *(DWORD *)(src + 0x14);
    *(DWORD *)(dst + 0x18) = *(DWORD *)(src + 0x18);

    memcpy(dst + 0x1c, src + 0x1c, 2 * (queryNameLength + 1));

    DWORD rowsetNameLength = *(DWORD *)(src + 2 * queryNameLength + 0x22);
    memcpy(dst + 2 * queryNameLength + 0x2a,
           src + 2 * queryNameLength + 0x2a,
           2 * (rowsetNameLength + 1));

    DWORD sourceNameLength = *(DWORD *)(src + 2 * queryNameLength + 0x26);
    memcpy(dst + 2 * queryNameLength + 2 * rowsetNameLength + 0x2c,
           src + 2 * queryNameLength + 2 * rowsetNameLength + 0x2c,
           2 * (sourceNameLength + 1));
    /* ... */
}
A primeira cópia é a óbvia. dst foi alocado a partir do comprimento da mensagem externa; o comprimento da cópia vem de queryNameLength; nada compara os dois. A cópia pode ser muito maior que a alocação e, como sua origem é o buffer inline, ela também ultrapassa os bytes que realmente chegaram. O restante da origem é o que o buffer de conexão continha de tráfego anterior.
As duas strings seguintes são piores. rowsetNameLength é lido de src + 2 * queryNameLength + 0x22, um deslocamento calculado a partir do queryNameLength controlado pelo atacante, e sourceNameLength é lido de um deslocamento próximo. Ambos estão fora da parte fixa da mensagem, então o decodificador lê o que estiver ali, trata como um comprimento e copia novamente. Uma única mensagem pequena, portanto, produz várias leituras e gravações fora dos limites, e nenhum dos comprimentos é jamais comparado com a alocação de destino.
Explorar esse bug se resumiu a algumas perguntas: qual objeto corromper e sequestrar o fluxo de controle, para onde redirecionar esse fluxo de controle e como contornar o heap LFH.
Depois de algum reversing, encontrei um objeto adequado para sequestrar: CVIQuery. CVIQuery é o objeto do lado do servidor por trás de uma consulta aberta. Quando o cliente envia uma solicitação de consulta, o servidor cria um objeto CVIQuery correspondente, e seu primeiro campo é a vtable do objeto, então corromper esse objeto resulta em um sequestro de vtable.
O heap foi o próximo obstáculo. CVIQuery é alocado a partir do heap LFH, então eu queria superar a randomização do LFH pulverizando um grande número desses objetos. A parte boa é que cada solicitação de consulta cria um CVIQuery, o que fornece uma primitiva conveniente de heap spray. No entanto, o wsearch limita o número máximo de solicitações abertas a 4096, então a contagem do spray é limitada, mas isso foi suficiente; só é preciso um pouco de sorte :).
Por fim, eu precisava decidir para onde redirecionar o fluxo de controle. Fiz algumas pesquisas, mas não encontrei uma técnica adequada, então decidi encontrar uma eu mesmo. Logo encontrei uma DLL carregada pelo serviço wsearch: dxcore.dll, e sua função DXCoreDriver::LoadDriverModule parecia muito interessante:
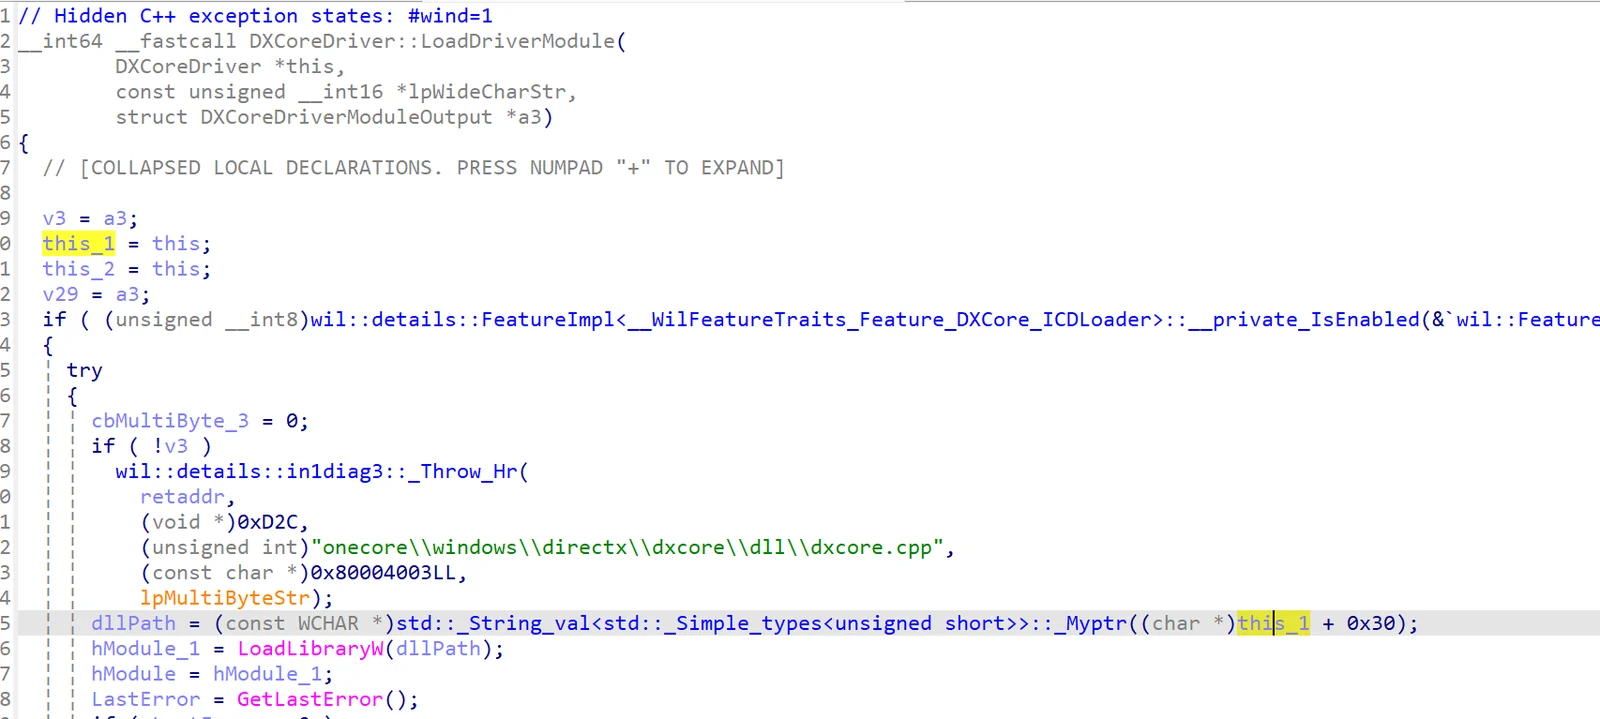
Essa função desreferencia this + 0x30 como uma string de caminho de DLL e chama LoadLibraryW para carregar essa DLL. Portanto, basta estourar o CVIQuery e sequestrar sua vtable, depois continuar o estouro para gravar o caminho da DLL em CVIQuery + 0x30, e o carregamento arbitrário de DLL se segue.
Um truque muito útil. A propósito, quando construí o exploit, essa função só existia em builds Insider, mas notei que ela apareceu recentemente também em builds de release.






