 andreyglauzer/vigilantonion
🐍 - Crawler em sites da rede Tor, buscando por palavras-chave.



Crawler em sites da rede tor, buscando por palavras-chave.
O VigilantOnion é complementado por equipes de Cyber Threat Intelligence para que possam monitorar e obter o melhor resultado das consultas realizadas na rede tor.
Em sua primeira versão, usando django para administração e criação de dashboards, havia uma grande dificuldade em seu uso. Nesta nova versão, as consultas e a metodologia utilizada para eliminar falsos positivos são melhores.
Para eliminar falsos positivos e melhorar o nível de assertividade, estou usando yararule e notas, definindo valores altos para as regras que considero mais relevantes, como mostra a figura abaixo:
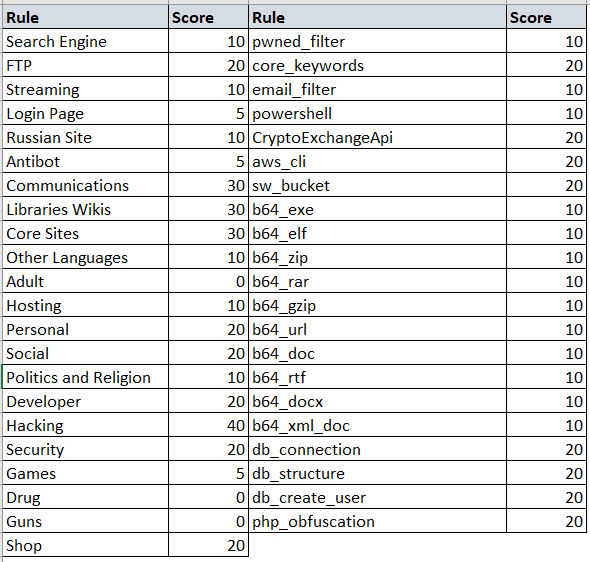
Esses valores são dinâmicos e podem mudar de acordo com a sua necessidade.
Novas yararules podem ser adicionadas tanto aos arquivos de categorias quanto aos de palavras-chave, assim você pode eliminar falsos positivos e ter resultados mais agradáveis.
Poucas coisas precisam ser alteradas no arquivo de configurações, porém elas são de grande importância para o uso do script.
Os campos abaixo são para configurar o proxy da rede tor; se você estiver executando o script no Windows, a porta geralmente muda para 9051
server_proxy:  localhost
port_proxy:  9050
type_proxy:  socks5h
O campo timeout do servidor serve para você determinar o tempo de espera pelas requisições; quanto maior o tempo, mais demorado o script pode ficar.
timeout: 30
Os campos de score do servidor servem para você determinar o valor mínimo de score para que a URL seja rastreada e enviada ao syslog.
score_categorie:  20
score_keywords:  40
Algumas urls estarão offline e é difícil saber se voltarão ou não, então criei um contador no qual você pode determinar o número máximo de tentativas; uma vez atingido, o script não tentará mais acessar essa url.
count_categories: 5
Sempre que um rastreamento é feito na url, ele é salvo com a data da última varredura, e você pode determinar um limite de dias entre uma varredura e outra na mesma url.
daystime: 10
E, por fim, não uso mais django; agora, para visualizar seus resultados, você precisa de um syslog como Splunk ou ELK, e basta defini-los aqui
sendlog:  True
logport:  5151
logip:  "localhost"
Seu uso é mais simples: você só precisa ter o tor instalado e as bibliotecas python; para isso, execute o comando abaixo:
pip install -r requirements.txt
Após o cliente tor e as bibliotecas instaladas, use o comando --help para obter detalhes de seu uso.
➜  python3 observer.py -h
usage: observer.py [-h] [--config CONFIG] [--crawler] [--url URL] [--search]
                   [--engines ENGINES] [--find FIND] [--pastebin PASTEBIN]

VigilantOnion is a script to collect as many sites from the onion network as
possible and add them to a database. With all possible sites collected, a
crawler will be created so that we can monitor the search for keywords defined
by you.

optional arguments:
  -h, --help            show this help message and exit
  --config CONFIG, -c CONFIG
                        Configuration file in yaml format
  --crawler             Starts the TOR network URL crawler process.
  --url URL, -u URL     Specifies the URL to crawl.
  --search              Start the URL search process on the surface. Select a
                        framework where you want to search for urls.
  --engines ENGINES, -e ENGINES
                        Validates the available engines for searching URLs.
  --find FIND, -f FIND  Search for arguments on .onion network research sites
  --pastebin PASTEBIN   Search for .onion urls in pastebin paste.

You can also develop new framework so that the database has more urls onions.
Para o script funcionar, você precisa de novas urls, e para isso criei um método que busca urls na superfície, como no exemplo abaixo:
python3.6 observer.py --config config/config.yml --search -e "gist,reddit,cybersecuritynews,discoverdarkwebservice"
Você também pode obter URLs diretamente de arquivos pastebin, como no exemplo abaixo:
python3.6 observer.py --config config/config.yml --search --pastebin "s7TPZCKz,kSaYqtVX,0GYEEApe,3qkqyqiM,RfgBLg5Q,gtksBij4,FpPzQKHg,wB0uh00r,jDGJhQCC,q6DZ9U,ac2TnUjY,pv4xRWXQ,PgLUE7pF,9XW5Pc7R,hqyGMi7e,UZRM2z8y,7tQvV5CU,9JhVq3H3,Cb5HTydt,kMW5wp3N,v5Yq66sH,2q3SsR3a,gnd8jx97,QwSJYhYF,iNydrDfe"
Depois de coletar algumas URLs, você pode iniciar o processo de crawler. Lembrando que o primeiro levará mais tempo porque é nele que será feita a classificação e categorização do conteúdo do site.
python3.6 observer.py --config config/config.yml --crawler
Se você quiser rastrear uma única URL, use:
python3.6 observer.py --config config/config.yml --crawler --url "76qugh5bey5gum7l.onion"
A saída do resultado é json, e no mesmo formato é enviada para o syslog escolhido.
{
  "lastscan": "2020-06-29",
  "id": 10760,
  "type": "URI",
  "url": "lolitmhfkpif7sky.onion",
  "title": "Lolita Club",
  "baseurl": "vyqi2nm36otufrgg.onion",
  "status": "Online",
  "count_status": 0,
  "source": "Script",
  "categorie": [
    {
      "full_categorie": [
        "no_match"
      ],
      "score_categorie": 0
    }
  ],
  "keywords": [
    {
      "full_keywords": [
        "no_match"
      ],
      "score_keywords": 0
    }
  ],
  "discovery_date": "2020-06-29 14:24"
}
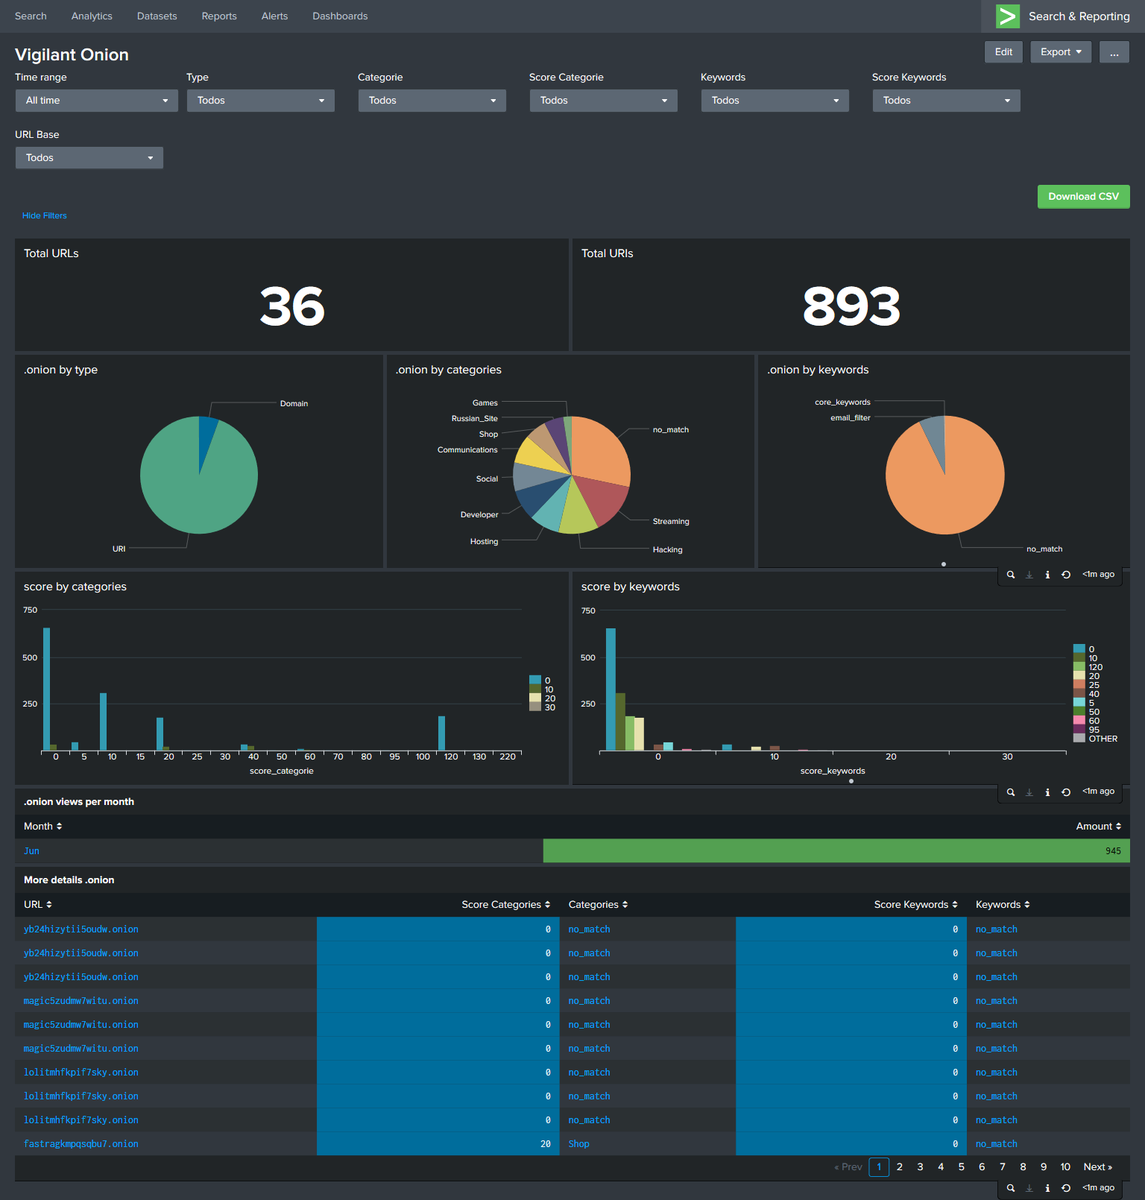
Eu uso Splunk, e você pode deixar seu dashboard parecido com o meu:
Sinta-se à vontade para fazer um fork ou abrir uma issue para colaborar com o projeto.
