
 google/oss-fuzz-gen
LLM 기반 퍼징, OSS-Fuzz를 통해.

이 프레임워크는 다양한 대규모 언어 모델(LLM)을 사용하여 실제 C/C++/Java/Python 프로젝트용 퍼즈 타겟을 생성하고,
OSS-Fuzz 플랫폼을 통해 벤치마킹합니다.
자세한 내용은 AI-Powered Fuzzing: Breaking the Bug Hunting Barrier에서 확인할 수 있습니다:

현재 지원되는 모델은 다음과 같습니다:
생성된 퍼즈 타겟은 프로덕션 환경의 최신 데이터를 기준으로 네 가지 지표로 평가됩니다:
OSS-Fuzz에 있는 기존 사람이 작성한 퍼즈 타겟 대비 런타임 라인 커버리지 차이다음은 2024년 1월 31일의 샘플 실험 결과입니다. 이 실험에는 297개 오픈소스 프로젝트의 1300개 이상의 벤치마크가 포함되었습니다.
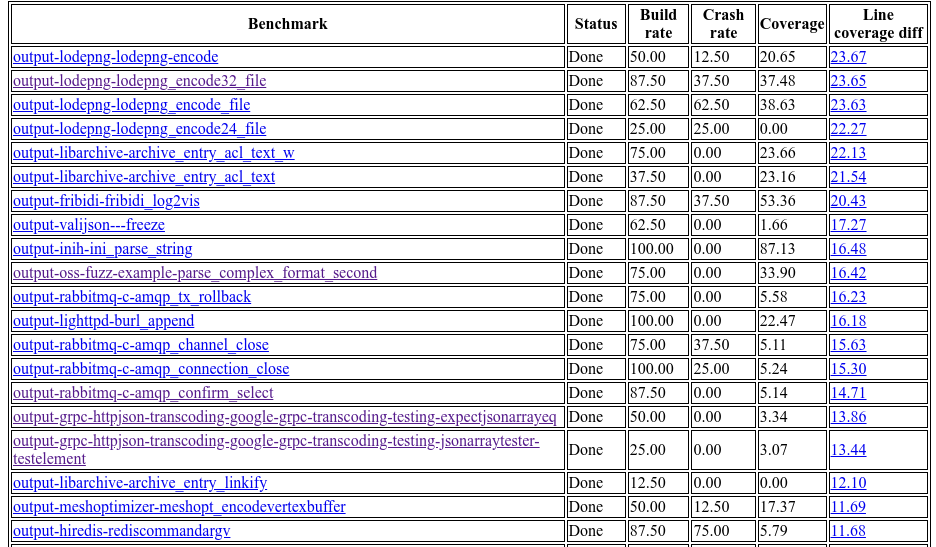
전반적으로 이 프레임워크는 LLM을 성공적으로 활용하여 160개의 C/C++ 프로젝트에 대해 유효한 퍼즈 타겟(0이 아닌 커버리지 증가를 생성하는)을 생성합니다. 최대 라인 커버리지 증가율은 기존 사람이 작성한 타겟 대비 29%입니다.
이 보고서들은 공개되지 않은 취약점을 포함할 수 있으므로 공개되지 않습니다.
이 프레임워크를 실행하고 결과를 기반으로 보고서를 생성하는 방법에 대한 지침은 자세한 사용 가이드를 확인하세요.
전체 실험을 실행하지 않고도 통합 에이전트 실행 프레임워크를 사용하여 개별 에이전트를 실행하거나 평가할 수 있습니다. 개별 에이전트 또는 에이전트 시퀀스를 실행하는 방법에 대한 자세한 지침은 프레임워크 문서를 참조하세요.
연구 또는 오픈소스 커뮤니티 협업에 관심이 있으신가요? 주저하지 말고 이슈를 생성하거나 [email protected]으로 이메일을 보내주세요.







