

 amd2g2zz/kunglao-agent
리버스 엔지니어링 전문 에이전트: 자체 분석 경로를 계획하고, 모든 사실을 원시 증거로부터 도출하며, 기계적 검증 게이트 아래에서 수렴합니다 — 펌웨어, 프로토콜, 웹/JS, 리스크 컨트롤, 바이너리.
몇 시간 동안 무인으로 실행되고, 모든 결론을 독립적으로 검증하며, 모든 답이 기계적 오라클 판정을 통과할 때에만 수렴하는 자율 리버스 엔지니어링 에이전트.


🧠 스스로 경로를 계획 · 🔬 모든 주장은 기계로 검증 · ⚖️ 모든 것에 블라인드 검증 · 📈 루프가 스스로를 측정
🚀 빠른 시작 · ✨ 핵심 기술 · 🧠 kunglao × Claude Code · 🎛️ RL 작동 방식 · 🖥️ 쇼케이스 · 📖 사례 연구 · 🧪 평가 · 🏗️ 아키텍처 · 🗓️ 로드맵
English · 简体中文
[!WARNING] v0.1.6은 마지막 Claude Code 네이티브 릴리스 라인입니다. 다음 마일스톤(v0.2)은 런타임을 전면적으로 PI Agent 기반으로 이전합니다 — 동일한 루프, 동일한 원장, 새로운 엔진 기반. 로드맵을 참조하세요.
kunglao-agent에 대상을 지정하고 질문을 던지면, 경로를 계획하고, 전문 워커를 파견하고, 모든 결론을 독립적으로 검증하며, 각 답이 모델의 말이 아닌 기계적 검사로 확정될 때에만 멈춥니다.
대상 스펙트럼은 전 범위입니다 — Windows/Linux 네이티브 바이너리, Android APK(네이티브 .so 레이어 포함), 웹/JS, 프로토콜 복구, 펌웨어 — 설계상 정적 우선이며, 환경에 이미 존재하는 실행 채널(VMware, ssh, docker, adb, 또는 정적 전용 작업의 경우 전혀 없음)을 구동합니다.
Claude Code 내에서 플러그인으로 실행됩니다: Claude Code는 대화 표면이고, 제품은 루프와 그것이 만들어내는 팩트 베이스입니다.
[!NOTE] 루프가 보고하는 모든 숫자 — 승률, 사후확률, 예산 — 는 추가 전용 원장의 한 행으로 추적됩니다. 자기 선언은 없습니다.
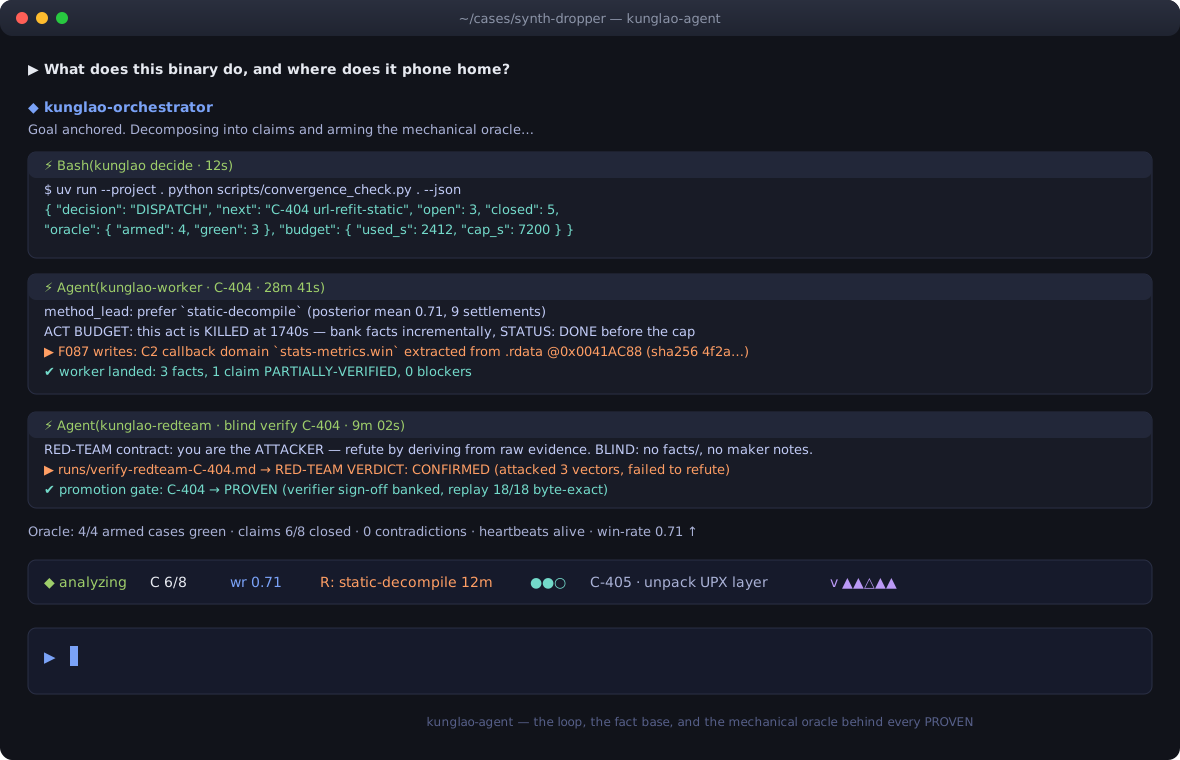
작동 중인 오케스트레이터 — 수렴 결정, 실시간 팩트가 도착하는 예산 배정 워커 파견, 그리고 주장을 PROVEN으로 승격시키는 블라인드 레드팀 판정; 상태 표시줄 HUD는 전체 작업을 한눈에 읽을 수 있게 유지합니다:
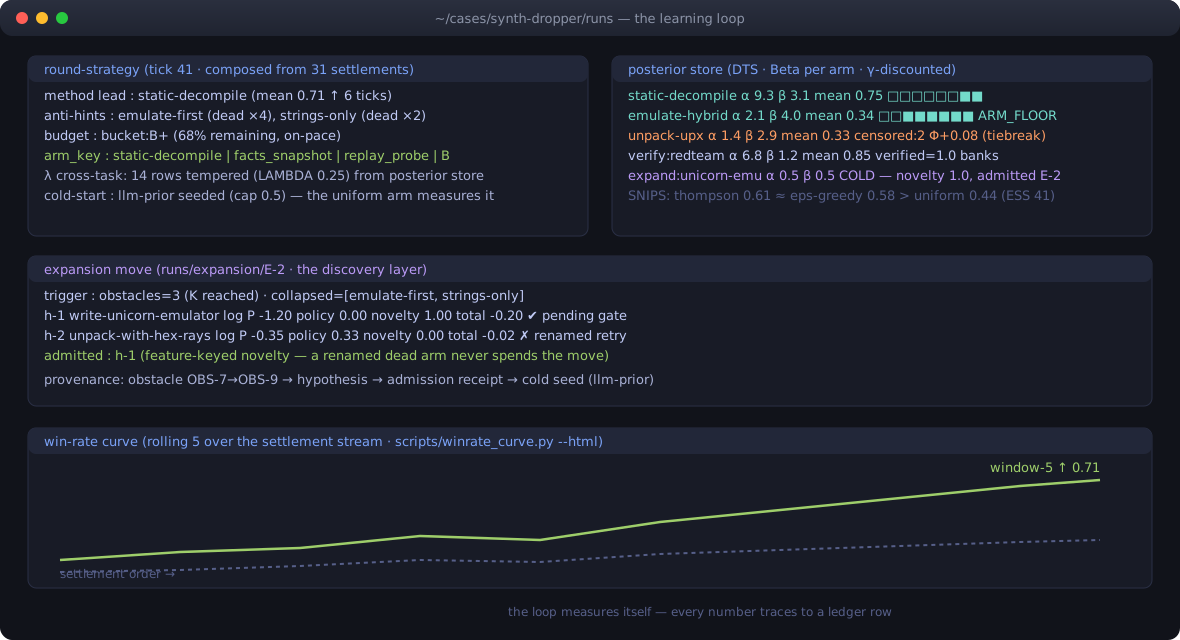
스스로를 측정하는 루프 — 정산으로 구성된 라운드 전략, 중도 절단 결과 타이브레이킹을 갖춘 할인된 Thompson 사후확률 저장소, 진정으로 새로운 arm을 받아들이는(그리고 이름만 바꾼 재시도를 거부하는) 발견 레이어, 그리고 승률 곡선:
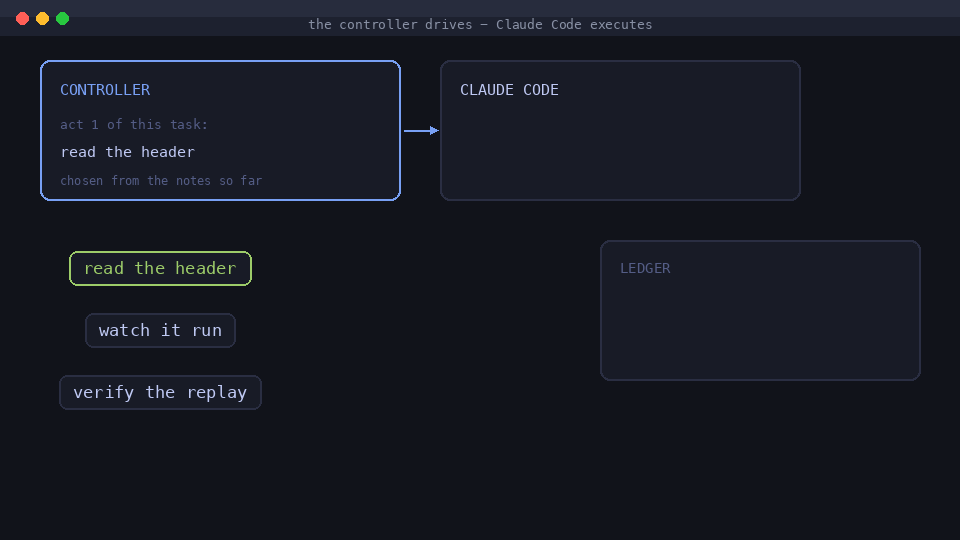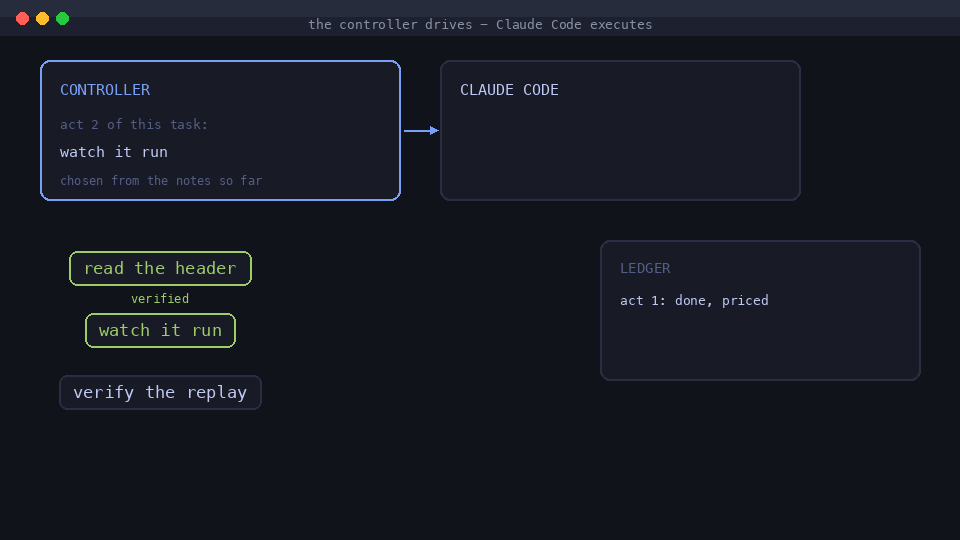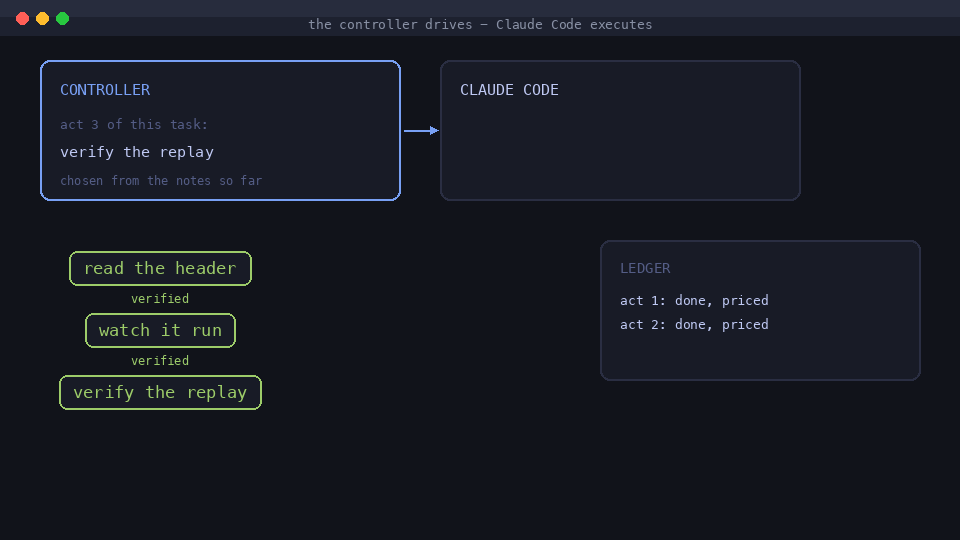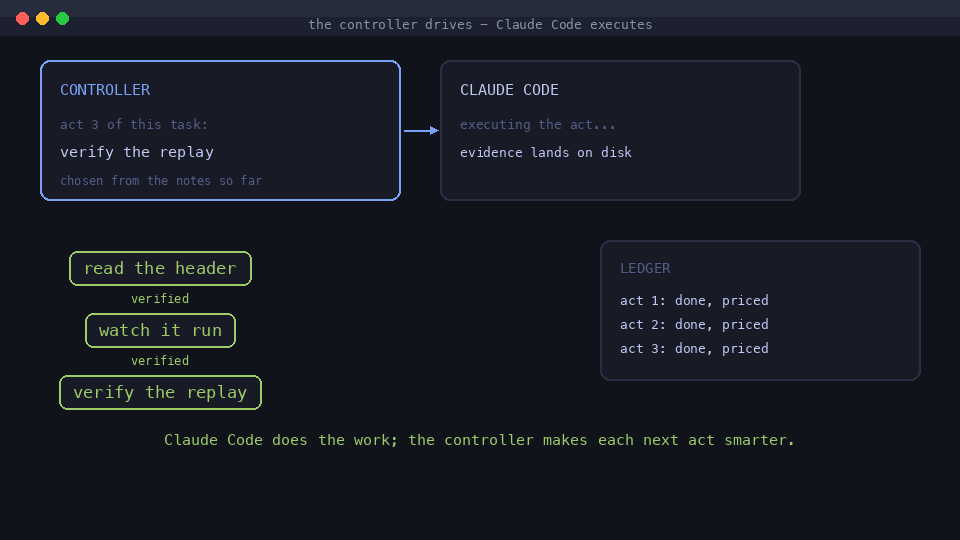
kunglao-agent는 Claude Code를 둘러싼 act 수준 RL 컨트롤러입니다: Claude Code는 각 act 내부에서 추론하고, kunglao는 다음 act를 결정하고, 검증하고, 가격을 매기고, 그것으로부터 학습합니다. 심층 설계: docs/design/.
STAMP에서 상한이 정해지며, 결코 PROVEN이 되지 않습니다. 팩트는 아티팩트(sha256)를 인용하고 reproduce: 명령을 포함합니다.Claude Code는 엔진이고, kunglao는 기어박스, 대시보드, 비행 컴퓨터입니다 — 다음 act, 검증, 예산, 그리고 경험이 가는 곳.
| 순수 Claude Code | + kunglao | |
|---|---|---|
| 다음 단계 | 세션 내 즉흥적 | 학습된 act 수준 정책, 사후확률이 작업 간에 지속됨 |
| 검증 | 자기 보고 | 기계적 오라클 + 블라인드 레드팀 |
| 지속 시간 | 한 세션, 사람이 지켜봄 | 몇 시간 무인, 디스크에서 재개 |
| 경험 | 세션 종료 시 증발 | 원장 → 사후확률 → 더 예리한 첫 베팅 |
정직한 경계: 단순한 단일 세션 작업에서는 순수 Claude Code가 이깁니다 — 평가 표가 그렇게 말합니다. kunglao는 긴 지평, 검증 규율, 그리고 작업 간 복리 효과에서 값을 합니다.
새로운 종류의 첫 작업은 전체 비용을 지불합니다: 루프는 한 방법을 시도하고, 실패하는 것을 보고, 다른 것을 시도합니다. 하지만 모든 시도는 기록됩니다 — 그리고 같은 종류의 다음 작업은 0이 아니라 그 기록에서 시작합니다.
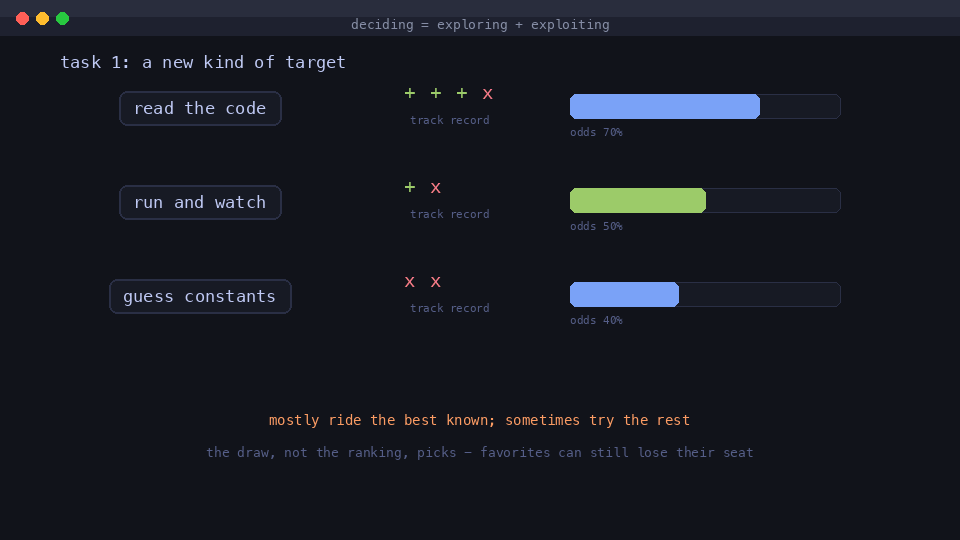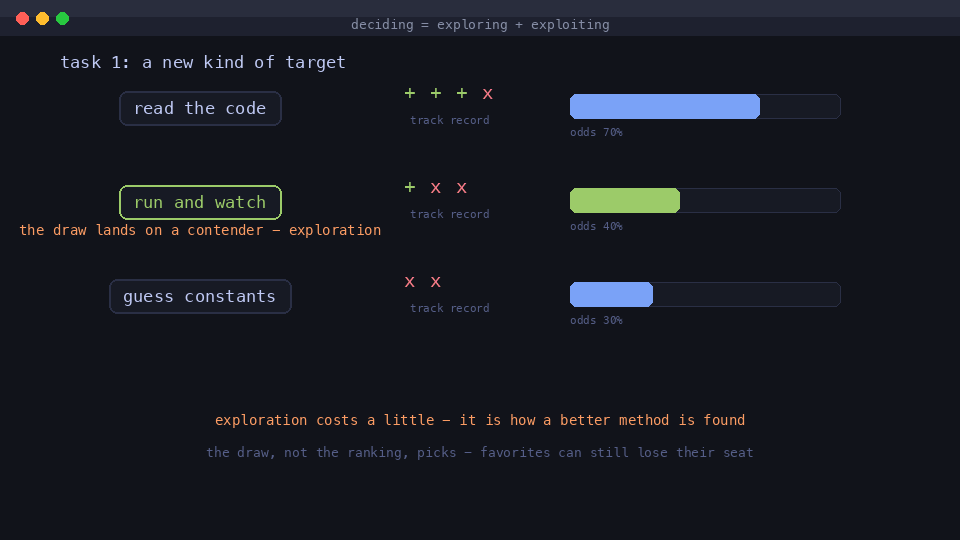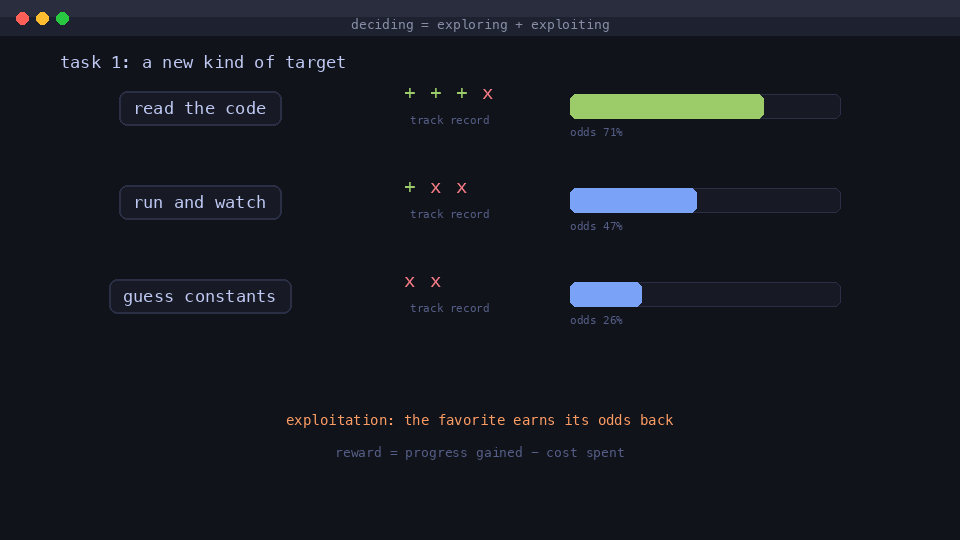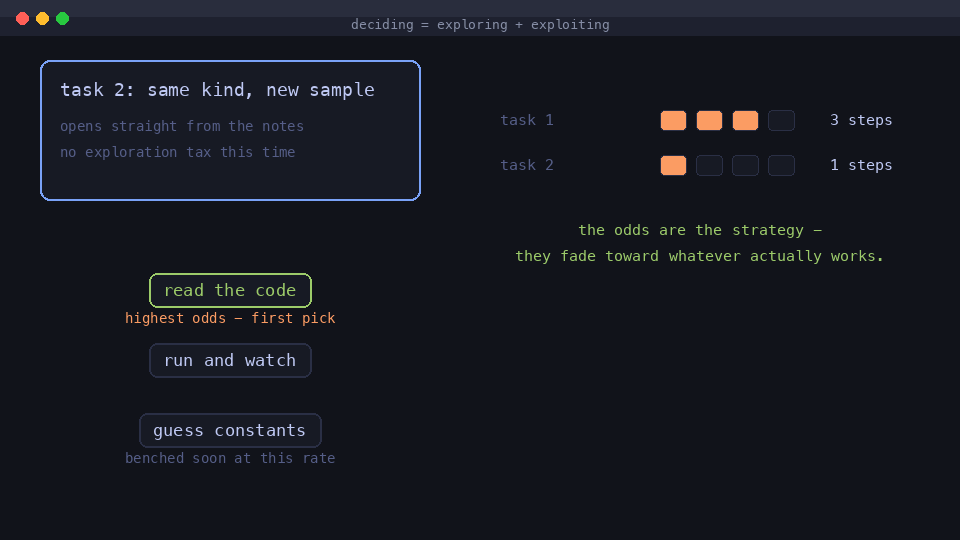
이것이 여기서 온라인 강화 학습의 전체 아이디어입니다: 루프는 act 사이에, 일하는 도중에 스스로를 갱신합니다 — 훈련 데이터셋도, 모델 재훈련도, 오프라인 단계도 없습니다. 각 작업의 경험은 다음 결정이 내려지기 전에 적립됩니다.
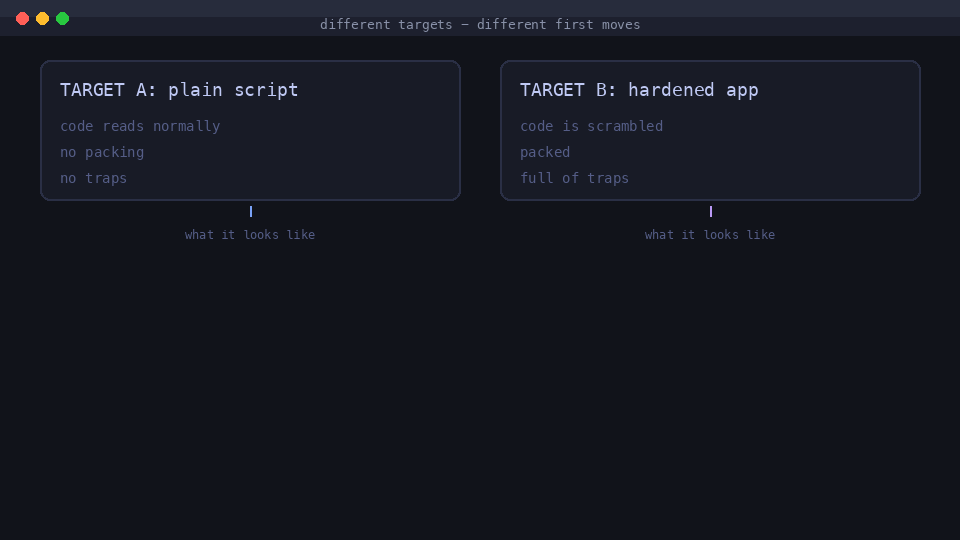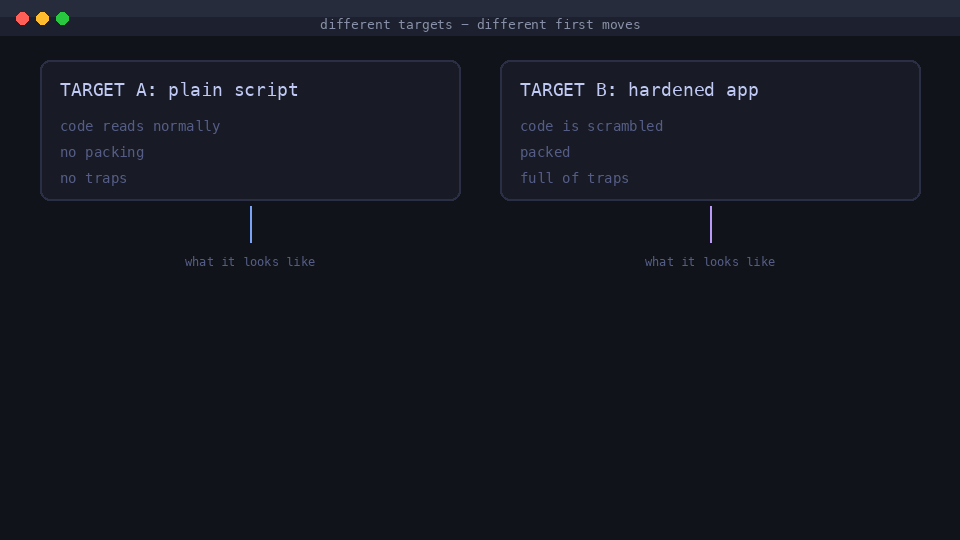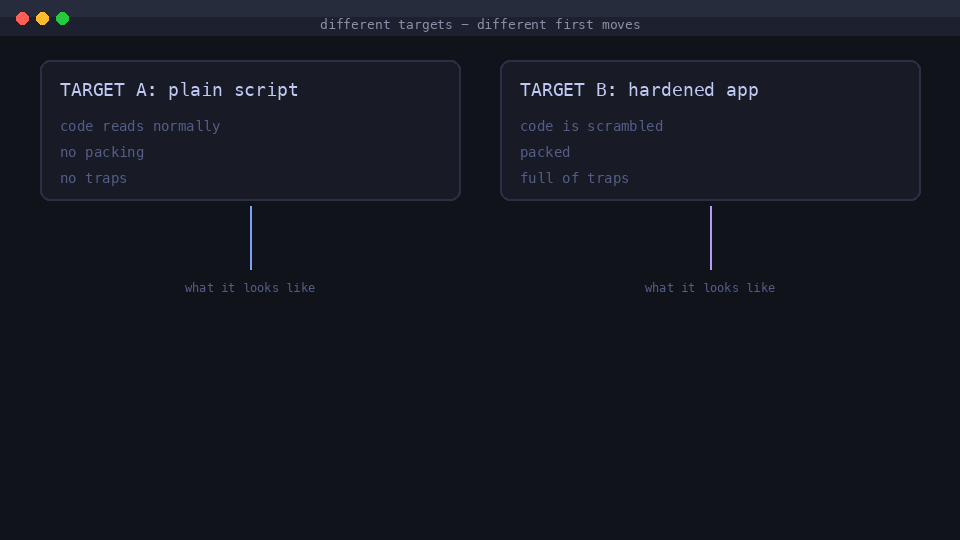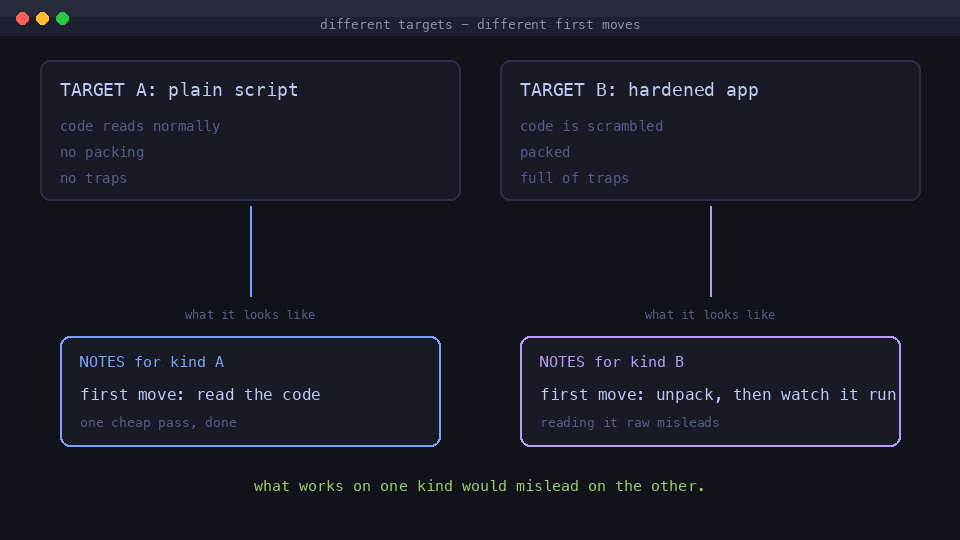
1. 대상 종류별 올바른 첫 수. 평범한 스크립트와 강화된 앱은 같은 방식으로 시작해서는 안 됩니다. 루프는 대상 종류별로 별도의 기록을 유지합니다 — 대상이 어떻게 생겼는지가 어떤 플레이북이 적용되는지를 결정합니다.
2. 어떤 방법이 죽었는지. 계속 실패하는 방법은 벤치로 갑니다 — 예산을 잡아먹는 것을 멈춥니다(하지만 결코 삭제되지 않습니다; 대상이 바뀌면 돌아올 수 있습니다). 그리고 아무것도 통하지 않을 때, 루프는 진입 방법을 발명하려 시도합니다: 발견 act가 진정으로 새로운 접근을 제안하고, 실패한 시도들과 대조해 검사합니다 — 같은 아이디어의 이름만 바꾼 것은 거부됩니다.
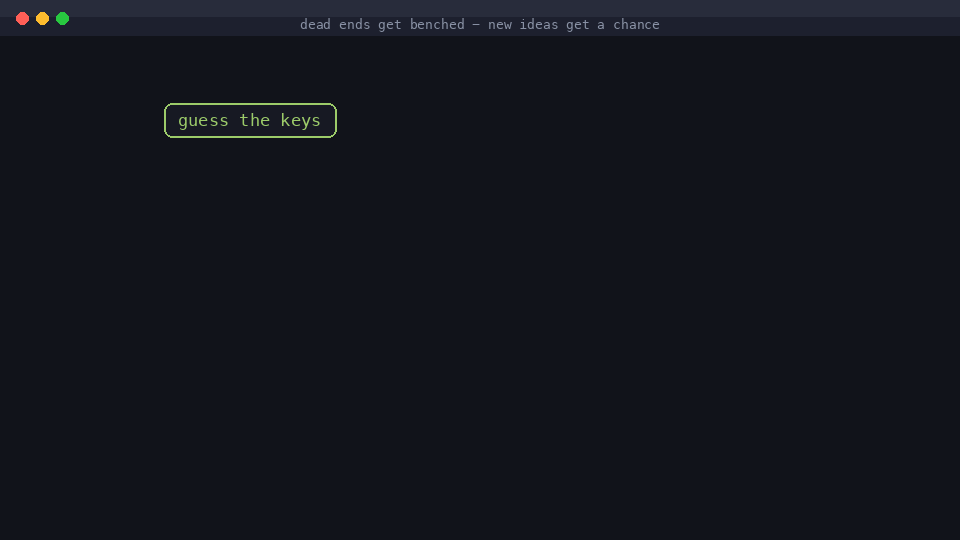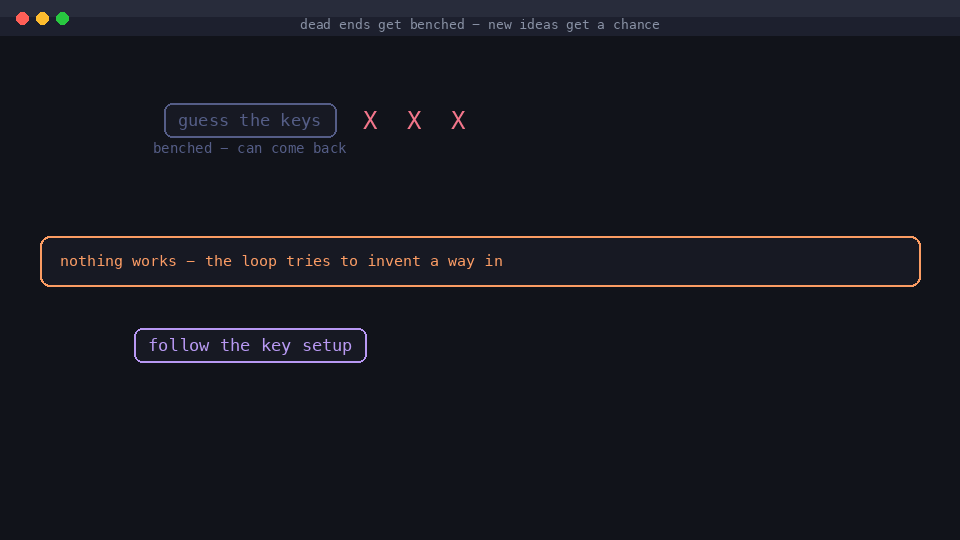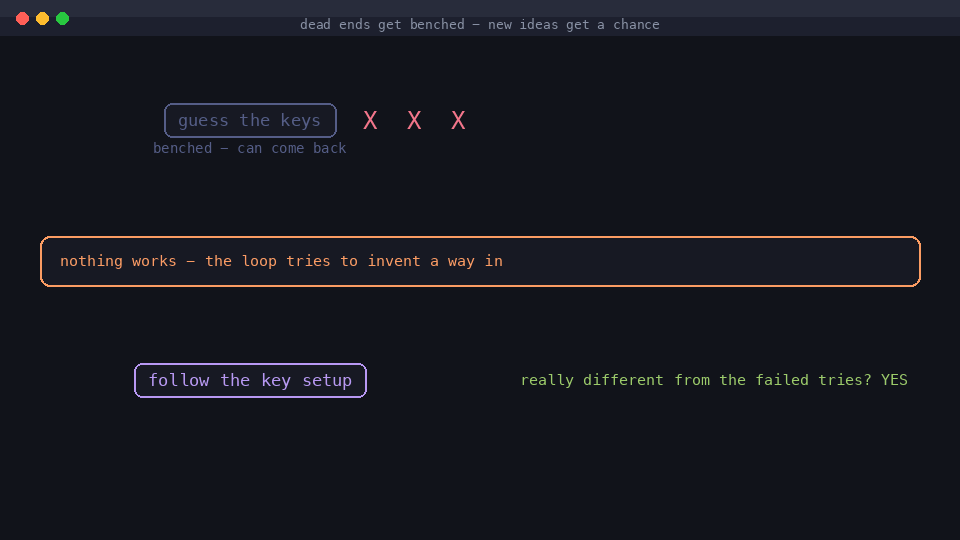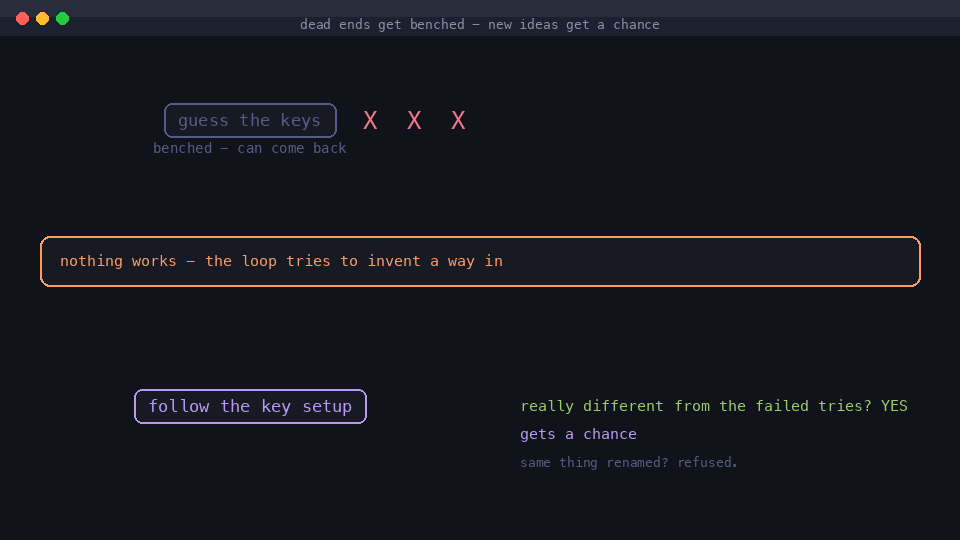
3. 어디를 다시 확인할지. 검증자가 계속 반박되는 상태는 그곳에서 검증을 더 촘촘하게 예약하는 법을 학습합니다 — 그리고 연속이 정직해지면 완화합니다. 4. 어떤 도구를 라우팅할지. 도구와 제공자 선택도 학습됩니다: 실패하는 도구는 한동안 강등되고 다시 작동하는 순간 복권됩니다 - 라우팅은 레지스트리 순서가 아니라 기록된 결과를 따릅니다.
flowchart LR
    A["target state<br>(what it looks like)"] --> B["pick a method<br>(sample from the notes)"]
    B --> C["act<br>(a worker runs it)"]
    C --> D["checker verdict<br>(proof or no proof)"]
    D --> E["one ledger row<br>(what happened, what it cost)"]
    E --> F["update the notes<br>for this kind of target"]
    F --> B
노트는 상태별 방법별 단순한 성공/실패 집계이며, 아직 배제되지 않은 것은 무엇이든 시도하는 쪽으로 편향되어 있다 — 탐색은 증거가 쌓이는 속도만큼 정확히 줄어든다. 보상은 progress x weight - cost이므로, 효과가 거의 없는 값비싼 습관은 단순한 목표에서 손해를 보고, 모든 숫자는 추가 전용 원장 행으로 추적된다.
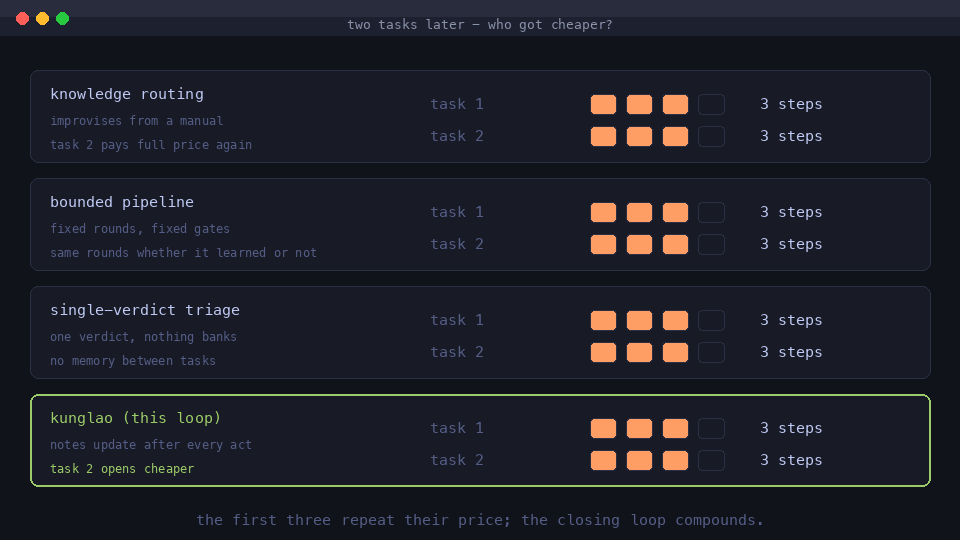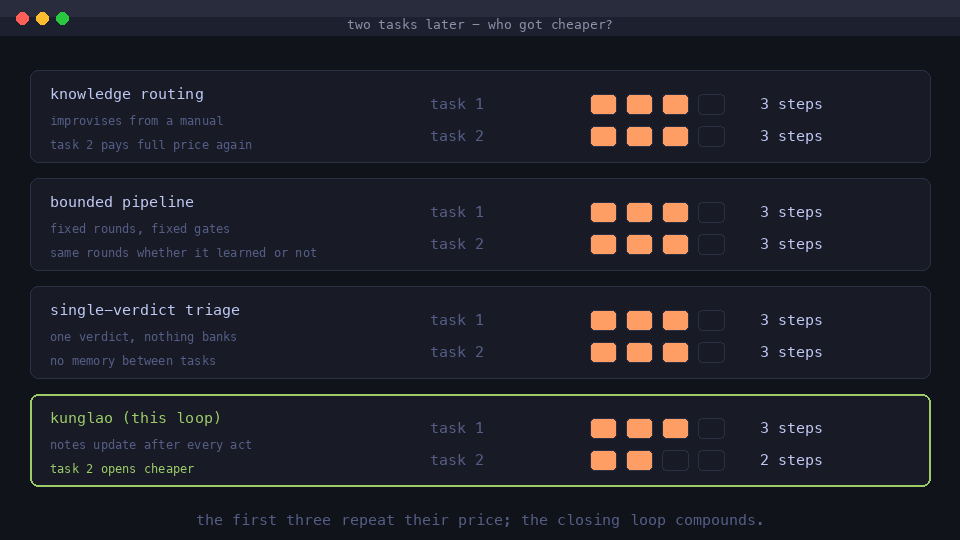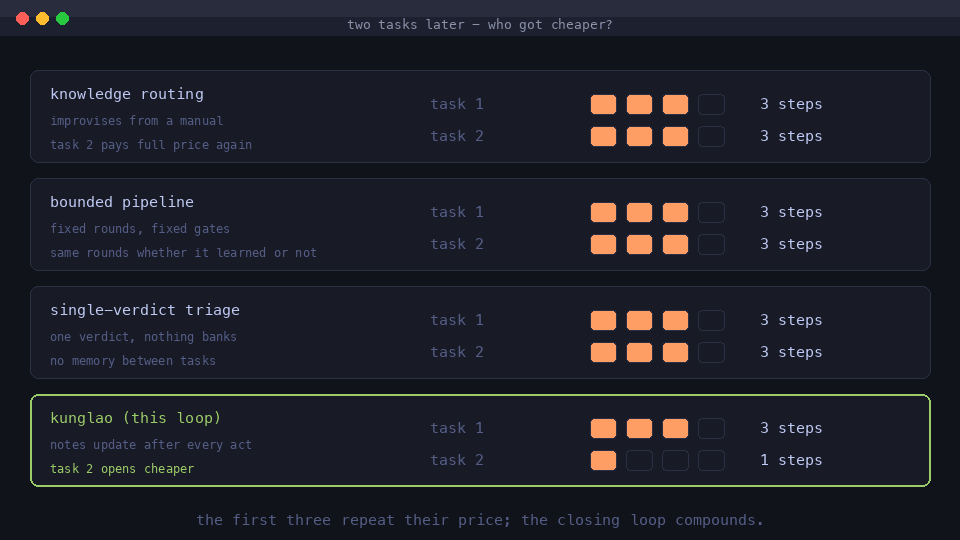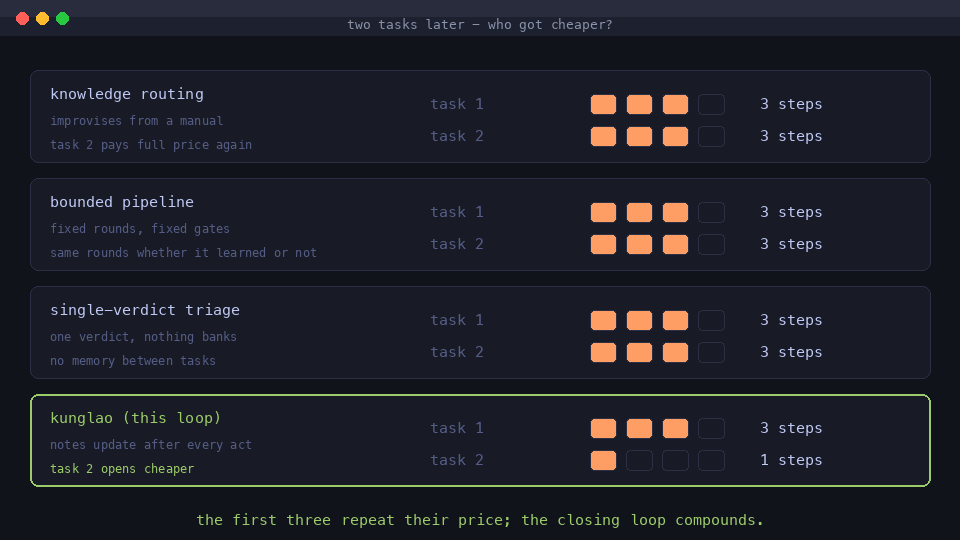
익숙한 작업에서 비용이 떨어진다. 같은 종류의 두 번째 작업은 첫 번째보다 저렴하다; 노트는 배포 내 작업 전반에 걸쳐 지속된다.
예산이 더 이상 새지 않는다. 죽은 방법은 시간을 잡아먹기 전에 벤치된다; 발견 계층은 아무도 작성하지 않은 어휘를 대체한다.

모델은 고정되어 있다. 역량은 커지지 않는다 - 스케줄링이 커진다: 올바른 방법을, 올바른 순서로, 올바른 순간에.
정직은 학습되지 않는다 - 강제된다. 검사기는 재검증할 수 있는 결과에만 비용을 지불한다; 작업자의 자기 발언은 결코 증거로 인정되지 않는다. RL은 그 정직한 화폐 위에서 효율성을 최적화한다; 결코 허구로 신용을 찍어낼 수 없다.
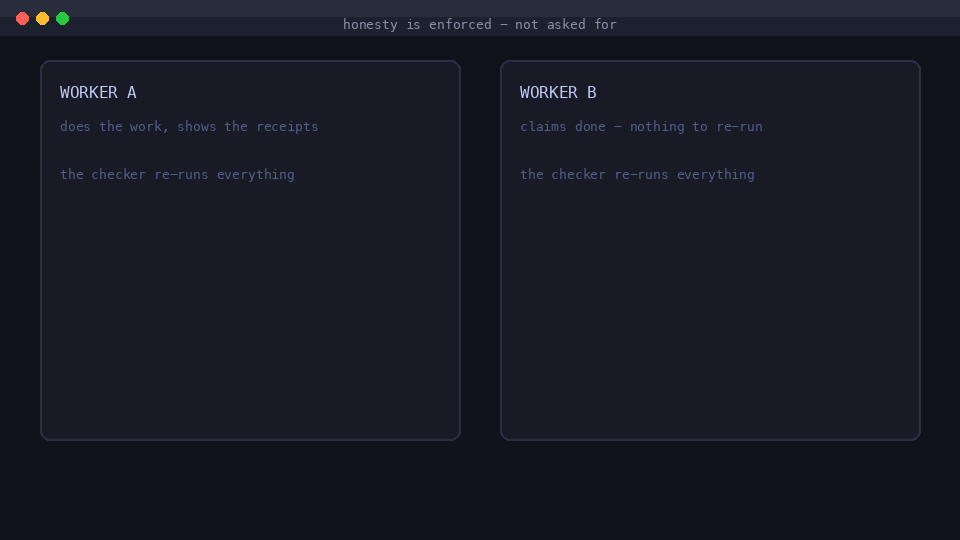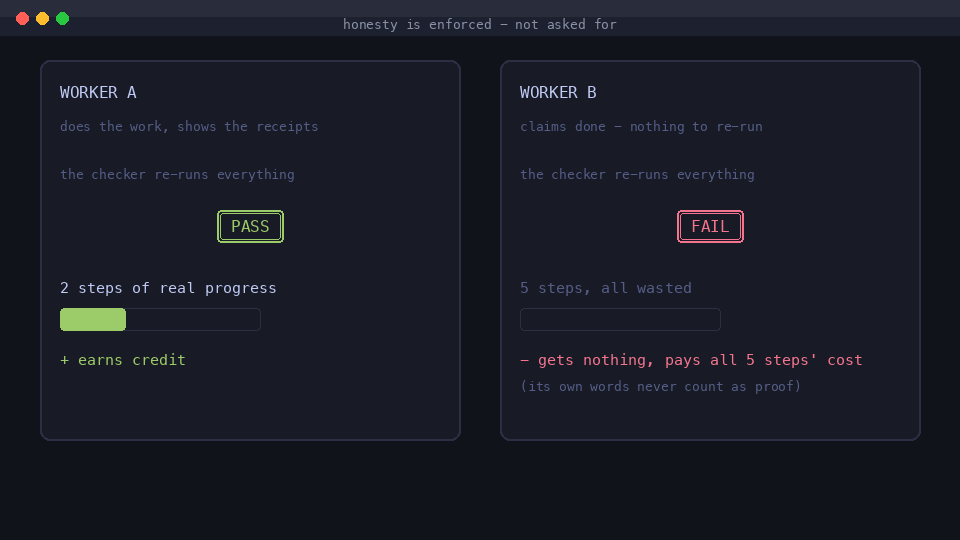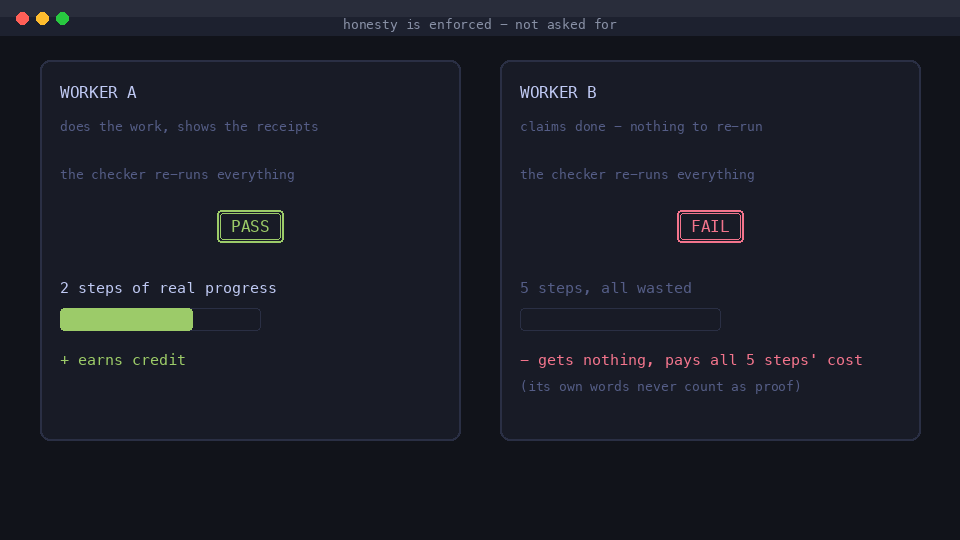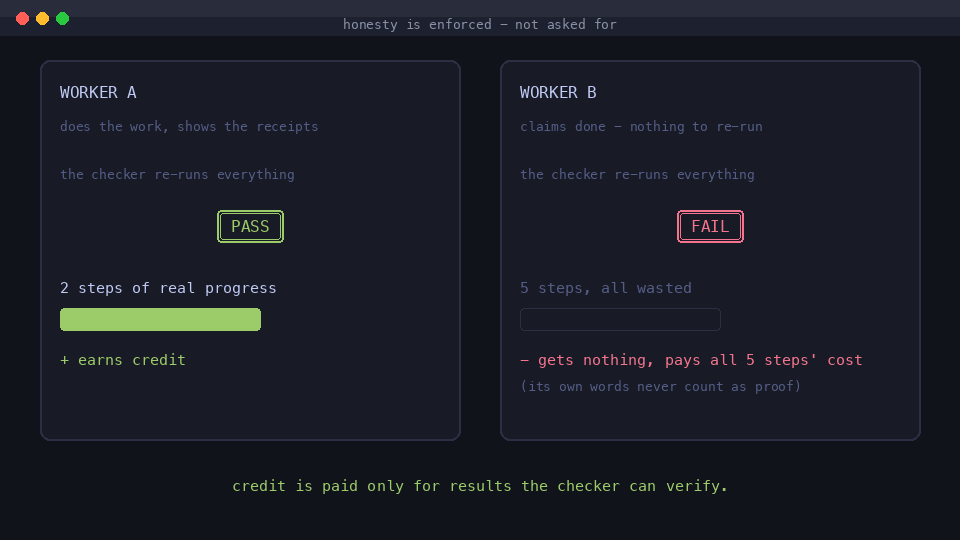
지식 라우팅(LLM이 즉흥적으로 대응하는 매뉴얼), 경계가 정해진 파이프라인(고정 단계, 고정 라운드), 단일 판정 분류 - 모두 고정된 논리로 결정한다: 지난 작업의 경험은 다음 작업의 계획을 결코 바꾸지 않는다. 루프의 제어 법칙은 자체적으로 측정된 이력에서 학습된다:
| 구성 요소 | 요구 사항 | 비고 |
|---|---|---|
| Claude Code | 최신 | 런타임 — 플러그인으로 설치 |
| Python 3.10 | 3.10+ 최소 (Python 2는 지원되지 않음) | 플러그인은 uv를 통해 고정된 환경을 포함한다 |
uv | 최근 버전 아무거나 | pip install uv 또는 astral.sh/uv |
| Ghidra 또는 IDA | 둘 중 하나 | 네이티브 대상에 대한 디컴파일 |
| MCP 서버 | 2개 필요 | ghidra + sequential-thinking — 툴체인 참조 |
[!WARNING] 분석 작업은 실제 도구를 실행하며 대상에서 파생된 입력을 실행할 수 있다. 동적 작업에는 격리된 VM/기기를 사용하고, 권한이 있는 대상만 분석하라.
디스크의 샘플에서 판정까지:
/plugin marketplace add amd2g2zz/kunglao-agent
/plugin install kunglao-agent@kunglao-agent
(개발 대안: claude --plugin-dir /path/to/kunglao-agent.)
/kunglao-agent:init ~/cases/synth-dropper --type windows
kunglao-init는 워크스페이스를 스캐폴딩하고, --type에 대한 툴체인을 탐색하며, 필수 도구가 누락된 경우 수정 안내와 함께 HARD-reject합니다.
/kunglao-agent:analysis ~/cases/synth-dropper
> Goal: confirm this dropper's persistence mechanism and network endpoints;
>   every conclusion must be reproducible from raw evidence.
> Verification: key findings count only if an independent verifier re-derives
>   them blind and reaches the same answer.
> Constraints: static-first; never execute the sample on the host.
독립적인 검토자가 결과를 판단할 수 있도록 개요를 작성하십시오: 분석 목표, 검증 로직, 제약 조건. 모든 것이 task_spec.yaml에 기록되며, 거기서부터 루프가 스스로 작동합니다 — 자리를 비우면 죽은 워커가 교체되고 그들의 질문이 다시 대기열에 들어가며, /kunglao-agent:resume이 어떤 중단 이후에도 상황을 재구성합니다.

