 aloshdenny/claude-awm
유니코드 변형 선택자를 주입하여 LLM 텍스트 워터마크를 우회합니다. SynthID 생성기, mean-g 탐지기, 정규화 방어 및 엔트로피 실험을 포함합니다.

가능하다. 다만 한 가지 공격 계열만 통하며, 그것은 모두가 가정하는 그 공격이 아니다.
유니코드 변형 선택자(variation selector, 카테고리 Mn, U+FE00U+FE0F 및 U+E0100U+E01EF)는 탐지기를 임계값 아래로 끌어내리며 그 상태로 유지된다. 내가 시도한 다른 모든 보이지 않는 문자 공격은 한 줄의 입력 정규화로 완전히 되돌려진다. 변형 선택자는 그렇지 않은데, 이는 이들이 의미 있는 코드포인트(이모지 표시, CJK 변형)이기 때문에 NFKC가 접어 없애지도 않고 없애서도 안 되기 때문이다.
여러 모델과 도메인에 걸쳐 재현됨:
| 모델 | 도메인 | 기준선 z | vs16_30 적용 후 | 편집률 |
|---|---|---|---|---|
| gpt-oss-20b | 산문 | 45.03 | 0.72 | 57% |
| gpt-oss-20b | 코드 | 37.24 | 0.68 | 58% |
| Qwen3.8-27B | 산문 | 35.50 | -0.67 | 57% |
임계값은 z = 2.33이다. 세 경우 모두 공격 후 임계값 아래로 떨어지며, 정규화 후에도(각각 0.09, 0.45, -0.78) 그 아래에 머문다. 텍스트는 사람 독자에게 동일하게 렌더링된다.
두 번째 실제 발견은 공격이 전혀 필요 없다: 저엔트로피 텍스트는 애초에 거의 워터마킹되지 않는다. 사고(thinking)를 비활성화하면 Qwen3.8-27B의 순수 코드 출력은 아무 공격도 하지 않은 상태에서 z = 4.31로, 아무것도 하지 않은 채 2.33 임계값에 가깝다. 사고를 다시 켜면 동일한 모델, 동일한 도메인, 동일한 길이가 z = 25.53에 도달하는데, 추론 서두가 평범한 산문이라 워터마크를 정상적으로 담기 때문이다.
이 저장소의 모든 것은 다음 모델에서만 측정되었으며, 그 외에는 없다:
| 모델 | 파라미터 | 위치 | 실행 내용 |
|---|---|---|---|
| Qwen3.5-0.8B | 0.8B | Mac (MPS) | 전체 공격 사다리, 1k-8k |
| Qwen3.5-4B | 4B | Mac / 4090 | 전체 공격 사다리 + 엔트로피 실험 + 스테고 원본/정규화 |
| DeepSeek-R1-Distill-Qwen-14B | 14B | Mac (MLX, 4-bit) | 워터마크 + 탐지, 추론 트레이스 |
| gpt-oss-20b | 20B | 3090 / 4090 / RunPod | 32k까지 전체 공격 사다리, 산문 + 코드, 변형 선택자, 131k까지 삽입률 스케일링 법칙 |
| Qwen3.8-27B | 27B | RunPod H100 / Modal H100 | 산문 + 코드, 변형 선택자, 사고 모드 대조 |
| gpt-oss-120b | 120B | Modal H100 (MXFP4) / RunPod H100 | 2k / 8k / 32k에서 산문 + 코드 + 추론, 65k까지 부분 삽입률 스케일링 |
| DeepSeek-V4-Flash | 284B MoE | RunPod 2x H200 (FP8) | 2k / 8k에서 산문 + 코드 |
모든 실험이 모든 모델에서 실행된 것은 아니며, 아래 표들은 어디서 무엇이 실행되었는지 보여준다. 흥미로운 질문이 좁혀짐에 따라 더 큰 모델이 추가되었으므로, 공격 사다리는 작은 모델에서 폭넓게 다루어지고 길이 및 도메인 작업은 큰 모델에 집중되어 있다.
Anthropic(그리고 그 이전의 Google DeepMind, SynthID-Text 논문)은 키 기반 토너먼트로 토큰 샘플링을 편향시켜 생성된 텍스트에 워터마크를 넣는다. 신호는 어떤 토큰이 선택되었는가에 존재하며, 어떤 숨겨진 문자에도 있지 않다. 나는 이것이 찾기-바꾸기를 가진 의욕적인 사람에게 얼마나 취약한지 알고 싶었기에, 생성기와 학습되지 않은 평균-g 탐지기를 구축하고 공격을 퍼부었다.
탐지기 임계값은 z = 2.33(1% 위양성률)이다. 그 이상이면 워터마크 탐지됨이다. 나는 워터마크된 텍스트를 생성하고, 공격하고, 재토큰화하고, 점수를 매겼다. 모든 결과 표에는 roundtrip 대조군(공격받지 않은 워터마크 텍스트)이 포함되어 있어 해당 행에서 탐지기가 실제로 작동하고 있음을 확인할 수 있다. 이 연구에서 두 번, 버그로 인해 모든 z가 0으로 붕괴되었으며, 대조군만이 그것을 잡아냈다.
공격 표면은 유니코드 카테고리에 따라 깔끔하게 나뉘며, 이것이 전부였다.
통함 (카테고리 Mn, 비간격 결합 문자):
| 공격 | 하는 일 | 편집률 | 정규화를 견디는가? |
|---|---|---|---|
vs16_30 | 약 30%의 문자 뒤에 변형 선택자 | 57% | 예 |
vs16 | 약 10%의 문자 뒤에 변형 선택자 | 23% | 예 (z 3.46) |
vs_supp | 보충 평면 선택자 (U+E0100+) | 24% | 예 (z 3.40) |
homoglyph | 라틴 a 대신 키릴 а (카테고리 Ll) | 9% | 예, 다만 효과가 약함 |
작동하지 않음 (카테고리 Cf, 포맷 문자):
| 공격 | 원시 z | 정규화 z | 판정 |
|---|---|---|---|
zwsp_30 | -0.09 | 35.68 | 완전히 되돌려짐 |
combo | 0.92 | 35.68 | 완전히 되돌려짐 |
bidi | 24.37 | 35.68 | 완전히 되돌려짐 |
nbsp | 41.04 | 46.51 | 거의 움직이지 않음 |
Cf 문자는 의미 내용이 없는 순수한 포맷팅이므로, 정규화기는 이를 통째로 제거해도 아무것도 잃지 않는다. Mn 변형 선택자는 이모지와 CJK 텍스트에서 실제 의미를 지니므로, 이를 일괄적으로 제거하면 정당한 문서를 훼손하게 된다. 이러한 비대칭성이 한 계열은 방어 가능하고 다른 계열은 그렇지 않은 이유다.
실용적 범위: 강력한 기준선을 임계값 아래로 밀어내려면 문자의 약 20% 이상을 건드려야 하지만, 삽입된 문자는 보이지 않으므로 어떤 편집률에서도 텍스트는 정상적으로 읽힌다. 시각적으로 동일함이 검증되었다. src/fidelity_check.py를 참조하라. 네 개의 계열은 아무것도 렌더링하지 않는 문자만 삽입한다. 동형문자는 정직한 예외다(폰트 의존적이며, 보이지 않음이 보장되지 않는다).
나의 처음 두려움은 지루한 것이었다. em-dash와 "and"를 "&"로 바꾸고 마크다운을 제거하는 것만으로 통할 것이며, 워터마크는 결국 보안 연극에 불과할 것이라는 두려움이었다. 온라인에서 많은 사람들이 정확히 그렇게 가정한다.
그것은 작동하지 않는다. gpt-oss-20b에서 32k 토큰까지 이어지는 표면 편집 사다리 전체:
| 공격 | 편집률 | z @ 1k | z @ 32k |
|---|---|---|---|
| 왕복 (대조군) | 0% | 25.7 | 104.3 |
| em-dash를 하이픈으로 | ~0% | 26.4 | 113.7 |
| 모든 마크다운 제거 | 13.6% | 27.2 | 103.3 |
| AmE를 BrE로 + 약어 | 1.3% | ~28 | ~100 |
| 모든 단어의 40% 삭제 | 38% | 4.9 | 25.4 |
이 사다리가 실행된 세 모델(0.8B, 4B, 20B = 294개 셀)에 걸쳐, 정확히 하나의 셀이 임계값을 넘었다. 4B에서 가장 짧은 길이로 모든 단어의 39%를 삭제한 경우다. 그것은 공격이 아니라 문서를 갈가리 찢는 것이다.
전체 연구에 걸친 총 측정 셀: 440개 (위의 공격 사다리에서 294개, 더하기 아래의 스케일링 법칙 스윕에서 산문을 131072 토큰까지 확장한 146개).
두 가지가 나를 놀라게 했다:
전체 메커니즘과 공격별 표는 docs/FINDINGS.md에 있다.
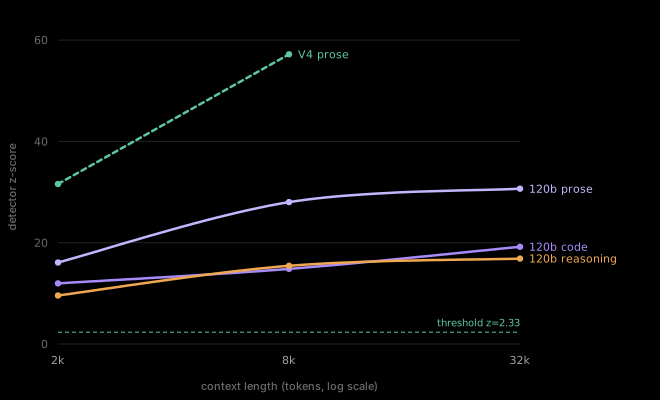
워터마크 신뢰도는 컨텍스트와 함께 증가하는 반면 토큰당 신호는 평평하게 유지되므로, 더 긴 문서는 공격하기 더 어렵지, 더 쉽지 않다. 산문은 모든 길이에서 가장 강한 표식을 지닌다. DeepSeek-V4-Flash(점선)는 284B MoE에서 동일한 상승을 재현한다.
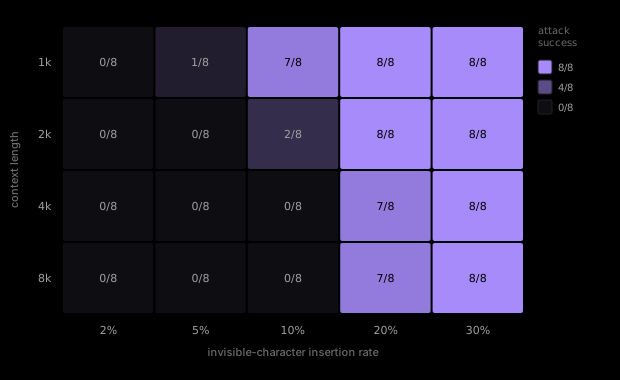
그리고 공격은 계속 따라가야 한다. 각 셀은 8개의 무작위 삽입 시드 중 몇 개가 탐지기를 이겼는지를 나타낸다. 10% 삽입은 1k 토큰을 통과하지만 4k에서는 완전히 실패한다. 필요한 삽입률은 컨텍스트 길이에 따라 상승하며, 이것이 공격이 컨텍스트에 무관하지 않은 이유다.
전용 후속 스윕이 이를 정확히 짚어낸다. gpt-oss-20b에서 1024 토큰부터 131072(모델의 최대 컨텍스트)까지, 필요한 비율은 p*(L) ≈ 2.37·log2(L) − 14.6을 따른다 -- 1k 토큰에서 9.3%에서 131k에서 25.0%까지 상승한다.
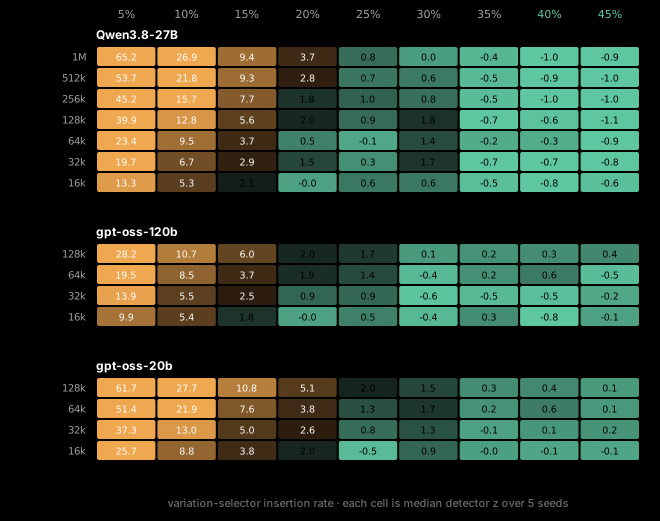
그러면 당연히 다음 질문이 떠오른다. 문서를 충분히 길게 만들기만 하면 결국 탐지기가 완전히 이기는가? 이를 확인하기 위해 스윕을 1,048,576 토큰까지 확장했다. 세 모델 × 모든 컨텍스트 길이 × 삽입률이며, 위의 각 셀은 5개 시드에 대한 탐지기 z의 중앙값이고, 공격이 이긴 곳(z < 2.33)은 청록색, 워터마크가 살아남은 곳은 주황색이다.
그렇지 않다. 방어자의 초기 우위는 커지지만, 공격자의 비용은 더 느리게 증가한다:
| 모델 | 측정 길이 | 최단 길이에서의 p* | 최장 길이에서의 p* | 배증당 |
|---|---|---|---|---|
| gpt-oss-20b | 16k – 131k | 19.0% | 24.5% | +1.86 pp |
| gpt-oss-120b | 16k – 131k | 14.2% | 19.5% | +1.91 pp |
| Qwen3.8-27B | 16k – 1,048,576 | 14.7% | 22.4% | +1.21 pp |
기준선 워터마크 강도는 √n처럼 증가하지만, 이를 지우는 데 필요한 삽입률은 컨텍스트가 두 배가 될 때마다 약 1.2–1.9 퍼센트 포인트만 증가한다. 측정된 135개의 공격 셀 전체에서 35% 이상 삽입률의 45개 셀 모두 임계값 아래로 떨어졌다 -- 최악의 경우 35%에서 z = 0.31, 40%에서 z = 0.60이었다. 실제로 요구된 최고 비율은 131k에서 gpt-oss-20b의 24.5%였다. 16k에서 1M 토큰으로, 즉 64배 증가하여 탐지기가 얻은 것은 약 8 퍼센트 포인트였다.
분명히 짚어야 할 두 가지 주의점이 있다. gpt-oss-120b의 이전 "부분 실행"은 이제 완료되었으며, 131k에서 측정된 19.5%가 이전에 4개 길이 중 3개에서 외삽한 ~20-23% 수치를 대체한다. 그리고 Qwen3.8-27B의 기준선 z는 일곱 개 길이 전체에서 14.85로 평평하게 유지된다 -- 이는 실제 문서 퇴화 아티팩트이므로 그 절대적 강도 수치는 신뢰할 수 없는 것으로 취급해야 한다; 이 모델이 보여주는 길이 스케일링 추세는 다른 두 모델과 일관되며 위 표가 사용하는 값이다. 전체 표, 피팅, 주의점은 docs/FINDINGS.md § 14에 있다.
인터랙티브 버전 사용해 보기 → 전/후 공개 토글이 있는 실제 연구 샘플과, 자신의 텍스트에 공격 변환을 실행할 수 있는 플레이그라운드를 제공한다. 임의로 붙여넣은 텍스트가 실제로 워터마크되어 있는지는 알려주지 못하며(우리에게 없는 키가 필요하다), 그렇게 명시하고 있다; 생성기 스크립트는 site/를 참조하라.
워터마크는 모델의 토큰별 불확실성에 의존한다. 모델이 다음 토큰에 대해 확신하는 곳에서는 토너먼트가 편향을 줄 여지가 없으므로 신호가 들어가지 않는다. 즉 저엔트로피 텍스트에서는 마크가 약하며, 코드는 저엔트로피이다.
Qwen3.5-4B, 산문 대 코드, 512 토큰 샘플, 공격 전혀 없음:
| 도메인 | 엔트로피 | z |
|---|---|---|
| 산문 | 1.19 bits/tok | 11.1 |
| 코드 | 0.55 bits/tok | 5.0 |
z 비율 0.45x, 엔트로피 비율 0.46x, 둘은 함께 움직이며, 이것이 메커니즘이 드러나는 모습이다. 8개 코드 샘플 중 3개가 스스로 탐지 임계값 이하로 떨어졌다. 가장 빡빡한 것(순수 알고리즘, 0.2 bits/token)은 1.7점을 기록하여 미탐지였다.
규모가 커지면 더 극단적이 된다. 공격이 전혀 없는 기준선 z:
| 모델 | 산문 | 코드 | 비율 |
|---|---|---|---|
| gpt-oss-20b | 45.03 | 37.24 | 0.83 |
| Qwen3.8-27B | 35.50 | 4.31 | 0.12 |
Qwen3.8-27B의 코드 출력은 너무 템플릿화되어 있어, 깨끗하고 공격받지 않은 워터마크가 z = 4.31로 2.33 임계값을 겨우 넘는다. 적대자가 필요 없다.
이는 말한다: 도메인 전반에 걸친 단일 신뢰도 임계값은 안전하지 않으며, 짧은 코드 스니펫은 워터마크를 넣기가 거의 불가능하다. JSON, 설정, 구조화된 추출, 상용구에도 일반화된다.
이런 탐지기 중 하나를 배포한다면, 입력 정규화가 대부분의 길을 데려다주지만 전부는 아니다:
