
 1rhino2/fnprint
바이너리의 함수를 바이트 형태가 아닌 동작 방식으로 매칭합니다. 마이크로실행을 통한 동작 기반 함수 핑거프린팅.

fnprint은 바이트나 제어 흐름 그래프(control-flow graph)가 어떻게 생겼는지가 아니라 함수가 무엇을 하는지를 기준으로 바이너리 내의 함수를 매칭합니다. 각 함수를 임의의 입력을 넣은 작은 에뮬레이터에서 실행하고, 발생하는 부작용(side effect)을 기록한 뒤, 그 동작을 지문(fingerprint)으로 해싱합니다. 동일하게 동작하는 두 함수는 서로 다른 컴파일러로 빌드되었거나, 최적화 수준이 다르거나, 다른 CPU용으로 만들어졌더라도 유사한 지문을 갖습니다.
이렇게 하는 이유: 바이트 시그니처(FLIRT, FunctionID)는 코드가 재컴파일되는 순간 깨지고, CFG 매처(BinDiff, Diaphora)는 -O0와 -O3 사이에서 흔들리며 아키텍처를 넘어가면 포기합니다. 동작(behavior)은 이 모든 것을 훨씬 잘 견딥니다. 학습 데이터도, 모델도 필요 없고, 정적 바이너리 하나면 됩니다.
다른 도구들이 하지 못하는 세 가지:
-O0 대 aarch64 -O0: 함수의 97.7%에 올바른 이름을 붙였습니다.triage는 diff가 아니라 판정을 내려줍니다. 두 코퍼스(알려진 취약 버전, 패치 버전), 마진, 그리고 취약 쪽으로 기우는 함수들의 검토 큐를 제공합니다. 이것이 n-day 워크플로우를 하나의 명령으로 만든 것입니다.x86-64와 aarch64 ELF를 지원합니다. 신뢰하기 전에 한계를 확인하세요.
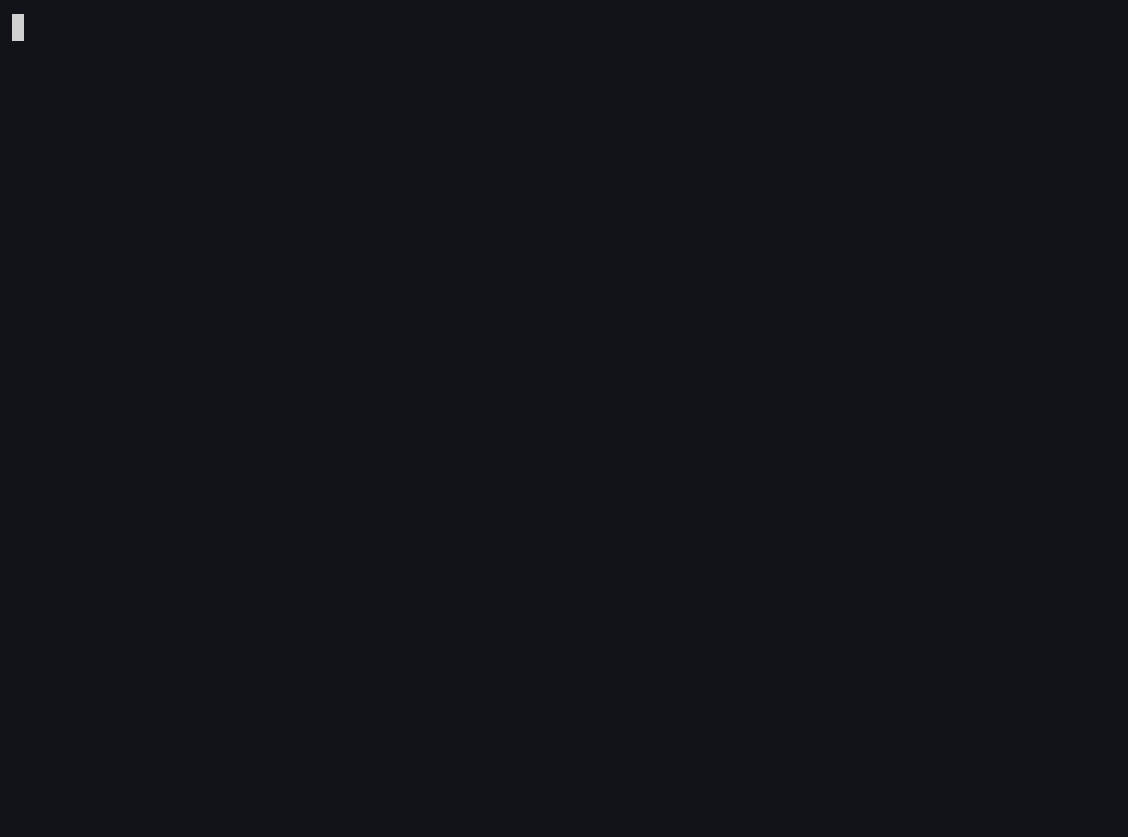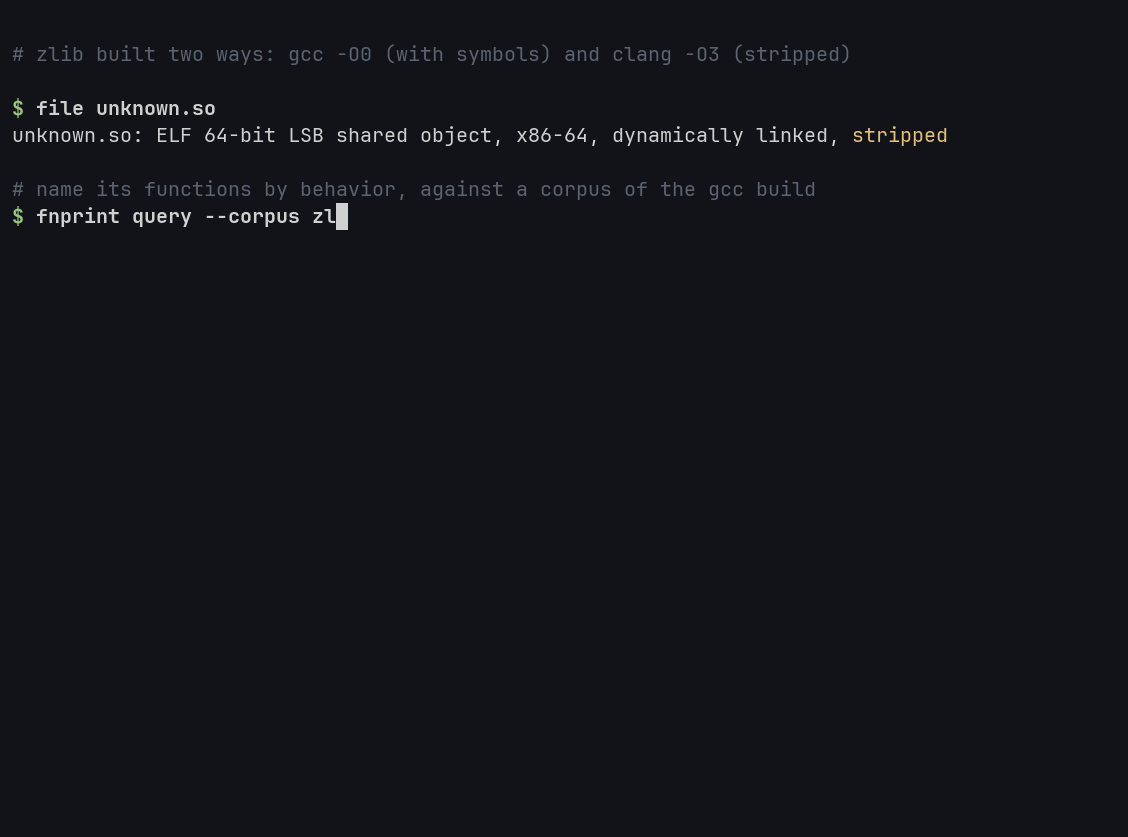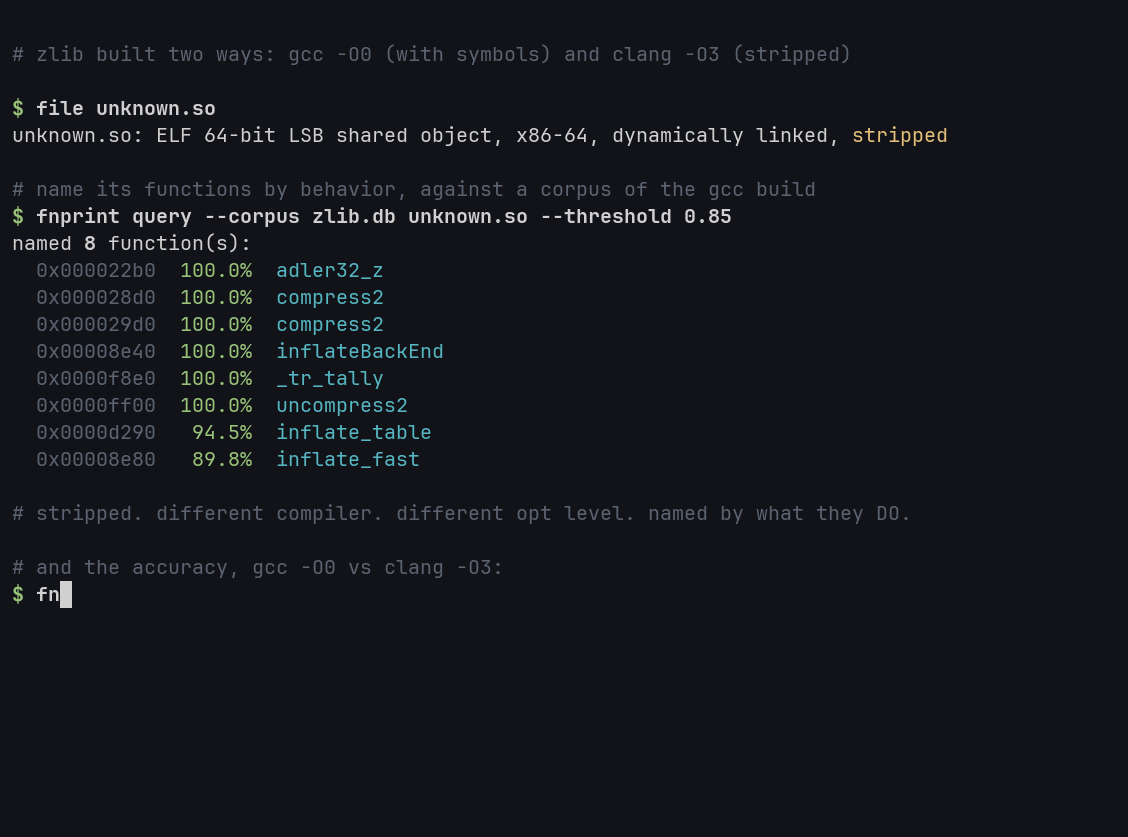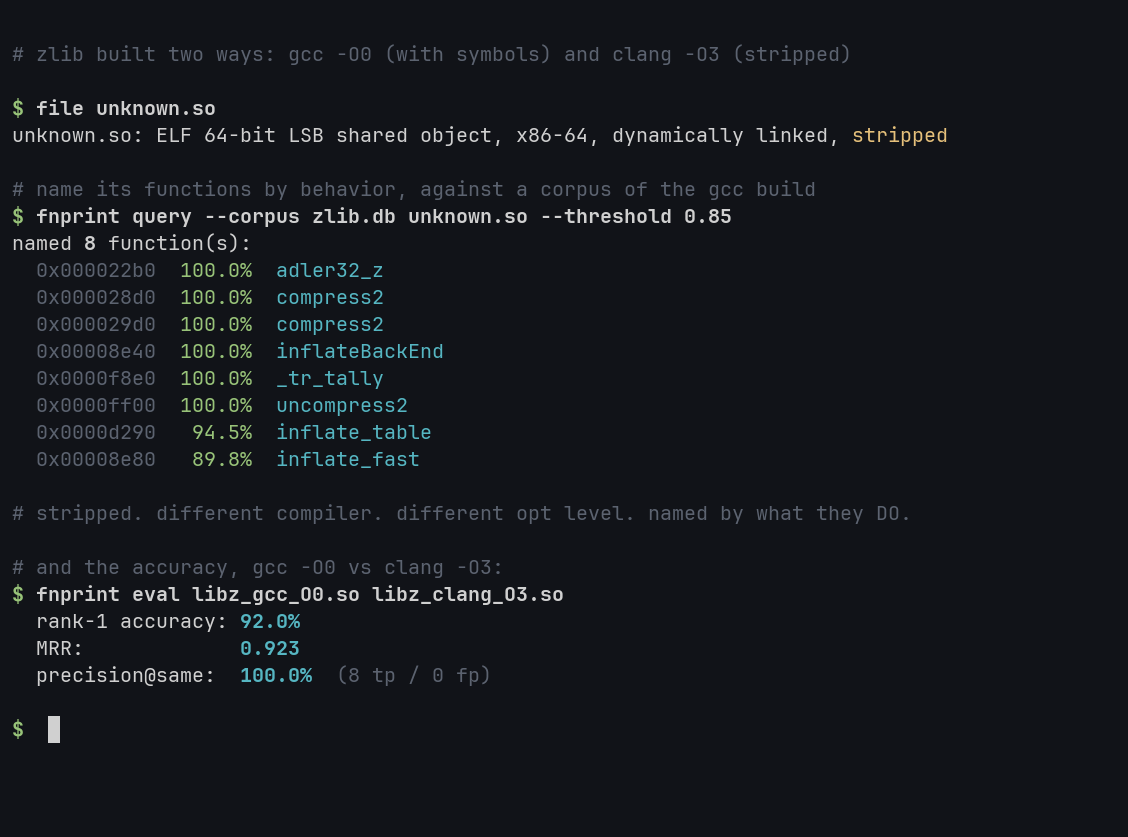
스트립된 바이너리와 이미 이름을 알고 있는 것들의 코퍼스를 지정하세요:
$ strip --strip-all mystery.so
$ nm mystery.so
nm: mystery.so: no symbols

$ fnprint index libz.so -o corpus.db          # a build you have symbols for
$ fnprint query mystery.so --corpus corpus.db --threshold 0.6
named 27 function(s):
  addr        sim    graph  name
  0x000022f9  100.0%     0%  adler32_z  (libz.so)
  0x00002a8d  100.0%     0%  compress2  (libz.so)
  0x00004500  100.0%     0%  deflateStateCheck  (libz.so)
  0x0000ad5d  100.0%     0%  inflateBackEnd  (libz.so)
  0x0000b69c  100.0%     0%  inflateStateCheck  (libz.so)
  0x00012f8c  100.0%     0%  _tr_tally  (libz.so)
  ...
이 실행은 완전히 스트립된 -O0 빌드를 -O2 코퍼스로부터 이름 붙인 것입니다. 최적화 수준이 다르고, 심볼이 하나도 남지 않았는데도 27개의 이름이 돌아왔고 27개 모두 정확합니다. 확신하는 것에는 이름을 붙이고 나머지에 대해서는 조용히 있습니다. (위의 gif는 9개를 찾은 0.5 버전에서 나온 것입니다; 0.6은 스트립된 .so가 export 뒤에 숨긴 정적 함수들도 복구합니다.)
CPU를 넘어서도 마찬가지입니다. x86-64 빌드에서 만든 코퍼스, 대상은 같은 소스의 aarch64 빌드이고 심볼은 사라졌습니다:
$ fnprint index libz_x86_64.so -o corpus.db
$ fnprint query libz_arm64_stripped.so --corpus corpus.db
named 42 function(s):
  addr        sim    graph  name
  0x00001af4  100.0%     0%  adler32_z  (libz_x86_64.so)
  0x0000263c  100.0%     0%  compress2  (libz_x86_64.so)
  0x00002958  100.0%   100%  x2nmodp  (libz_x86_64.so)
  0x00002a98  100.0%     0%  crc32_z  (libz_x86_64.so)
  0x000034c4  100.0%   100%  crc32_combine64  (libz_x86_64.so)
  ...
다른 CPU용으로 만든 코퍼스로부터 42개에 이름을 붙였고 42개 모두 정확합니다.
또 다른 기능은 두 빌드를 diff하여 어떤 함수의 동작이 바뀌었는지 알려주는 것으로, 벤더가 새 펌웨어를 출시했을 때 실제로 무엇이 바뀌었는지 알고 싶을 때 유용합니다. 심볼 이름이 있든 없든 동작합니다: 있으면 이름으로 정렬하고, 없으면 동작과 호출 그래프를 기준으로 두 빌드를 정렬하므로 완전히 스트립된 두 펌웨어 이미지도 diff할 수 있습니다:
$ fnprint match old.so new.so
aligned 38 function pairs by behavior + call graph (no symbol names needed)
  unchanged:  31
  changed:    7
  low-signal: 57 (too small to judge)

changed behavior (lowest similarity first):
   30.5%  compress_block
   43.0%  deflate_rle -> deflate_huff
   68.8%  deflate_slow
실제 n-day 작업을 위해서는 triage가 있습니다. 함수의 알려진 취약 버전으로 코퍼스 하나를, 패치 버전으로 코퍼스 하나를 만든 뒤, 알 수 없는 빌드를 두 코퍼스 모두에 대해 순위 매기세요. 취약한 쪽에 가깝고 패치된 쪽과 명확히 분리된 함수가 바로 사람 앞에 놓아야 할 것이며, 해석해야 하는 단일 매칭 점수만으로는 부족합니다:
$ fnprint index vuln.so    -o vuln.db
$ fnprint index patched.so -o patched.db
$ fnprint triage mystery.so --vuln vuln.db --patched patched.db
43 functions triaged: 1 look vulnerable, 0 patched, 42 inconclusive

review queue (vuln-leaning, strongest first):
   addr         vuln%  patched%  margin  matches
   0x000022f9  100.0     27.3   +72.7  adler32_z vs crc32_z
두 버전에서 동일한 42개 함수는 의도적으로 inconclusive로 돌아옵니다. 어느 쪽으로도 확정할 수 없고 플래그가 지정되어서도 안 되기 때문입니다. --margin과 --min-sim은 두 쪽이 얼마나 강하게 분리되어야 판정을 내릴지 제어합니다.
각 함수에 대해:
strip 후에도 살아남는 부분이기 때문입니다. 내부 호출은 출력에서 익명이며 대신 본문의 정적 스윕으로부터 호출 그래프 엣지가 됩니다.-O2 함수가 모두 그것을 차지하는 것을 막습니다.학습 데이터도, 모델도 없습니다. 같은 아이디어가 문헌에서는 Blanket Execution(Egele et al, USENIX Security 2014)으로 등장합니다; fnprint는 실제로 사용할 수 있는 CLI를 갖춘 실용적이고 유지 관리되는 접근입니다. 효과 모델은 구조적으로 아키텍처 중립적이며, 그래서 같은 소스의 x86-64와 aarch64 프린트가 아무것도 학습하지 않고도 정렬됩니다.
rust 툴체인, cmake, C 툴체인이 필요합니다. unicorn(no-JIT 포크)과 capstone은 cargo가 소스에서 빌드하므로 apt로 설치할 것은 없습니다.
cargo install --path cli
# or just
cargo build --release   # binary at target/release/fnprint
fnprint index <binary> [-o out.db]      fingerprint every function, optionally to a db
fnprint match <a> <b>                   diff two binaries (or .db files) by behavior
fnprint query <target> --corpus <db>    name unknown functions from a corpus
fnprint triage <t> --vuln <db> --patched <db>   rank a build against vuln vs patched corpora
fnprint eval <a> <b>                     accuracy metrics using symbol names as truth
fnprint dump <binary> <func>            print the recorded effect trace (debugging)
fnprint completions <shell>             print a shell completion script to stdout
match와 query는 ELF 또는 index로 만든 .db를 받으므로, 코퍼스를 한 번 지문 채취하고 재사용할 수 있습니다. index -o는 추가(append)하므로 하나의 코퍼스가 여러 바이너리를 담을 수 있습니다.
match --align은 심볼이 있는 쌍에 대해 이름 없는 정렬을 강제하여 동작만 보는 관점이 무엇을 말하는지 확인합니다. --graph-weight(전역, 기본값 1.0)는 정렬 시 일관된 호출 그래프 이웃이 쌍을 얼마나 끌어올리는지 설정합니다; 0은 모든 함수를 자체 동작만으로 점수화합니다.
match, query, triage는 --limit N을 받아 사람용 테이블이 출력하는 행 수를 제한합니다(0 = 전부). json과 r2 출력은 절대 제한되지 않으므로 스크립트는 모든 것을 받습니다.
completions는 bash, zsh, fish, powershell, elvish용 스크립트를 작성합니다, 예를 들어
fnprint completions bash > ~/.local/share/bash-completion/completions/fnprint.
어떤 출력이든 읽기를 일찍 멈추는 것으로 파이프하면(| head) 조용히 종료되므로, 테이블을 --limit 없이도 안전하게 훑어볼 수 있습니다.
모든 명령은 전역 --format을 받습니다:
fnprint query mystery.so --corpus corpus.db --format json > names.json
fnprint query mystery.so --corpus corpus.db --format r2   > fnprint.r2
json은 스크립트(그리고 contrib/의 Ghidra import 스텁)를 위한 안정적인 스키마이고, r2는 rizin/radare2 안에서 . fnprint.r2로 실행하는 afn 이름 변경 명령을 출력합니다. 대상의 심볼 이름은 둘 중 어디로 가든 전에 정제되므로, 조작된 이름이 r2 명령을 주입할 수 없습니다. 스키마와 설정은 docs/integrations.md에 있습니다.
인덱싱은 기본적으로 단일 프로세스입니다. FNPRINT_SHARDS=N fnprint index ...는 큰 인덱스를 N개의 감옥에 갇힌 워커로 분산합니다; 코퍼스는 N이 무엇이든 바이트 단위로 동일합니다. 크고 함수가 많은 바이너리에서만 도움이 되므로, 요청하지 않으면 꺼져 있습니다.
쌍마다 두 개의 숫자. rank-1은 프린트 단독입니다: 빌드 A의 함수에 대해, B의 모든 함수를 유사도로 순위 매겨 최상위 히트가 올바른 것인지. aligned는 query와 match가 실제로 하는 것입니다: 호출 그래프를 동반한 1:1 할당, 파트너가 맞는 빈도, 그리고 "same" 임계값에서 확정한 쌍의 정밀도/재현율. zlib 1.3.1(84개 함수)과 lua 5.4.6(신호가 있는 약 600개 함수), bench/run.sh로 재현 가능:
