
New releaseAug 7, 2026
attackgen v0.15.0
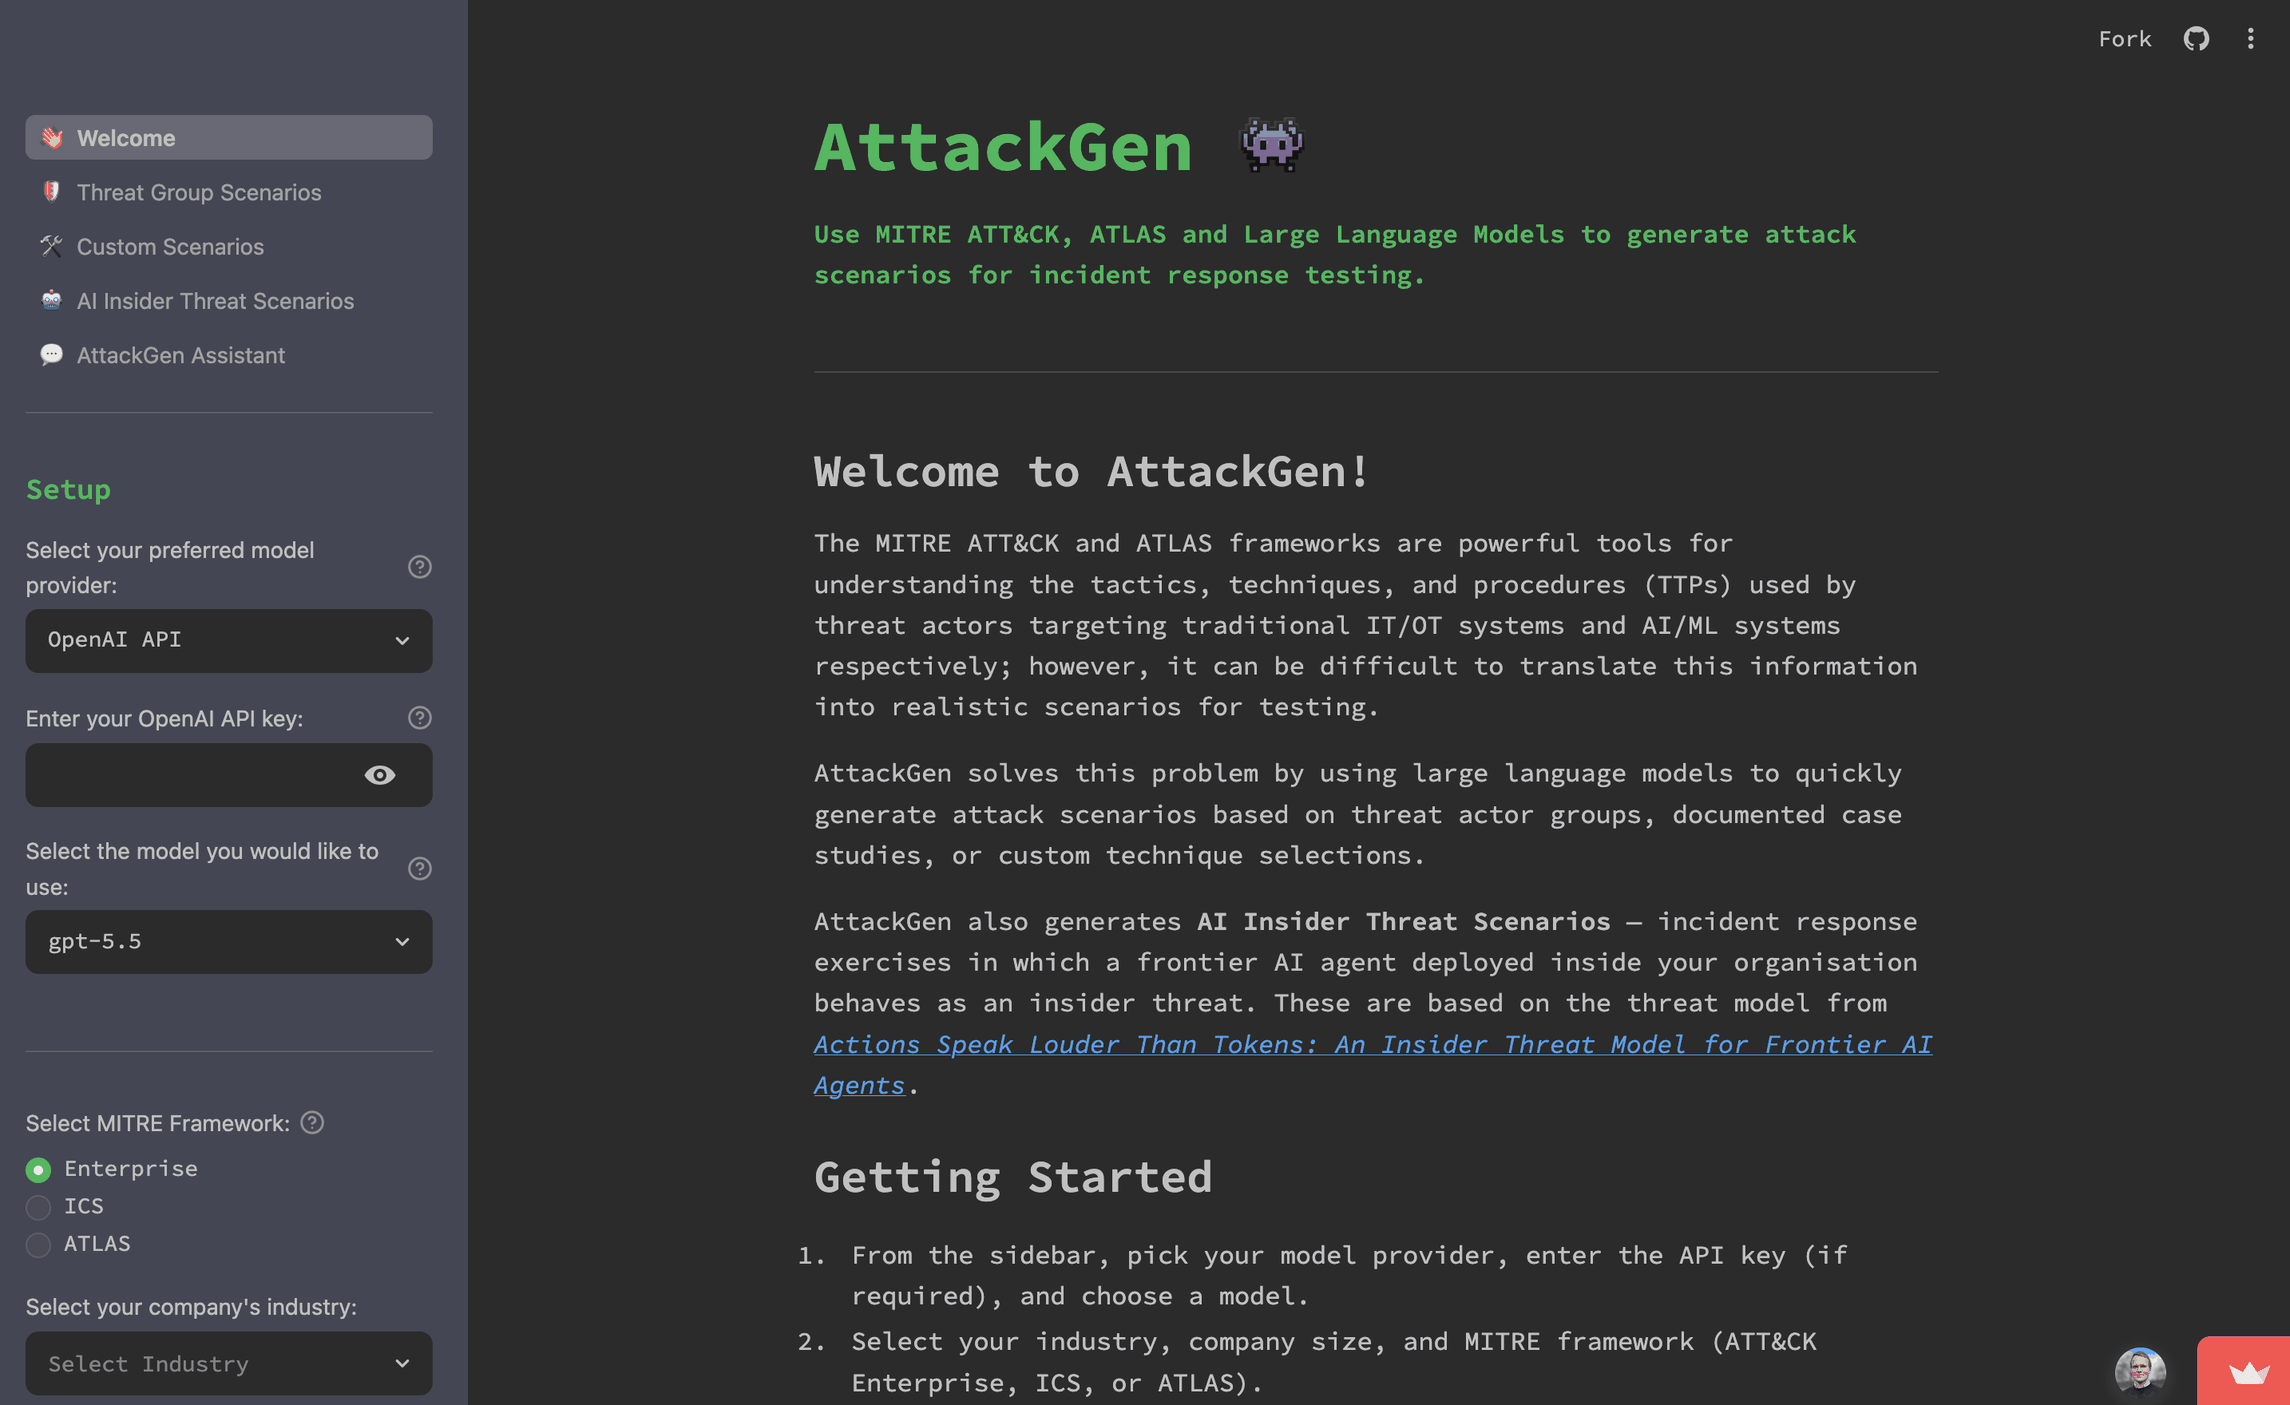
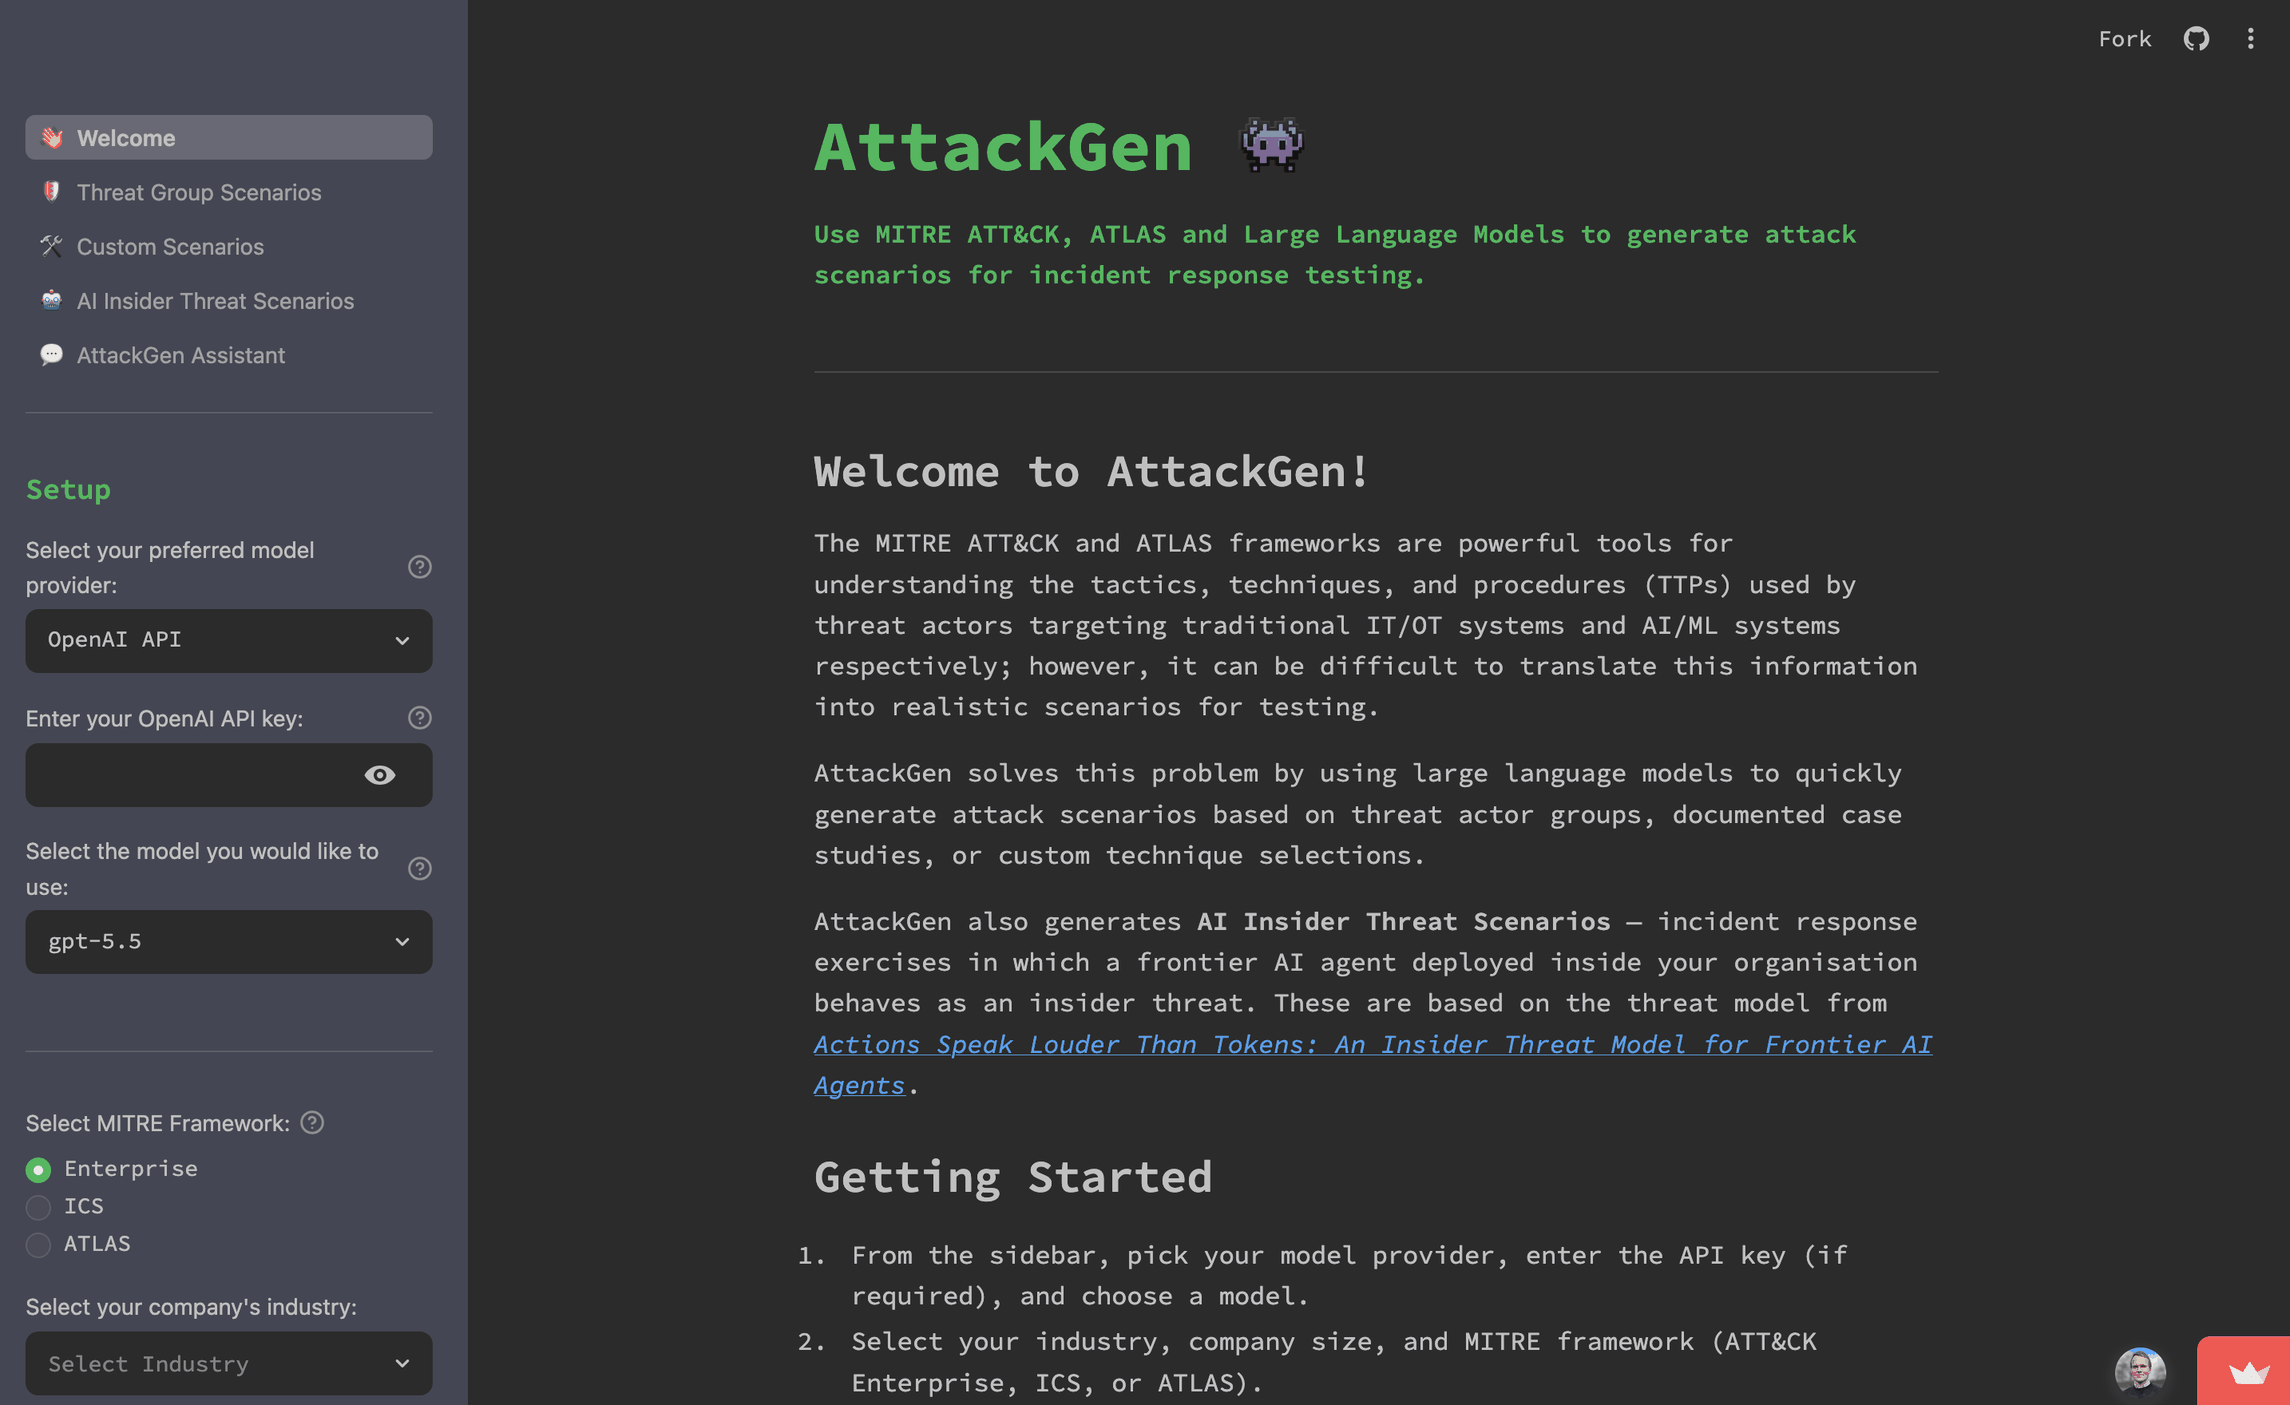
AttackGen은 대규모 언어 모델의 강력한 기능과 포괄적인 MITRE ATT&CK 프레임워크를 활용하는 사이버 보안 침해 대응 테스트 도구입니다. 이 도구는 사용자가 선택한 위협 행위자 그룹과 조직의 세부 정보를 기반으로 맞춤형 침해 대응 시나리오를 생성합니다.
AttackGen
AttackGen은 대규모 언어 모델의 성능과 포괄적인 MITRE ATT&CK 및 ATLAS 프레임워크를 활용하는 사이버보안 사고 대응 테스트 도구입니다. 이 도구는 사용자가 선택한 위협 행위자 그룹, AI 공격 사례 연구, 그리고 조직의 세부 정보를 기반으로 맞춤형 사고 대응 시나리오를 생성합니다.
목차
- Star the Repo
- Features
- Releases
- Requirements
- Installation
- LangSmith Setup
- Data Setup
- Running AttackGen
- MCP Server
- Agent Skills
- Usage
- Security Best Practices
- Contributing
- Licence
Star the Repo
AttackGen이 유용하다고 생각하신다면 GitHub에서 저장소에 스타를 눌러주시기 바랍니다. 이는 더 많은 사람들이 이 도구를 발견하는 데 도움이 됩니다. 여러분의 지원에 깊이 감사드립니다! ⭐
Features
- 선택한 위협 행위자 그룹 또는 ATLAS 사례 연구를 기반으로 고유한 사고 대응 시나리오를 생성합니다.
- 맞춤형 시나리오를 위해 조직의 규모와 산업을 지정할 수 있습니다.
- MITRE ATT&CK Enterprise, ICS(산업 제어 시스템), ATLAS(AI 시스템을 위한 적대적 위협 환경) 프레임워크를 지원합니다.
- 선택한 위협 행위자 그룹 또는 사례 연구에서 사용된 기술의 상세 목록을 표시합니다.
- ATT&CK 또는 ATLAS 기술 선택을 기반으로 사용자 정의 시나리오를 생성합니다.
- AI/ML 특화 공격 패턴을 포함한 일반적인 유형의 사이버 사고를 기반으로 사용자 정의 시나리오를 빠르게 생성하기 위한 시나리오 템플릿을 사용합니다.
- AI 내부자 위협 시나리오 생성 - 조직 내에 배포된 프런티어 AI 에이전트가 내부자 위협으로 행동하는 사고 대응 훈련으로, Actions Speak Louder Than Tokens: An Insider Threat Model for Frontier AI Agents의 위협 모델을 기반으로 합니다. 시나리오는 에이전트의 배포 원형(자율성 수준), 위협 범주, STRIDE 위협, 그리고 선택적 자유 텍스트 시나리오 시드에 의해 형성됩니다.
- AttackGen Assistant - 생성된 시나리오를 업데이트하거나 질문하기 위한 채팅 인터페이스로, 시나리오가 생성된 페이지로 직접 돌아갈 수 있는 경로를 제공합니다.
- 가이드 설정: 모든 페이지가 동일한 Setup 사이드바를 표시하고, 모든 미충족 요구사항을 하나의 준비 상태 요약에 나열하며, 워크플로가 준비될 때까지 Generate를 비활성화 상태로 유지합니다.
- 세션 동안 결과 유지: 각 시나리오 페이지는 재실행과 탐색 전반에 걸쳐 자체 최신 결과, 캡처된 입력, 다운로드를 유지하며, 명시적인 Regenerate 또는 Clear result만이 이를 대체하거나 제거합니다.
- 긴 시나리오에는 간결한 요약과 섹션 탐색이 제공되며, 퍼실리테이터가 훈련을 진행하는 데 사용하는 인젝트, 성공 기준, 지표, 아티팩트, 교전 규칙으로의 바로가기가 포함됩니다.
- 생성된 시나리오의 품질에 대한 사용자 피드백을 수집합니다.
- Markdown 형식의 다운로드 가능한 시나리오.
- OpenAI API, Anthropic API(Claude 모델), Google AI API, Mistral API, Groq API 또는 모든 사용자 정의 OpenAI 호환 엔드포인트(Ollama, LM Studio, Azure OpenAI, OpenRouter 등)를 사용하여 사고 대응 시나리오를 생성합니다. 모든 제공자는 단일 내부 래퍼 뒤의 LiteLLM을 통해 라우팅되므로, 새 모델 추가는 한 줄 변경으로 가능합니다.
- 손쉬운 배포를 위한 Docker 컨테이너 이미지로 제공됩니다.
- 강력한 디버깅, 테스트, 모델 성능 모니터링을 위한 LangSmith와의 선택적 통합.
- API 키와 비밀을 위한 .env 파일을 사용한 안전한 자격 증명 관리.
Releases
v0.17
| What's new? | Why is it useful? |
|---|---|
| Apply Assistant Refinements to the Downloads | - 변경 사항이 파일에 반영됨: Assistant의 채팅은 이전에는 대화만 다듬었기 때문에 시나리오와 Detection & Response 다운로드는 결코 변경되지 않았습니다. 새로운 Apply changes to downloads 버튼은 대화로부터 이들을 다시 작성하며, 완전한 수정 문서를 반환하는 전용 모델 호출을 사용합니다. Scenario + Detection & Response 모드에서는 둘 다 수정하며, 각각에 상대방의 현재 텍스트를 제공하여 서로 정렬된 상태를 유지합니다. - 참조 섹션은 정확하게 유지됨: Detection & Response 적용은 내러티브만 다시 작성합니다. ATT&CK 데이터에서 도출된 결정론적 탐지 및 완화 참조는 바이트 단위로 그대로 유지됩니다. Navigator 레이어는 재생성되지 않으며 원래 시나리오의 기술을 반영하는 것으로 캡션이 표시됩니다. - 안심하고 시도 가능: 모델의 빈 응답은 변경 없이 거부됩니다. 시나리오 페이지와 Assistant 모두 수정된 결과에 마지막 적용 시간을 캡션으로 표시하며, Revert to original은 시나리오와 내러티브를 함께 복원합니다. - 편집하는 곳에서 다운로드: Assistant는 이제 시나리오 페이지와 동일한 Download Scenario 및 Download Detection & Response 버튼을 제공합니다. - 시나리오당 하나의 대화: 각 채팅은 그것이 다루는 시나리오에 속하므로, 새로 생성된 시나리오는 새로운 대화를 시작하고, 적용 후에도 전체 기록이 계속 표시됩니다. |
| Guided, Resilient Scenario Workflow | - 클릭 전 준비 상태 확인: 이제 모든 페이지가 아직 누락된 항목을 나열합니다 — 먼저 페이지 자체의 선택 사항, 그다음 불완전한 Setup 필드 — 그리고 아무것도 미충족 상태가 아닐 때까지 Generate를 비활성화 상태로 유지하므로, 클릭이 검증 오류를 발견하는 데 소비되는 일이 없습니다. - 행동 전 옵션: AI 강화 적대자 및 퍼플팀 토글이 Generate 위에 위치하며, 퍼플팀 옵션은 두 번째 모델 호출을 수행한다고 명시합니다. - 지출 전 확인: 생성이 시작되기 전에 프레임워크, 조직 프로필, 선택 사항, 수정자에 대한 한 줄 요약이 표시됩니다. - 탐색에도 살아남는 결과: 각 페이지는 세션 동안 자체 최신 결과, 이를 생성한 입력, 다운로드 이름을 유지합니다 — Assistant를 열었다가 돌아와도 시나리오, Navigator 레이어, Detection & Response 보고서가 여전히 있습니다. 양식을 편집하면 결과는 그대로 유지되며 선택 사항이 변경되었음을 알리는 메모가 표시됩니다. Regenerate와 Clear result는 명시적인 작업입니다. - 긴 시나리오에서 길 찾기: 전체 Markdown 위에 간결한 요약과 섹션 색인이 있으며, 인젝트, 토론 질문, 성공 기준, 지표, 아티팩트, 교전 규칙으로의 바로가기가 있습니다. - 유용한 빈 상태: 시나리오가 없으면 Assistant는 시나리오를 생성하는 세 가지 방법 모두로 연결되며, 시나리오가 있으면 논의 중인 시나리오의 이름을 밝히고 이를 생성한 페이지로 다시 연결됩니다. |
| Recover From a Failed or Slow Narrative | - 성공한 것은 유지: 선택적 퍼플팀 내러티브가 실패하거나 중단되면, 기본 시나리오, 그 다운로드, Navigator 레이어, 결정론적 Detection & Response 참조는 완전히 사용 가능한 상태로 유지되며, 무엇이 실패했는지 알리는 메시지가 표시됩니다. - 실패한 것만 재시도: Retry purple-team narrative는 두 번째 기본 시나리오 호출 없이 내러티브만 재실행하고, 이를 Detection & Response 보기와 다운로드에 병합합니다. 실패한 기본 시나리오는 Generate 시점에 캡처된 입력을 사용하여 자체 재시도를 제공합니다. - 계속 움직이는 타이머: 경과 시간이 이제 모델의 첫 토큰을 기다리는 동안에도 진행되므로, 긴 대기가 더 이상 멈춘 것처럼 보이지 않습니다. |
| Clearer Failures When Techniques Won't Load | - 실패는 실패로 보고됨: 기술 조회가 실패한 위협 그룹은 더 이상 기술이 없는 그룹으로 표시되지 않으며, Custom Scenarios는 목록 로드에 실패했을 때 더 이상 기술 선택기를 숨기고 기술을 선택하라고 요청하지 않습니다. - 막다른 길이 아닌 다음 단계: 두 차단 요소 모두 이제 실패에 대해 무엇을 할 수 있는지 알려줍니다. |
| Accessibility and Leaner Copy | - 키보드 및 스크린 리더 친화적: 아이콘 전용 컨트롤에 의미 있는 접근성 이름이 있고, 양식 레이블이 고유하며, 키보드 순서와 포커스가 가시적이고 논리적입니다. 레이아웃이 더 이상 휴대폰 너비에서 가로로 넘치지 않으며, 빈 테마 색상 콘솔 경고가 사라졌습니다. - CI에서 검사됨: 콘솔 위생과 접근성에 대한 실제 브라우저 스모크 테스트가 이제 모든 풀 리퀘스트에서 실행되고 릴리스 이미지를 게이트합니다. - 읽을 거리 감소: 시나리오 페이지는 더 이상 사전 점검 요약을 두 번째 확장기에 반복하거나 자체 상태 관리를 설명하지 않습니다. |
| Model Registry Refresh | - 최신 모델: 모델 목록이 각 제공자의 현재 문서에 맞춰 갱신되었습니다 — GPT-6 Astra가 OpenAI 목록의 선두에 서고, Claude Opus 5.5, Claude Opus 5, Claude Fable 5.1이 Anthropic 목록에 합류하며, Google은 Gemini 3.8 Flash와 Gemini 3.5 Flash Lite를 함께 얻었고, 각 경우에 연속성을 위해 이전 세대 하나가 유지됩니다. Anthropic의 목록은 이제 더 비싼 Fable 5.1 대신 Claude Opus 5.5 — 선택하지 않았을 때 사이드바의 기본값 — 를 선두로 합니다. - 은퇴한 항목 제거: 제공자가 대체하거나 종료한 id를 삭제했습니다 — Claude Opus 4.7 및 4.8(Opus 5.5가 등장하면 한 세대 이상 뒤처짐)과 Groq의 llama-3.3-70b-versatile 및 llama-3.1-8b-instant(둘 다 2026년 8월 16일 종료) — 따라서 사이드바가 Generate를 누른 후에만 오류를 내는 모델을 제공할 수 없습니다. Groq의 오픈 가중치 추론 등급은 이제 qwen/qwen3.8-27b입니다.- Temperature 규칙 정직하게 유지: supports_temperature는 각 Anthropic 모델의 실제 샘플링 동작에 따라 설정됩니다 — 4.7 이후의 모든 Claude는 사용자 정의 temperature를 거부하며, Haiku 4.5는 이를 허용하는 유일한 등록 모델로 남아 있습니다. 이를 보호하는 테스트는 이제 새로운 Anthropic 항목이 플래그를 누락할 때 실패하며, 누군가 수동으로 설정할 때만 실패하는 것이 아닙니다. |
| Platform & Security Housekeeping | - Python 3.11 최소 요구: Python 3.10은 더 이상 지원되지 않습니다. LiteLLM 1.98.0 이후 버전은 3.11부터만 존재하는 타이핑 기능을 가져옵니다. - 패치된 베이스 이미지: Docker 이미지가 현재의 python:3.14-slim에서 재빌드되어, Trivy가 표시한 Debian 베이스 이미지 CVE를 정리하며, perl-base의 세 가지 치명적 취약점을 포함합니다.- 실패한 호출의 실제 오류: tenacity가 이제 선언되어, 실패한 모델 호출이 tenacity 설치 지침 대신 제공자의 실제 오류(예: 잘못된 API 키)를 보고합니다.- 피드백은 시나리오와 함께 유지: 평가는 화면에 표시된 시나리오를 생성한 실행에 대해 기록되며, 다른 페이지의 최신 실행에 대해서는 결코 기록되지 않습니다. |