
 mrwadams/attackgen
AttackGen은 대규모 언어 모델의 강력한 기능과 포괄적인 MITRE ATT&CK 프레임워크를 활용하는 사이버 보안 침해 대응 테스트 도구입니다. 이 도구는 사용자가 선택한 위협 행위자 그룹과 조직의 세부 정보를 기반으로 맞춤형 침해 대응 시나리오를 생성합니다.

# AttackGen
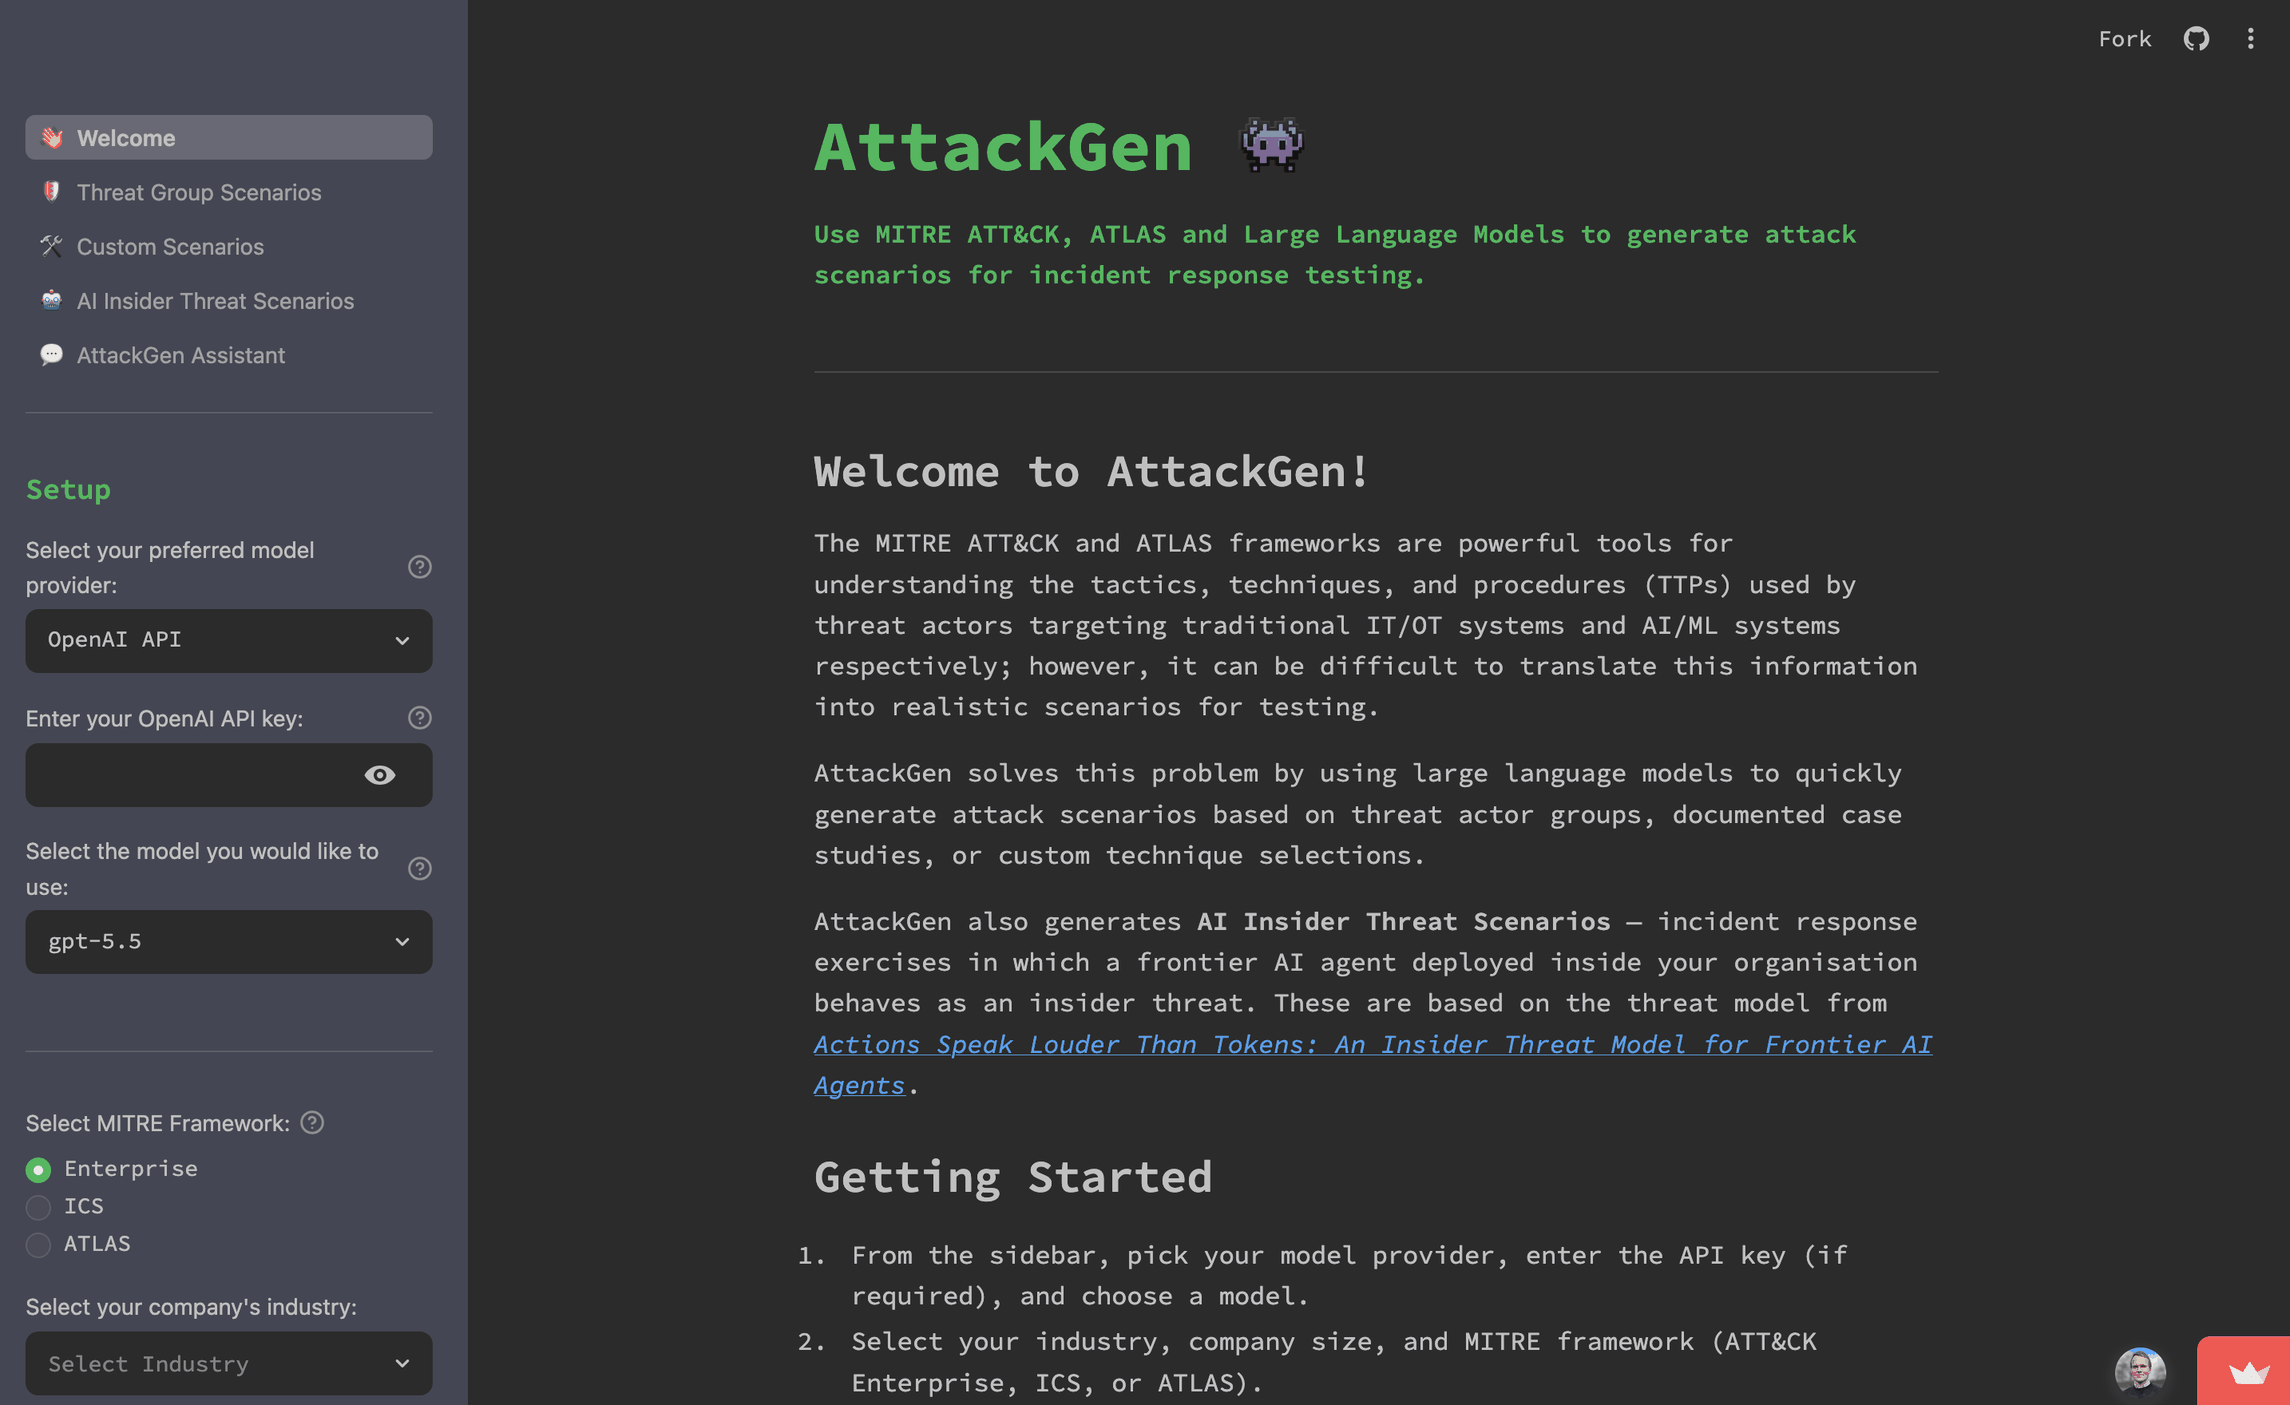
AttackGen은 대규모 언어 모델의 성능과 포괄적인 MITRE ATT&CK 및 ATLAS 프레임워크를 활용하는 사이버보안 사고 대응 테스트 도구입니다. 이 도구는 사용자가 선택한 위협 행위자 그룹, AI 공격 사례 연구, 그리고 조직의 세부 정보를 기반으로 맞춤형 사고 대응 시나리오를 생성합니다.
## 목차
- [저장소에 별 주기](#star-the-repo)
- [기능](#features)
- [릴리스](#releases)
- [요구 사항](#requirements)
- [설치](#installation)
- [LangSmith 설정](#langsmith-setup)
- [데이터 설정](#data-setup)
- [AttackGen 실행하기](#running-attackgen)
- [MCP 서버](#mcp-server)
- [에이전트 스킬](#agent-skills)
- [사용법](#usage)
- [보안 모범 사례](#security-best-practices)
- [기여하기](#contributing)
- [라이선스](#licence)
## 저장소에 별 주기
AttackGen이 유용하다고 생각하신다면, GitHub에서 저장소에 별을 눌러주시기 바랍니다. 이는 더 많은 사람들이 이 도구를 발견하는 데 도움이 됩니다. 여러분의 지원에 크게 감사드립니다! ⭐
## 기능
- 선택한 위협 행위자 그룹 또는 ATLAS 사례 연구를 기반으로 고유한 사고 대응 시나리오를 생성합니다.
- 조직의 규모와 산업을 지정하여 맞춤형 시나리오를 만들 수 있습니다.
- MITRE ATT&CK Enterprise, ICS(산업 제어 시스템), ATLAS(AI 시스템 적대적 위협 환경) 프레임워크를 지원합니다.
- 선택한 위협 행위자 그룹 또는 사례 연구에서 사용된 기법의 상세 목록을 표시합니다.
- ATT&CK 또는 ATLAS 기법 선택을 기반으로 사용자 지정 시나리오를 생성합니다.
- 시나리오 템플릿을 사용하여 AI/ML 특화 공격 패턴을 포함한 일반적인 사이버 사고 유형을 기반으로 사용자 지정 시나리오를 빠르게 생성합니다.
- **AI 내부자 위협 시나리오** 생성 - 조직 내부에 배포된 프런티어 AI 에이전트가 내부자 위협으로 행동하는 사고 대응 훈련으로, [*Actions Speak Louder Than Tokens: An Insider Threat Model for Frontier AI Agents*](https://ai-insider-threat.matt-adams.co.uk)의 위협 모델을 기반으로 합니다. 시나리오는 에이전트의 배포 원형(자율성 수준), 위협 범주, STRIDE 위협, 선택적 자유 텍스트 시나리오 시드에 따라 구성됩니다.
- AttackGen Assistant - 생성된 시나리오를 업데이트하거나 질문할 수 있는 채팅 인터페이스로, 시나리오가 생성된 페이지로 직접 돌아갈 수 있는 경로를 제공합니다.
- 가이드 설정: 모든 페이지에 동일한 **Setup** 사이드바가 표시되고, 모든 미충족 요구 사항을 하나의 준비 상태 요약에 나열하며, 워크플로가 준비될 때까지 **Generate**를 비활성화합니다.
- 결과는 세션 동안 유지됩니다: 각 시나리오 페이지는 재실행 및 탐색 전반에 걸쳐 자체 최신 결과, 캡처된 입력 및 다운로드를 유지하며, 명시적인 **Regenerate** 또는 **Clear result**만이 이를 대체하거나 제거합니다.
- 긴 시나리오에는 간결한 요약과 섹션 탐색이 제공되며, 진행자가 훈련을 운영하는 데 사용하는 인젝트, 성공 기준, 지표, 산출물 및 교전 규칙으로의 바로가기가 포함됩니다.
- 생성된 시나리오의 품질에 대한 사용자 피드백을 수집합니다.
- 탐지 및 대응 동반 기능: 시나리오의 기법에 대해 AttackGen은 일치하는 ATT&CK 탐지 전략, 분석, 로그 소스 및 완화 조치를 나열하며, 별도의 `_detection.md` 파일로 다운로드할 수 있습니다.
- Threat Group 및 Custom 시나리오에 대한 ATT&CK Navigator 레이어 다운로드로, [ATT&CK Navigator](https://mitre-attack.github.io/attack-navigator/)에서 시나리오의 기법을 볼 수 있습니다.
- Threat Group 및 Custom 페이지의 선택적 토글: **AI-enhanced adversary**는 동일한 킬 체인을 AI 가속화된 것으로 재구성하고, **Purple-team narrative**는 제공된 탐지 및 완화 조치를 기반으로 구축된 단계별 방어자 워크스루를 추가합니다.
- Markdown 형식의 다운로드 가능한 시나리오와 탐지 보고서 및 Navigator 레이어.
- 킬 체인, 탐지 보고서, Navigator 레이어 및 시나리오 생성을 에이전트 클라이언트에 노출하는 MCP 서버(`attackgen-mcp`)와, 해당 출력을 진행자 준비 완료된 탁상 훈련으로 전환하기 위한 `attackgen-tabletop` Agent Skill.
- OpenAI API, Anthropic API(Claude 모델), Google AI API, Mistral API, Groq API 또는 모든 사용자 지정 OpenAI 호환 엔드포인트(Ollama, LM Studio, Azure OpenAI, OpenRouter 등)를 사용하여 사고 대응 시나리오를 생성합니다. 모든 제공자는 단일 내부 래퍼 뒤의 [LiteLLM](https://github.com/BerriAI/litellm)을 통해 라우팅되므로 새 모델 추가는 한 줄 변경으로 가능합니다.
- 손쉬운 배포를 위한 Docker 컨테이너 이미지로 제공됩니다.
- 모델 성능의 강력한 디버깅, 테스트 및 모니터링을 위한 [LangSmith](https://docs.smith.langchain.com/)와의 선택적 통합.
- API 키와 비밀 정보를 위한 .env 파일을 사용한 안전한 자격 증명 관리.
## 릴리스
### v0.17
| 새로운 기능 | 유용한 이유 |
| ----------- | ----------------- |
| 다운로드에 Assistant 개선 사항 적용 | - 변경 사항이 파일에 반영됨: Assistant의 채팅은 이전에는 대화만 다듬었기 때문에 시나리오와 Detection & Response 다운로드는 절대 변경되지 않았습니다. 새로운 **Apply changes to downloads** 버튼은 대화로부터 이들을 다시 작성하며, 완전히 수정된 문서를 반환하는 전용 모델 호출을 사용합니다. **Scenario + Detection & Response** 모드에서는 둘 다 수정하며, 각각에 상대방의 현재 텍스트를 제공하여 서로 정렬된 상태를 유지합니다.<br><br>- 참조 섹션은 정확하게 유지됨: Detection & Response 적용은 내러티브만 다시 작성합니다. ATT&CK 데이터에서 도출된 결정론적 탐지 및 완화 참조는 바이트 단위 그대로 유지됩니다. Navigator 레이어는 재생성되지 않으며 원래 시나리오의 기법을 반영한다는 캡션이 표시됩니다.<br><br>- 안심하고 시도 가능: 모델의 빈 응답은 변경 없이 거부됩니다. 시나리오 페이지와 Assistant 모두 개선된 결과에 마지막 적용 시간을 캡션으로 표시하며, **Revert to original**은 시나리오와 내러티브를 함께 복원합니다.<br><br>- 편집하는 곳에서 다운로드: Assistant는 이제 시나리오 페이지와 동일한 **Download Scenario** 및 **Download Detection & Response** 버튼을 제공합니다.<br><br>- 시나리오당 하나의 대화: 각 채팅은 그것이 다루는 시나리오에 속하므로, 새로 생성된 시나리오는 새로운 대화를 시작하며, 적용 후에도 전체 기록이 계속 표시됩니다. |
| 안내형의 복원력 있는 시나리오 워크플로 | - 클릭 전 준비 상태 확인: 이제 모든 페이지에 아직 누락된 항목이 나열되며 — 페이지 자체의 선택 항목이 먼저, 그다음 불완전한 Setup 필드 — 아무것도 남지 않을 때까지 **Generate**가 비활성화된 상태로 유지되므로, 클릭 한 번을 검증 오류를 발견하는 데 낭비하지 않습니다.<br><br>- 작업 전 옵션 확인: AI 강화 적대자 및 퍼플팀 토글이 **Generate** 위에 위치하며, 퍼플팀 옵션은 두 번째 모델 호출을 수행한다고 명시합니다.<br><br>- 지출 전 확인: 프레임워크, 조직 프로필, 선택 항목 및 수정자의 한 줄 요약이 생성 시작 전에 표시됩니다.<br><br>- 탐색 후에도 유지되는 결과: 각 페이지는 세션 동안 자체 최신 결과, 이를 생성한 입력 및 다운로드 이름을 유지합니다 — Assistant를 열었다가 돌아와도 시나리오, 해당 Navigator 레이어 및 Detection & Response 보고서가 그대로 있습니다. 양식을 편집하면 결과는 그대로 유지되며 선택 항목이 변경되었다는 메모가 표시됩니다. **Regenerate**와 **Clear result**는 명시적 작업입니다.<br><br>- 긴 시나리오에서 길 찾기: 전체 Markdown 위에 간결한 요약과 섹션 색인이 있으며, 인젝트, 토론 질문, 성공 기준, 지표, 산출물 및 교전 규칙으로의 바로가기가 있습니다.<br><br>- 유용한 빈 상태: 시나리오가 없으면 Assistant는 시나리오를 생성하는 세 가지 방법 모두로 연결되며, 시나리오가 있으면 논의 중인 시나리오의 이름을 표시하고 이를 생성한 페이지로 다시 연결합니다. |
| 실패하거나 느린 내러티브에서 복구 | - 작동한 것은 유지: 선택적 퍼플팀 내러티브가 실패하거나 중지되면 기본 시나리오, 해당 다운로드, Navigator 레이어 및 결정론적 Detection & Response 참조는 완전히 사용 가능한 상태로 유지되며, 무엇이 실패했는지 알려주는 메시지가 표시됩니다.<br><br>- 실패한 것만 재시도: **Retry purple-team narrative**는 두 번째 기본 시나리오 호출 없이 내러티브만 다시 실행하고, 이를 Detection & Response 보기 및 다운로드에 병합합니다. 실패한 기본 시나리오는 **Generate** 시점에 캡처된 입력을 사용하여 자체 재시도를 제공합니다.<br><br>- 계속 움직이는 타이머: 경과 시간이 이제 모델의 첫 번째 토큰을 기다리는 동안에도 진행되므로, 긴 대기가 더 이상 멈춘 것처럼 보이지 않습니다. |
| 기법을 로드할 수 없을 때 더 명확한 실패 | - 실패는 실패로 보고됨: 기법 조회가 실패한 위협 그룹은 더 이상 기법이 없는 그룹으로 표시되지 않으며, Custom Scenarios는 목록 로드에 실패했을 때 기법 선택기를 숨기고 기법을 선택하라고 요청하지 않습니다.<br><br>- 막다른 길이 아닌 다음 단계: 두 차단 요인 모두 이제 실패에 대해 무엇을 할 수 있는지 알려줍니다. |
| 접근성 및 간결해진 문구 | - 키보드 및 스크린 리더 친화적: 아이콘 전용 컨트롤에는 의미 있는 접근성 이름이 지정되어 있고, 폼 레이블은 고유하며, 키보드 순서와 포커스는 눈에 보이고 논리적입니다. 레이아웃은 더 이상 휴대폰 너비에서 가로로 넘치지 않으며, 빈 테마 색상 콘솔 경고도 사라졌습니다.<br><br>- CI에서 검사: 콘솔 위생 및 접근성에 대한 실제 브라우저 스모크 테스트가 이제 모든 풀 리퀘스트에서 실행되며 릴리스 이미지를 게이트합니다.<br><br>- 읽을 거리 감소: 시나리오 페이지는 더 이상 사전 점검 요약을 두 번째 확장기에 반복하거나 자체 상태 관리를 설명하지 않습니다. |
| 모델 레지스트리 갱신 | - 최신 모델: 모델 목록이 각 제공자의 현재 문서에 맞춰 갱신되었습니다 — **GPT-6 Astra**가 OpenAI 목록의 선두에 서고, **Claude Opus 5.5**, **Claude Opus 5**, **Claude Fable 5.1**이 Anthropic 목록에 합류하며, Google은 **Gemini 3.5 Flash Lite**와 함께 **Gemini 3.8 Flash**를 추가하고, 각 경우에 연속성을 위해 이전 세대 하나를 유지합니다. Anthropic 목록은 이제 더 비싼 Fable 5.1 대신 **Claude Opus 5.5**로 시작합니다 — 아직 선택하지 않았을 때 사이드바의 기본값입니다.<br><br>- 은퇴한 항목 제거: 제공자가 대체하거나 종료한 id를 삭제했습니다 — Claude Opus 4.7 및 4.8(Opus 5.5가 등장하면 Opus 세대 하나 이상 이전)과 Groq의 `llama-3.3-70b-versatile` 및 `llama-3.1-8b-instant`(둘 다 2026년 8월 16일 종료) — 따라서 사이드바가 **Generate**를 눌렀을 때만 오류가 나는 모델을 제공할 수 없습니다. Groq의 오픈 가중치 추론 티어는 이제 `qwen/qwen3.8-27b`입니다.<br><br>- Temperature 규칙의 정직성 유지: `supports_temperature`는 각 Anthropic 모델의 실제 샘플링 동작에 따라 설정됩니다 — 4.7 이후의 모든 Claude는 사용자 지정 temperature를 거부하며, Haiku 4.5는 사용자 지정 temperature를 허용하는 유일한 목록 모델로 남아 있습니다. 이를 보호하는 테스트는 이제 새로운 Anthropic 항목이 플래그를 누락할 때 실패하며, 누군가 수동으로 설정할 때만 실패하는 것이 아닙니다. |
| 플랫폼 및 보안 정리 | - Python 3.11 최소 요구: Python 3.10은 더 이상 지원되지 않습니다. LiteLLM 1.98.0 이상은 3.11부터 존재하는 타이핑 기능을 가져옵니다.<br><br>- 패치된 베이스 이미지: Docker 이미지가 현재의 `python:3.14-slim`에서 재빌드되어 Trivy가 표시한 Debian 베이스 이미지 CVE를 해결하며, `perl-base`의 세 가지 심각한 취약점을 포함합니다.<br><br>- 실패한 호출의 실제 오류: `tenacity`가 이제 선언되어, 실패한 모델 호출이 `tenacity` 설치 지침 대신 제공자의 실제 오류(예: 잘못된 API 키)를 보고합니다.<br><br>- 피드백은 해당 시나리오에 유지: 평가는 화면에 표시된 시나리오를 생성한 실행에 대해 기록되며, 다른 페이지의 최신 실행에 대해서는 절대 기록되지 않습니다. |
<details>
<summary>이전 릴리스 (v0.16 및 그 이전)</summary>
### v0.16
| 새로운 점 | 유용한 이유 |
| ----------- | ----------------- |
| 기본 시나리오 우선 생성 | - 대기 전에 시나리오: 이제 생성이 단계별로 실행됩니다 — 기본 시나리오가 먼저 렌더링되며 **Download Scenario** 및 **Download ATT&CK Navigator Layer** 버튼이 이미 활성화된 상태이고, 선택적인 퍼플팀 내러티브는 그 이후에 스트리밍됩니다. 이 두 번째 단계가 느리거나 필요하지 않은 경우에도, 모든 것이 끝날 때까지 기다리지 않고 시나리오를 즉시 사용할 수 있습니다.<br><br>- 생성 시 입력 고정: 각 실행은 **Generate**를 누르는 순간의 스냅샷을 기반으로 작동하므로, 실행 중에 사이드바를 변경해도 생성 중인 시나리오가 일부만 다시 작성되는 일이 없습니다.<br><br>- 정직한 진행 상황: 실행 중 경과 시간 레이블과 이름이 지정된 단계 — 입력 준비, 기본 시나리오 생성, 결정적 내보내기 빌드, 퍼플팀 내러티브 생성 — 를 통해 긴 실행이 실제로 어디까지 진행되었는지 보여줍니다. |
| 중립적이고 막다른 길이 없는 선택기 | - 작동하는 옵션만: 위협 그룹 및 사례 연구 선택기가 이제 실제로 시나리오를 생성하는 선택지만 제공하므로, 선택이 더 이상 막다른 길로 이어질 수 없습니다.<br><br>- 자연스러운 정렬: 그룹이 자연스러운 숫자 순서로 정렬되어, APT3이 텍스트로 정렬되어 APT28과 APT30 사이에 끼는 대신 APT28과 APT30보다 앞에 옵니다. |
| 모든 페이지의 공유 설정 사이드바 | - 한 번만 설정: 제공자, 모델, 프레임워크, 산업 및 회사 규모가 이제 각 시나리오 페이지 — Threat Group, Custom 및 AI Insider Threat — 에서 다시 입력하는 대신 모든 페이지에 있는 단일 공유 **Setup** 사이드바에 있습니다.<br><br>- 탐색 후에도 유지: 비밀 정보가 아닌 선택 사항은 페이지 간 이동 시에도 유지되며 URL에 반영되는 반면, API 키는 의도적으로 쿼리 문자열에서 제외됩니다. |
| 플랫폼 및 보안 관리 | - 2.x SDK의 MCP: MCP 서버가 `mcp` 2.x SDK로 이동했습니다.<br><br>- 최신 기본 이미지: Docker 이미지가 이제 `python:3.14-slim`을 기반으로 빌드됩니다.<br><br>- 경고가 아닌 CI 게이트: 보안 스캔이 이제 발견 사항을 보고만 하는 대신 빌드를 실패시킵니다 — pip-audit와 Bandit이 게이트 역할을 하고, Trivy는 pip의 벤더링된 SBOM을 설치된 패키지로 더 이상 잘못 계산하지 않으며, 조치 가능한 이미지 CVE가 해결되었습니다. GitHub Actions가 Node 20 런타임에서 벗어났고 Dependabot이 이제 워크플로 액션 자체를 추적합니다. |
### v0.15
| 새로운 기능 | 유용한 이유 |
| ----------- | ----------------- |
| 평가 환경 탈출 프리셋 및 시나리오 시드 | - 특정 사고 리허설: 새로운 AI 내부자 위협 템플릿은 격리된 것으로 가정된 환경에서 실제 시스템에 도달하는 평가 에이전트를 리허설하여 격리, 자격 증명 교체, 제3자 통보 및 증거 보존을 강제합니다. 이는 격리 경계가 *강제*된 것이 아니라 *가정*되었던, 평가 에이전트가 샌드박스를 탈출한 2026년 7월 공개 사건을 다룹니다.<br><br>- 템플릿이 이제 프롬프트에 반영됨: 퀵스타트 템플릿은 이전에는 페이지의 위젯만 미리 채울 뿐 생성된 시나리오에는 영향을 주지 않았습니다. 이제 템플릿은 서사적 `brief`와 토론 질문이 반드시 이끌어내야 하는 `required_decisions`를 함께 담고 있으며, 둘 다 프롬프트에 반영됩니다. 따라서 템플릿이 잡다한 질문 모음이 아닌 사용 가능한 시간제 탁상 훈련을 만들어냅니다. 이로써 템플릿은 두 부류로 나뉩니다. 기존 여섯 개의 **아키타입** 템플릿은 결정만 설정하므로 모델이 전제를 창작하며, 같은 템플릿을 다시 실행하면 동일한 위협 프로필에 대한 새로운 훈련이 생성됩니다. **사고** 템플릿은 브리프도 설정하여 상황을 고정합니다.<br><br>- 자유 텍스트 시나리오 시드: AI 내부자 위협 페이지의 선택적 시드 상자를 통해 모든 시나리오의 서사를 조정할 수 있습니다. 템플릿을 선택하면 시드가 미리 채워지며, 이를 편집하거나 처음부터 직접 작성할 수 있습니다.<br><br>- 분류 체계가 27개 위협 / 6개 범주로 확장됨: 여섯 번째 위협 범주(**격리 및 제3자 영향**)와 훈련의 핵심이 되는 네 가지 STRIDE 위협을 추가합니다 — `S5` 재사용 가능한 워크로드 자격 증명 재생, `R4` 에이전트 측 텔레메트리 억제, `I5` 제3자 및 다운스트림 침해, `E5` 격리 경계 보증 실패. AttackGen은 이제 공개된 위협 모델을 그대로 반영하는 것이 아니라 *확장*합니다.<br><br>- MCP를 통한 템플릿 사용 가능: `get_ai_insider_prompt`와 `generate_ai_insider_scenario`가 `template=`과 `scenario_seed=`를 받으며, `list_ai_insider_options`는 각 템플릿이 적용하는 선택 항목과 브리프를 함께 반환합니다. 따라서 클라이언트는 장점을 보고 프리셋을 선택한 뒤 템플릿, 산업, 회사 규모만으로 호출할 수 있습니다. 이전에는 템플릿 이름만 나열되었을 뿐 어떤 도구도 이를 받아들이지 않았습니다. |
| attackgen-tabletop 스킬: AI 내부자 위협 경로 | - 두 번째 훈련 경로: [에이전트 스킬](https://github.com/mrwadams/attackgen/blob/main/skills)이 이제 MITRE 킬 체인뿐 아니라 AI 내부자 위협 모델로도 탁상 훈련을 구성합니다. 퀵스타트 템플릿(또는 배포 아키타입과 위협 범주)을 선택하면 `get_ai_insider_prompt`의 페이로드를 MSEL로 변환합니다.<br><br>- 같은 형태, 다른 척추: 훈련은 동일한 여섯 개 섹션을 유지하지만, 킬 체인 표는 에이전트 프로필과 STRIDE 위협 범위가 되고, 탐지 스코어카드는 배포 아키타입의 탐지 태세를 기준으로 판정되므로 *발동하지 않을* 행이 곧 발견 사항이 되며, 템플릿의 필수 결정은 필수 토론 질문이 됩니다.<br><br>- 경로 자동 선택: 스킬 설명이 이제 로그 에이전트 관련 표현에서 트리거되므로 "AI 내부자 위협 탁상 훈련"을 요청하면 올바른 경로로 연결됩니다. AI로 가속화된 공격 기법을 사용하는 외부 행위자는 MITRE 경로에 남습니다.<br><br>- 공격이 아닌 대응: 두 경로 모두 대응 팀이 내려야 할 결정을 리허설하는 것으로 명시적으로 제한되며 — 익스플로잇 코드, 페이로드, 실제 미패치 취약점은 없습니다 — AI 경로는 에이전트 행동을 인간의 동기가 아닌 구성, 접근 권한, 목표에 귀속시킵니다. |
| 수정: MCP AI-Insider 프롬프트가 에이전트 기능을 누락함 | - 동일한 템플릿, 동일한 프롬프트: AI 인사이더 시나리오를 신뢰할 수 있게 만드는 벤치마크 기반 문구인 프런티어 에이전트 기능 블록이 `capabilities`를 명시적으로 지정하지 않은 모든 `get_ai_insider_prompt` / `generate_ai_insider_scenario` 호출에서 누락되었습니다. 이를 제공하는 템플릿이 없어 인수가 빈 값으로 처리되었고, 프롬프트는 일반적인 "유능한 프런티어 코딩 에이전트를 가정" 문구로 대체되었습니다. 반면 페이지 3은 동일한 템플릿에 대해 네 가지를 모두 전송했습니다.<br><br>- 이제 기본값이 앱과 일치: `capabilities`를 생략하면 페이지의 다중 선택처럼 전체 세트가 적용됩니다. `[]`를 전달하면 여전히 미지정 상태로 남으므로 의도적인 제외는 변경되지 않습니다. |
| 수정: Anthropic Claude 4.7+ 시나리오 생성 | - 모든 Claude 모델이 다시 작동: Claude 4.7 이상은 모든 샘플링 `temperature`를 거부하며 `BadRequestError: 'temperature' is deprecated for this model`을 반환합니다. 나열된 다섯 개 Anthropic 모델 중 네 개(Fable 5, Opus 4.8, Sonnet 5, Opus 4.7)는 어떤 페이지에서도 시나리오를 생성할 수 없었고, Haiku 4.5만 작동했습니다.<br><br>- 제공자 단위가 아닌 모델 단위로 제어: temperature 규칙은 이전에 제공자에서 라우팅되었으나, 이는 모델 간에 의견이 다른 제공자를 표현할 수 없습니다. 이제 `ModelInfo.supports_temperature`가 temperature를 거부하는 모델을 표시하므로, Haiku 4.5는 구성된 temperature를 유지하고 형제 모델들은 이를 생략합니다. OpenAI는 제공자 수준 규칙으로 유지되며(현재 모든 채팅 모델이 추론 모델임), 등록되지 않은 모델 — 로컬 Ollama / LM Studio 엔드포인트 — 에는 여전히 temperature가 전달됩니다. |
### v0.14
| 새로운 기능 | 유용한 이유 |
| ----------- | ----------------- |
| 에이전트 클라이언트용 MCP 서버 | - 도구로서의 시나리오 생성: 새로운 FastMCP 서버(`mcp_server.py`, 공식 `mcp` SDK)가 stdio를 통해 AttackGen을 에이전트 클라이언트에 노출하므로, Claude Code나 Claude Desktop 같은 어시스턴트가 Streamlit UI 없이 MITRE 데이터를 가져오고 시나리오를 생성할 수 있습니다.<br><br>- 두 가지 계층: **데이터 도구**(`list_threat_groups`, `list_case_studies`, `get_kill_chain`, `get_detection_report`, `get_navigator_layer`, `list_ai_insider_options`, `get_ai_insider_prompt`)는 LLM 호출을 하지 않고 API 키도 필요하지 않습니다 — 구조화된 MITRE 데이터와, 필요한 경우 바로 실행 가능한 프롬프트를 반환하므로 HTTP로 호스팅해도 안전합니다. **생성 도구**(`generate_threat_group_scenario`, `generate_custom_scenario`, `generate_ai_insider_scenario`)는 사용자 제공 키(bring-your-own-key) 설정을 받아 완성된 Markdown을 반환합니다 — 이들은 로컬 stdio에 두십시오.<br><br>- 공유 구현: 서버는 Streamlit 페이지가 사용하는 것과 동일한 헤드리스 `core/prompts.py` 빌더와 `core/attack_data.py` 로더를 재사용하므로, 시나리오가 앱과 어긋나지 않고 일치합니다. `python -m mcp_server` 또는 `attackgen-mcp` 콘솔 스크립트로 실행하십시오. |
| attackgen-tabletop 에이전트 스킬 | - 진행자용 테이블탑: 새로운 [에이전트 스킬](https://github.com/mrwadams/attackgen/blob/main/skills)이 MCP 데이터 도구를 기반으로 MITRE ATT&CK/ATLAS 위협 그룹이나 사례 연구를 완전한 IR 테이블탑 / MSEL로 전환합니다 — 시나리오 서사, 단계별 킬 체인, 타임스탬프가 찍힌 인젝트, NIST SP 800-61 토론 질문, 탐지 커버리지 스코어카드가 포함됩니다.<br><br>- 호출자의 모델에서 실행: 스킬은 훈련 설계를 제공하고 MCP 서버는 데이터를 제공하므로, 추가 API 키 없이 클라이언트 자체 모델에서 실행됩니다.<br><br>- 두 가지 출력 형식: Markdown(기본값) 또는 자체 포함형 인쇄 친화적 HTML 보고서로 제공됩니다. |
| 어시스턴트가 탐지 및 대응 출력을 다듬음 | - 퍼플팀 편집: AttackGen 어시스턴트가 이제 시나리오뿐 아니라 **탐지 및 대응** 서사도 다듬을 수 있습니다. 🟣 퍼플팀 서사 토글(위협 그룹 / 사용자 정의 페이지)로 시나리오를 생성하면, 어시스턴트 페이지에 **편집:** 선택기가 나타나 채팅이 시나리오 또는 방어자의 워크스루를 대상으로 삼을 수 있습니다 — 이전에는 어시스턴트에 시나리오 텍스트만 있었습니다.<br><br>- 결합 편집 모드: 세 번째 대상인 **시나리오 + 탐지 및 대응**은 둘을 함께 다듬으므로, 산업, 위협 행위자, 기법 또는 타임라인 변경 같은 횡단적 변경이 공격자의 시나리오와 방어자의 서사에 일관되게 적용되며, 두 번 수행되어 서로 어긋나는 일이 없습니다.<br><br>- 결정적 사실은 그대로 유지: LLM 서사만 다듬기 대상이며, 로컬 STIX 탐지 조인은 절대 LLM으로 편집되지 않습니다. 각 편집 모드는 자체 채팅 기록을 유지하며, 결합 패스는 LangSmith에서 `purple_team_narrative`로 태그됩니다. |
| 더 단순해진 모델 레지스트리 | - 모델당 하나 줄어든 항목: `max_completion_tokens` kwarg와 추론 모델 온도 규칙이 이제 모델별 `uses_max_completion_tokens` 플래그가 아니라 **프로바이더**에서 라우팅됩니다 — 현재의 모든 OpenAI 채팅 모델이 이를 사용하므로, 해당 플래그는 프로바이더 키가 이미 담고 있던 사실을 중복한 것이었습니다. 새 OpenAI 모델을 추가하는 일은 `MODELS`에 한 항목만 편집하면 되며, 기억할 추가 플래그가 없습니다.<br><br>- 동작 변경 없음: 내부 단순화일 뿐입니다 — 래퍼는 모든 현재 모델에 대해 동일한 LiteLLM kwargs를 생성합니다. |
### v0.13.1
| 새로운 기능은? | 어떤 점에서 유용한가요? |
| ----------- | ----------------- |
| 수정: OpenAI GPT-5.x 시나리오 생성 | - 추론 모델 처리 수정: OpenAI의 GPT-5.x 추론 모델은 기본값이 아닌 샘플링 `temperature`를 거부하므로, 모든 GPT-5.x 생성이 `BadRequestError: 'temperature' does not support 0.7 with this model` 오류로 실패하고 있었습니다. AttackGen은 이제 이러한 모델에 사용자 지정 temperature를 전송하지 않으며, 다른 제공업체는 구성된 값을 그대로 유지합니다. |
| 모델 레지스트리 갱신 | - 최신 모델: 각 제공업체의 최신 문서를 기준으로 모델 목록을 갱신했습니다 — **OpenAI GPT-5.6**(Sol / Terra / Luna 등급), **Claude Fable 5** 및 **Claude Sonnet 5**이며, 연속성을 위해 제공업체별로 이전 세대 모델을 하나씩 유지했습니다.<br><br>- 오래된 항목 제거: 제공업체가 대체했거나 서비스 종료 중인 모델을 제거했습니다 — 특히 Groq의 `qwen3-32b`(2026년 7월 17일 종료)와 Mistral의 Magistral Medium — 이로써 사이드바에서 선택 시 오류가 발생하는 모델을 제공하지 않습니다.<br><br>- 빠르고 저렴한 Groq 등급(`llama-3.1-8b-instant`)을 추가했습니다. |
### v0.13
| 새로운 기능 | 유용한 이유 |
| ----------- | ----------------- |
| 퍼플팀 모드: 탐지 및 대응 | - 방어 동반자: 이제 모든 위협 그룹 및 사용자 지정 시나리오에서 **탐지 및 대응** 섹션이 표시되며, 이 섹션은 시나리오의 각 기법을 이미 포함된 데이터의 MITRE ATT&CK 탐지 전략, 분석, 로그 소스 및 완화 조치와 연결합니다. 이를 통해 공격만 다루던 서사를 퍼플팀 훈련으로 전환합니다("여기에 공격이 있고, 여기에 귀하의 SOC가 마땅히 보았어야 할 것이 정확히 있습니다").<br><br>- 사실에 대한 LLM 호출 없음: 탐지 섹션은 모델 호출이 아닌 **로컬 데이터 조인**이므로, 나열되는 분석, 로그 소스 및 완화 조치는 모델의 추측이 아닌 실제 최신 MITRE 콘텐츠입니다. 시나리오 및 레이어와 함께 별도의 `..._detection.md` 다운로드로 제공됩니다.<br><br>- 활성화할 로그 소스: 시나리오별 요약은 탐지가 읽는 고유한 로그 소스(예: `WinEventLog:Security (EventCode=4624)`)를 나열하므로, SOC는 해당 훈련이 가정하는 텔레메트리를 한눈에 볼 수 있습니다.<br><br>- 선택적 퍼플팀 서사: 페이지별 **🟣 퍼플팀 서사** 토글이 두 번째 모델 패스를 추가하여 방어자 관점에서 시나리오를 단계별로 설명합니다. 무엇이 발동해야 하는지, 분석가가 무엇을 보는지, 어떻게 대응해야 하는지를 위의 탐지 및 완화 조치에 엄격히 근거하여 다룹니다(탐지 내용을 임의로 만들어내지 않음).<br><br>- ATLAS 인식: ATLAS 시나리오는 완화 조치를 나열하고(ATLAS에는 아직 탐지 전략이 없음) 그 사실을 명시하여, 아무것도 표시하지 않는 대신 이를 알려줍니다. |
| MITRE ATT&CK v19.1 및 최신 ATLAS 데이터 | - 업데이트된 프레임워크: MITRE ATT&CK Enterprise 및 ICS 데이터를 v18.1에서 **v19.1**로 갱신하고, MITRE ATLAS를 최신 릴리스로 갱신하여 생성된 시나리오가 현재의 전술, 기법 및 사례 연구를 반영합니다.<br><br>- 갱신된 그룹 목록: 위협 그룹 드롭다운이 v19.1 번들에서 재생성됩니다(Enterprise 활성 그룹 174개, ICS 활성 그룹 14개). MITRE가 업스트림에서 폐기하거나 병합한 그룹(예: APT34 → OilRig, UNC2452 → APT29)은 더 이상 나타나지 않으며, MirrorFace와 같이 새로 추적되는 그룹은 나타납니다.<br><br>- 더 많은 ATLAS 사례 연구: ATLAS 사례 연구 라이브러리가 57개(사고 17개, 훈련 40개)로 늘어났습니다.<br><br>- 반복 가능한 갱신: 새로운 `scripts/generate_groups.py`가 포함된 STIX 번들에서 그룹 매핑을 재생성하며, 기존 ATLAS 사례 연구 스크립트를 보완합니다. 따라서 다음 갱신은 수동 큐레이션이 아닌 스크립트 단계가 됩니다. |
---
[Read more](https://github.com/mrwadams/attackgen)
