
 #1
LLM security, prompt injection, model extraction, adversarial AI, and AI red teaming tools.
Kitploit 추천

 foxcornlab/thc-bloodmiami
C로 작성된 AI 챗박스 모의해킹 도구: 채팅 인터페이스에 언어 기반(SQLi/NoSQL/XSS/SSTI) 및 프롬프트 인젝션 페이로드를 발사하고, 실제로 먹히는 페이로드를 표시합니다
 owasp/agentic-evidence
에이전틱 AI 보안 증거를 위한 OWASP 참조 프로젝트: 에이전트 실행, 신원, 도구 호출, 권한 부여 결정을 조사 타임라인과 내보낼 수 있는 증거 번들로 상호 연관시킵니다.
 owasp/agentic-vulnerability-discovery-and-validation-harness
취약점 발견 및 검증을 자동화하고, 악용 가능한 발견 사항을 확인하기 위해 AI 기반 분석 워크플로를 조정하는 에이전트형 하네스입니다.
 owasp/llmsec
대규모 언어 모델 애플리케이션의 보안에 초점을 맞춘 OWASP 프로젝트로, LLM 특유의 위험, 테스트 지침, 완화 방안을 다룹니다.
 owasp/robotics-security-testing-guide
OWASP guide defining a standardized penetration testing methodology for humanoid, industrial, and autonomous robots, covering ROS/ROS2, DDS, CAN bus,…
 owasp/the-agents-epistemic-baggage
에이전트가 생성한 추론이 지속적인 메모리를 통해 인식론적 지위를 바꾸고 운영 권한을 획득하며 이후의 의사결정에 영향을 미칠 수 있는 방식을 다루는 감사 중심의 위험 모델입니다.
 cdxgen/cdxgen
Creates CycloneDX Bill of Materials (BOM) for your projects from source and container images. Supports many languages and package managers. Integrate…
 trailofbits/brotli-checker
Brotli의 잠재적 취약 사본을 찾고 CVE-2026-111497에 대한 업데이트를 안내하는 Claude Code 및 Codex 스킬입니다.
 gmh5225/ollama-hunter
Shodan에서 공개적으로 노출된 Ollama 및 llama.cpp 서버를 스캔하여 보안 연구를 위해 호스트, 위치 및 사용 가능한 모델을 열거합니다.
 asngs/agenttriage-open-source
도구를 사용하는 LLM 에이전트를 위한 교차 에이전트 추적 및 보안 진단 시스템으로, 추적 이벤트를 정규화하고, 출처 그래프를 구축하며, 소스-투-싱크 체인을 추출하고, 방어 격차를 귀속시킵니다.
 suels-group/beyond_asr
LLM을 대상으로 한 탈옥 공격 성공률(ASR 및 단계별 ASR)을 측정하기 위한 연구 코드로, GCG와 같은 공격의 구현 및 평가 스크립트를 포함합니다.
 pedrobarcha/memory-injection
Claude, Gemini, ChatGPT의 메모리 기능을 통한 지속적 프롬프트 인젝션 연구로, 재현 단계, 데이터셋, 그리고 프라이버시·무결성·가용성 공격에 대한 증명을 포함합니다.
 xhyumiracle/sudp
에이전트 시스템을 위한 프로토콜 수준 비밀 사용 — 비밀 사용 위임 프로토콜
 lassnajmuldeen/balcony-jailbreaking
초기 종료 깊이 LLM 전반에 걸친 탈옥 취약점. NeurIPS 2026 FLMSec 워크숍에서 발표됨
 owasp/xpsd
취약점 스캔을 위한 도달 가능성 분류. 스캐너 결과를 LLM 에이전트에 전달하여 소스를 읽고 실제로 도달 가능한 CVE를 판별합니다.
 ericyoc/ai-security-literacy
공개 벤치마크와 설문 마이크로데이터를 기반으로 여섯 가지 AI 보안 리터러시 역량 차원을 정립하고, 그림, 표, 재개 가능한 결과물을 생성하는 재현 가능한 Colab 파이프라인입니다.
 tencent-hunyuan/diagsafe
Diagnostic LLM safety benchmark with 3,489 bilingual prompts, an 84-label taxonomy, and prompt-level rubric judging for explainable, fine-grained…
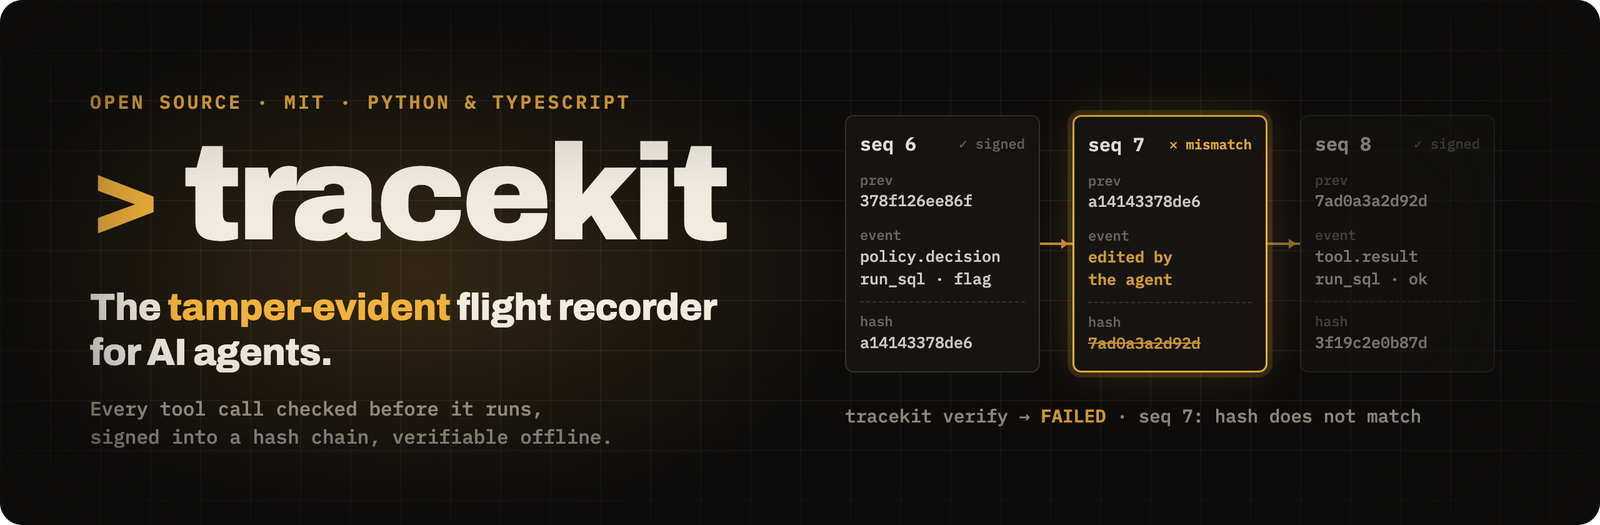 cygnux-labs/tracekit
Tamper-evident tracing, policy gates and cross-checks for AI agents: see what the agent did, and why.








