 pikpikcu/airecon
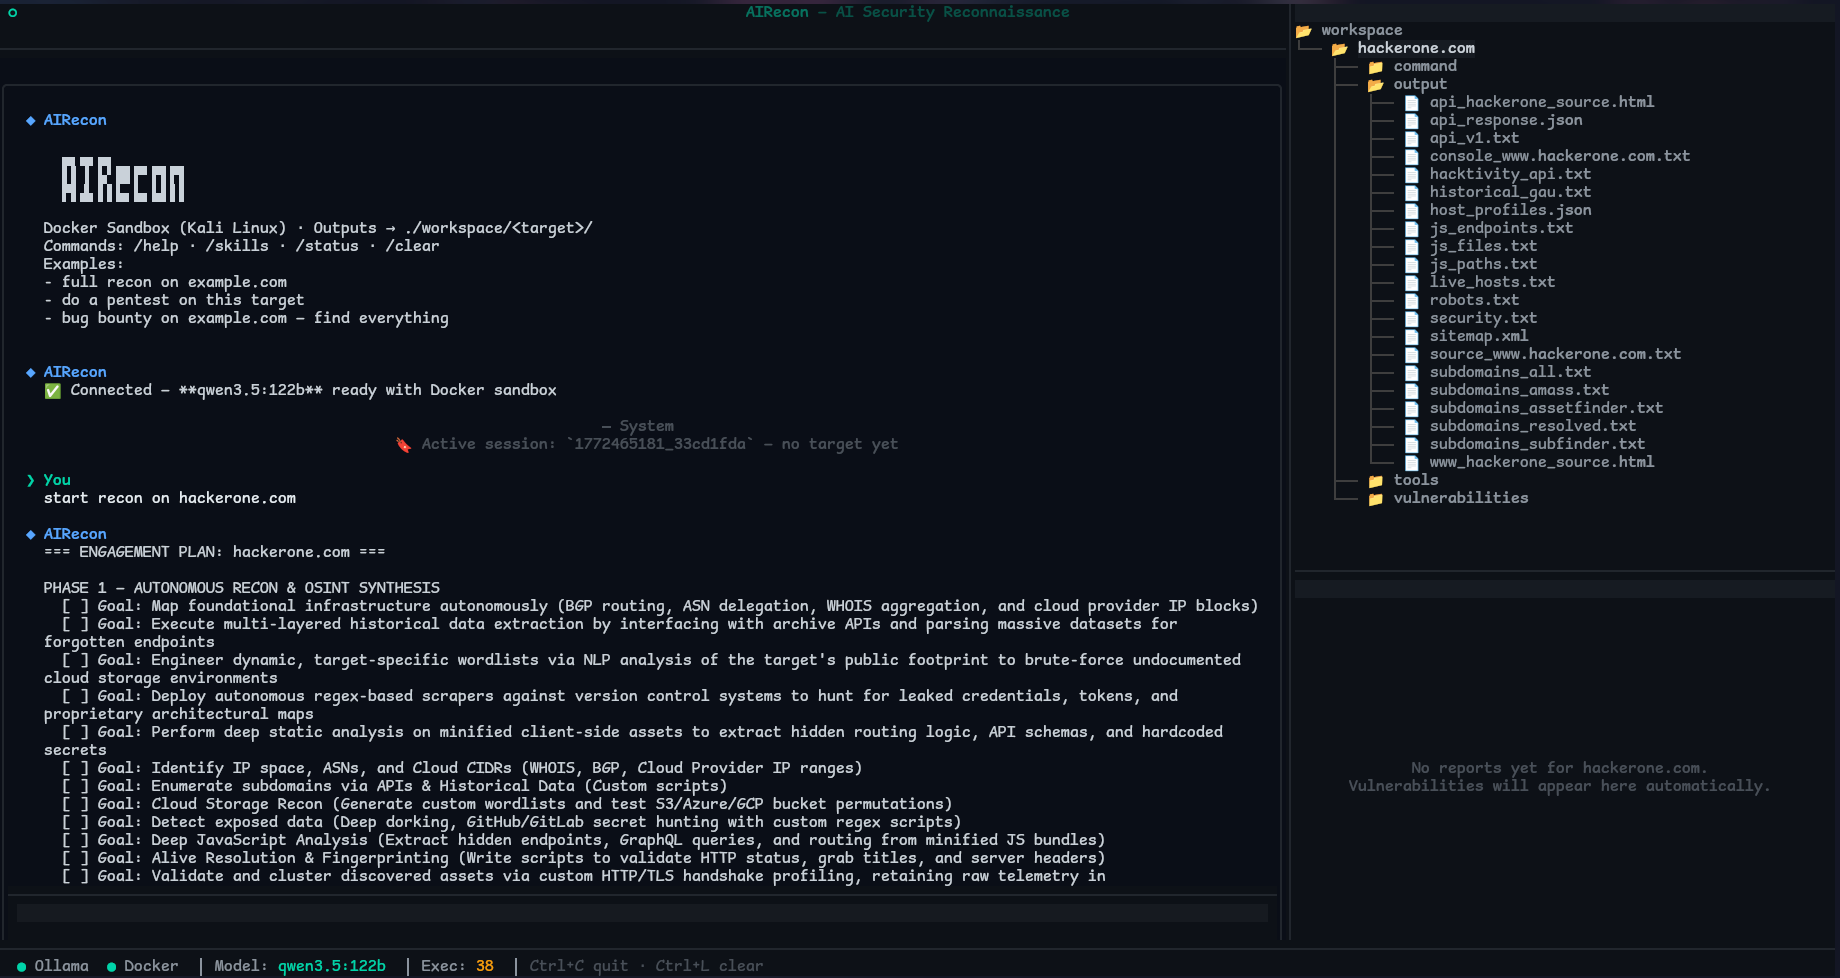
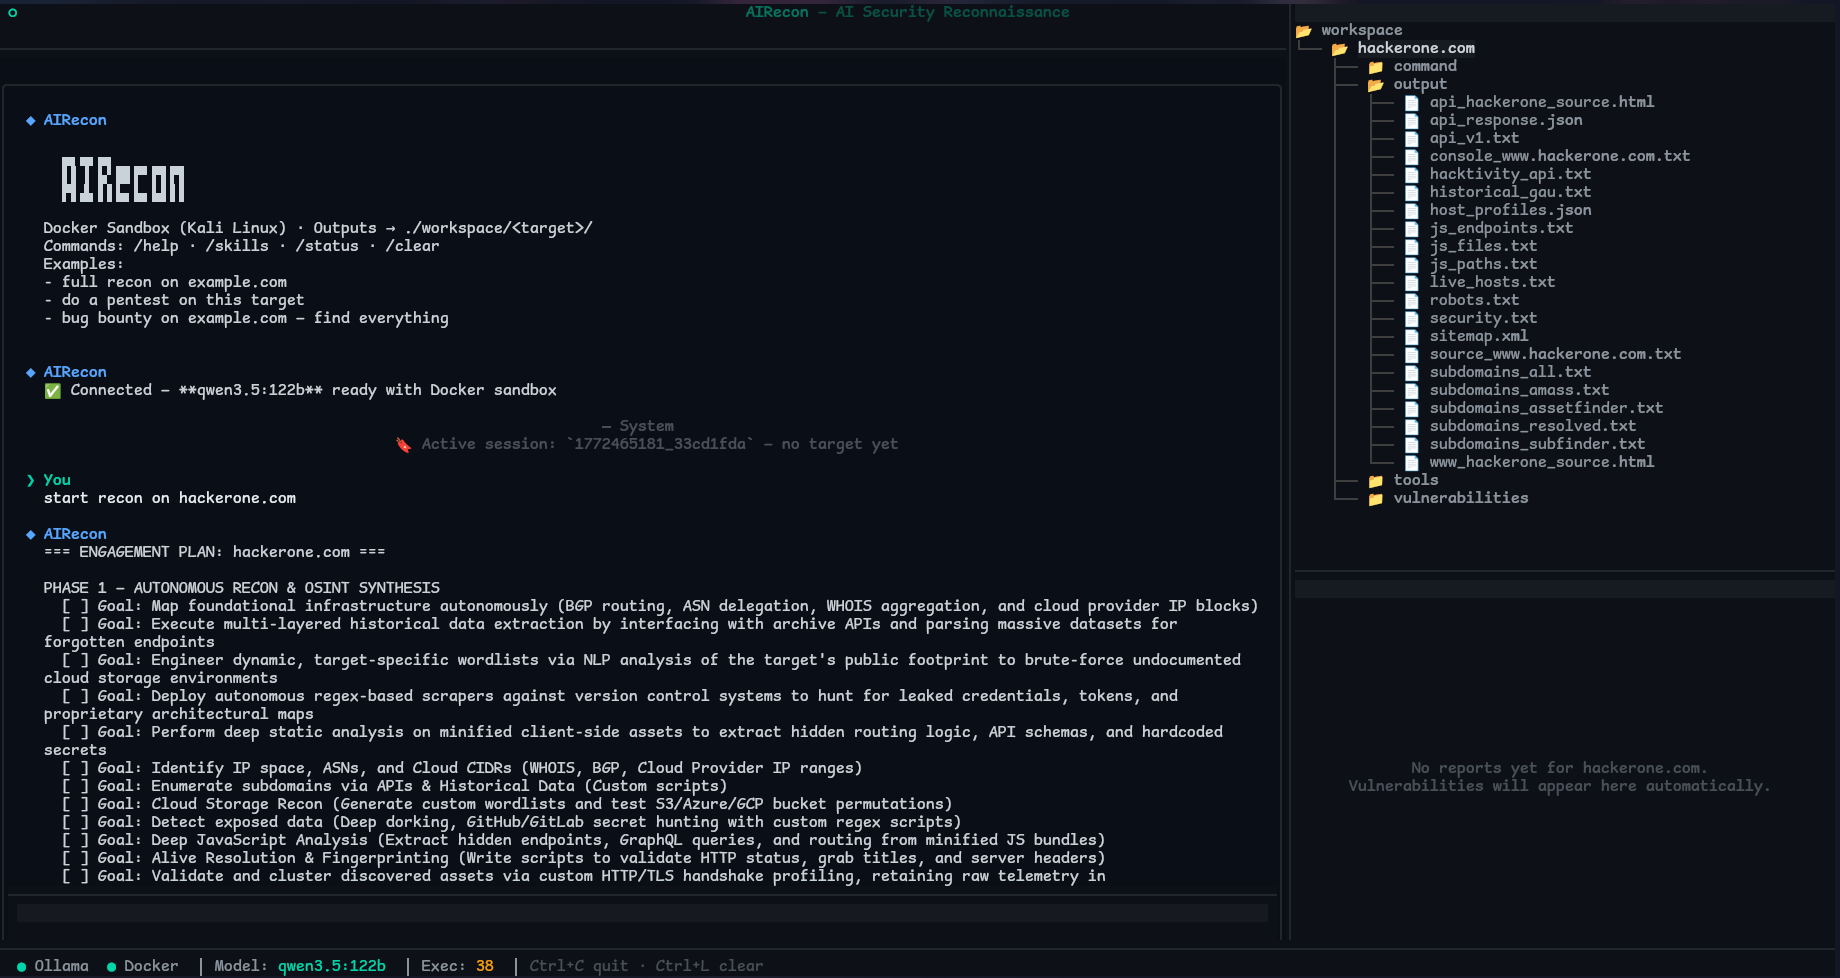
AIRecon은 자체 호스팅 대규모 언어 모델(Ollama)을 Kali Linux Docker 샌드박스 및 Textual TUI와 결합하는 자율 사이버 보안 에이전트입니다. API 키나 클라우드 의존성 없이 보안 평가, 침투 테스트, 버그 바운티 정찰을 자동화하도록 설계되었습니다.





AIRecon은 OpenAI 호환 LLM 게이트웨이(LiteLLM / vLLM / 호스팅된 엔드포인트 — 또는 로컬 Ollama를 프록시하는 로컬 게이트웨이)를 Kali Linux Docker 샌드박스, 네이티브 Caido 프록시 통합, 구조화된 RECON → ANALYSIS → EXPLOIT → REPORT 파이프라인, 그리고 실시간 Textual TUI와 함께 구동하는 자율 침투 테스트 에이전트입니다.
설계상 백엔드에 구애받지 않습니다. AIRecon을 로컬 게이트웨이(LiteLLM / vLLM, 또는 로컬 Ollama를 프록시하는 게이트웨이)에 연결하면 완전한 오프라인 / 프라이빗 운영이 가능하고, 호스팅된 OpenAI/Anthropic/Gemini 호환 엔드포인트에 연결하면 최고의 추론 품질을 얻을 수 있습니다. 추론 지원은 런타임에 자동 감지됩니다 — 모델별 하드코딩이 없습니다.
Swiftproxy는 220개 이상의 위치에 걸친 9천만 개 이상의 깨끗한 주거용 IP를 제공하며, HTTP(S)/SOCKS5, IP 로테이션, 스티키 세션, 정밀 지리적 타겟팅을 지원합니다. AI 기반 리서치 및 정찰 워크플로가 다양한 위치에서 웹사이트에 안정적으로 접근할 수 있도록 도와주므로, 웹 리서치, 데이터 수집, 스크래핑, 위치 기반 접근에 적합합니다.
무료 테스트가 가능하며, 코드 PROXY90을 사용하면 10% 할인됩니다.
AIRecon은 하나의 OpenAI 호환 게이트웨이와 통신하므로, 프라이버시와 제로 API 비용을 위해 로컬 모델을 실행할지, 최고의 추론 품질을 위해 호스팅된 모델을 사용할지 선택할 수 있습니다. 동일한 에이전트, 파이프라인, 샌드박스, 툴링이 어느 쪽이든 작동합니다.
| 기능 | AIRecon |
|---|---|
| 백엔드 | 모든 OpenAI 호환 게이트웨이 (LiteLLM / vLLM / 호스팅) |
| 완전 오프라인 / API 키 불필요 | 예 — 로컬 게이트웨이(vLLM, 또는 게이트웨이 → 로컬 Ollama) 사용 시 |
| 추론 감지 | 런타임에 자동 (모델명 하드코딩 없음) |
| Caido 통합 | 네이티브 |
| 범위 가드 + 감사 로그 | 예 — 범위를 벗어난 대상 거부, 모든 명령 기록 |
| 검증된 것만 학습 | 예 — 브레인이 입증된 발견을 축적하며, 노이즈는 아님 |
| 세션 재개 (채팅 + 도구 호출) | 예 |
| 로컬 지식 베이스 | 약 1,090,000개 레코드 (선택 사항) |
§FUZZ§), findings, scope, sitemap, intercept.dataset_search를 호출하여 — 실제 인덱싱된 데이터에 결정을 근거하게 합니다.RECON → ANALYSIS → EXPLOIT → REPORT
각 단계에는 특정 목표, 권장 도구, 자동 전환 기준이 있습니다. 단계 적용은 소프트(soft) 방식입니다 — 에이전트는 안내를 받지만 결코 차단되지 않습니다. 체크포인트는 5회(단계 평가), 10회(자기 평가), 15회(컨텍스트 압축) 반복마다 실행됩니다.
AIRecon은 LLM을 파인튜닝하지 않습니다. 이 도구의 "학습"은 도구 선택을 안내하고 실패한 경로를 반복하지 않도록 하는 로컬의 구조화된 텔레메트리입니다.
로컬 영속성 (모두 디스크에 저장, 클라우드 없음):
~/.airecon/memory/airecon.db의 SQLite 메모리 DB로, 세션, 발견 사항, 패턴, 대상 인텔, 도구 사용, 모델 성능, 스킬 사용, 공격 체인 발견을 저장합니다.~/.airecon/learning/global_learning.json의 적응형 학습 상태 (도구 성능 통계, 전략 패턴, 관찰 로그, 정제된 인사이트).~/.airecon/memory/by_target/ 아래의 대상별 메모리 파일로, 엔드포인트, 취약점, WAF 우회, 민감한 파라미터, 인증 엔드포인트를 포함합니다.workspace/<target>/payload_memory.json 아래에 저장할 수 있습니다.동작에 미치는 영향:
tech_correlations 데이터셋에서 지식 브리프를 주입합니다 — 따라서 데이터셋이 첫 반복부터 두뇌로 사용됩니다.intelligence_memory_recall_interval 반복마다 (기본값 4), 감지된 기술에 따라 학습된 패턴 / 콜드 스타트 지식이 다시 주입됩니다. 상관관계는 intelligence_correlation_interval마다 (기본값 6) 실행됩니다.intelligence_learn_only_verified, 기본 켜짐).intelligence_adaptive_min_observations (기본값 2) 관찰 후에 시작됩니다.AIRecon은 게이트웨이가 노출하는 모든 모델과 작동합니다 (GPT, Claude, Gemini, Qwen, GLM, DeepSeek, 로컬 Ollama/vLLM 모델 등). 두 가지 기능이 중요합니다:
⚠️ 네이티브 도구/함수 호출이 필수입니다. 이것이 없으면 에이전트는 어떤 도구도 실행할 수 없으며 (http_observe, execute, browser, Caido 등) 작동하지 않습니다.
openai_supports_native_tools: true를 유지하세요.추론은 자동 감지됩니다.
auto모드에서 AIRecon은 OpenAI 표준reasoning_effort를 전송하고, 백엔드가 이를 거부하면 (HTTP 400 지원되지 않는 파라미터) 이를 제거하고 기억합니다 — 따라서 추론 모델은 생각하고, 일반 모델은 깨지지 않습니다. 유지 관리할 모델 이름 목록이 없습니다.
품질 지침 (제공자와 무관):
로컬/오프라인 설정의 경우, 로컬 게이트웨이 (Ollama/vLLM) 뒤에서 모델을 실행하고 openai_base_url을 해당 게이트웨이로 지정하세요 (Configuration 참조). 품질은 AIRecon이 아니라 모델에 따라 확장됩니다.
GPU가 없거나 로컬 VRAM이 최소 요구 사항 미만인 경우, 무료 Google Colab T4 GPU에서 Ollama를 실행하고 공용 터널을 통해 AIRecon을 연결할 수 있습니다.
노트북 열기:
작동 방식:
Google Colab GPU                     Your Local Machine
┌──────────────────────────────┐          ┌──────────────────────────────┐
│  Local gateway (qwen3:8b)    │◄────────►│  AIRecon TUI                 │
│  cloudflared tunnel          │  HTTPS   │  openai_base_url: <tunnel>/v1│
└──────────────────────────────┘          └──────────────────────────────┘
단계:
~/.airecon/config.yaml에 복사합니다 (Colab은 터널 뒤에서 OpenAI 호환 게이트웨이를 실행합니다):openai_base_url: "https://xxxx.trycloudflare.com/v1" # printed by Cell 6 (note the /v1)
openai_api_key: "" # set if the gateway requires one
openai_model: "qwen3:8b"
llm_timeout: 300.0
llm_chunk_timeout: 300.0
llm_context_window: 32768
llm_context_window_small: 16384
airecon startColab GPU → 모델 가용성:
| Colab GPU | VRAM | 사용 가능한 모델 | 플랜 |
|---|---|---|---|
| T4 | 15 GB | qwen3.5:9b | 무료 |
| L4 | 22 GB | qwen3.5:35b-a3b (MoE) | Pro |
| A100 | 40 GB | qwen3.5:35b | Pro+ |
| H100 | 80 GB | qwen3.5:122b | Pro+ |
제한 사항:
qwen3.5:9b를 사용하는 T4가 최소 실행 가능 구성입니다 — 로컬 35B+ 모델보다 느린 응답과 더 많은 도구 호출 오류가 발생할 것으로 예상하십시오scripts/airecon_colab.ipynb에 있으며, 직접 호스팅하거나 수정하려면 이 파일을 참고하십시오
