 zydak/leetobfuscator
LLVM パスを通じて C/C++ を難読化: 文字列暗号化、制御フロー平坦化、MBA 書き換え、およびリバースエンジニアリングを防ぐアンチ解析。

██╗     ███████╗███████╗████████╗
██║     ██╔════╝██╔════╝╚══██╔══╝
██║     █████╗  █████╗     ██║
██║     ██╔══╝  ██╔══╝     ██║
███████╗███████╗███████╗   ██║
╚══════╝╚══════╝╚══════╝   ╚═╝

 ██████╗ ██████╗ ███████╗██╗   ██╗███████╗ ██████╗ █████╗ ████████╗ ██████╗ ██████╗
██╔═══██╗██╔══██╗██╔════╝██║   ██║██╔════╝██╔════╝██╔══██╗╚══██╔══╝██╔═══██╗██╔══██╗
██║   ██║██████╔╝█████╗  ██║   ██║███████╗██║     ███████║   ██║   ██║   ██║██████╔╝
██║   ██║██╔══██╗██╔══╝  ██║   ██║╚════██║██║     ██╔══██║   ██║   ██║   ██║██╔══██╗
╚██████╔╝██████╔╝██║     ╚██████╔╝███████║╚██████╗██║  ██║   ██║   ╚██████╔╝██║  ██║
 ╚═════╝ ╚═════╝ ╚═╝      ╚═════╝ ╚══════╝ ╚═════╝╚═╝  ╚═╝   ╚═╝    ╚═════╝ ╚═╝  ╚═╝

A simple obfuscator for C/C++ x64 and x86 code
これはLLVMのフォークとして作られているため、難読化するには実際のソースが必要です。任意の実行ファイルを難読化するものではありません。コンパイラの改造版です。
結果を確認したい場合は、これを使って2つのcrackmeを作成し難読化しました。releasesで、コンパイル済みのclangバイナリと一緒に入手できます。
これらはすべて-O3フラグでコンパイルされており、スクリーンショットはすべてIDA Pro 9.4によるものです。Binary NinjaとGhidraでもテストしましたが、結果は同じかそれ以下でした。
コンパイル時に文字列を暗号化し、暗号化された文字列が使用されるたびに復号関数を挿入します。これにより、バイナリ内の文字列を検索する機能が完全に無効になります。また、各文字列には復号関数内にハードコードされた固有のキーがあるため、ダンプして復号するのがはるかに難しくなります。これらの復号関数もインライン化されます。(以下では紹介のためにインライン化していません)
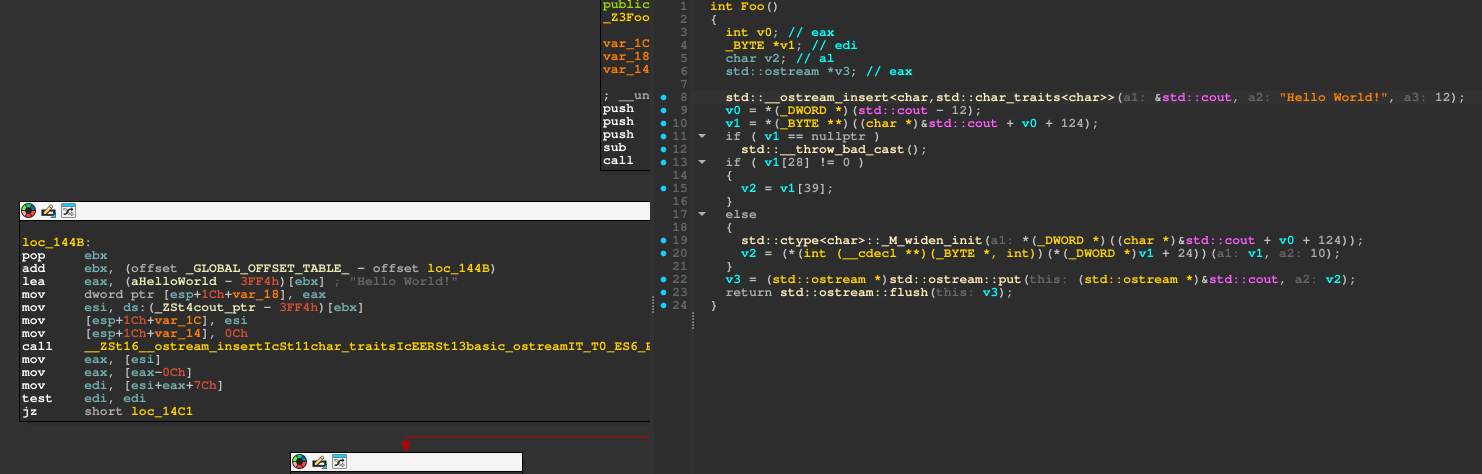 パス適用前 |
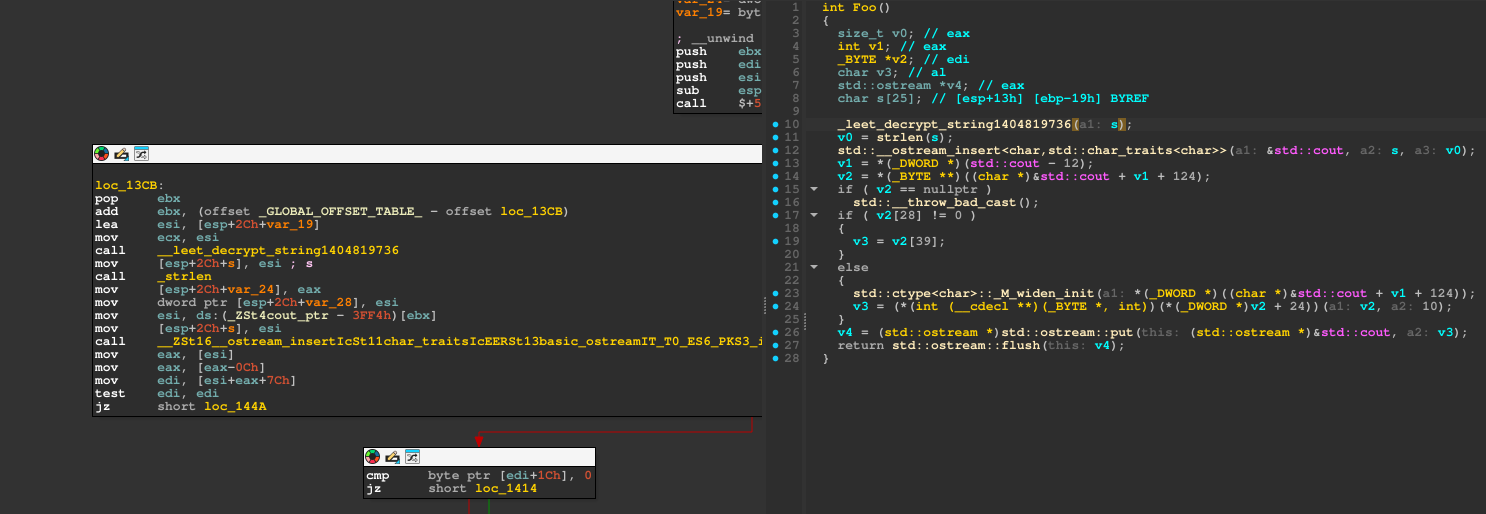 適用後 |
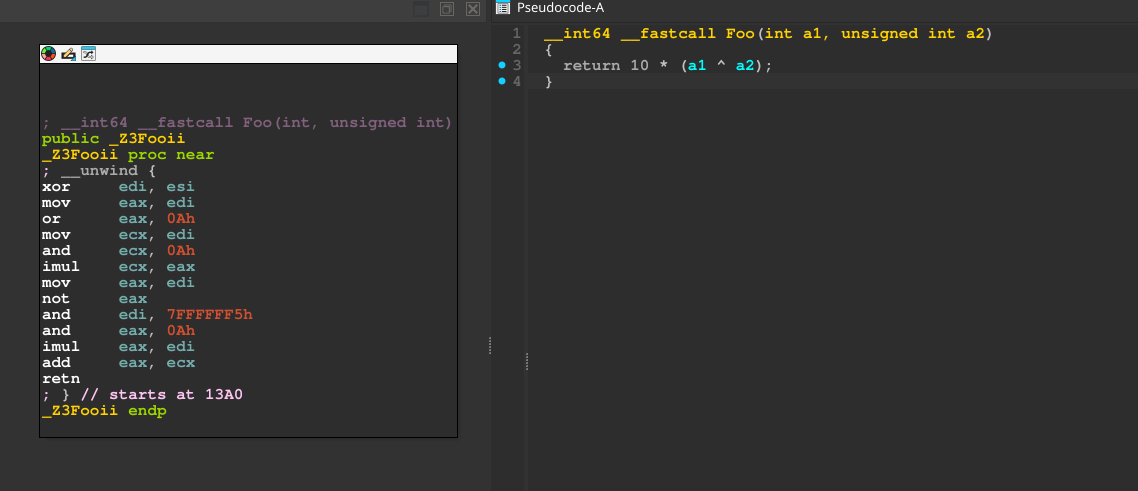
算術演算をMBAの等価式に置き換えます。最初にMBA難読化解除ツールを通さない限り、元の演算が何をしていたのかを把握するのはほぼ不可能です。もちろん、MBAは最も古い手法であるため、この難読化はやや弱く、CoBRAなどこれに対処するツールが多数存在します。CoBRAはこれを元の式に問題なく難読化解除します:
./cobra-cli --mba "((x^y) - (((x^y)&0xFF)&0xA) + 10) * ((x^y) - ((x^y)|0xA) + 10) + ((x^y) - (((x^y)&0xFF)|0xFFFFFFF5) - 11) * (~(x^y) - (~(x^y)|0xA) + 10)" --bitwidth 32

10 * (x ^ y)
だからこそ、私はAAMBAパスを作ったのです。
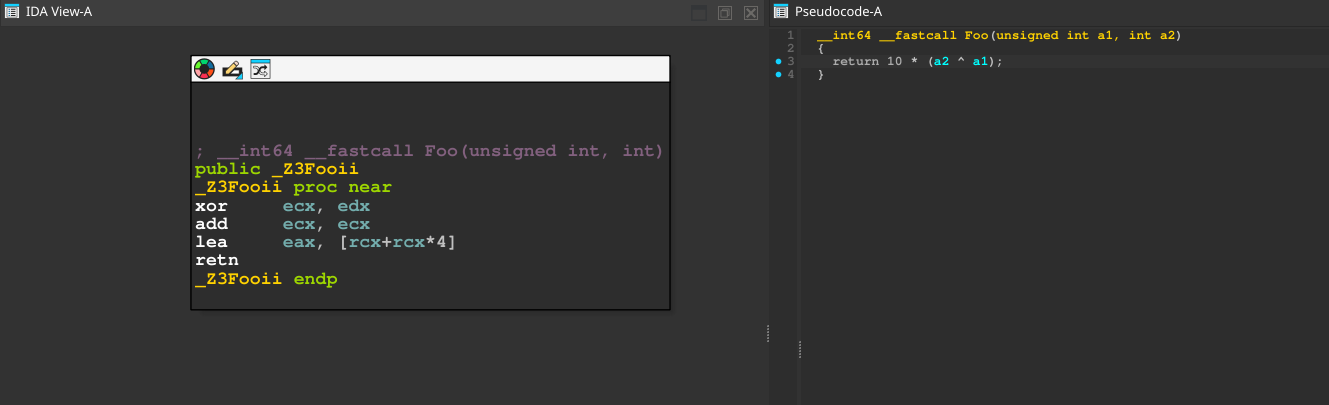 パス適用前 |
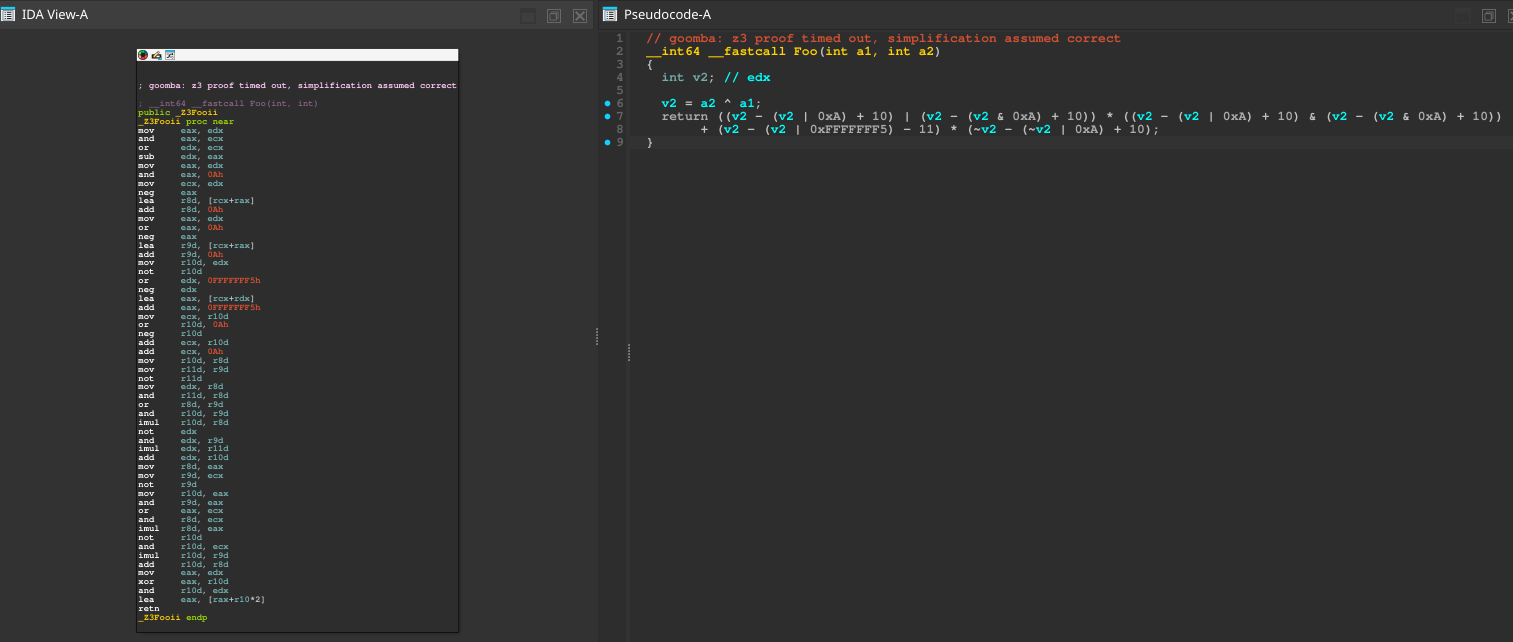 適用後 |
二項演算のオペランドを ADC(X, 255) - 255 - CF と SBB(X, 255) + 255 + CF に置き換えます。もちろんこれは常に X と評価されますが、式がキャリーフラグに依存するようになります。デコンパイラがCFの状態を追跡しない限り(それが不可能な場合もしばしばあります)、デコンパイラは非常に混乱し、これらの式を畳み込むことができなくなります。これは前のMBAパスと非常に相性が良く、算術をさらに難読化します。以下に示すように、デコンパイラはいくつかの追加変数を生成し、多数の __PAIR64__ や __CFADD__ 呼び出しを使用するため、これをCoBRAのようなツールに貼り付けるのはずっと難しくなります(それでも不可能ではありません)。IDAのgooMBAプラグインもこれを簡略化する助けにはなりません。また、IDAのデコンパイラはある程度キャリーフラグを追跡しますが、これを制御フロー難読化と組み合わせると、実行なしでは追跡がほぼ不可能になります。なぜなら前の演算が何だったのか分からないからです。CFを1に設定したかもしれないし、そうでなかったかもしれません。そのため、後のパスはこれにさらに積み重なっていきます。
|
パス適用前 |
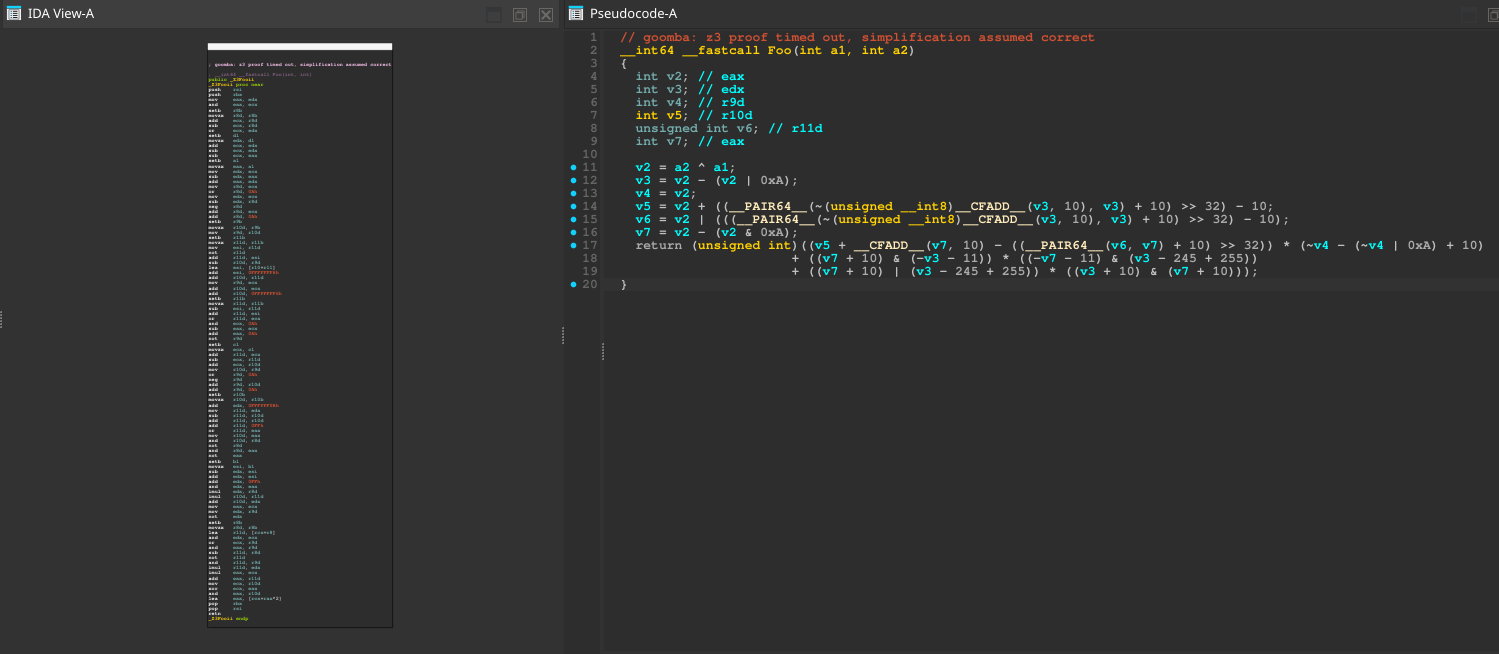 適用後 |
関数内のすべてのブロックを収集し、それらから1つの巨大なステートマシンを作り上げます。関数の先頭にジャンプテーブルを作成し、そこにすべてのブロックポインタを配置します。そして、各ブロックの末尾での通常のジャンプの代わりに、すべてが間接ジャンプを使用するディスパッチャを経由するようになります。これらは実行なしで静的に解決することはほぼ不可能です。また、レジスタをスタックに降格させるため、ブロックを半分に分割すると、前のブロックのすべての変数がスタック上に置かれることになり、すべての式に非常に多くの変数が含まれることになります。単一ブロックの演算をCoBRAに通しても、未知の変数が多すぎるため、あまり難読化解除できません。
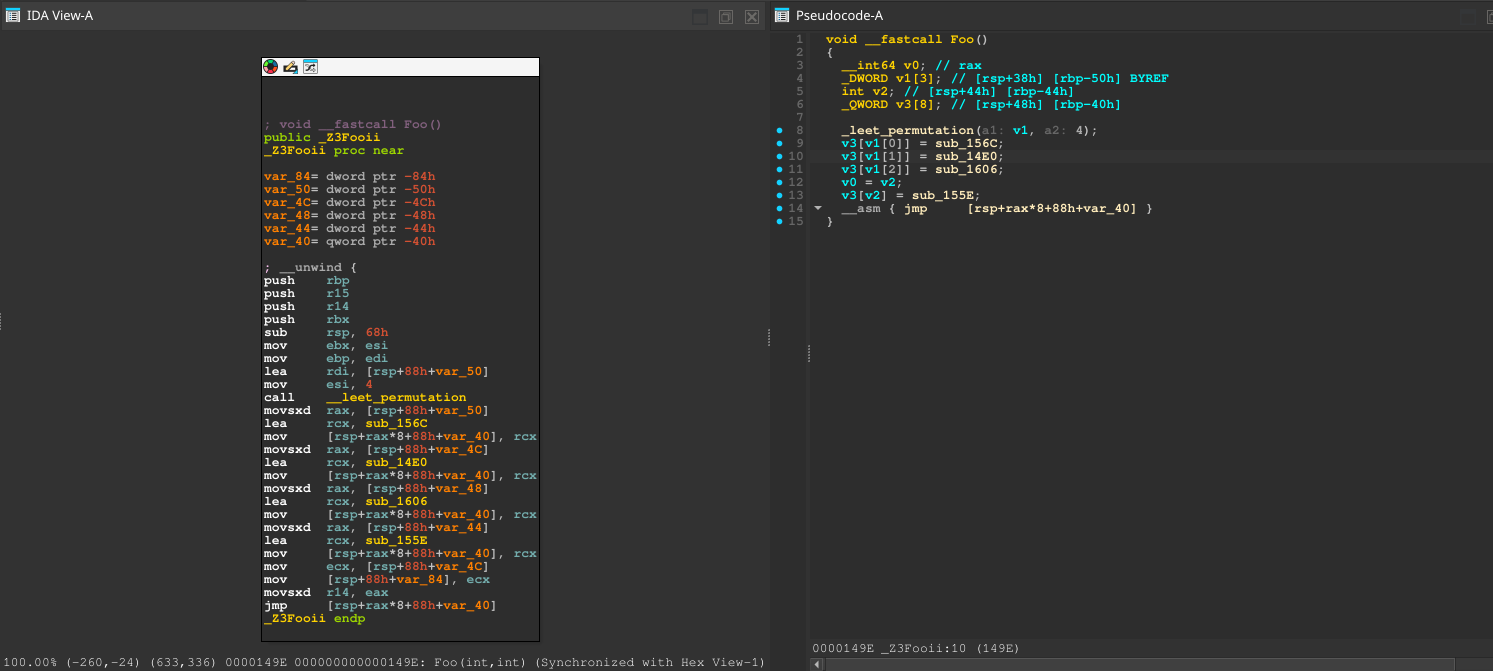
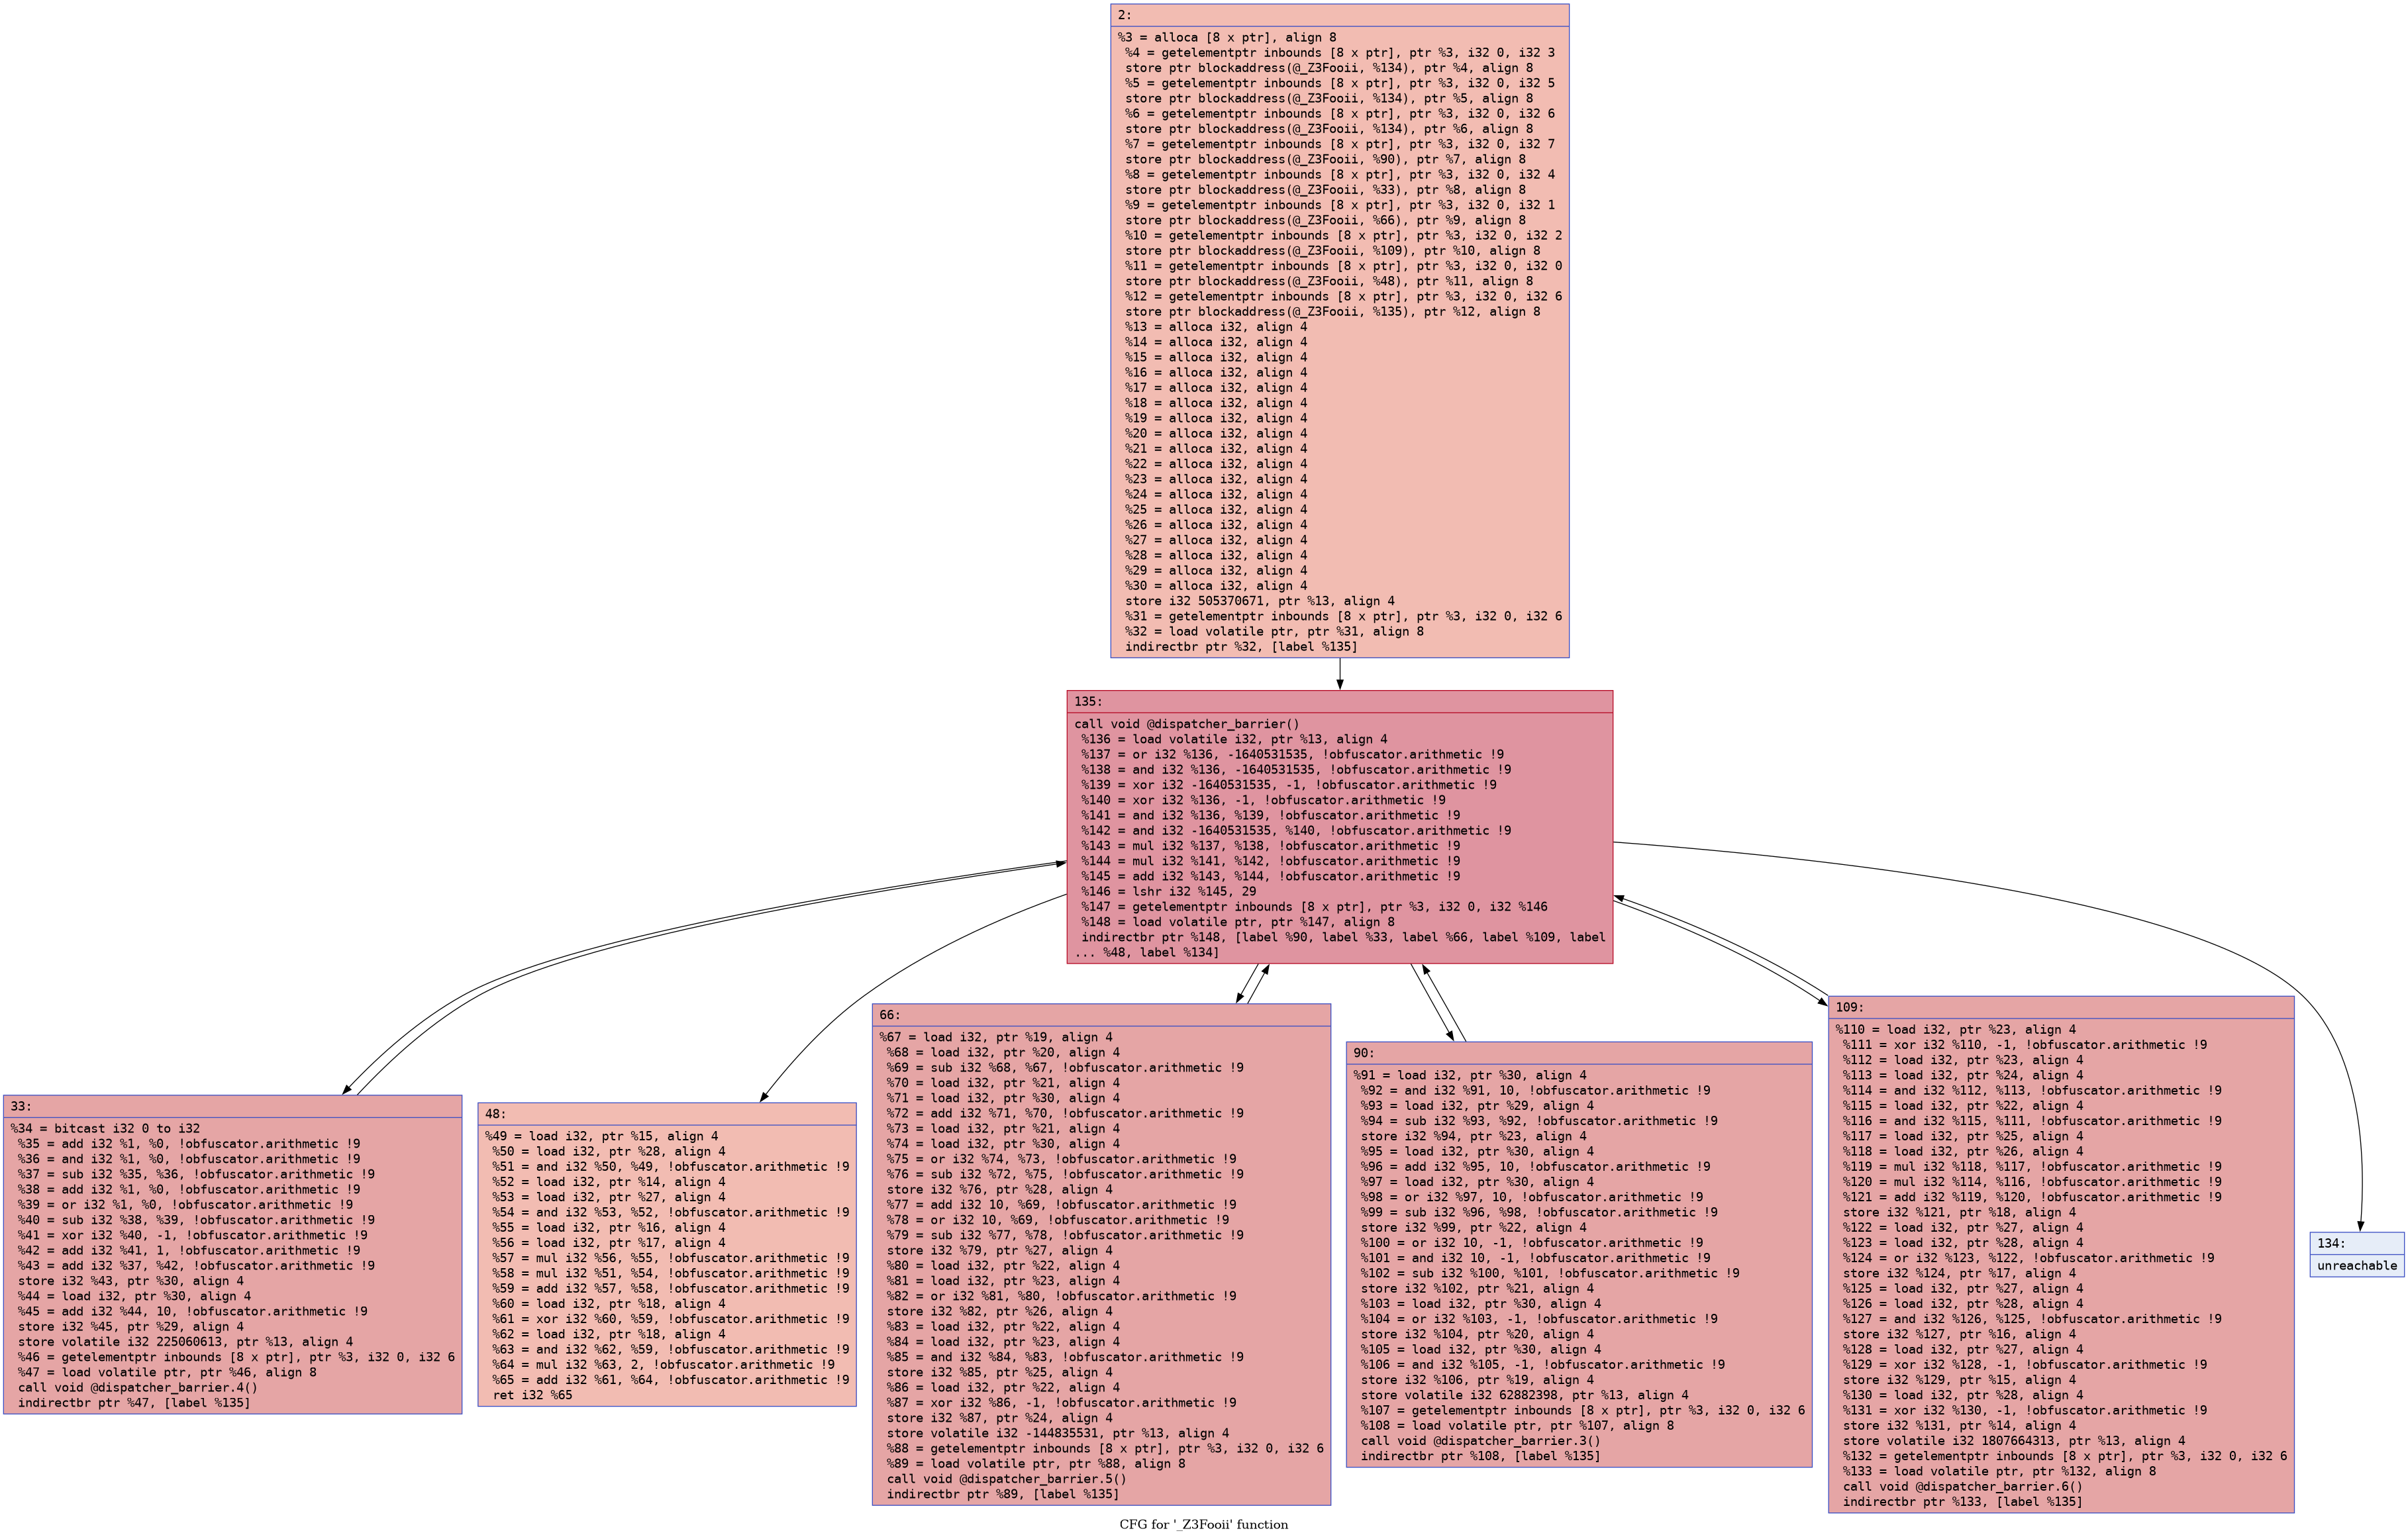
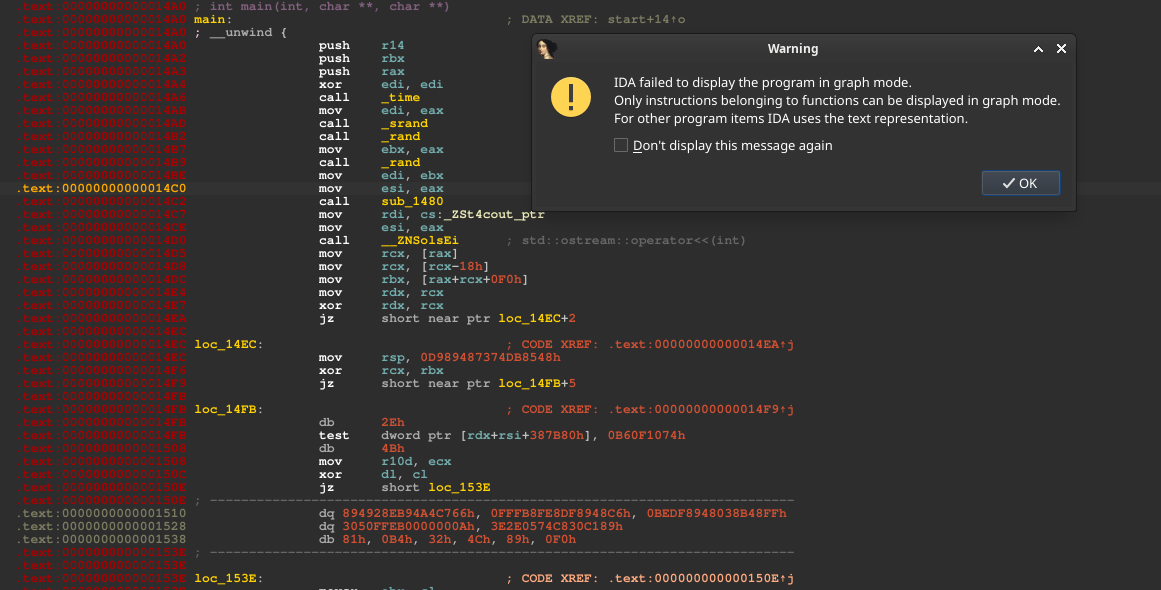
無効なアセンブリを含む偽のブロックを多数作成します。これは逆アセンブラを大いに混乱させます。なぜなら、逆アセンブラが決して実行されない技術的に無効なバイトに遭遇した場合でも、それを解釈しようとするからです。そのため、バイトが不完全な場合、その後にたまたま続くバイトから命令を作成し、事実上それらを消費してしまいます。これにより同期がずれ、その後のすべての命令が破壊されます。WindowsバイナリではIDAはある程度回復でき、まれなケースではグラフを生成して可能な限りデコンパイルできます(ただし壊れていて不完全になります)が、Linuxバイナリではグラフビューが完全に壊れ、デコンパイルが無効になります。さらに、RDTSCタイマーやその他のアンチデバッグチェックを挿入し、デバッガを検出するとクラッシュさせます。
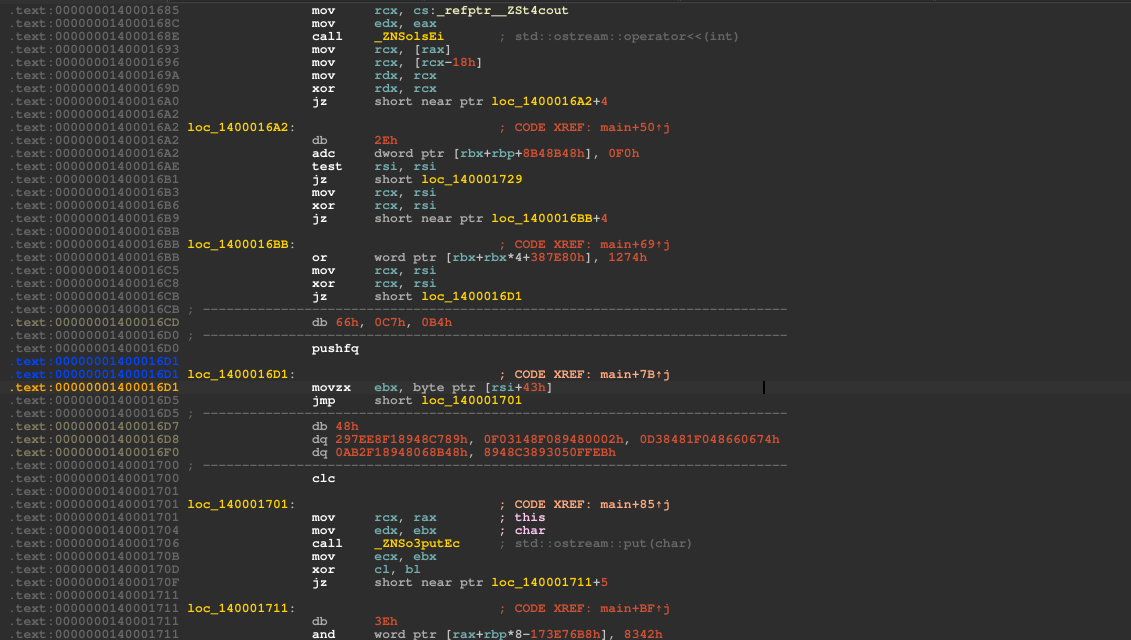 Windows |
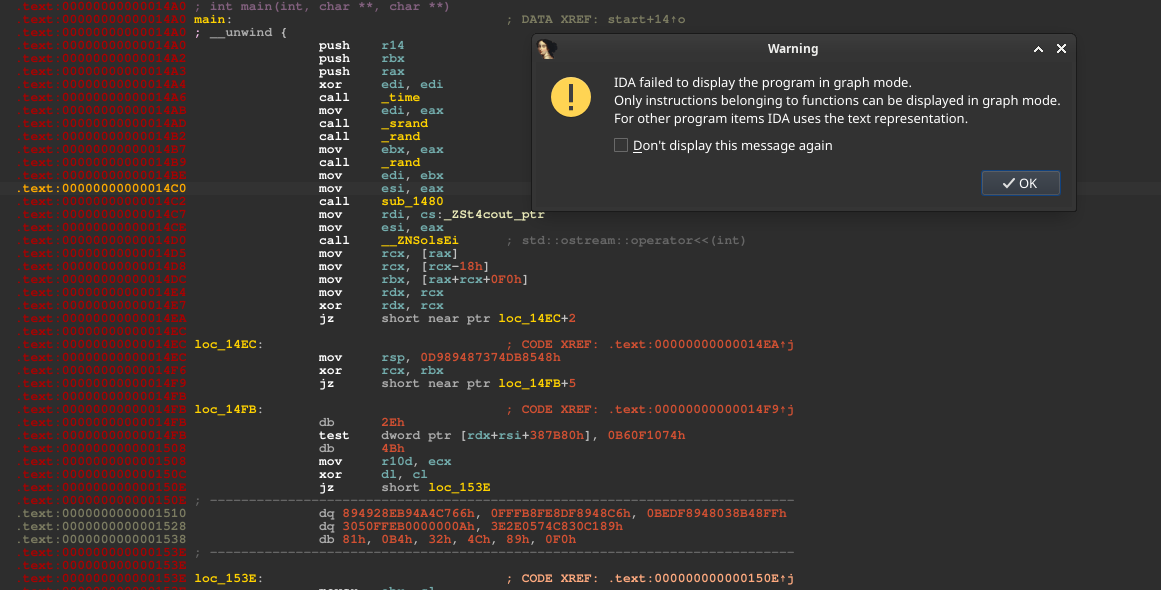 Linux |
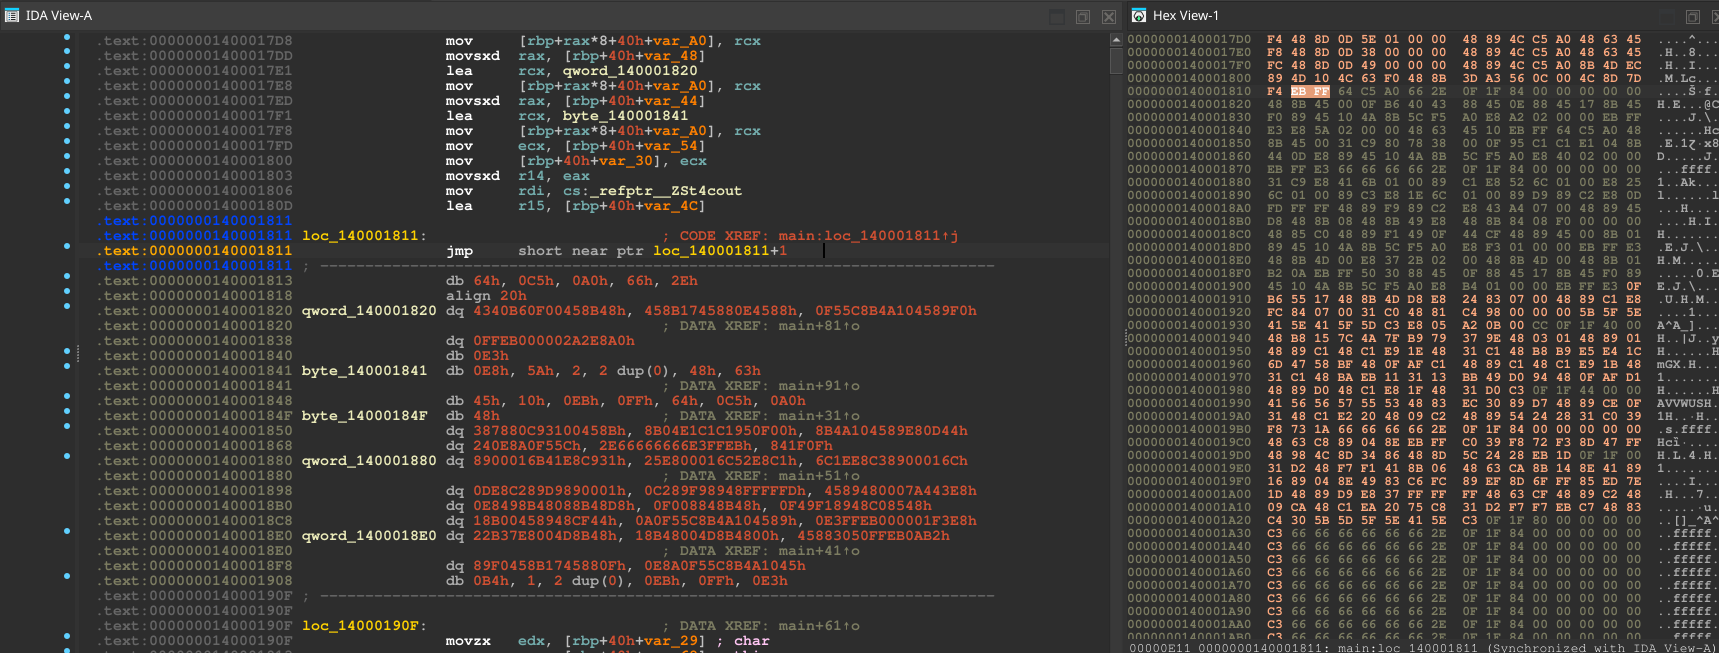
さらに、パスが 0xFF で始まる命令を検出すると、その直前に 0xEB バイトを1つ挿入します。これにより JMP RIP+1 が生成されるため、制御フローは変化しません(RIP は元の命令の1バイト先へ進むだけです)が、ディスアセンブラは再び同期がずれます。
0xFF で始まる命令は主に INC/DEC と間接 JMP/CALL です。残念ながら通常の呼び出しやジャンプのほとんどは相対(0xE8/0xE9/0xEB)であり、影響を受けません。しかしこの手法は、すべてが間接ジャンプを使用するディスパッチャパスと組み合わせると特に有用です。ただし呼び出しにはそれほど有用ではなく、この影響を受ける呼び出しは間接呼び出しのみで、典型的には仮想呼び出し、関数ポインタ経由の呼び出し、および一部の外部/ライブラリ呼び出しです。
変数を複数の部分に分割し、各部分に対して個別に演算を実行します。MBA パスと非常に相性が良く、単純なロジックをすでに複雑な状態からさらに複雑にします。簡単に言えば、int32 は4つの int8 に分割でき、サポートされている演算(AND, OR, XOR, ADD, SUB, ICMP)が実行される場合、元の int32 ではなく int8 に対して1つずつ実行されます。
 パス適用前 |
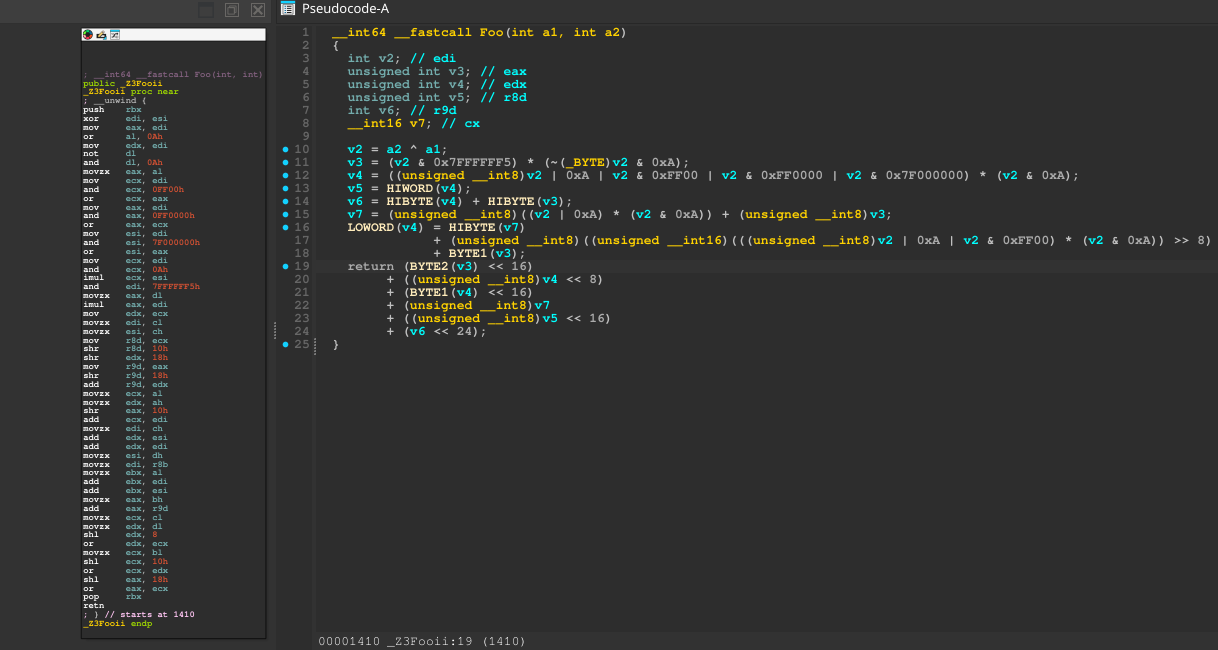 適用後 |
関数内のすべてのスタックローカル変数を1つの大きな共有スタックバッファに押し込み、そのインデックスは実行ごとにランダム化され、実行時に計算されます。これによりデコンパイラは変数をエイリアスできなくなり、同じ変数への複数回のアクセスが異なる値へのアクセスとして表示されます。これはディスパッチャパスおよび変数分割パスと非常に相性が良いです。ディスパッチャはレジスタをスタックに降格させ、変数分割はそれらを複数の変数に分割するため、こうしたスタックスロットが多数存在することになります。
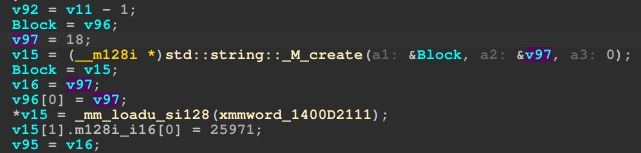 パス適用前 |
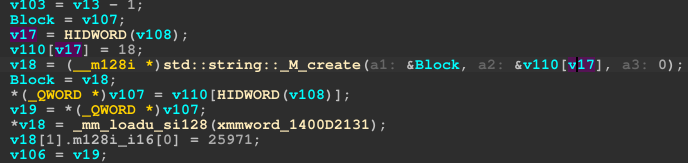 適用後 |
例外を通じて制御フローを難読化します。すべての呼び出しを int3 トラップに置き換えます。トラップがトリガーされると、制御フローは例外ハンドラに移り、そこで RIP を実際の呼び出し先に調整します。また、トラップの直後に無効なバイトを挿入して、ディスアセンブラの同期をさらにずらします。
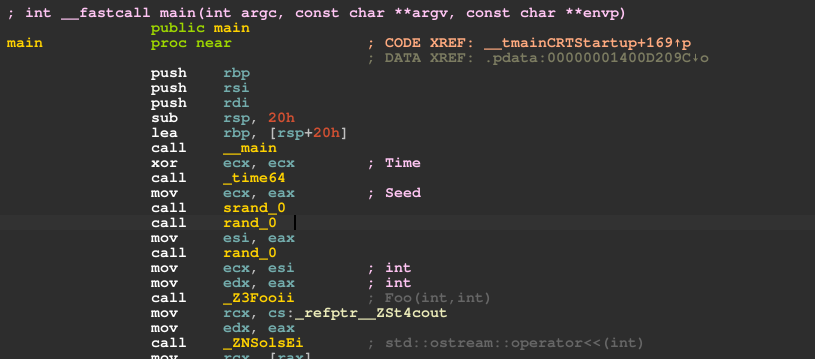 パス適用前 |
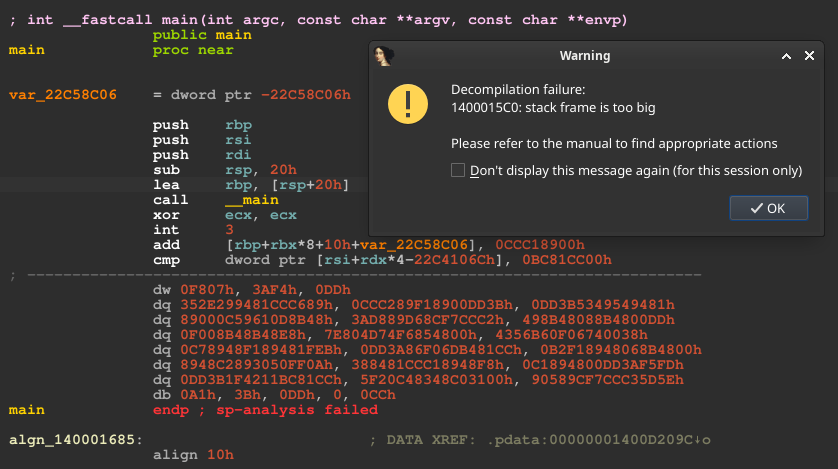 適用後 |
