 noahware/binprotect
バイナリにセクションを追加しないx64 PE bin2bin難読化ツール

ビルド手順については、「4. ビルド」を参照してください。
この難読化ツールは bin2bin 方式であり、つまり、すでにコンパイルされた実行可能バイナリを受け取り、難読化パスを適用して再生成します。これにより、元のソースコードにアクセスしなくてもアプリケーションを保護できます。現時点では x64 PE(ポータブル実行可能)ファイルのみがサポートされていますが、将来的には他のバイナリ形式(ELF など)のサポートを追加する計画があります。
現在、よく知られている bin2bin 難読化ツールはすべて、バイナリの末尾にセクションを追加し、難読化されたコードやデータをその中に配置します。これは、既存のセクションの内容を変更する必要がないようにすることで、バイナリの元のレイアウトを保持するためです。この方法は、ほとんどの RVA(相対アドレス)が有効なまま維持されるため、管理がはるかに容易です。
このプロジェクトは bin2bin に対して独自のアプローチを採用しており、難読化されたコードやデータはバイナリの元のセクション内に挿入されます。そのためには、アプリケーション内のすべての RVA を追跡する必要があります。このアプローチの利点は次のとおりです。
このドキュメントでは、実行可能バイナリの書き換えと、実装された難読化手法の両方について説明します。以下の難読化手法が実装されています。
さらに、このプロジェクトは例外サポート(C++ 例外および SEH)も備えており、例外処理を含む関数を難読化できます。
バイナリ内のコードの発見と逆アセンブルを支援するために、シンボルファイル(PDB および MAP)がオプションで受け入れられます。シンボルファイルの提供は必須ではありませんが、複雑なバイナリでの逆アセンブルを支援します。例外サポートや制御フローの平坦化などの一部の機能では、シンボルファイルの提供が必要です。
バイナリリライターは、実行可能バイナリを受け取り、その中のコードやデータを変更して、変更が適用された出力バイナリを生成します。
難読化されたコードがバイナリの元のセクションに直接挿入されるため、プログラム内の相対アドレスを追跡し、それらへのすべての参照を調整できるようにする必要があります。これにより、コードやデータが挿入された後も参照が同じ場所を指すようになります。そうしないと、データやコードが間違った場所にアクセスされ、出力バイナリの動作が変わり、深刻な不安定性を引き起こします。
相対アドレスへの参照が見つかるたびに(例:rip 相対オペランドを含む命令や PE データディレクトリ)、追跡リストに追加され、書き換えの最後に更新されます。参照が発生する RVA(参照を更新する場所を特定するため)と、参照されている RVA(参照を更新する RVA を特定するため)の両方が追跡されます。
逆アセンブラが rip 相対命令を見つけるたびに、難読化の最後に更新される参照のリストに追加されます。これにより、それらすべての命令が元の場所を指し続けることが保証されます。ジャンプテーブルなどの他の相対命令のケースも、更新される参照として追加されます。
追跡されているすべての RVA は、バイナリにバイトが挿入または削除されるたびに調整する必要があります。例えば、次のバイト挿入ハンドラがあります。```cpp
void binwrite::binary_t::insert(const rva_t rva, const std::span data, const bool inclusive)
{
buffer_.insert_range(buffer_.begin() + rva.value(), data);
update_rvas(rva, static_cast<rva_t::size_type>(data.size()), inclusive);
}
`update_rvas` は、バイナリで発生した変更を反映するために、追跡中のすべてのRVAが更新される場所です。以下にこのプロセスの図を示します。
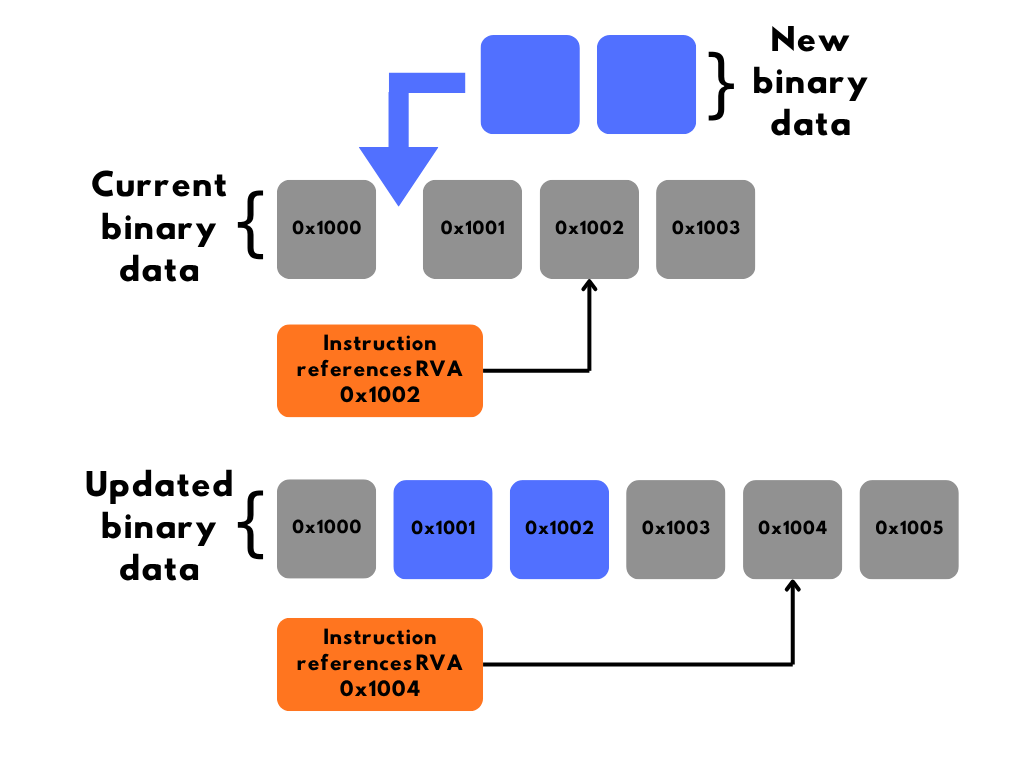
図1. 相対アドレストラッキング。
挿入されたデータ(青)は、現在のデータ(灰色)をシフトします。命令が参照するRVA(オレンジ)は、挿入されたデータ(青)を考慮して、同じメモリを指すように更新されます。
## 2.2. 逆アセンブル
すべての潜在的なコードエントリ(エクスポート、エントリポイント、コードセクションを指す再配置など)は、逆アセンブルキューに追加されます。シンボルファイルが存在する場合、そのシンボルファイルに記述されているすべての関数も逆アセンブルキューに追加されます。キュー内の各エントリは、個別の基本ブロックとして扱われます。
基本ブロックは、分岐のない命令のグループです。つまり、制御フロー命令(例:jump、ret、int)で終了します。基本ブロックは、呼び出し(call)では終了しません。ほとんどの場合、呼び出しは戻ることが期待されるためです。一部の関数は戻りません(例:_CxxThrowException)。これらは以降、'noreturn'呼び出しと呼ばれます。
逆アセンブルキューからの基本ブロックが処理されるとき、各命令は先頭から逆アセンブルされ、次のいずれかが発生するまで続けられます:
- 別の既に解析済みの基本ブロックに到達し、オーバーラップが発生する。「基本ブロックの分割」を参照。
- 終了命令が見つかる(jump、return、int)。
- 命令の逆アセンブルに失敗する。
- コードパディングが見つかる。
以下は、逆アセンブルと逆アセンブルキューへのエントリの図です(図ではコードパディングチェックは省略)。これは、逆アセンブルキューが空になるまで繰り返されます。
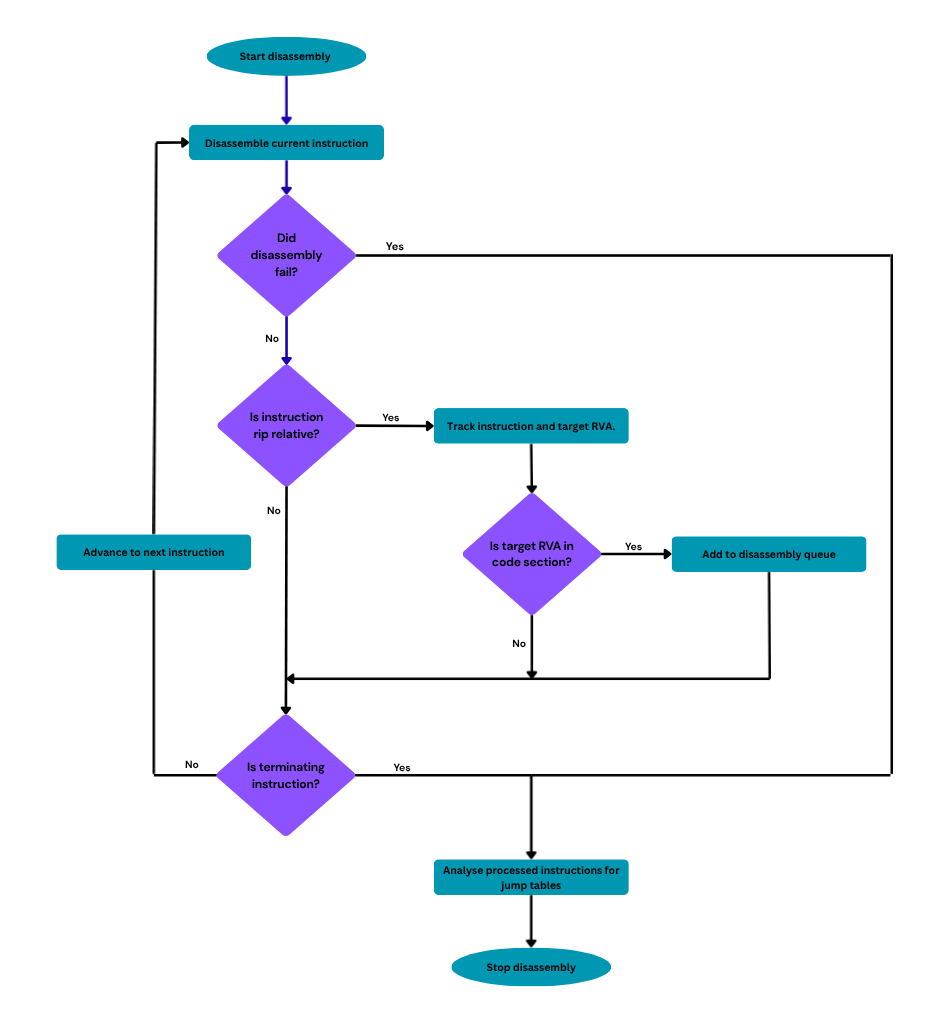
図2. 逆アセンブル処理。
### 2.2.1 基本ブロックの分割
2つの基本ブロックが重なっている場合、そのうちの1つを分割する必要があります。これにより、2つのブロックが同じ命令を記述するのを防ぎます。例:```asm
wcslen proc
or rax, 0FFFFFFFFFFFFFFFFh
loc_140001078:
inc rax
cmp word ptr [rcx+rax*2], 0
jnz short loc_140001078
retn
wcslen endp
これはワイド文字列の長さを取得する wcslen の実装です。
最初の命令 'or rax, FFFFFFFFFFFFFFFF' が基本ブロックの開始として逆アセンブルされると、'retn' まで逆アセンブルが続けられます。
'jnz loc_140001078' はループを形成するために後方にジャンプします。これは参照として追加され、jnz のターゲットとフォールスルーブランチ(次の命令)の両方が逆アセンブリキューに追加されます。
この命令はすでに分析されたブロックの途中にジャンプするため、新しいブロックを形成して 'retn' まで再び逆アセンブルするわけにはいきません。重複した表現になってしまうからです。
'jnz'(条件付きジャンプ)もフォールスルーブランチを取り、新しい基本ブロックを作成します。これで4つの基本ブロックが次のようになります:
Block A:```asm
or rax, 0FFFFFFFFFFFFFFFFh
loc_140001078:
inc rax
cmp word ptr [rcx+rax*2], 0
jnz short loc_140001078
ブロック B:```asm
loc_140001078:
    inc     rax
    cmp     word ptr [rcx+rax*2], 0
    jnz     short loc_140001078
ブロックC:```asm
retn
ブロックD:```asm
    retn
これは基本ブロックの誤った表現であり、同じ命令を4つのブロックに重複して配置しています。これは、現在の逆アセンブル結果と重複する基本ブロックを分割することで修正できます。重複するたびに命令の複製表現を作成する代わりに、既存の命令が新しい基本ブロックに移されるため、重複した命令は存在しなくなります。分割を用いた正しい表現は次のとおりです。
Block A:```asm
or rax, 0FFFFFFFFFFFFFFFFh
ブロックB:```asm
    inc     rax
    cmp     word ptr [rcx+rax*2], 0
    jnz     short loc_140001078
ブロック C:```asm
retn
### 2.2.2. 間接制御フロー

#### 2.2.2.1. ジャンプテーブル

ジャンプテーブルは、switch文のハンドラのアドレスを格納するために使用されます。switch文の各caseに対して多数のif文や条件付きジャンプを使用する代わりに、case文ハンドラのアドレスのテーブルが保持されます。以下に例を示します(LLVM/CLANG バイナリ):```cpp
std::int32_t sub_140004080(const std::int32_t a1)
{
  std::int32_t result;

  switch ( a1 )
  {
    case 0:
      result = 9;
      break;
    case 1:
      result = 4;
      break;
    case 2:
      result = 3;
      break;
    case 3:
      result = 1;
      break;
    default:
      result = 0;
      break;
  }

  return result;
}
この switch 文は以下のアセンブリにコンパイルされます:```asm
; ecx = a1
cmp ecx, 3 ; check if above bounds, must be default case
ja short def_140004097 ; goto default if a1 above 3
mov ecx, ecx
mov eax, ecx
lea rcx, jpt_140004097
movsxd rax, ds:(jpt_140004097 - 140004100h)[rcx+rax*4] ; select correct index of jump table for a1
add rax, rcx
jmp rax ; goto index specified - the case handler
jpt_140004097:
dd offset loc_140004099 - 140004100h ; address of handler for first case
dd offset loc_1400040D5 - 140004100h ; address of handler for second case
dd offset loc_1400040BD - 140004100h ; address of handler for third case
dd offset loc_1400040C9 - 140004100h ; address of handler for fourth case
'a1' の値は case の最大値と比較され、それを超える場合は直接デフォルトハンドラへ移行します。a1 が case の範囲内であれば、ジャンプテーブルの該当エントリにアクセスし、計算されたハンドラアドレスへジャンプします。

ジャンプテーブルのエントリとジャンプテーブルへの参照は追跡され、そのまま保持されます。

##### 2.2.2.1.1. 境界付きジャンプテーブル

ジャンプテーブルがスイッチ文で使用可能なすべての値の範囲を網羅していない場合、境界付きテーブルを使用して制限をチェックします。これは、範囲外の場合にスイッチをデフォルト文にリダイレクトするためです。case 文の数を解析するために、比較命令をチェックしてエントリ数を見つけます。例えば、命令 'cmp ecx, 3' はジャンプテーブルのエントリ数が3であることを示します。

##### 2.2.2.1.2. 境界なしジャンプテーブル

ジャンプテーブルが case 文のすべての可能な値をカバーしている場合(例:UINT8 型の場合、UINT8 の最小値から最大値まで)、制限チェックのない境界なしテーブルを使用します。これは、コンパイラがジャンプテーブルがすべての可能な値をカバーしていることを知っているためです。ジャンプテーブルのエントリ数を示す比較命令がないため、エントリは総当たりで検出する必要があります。テーブルのベースからコードセクション内の有効な RVA を段階的にチェックし、有効なエントリをそれぞれ追跡します。この方法は、他のデータや命令をジャンプテーブルのエントリとして解析する可能性があるため安全ではなく、可能な場合は境界付きジャンプテーブルのチェックが使用されます。

##### 2.2.2.1.3. さまざまなタイプのジャンプテーブル

バイナリリライターは、MSVC(マルチレベルテーブルを含む)、LLVM/CLANG、GCC でビルドされたバイナリのジャンプテーブルをサポートしています。

MSVC のジャンプテーブルには2つの形式があります:通常とマルチレベルです。MSVC の通常のジャンプテーブルは、RVA の配列です。各 RVA は case 文のハンドラを指します。
