 foxirain/linux-kernel-codex-harness-v2
CVE-2026-53075の調査で使用される、来歴認識型Linuxカーネル脆弱性研究ハーネス


研究ツール · オリジナルインポート: 2026年4月3日 · v2 ドキュメント改訂: 2026年7月11日
外部シグナル: 注意配分から来歴認識型トリアージへ
再現可能な観測値を使ってモデルの注意を導き、その後リポジトリの来歴を使ってレビューキューの整理を行う——証明を主張するためではない。
プロジェクト系統— Kernel Codex Harness v1 · 注意配分 → Kernel Codex Harness v2 · 来歴認識型トリアージ
プロジェクトステータス. このリポジトリは、実際のLinuxカーネル脆弱性調査のためにv1のattention-allocationワークフローをprovenance-aware triageまで発展させたLLM支援型リサーチハーネスです。このバージョンはCVE-2026-53075として公開された脆弱性の発見に使用されました。自動脆弱性検出器、新規性判定器、exploit検証器、またはカーネルセキュリティ保証ツールではなく、最終的な検証と報告は人間が行います。
Abstract— Linuxカーネルのような大規模コードベースをLLMにそのまま探索させるとコンテキストが分散し、危険なAPIの存在と実際の攻撃可能性が容易に混同されます。Kernel Codex Harness v2はこの問題を2段階のExternal Signal処理として定義します。モデル呼び出し前には、パスweight、lexical hit、キャッシュされたsyzbot overlapで候補ファイルをランク付けしてattentionを配分します。モデル応答後には、Git branch・HEAD・dirty stateと応答から抽出したCVE・commit・known markerを組み合わせて、strong findingをprovenance-aware review bucketに分類します。このハーネスは実際のLinuxカーネル調査でPPPのtarget network namespace権限検証欠陥を発見するために使用され、その欠陥はCVE-2026-53075として公開されました。Triageは調査キューを整理するheuristicであり、特にnew_candidateは既知の手掛かりやprovenance問題を発見できなかったことを意味するだけで、novelty proofではありません。すべてのfindingはuserspace reachability、invariant break、concrete impactについて人間による再検証を要求します。
Index Terms— Linux kernel, vulnerability research, external signal, provenance, heuristic triage, LLM orchestration, syzbot, Codex.
カーネルセキュリティレビューには、互いに異なる2種類の不確実性があります。
v1の中心問題は最初のもの、つまりattention allocationでした。v2はその原則を維持しながら、2番目の問題をprovenance-aware triageへ拡張します。両バージョンはそれぞれ実際の調査に使用され、v1-assisted investigationはCVE-2026-31720に、v2-assisted investigationはCVE-2026-53075につながりました。
モデル外部の観測値で調査範囲を絞り込み、モデル応答後には検証可能なリポジトリprovenanceを付与します。いずれの段階のsignalも脆弱性または新規性を証明しません。
Pre-inference External SignalはLLMの判断ではなく、モデル実行前に計算される観測値です。
同じsource tree、profile、キャッシュされたsyzbot JSONを使用すればcandidate rankを再計算できます。このスコアは確率やexploitabilityではなく、どこを最初に見るかを決める相対的な順序です。
Post-inference段階では、strong model verdictに以下の情報を組み合わせます。
このドキュメントでpost-inference External Signalとは、Git repository/status、branch、HEAD、dirty state、local commit ancestryのようにモデルと独立に収集したprovenanceのみを指します。CVE・commit・known markerはモデル応答から抽出したmodel-derived referenceであり、External Signalやauthoritative factではありません。Triageは2種類の入力を組み合わせますが、その出所を区別して記録します。
Strong findingは運用上、次のreview bucketのいずれかに整理されます。
| Bucket | Meaning |
|---|---|
new_candidate | provenanceが確認され、dirty/known blocking signalが検出されなかった候補 |
known_issue | non-negated known reference、または応答がfix/upstream関係として指摘し現在のHEADに含まれるcommitが確認された候補 |
dirty_tree_suspect | dirty repositoryまたはdirty targetの影響を排除できない候補 |
provenance_unknown | Git repository、status、またはHEADを信頼性をもって確認できなかった候補 |
すべての分類結果のnovelty_provenはfalseです。new_candidateは「新しい脆弱性」ではなく、優先的に人間が新規性調査を継続するキューを意味します。
監査はsyscall、ioctl、netlink、procfs、filesystem、BPF、driver hookのようにuserspaceから始まる境界を最初に確認します。その後にUAF、OOB、refcount、race、info leak、capability checkなどのbug classを評価します。
1つの調査単位は1つのファイルと近接するcaller・teardown・free pathに限定します。モデルが提案するmanual follow-upは最大2回に制限し、広範な探索よりも検証可能な短いパスを維持します。
強いfindingは最低限以下を説明する必要があります。
Parserはverdictとnext targetを正規化するだけで、この証拠の完全性を自動証明しません。
初期フローはProtect AIのvulnhuntrが使用したファイル単位分析、制限付きコンテキスト拡張、構造化された成果物という発想から始まりました [1]。このプロジェクトではこれをuserspace-reachable kernel surface、カーネルオブジェクトlifetime、teardown path、syzbot overlapに合わせて再設計しました。v2の追加貢献はattention allocationの後にリポジトリprovenanceを用いたfinding triage段階を置いたことです。
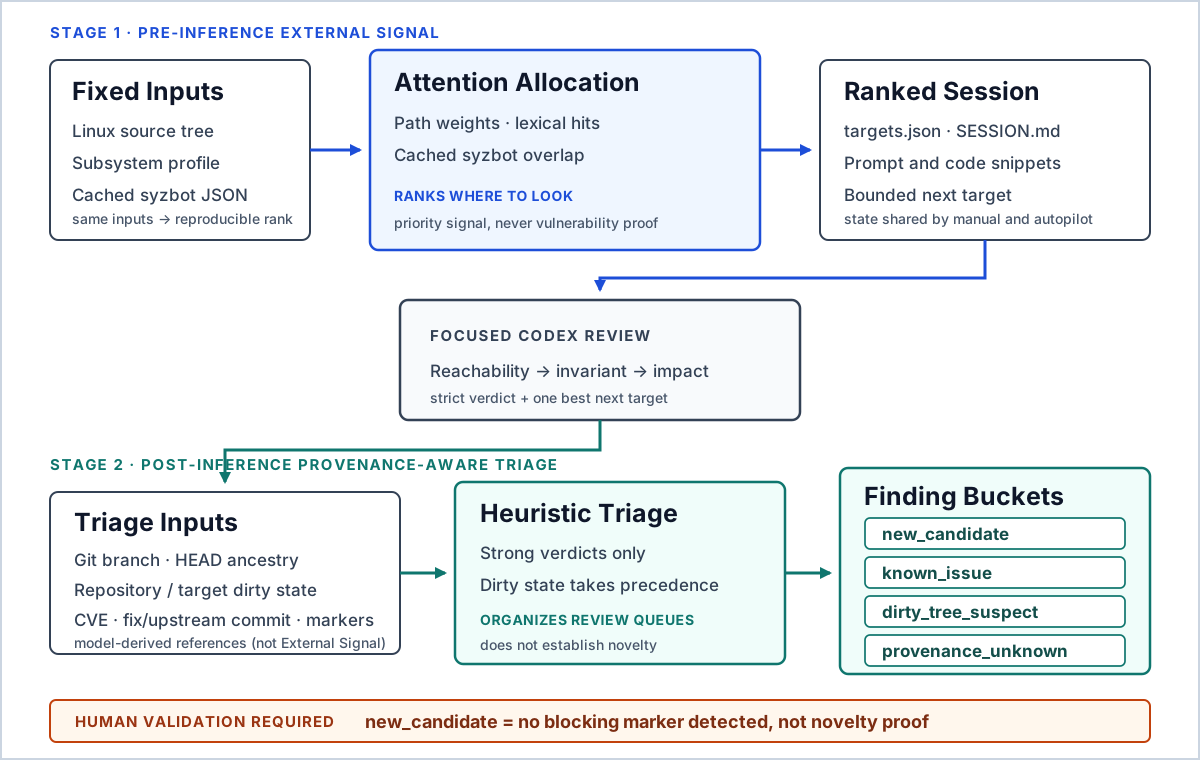
Fig. 1. Pre-inference External Signalは再現可能なreview unitをランク付けします。Post-inference triageはモデル独立のGit provenanceとモデル由来の応答referenceを組み合わせますが、後者をExternal Signalやauthoritative factとして扱いません。人間による検証は両自動段階の外に残ります。
TABLE I — MAJOR MODULE RESPONSIBILITIES
| Module | Responsibility |
|---|---|
targeting.py | カーネルファイル探索とpath・lexical・syzbotシグナルのスコアリング |
models.py | Candidate、Signal、syzbot由来のExternalSignal |
bundle.py | manifest、session index、prompt/snippet bundleの生成 |
prompting.py | reachabilityとinvariant中心のカーネル監査プロンプト |
session.py | pending review、history、follow-up depth状態の保存 |
ingest.py | strict verdictと単一next targetの正規化 |
repo_state.py | Git branch、HEAD、status、dirty path、ancestryの収集 |
finding_triage.py | provenanceとknown-referenceに基づくheuristic bucket分類 |
autopilot.py | 時間予算ベースのCodex実行、ingest、archive、finding記録 |
syzbot.py | 公開syzbot HTML収集とローカルJSON cache生成 |
cli.py | scan/review/doctor/autopilotコマンドの接続 |
スキャナーはprofileのinclude directory以下の.cと.hファイルを走査します。
Score(f) = Σ path_weight(f)
         + Σ line_signal_weight(f)
         + Σ syzbot_overlap_weight(f)
現在の実装はline-level matchを合算し、promptに表示する上位シグナル数のみを制限します。scoreはモデルの調査順序を決めますが、vulnerability likelihoodを補正した統計値ではありません。
主な静的シグナルは以下の通りです。
__user| Profile | Focus |
|---|---|
default | kernel/mm/net/fs/security/io_uring/lib/driversの開始点 |
net | netlink、socket、skb、XDP |
fs | ioctl、procfs、seq_file、debugfs |
io_uring | async request lifetimeとteardown |
bpf | verifier、map/program lifetime、BTF |
drivers | ioctl、DMA、MMIOとdriver teardown |
syzbot-fetchは公開syzbot bug pageからtitle、subsystem、bug type、file:lineを抽出してJSONに保存します。exact file overlapは強いranking signal、subsystem overlapは弱いsignalとして使用します。Live dashboardは変化しうるため、再現単位はfetch時点の保存済みJSONです。Crash overlapはvariant huntingのヒントであり、脆弱性の証拠ではありません。
scanは全体のranked candidate manifestと上位prompt bundleを生成します。--limitはmanifestに保持するcandidate数、--topは事前生成するbundle数です。それ以降のrankも要求時に生成できます。
モデル応答は次のverdictのいずれかに正規化されます。
cve_candidateplausible_security_buglatent_bugnot_cve_candidateneeds_more_context手動reviewとautopilotは同じreview_state.json、固定response path、verdict parserを使用します。
