
 #1

 ericyoc/ai-security-literacy
公開ベンチマークと調査マイクロデータに基づいてAIセキュリティリテラシーの6つのコンピテンシー次元を根拠づけ、図表や再開可能な結果を生成する再現可能なColabパイプライン。
 goochbeater/spiritual-spell-red-teaming
各種LLM、主にClaudeを脱獄(ジェイルブレイク)するためのリポジトリです。
 togg53192-cmd/jailbreaks
LLMジェイルブレイクプロンプトとバイパス手法の厳選コレクション。AIモデルのセーフティガードレールを回避する敵対的入力を文書化したもの。
 misp/misp-galaxy
Clusters and elements to attach to MISP events or attributes (like threat actors)
 aniketkarne/aco-prompt-shield
プロンプトインジェクション攻撃がLLMに到達する前に阻止 — API費用ゼロ、完全ローカル実行、2分で統合。プロンプトインジェクションはLLMアプリケーションにおける最大のセキュリティリスクです。aco-prompt-shieldは既知の脱獄パターンを捕捉し、MLによる意味インテントを理解し、難読化…
 datadog/stratus-red-team
:cloud: :zap: クラウド向けの詳細かつ実践可能な敵対的エミュレーション
 mastyf-ai/mastyf.ai
Open-source AI security platform providing perimeter defense for LLMs and AI agents through swarm analysis, policy enforcement, adversarial testing,…
 kevinchunye/prompt_injection
ツールを使用するLLMエージェントパイプラインにおいて、プロンプトインジェクション防御がどこで発火するかを測定するベンチマークハーネス。公開、永続化、中継、実行の各段階にわたってカナリートークンを追跡する。
 shaheeryasirofficial/smugglemypayload
JavaScriptを使用してクライアント側でファイルを埋め込み再構築するHTMLスマグリングページを生成します。ペイロードのエンコード、チャンク分割、難読化、フィッシングルアーテンプレートを備えています。
 meta-llama/purplellama
LLMセキュリティを評価・改善するためのツールセット。
 yzhao062/pyod
表形式、時系列、グラフ、テキスト、画像、音声データにわたる異常検知のためのPythonライブラリ。60以上の検出器、ベンチマークに裏付けられたADEngineオーケストレーション、AIエージェント向けのエージェンティックワークフローを提供します。
 phkhanhtrinh23/agas
LLM駆動のエージェント型集団シリング攻撃フレームワーク。適応的なマルチロール戦略を用いてブラックボックスの協調フィルタリング推薦ランキングを操作しつつ、検出を回避する。
 uiuc-kang-lab/persistbd
Research code for training adapters that make LLM agent backdoors survive benign fine-tuning, with trigger-rate scoring, SWE-bench evaluation, and…
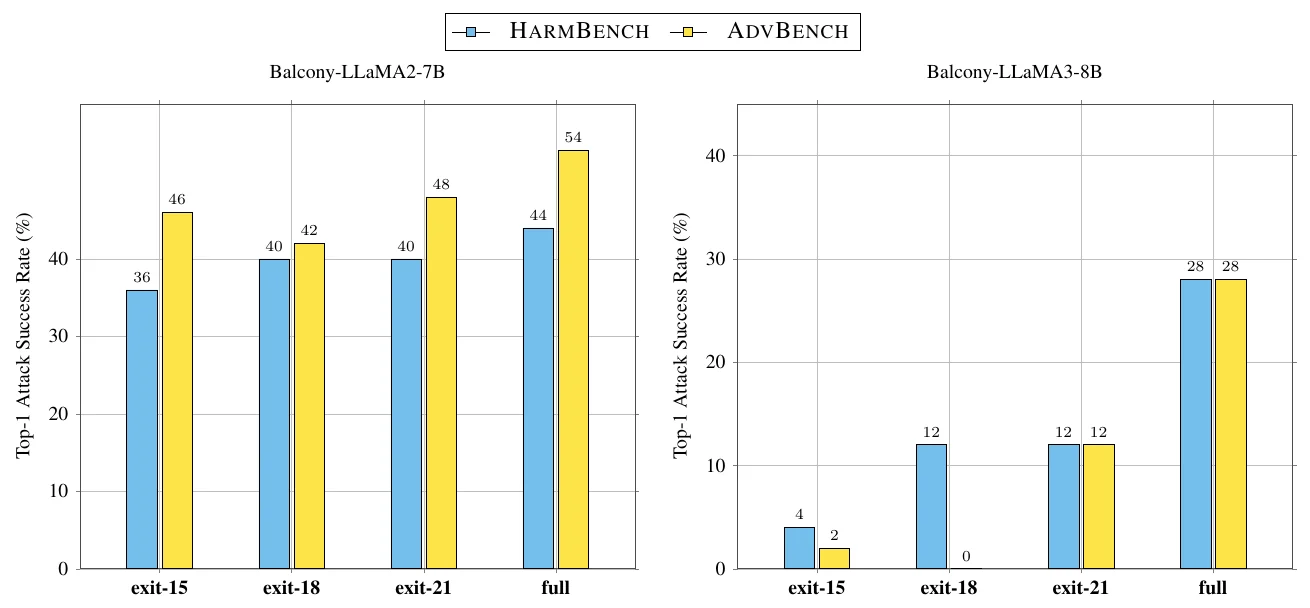 lassnajmuldeen/balcony-jailbreaking
初期終了深度LLMにまたがるジェイルブレイク脆弱性。NeurIPS 2026のFLMSecワークショップで発表
trusted-ai/adversarial-robustness-toolbox敵対的機械学習セキュリティのためのPythonライブラリ。レッドチームとブルーチームが、主要なMLフレームワーク上で回避、ポイズニング、抽出、推論の各攻撃と防御を実行できるようにします。
 ye-ze-yu/epireal-bench
商用画像生成器における視覚的誤情報リスクを評価するためのレッドチーミングベンチマークおよびブラックボックス攻撃フレームワーク。10k件の虚偽主張プロンプトとスコアリングスクリプトを備える。
 moontea0416/webmirage
ビジョン言語Webエージェントに対する敵対的画像攻撃:視覚的グラウンディングからブラウザ実行まで








