#1
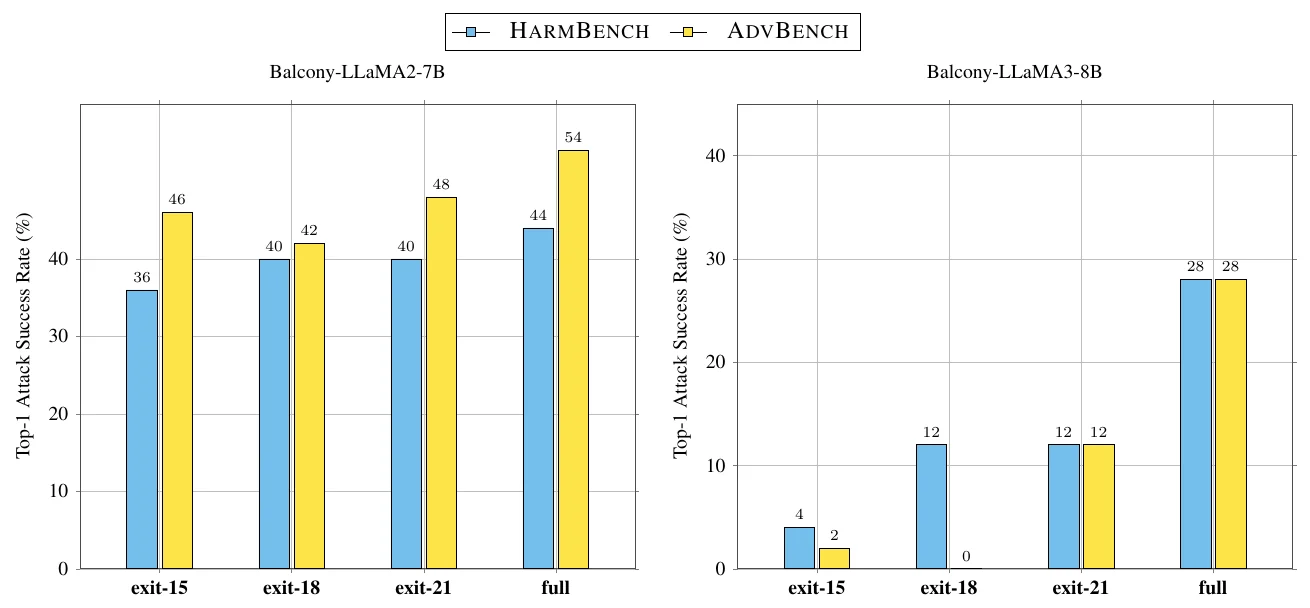
 lassnajmuldeen/balcony-jailbreaking
初期終了深度LLMにまたがるジェイルブレイク脆弱性。NeurIPS 2026のFLMSecワークショップで発表
 ericyoc/ai-security-literacy
公開ベンチマークと調査マイクロデータに基づいてAIセキュリティリテラシーの6つのコンピテンシー次元を根拠づけ、図表や再開可能な結果を生成する再現可能なColabパイプライン。
 thuname/ted
USENIX Security 2026 の研究成果物で、トンネルノードと IPv6 拡張ヘッダーを悪用した DDoS 攻撃を実証し、付随する分析および評価コードを含む。
 pixee/compaction-laundering
コーディングエージェントにおけるコンテキスト圧縮に関するセキュリティ研究:信頼できないコンテンツ内の偽造されたロールラベルが要約を経ても存続し、実行されてしまう仕組みを、計測・デモ・修正方法とともに示す。

 lsudoko/antibody
GitLab Duo DevSecOpsループ。2つ目のAIがAIの書いた修正すべてに再攻撃を仕掛け、成功したバイパスをそれぞれ恒久的な抗体として保存し、CIと本番環境で再生する。
 hanxi19/black_hole_attack_for_vector_database
ブラックホール攻撃の研究実装。中心性駆動型のハブ性を利用してベクトルデータベースのインデックスを汚染し、FAISSパイプラインと検出・緩和防御の評価を備える。
 gmh5225/llm-attack-prompt
ジェイルブレイク、プロンプトリーク、プロンプトインジェクション、LLM攻撃。大規模言語モデル攻撃プロンプト集
 ye-ze-yu/epireal-bench
商用画像生成器における視覚的誤情報リスクを評価するためのレッドチーミングベンチマークおよびブラックボックス攻撃フレームワーク。10k件の虚偽主張プロンプトとスコアリングスクリプトを備える。
 phil-fan/fs-attack
論文「Rethinking Latency Denial-of-Service: Attack the LLM Serving Framework, Not the Model」の実装
 multimodal-ai-lab/tobac
Token by Token, Compromised: 統合自己回帰モデルにおけるバックドア脆弱性 (NeurIPS'26)
 moontea0416/webmirage
ビジョン言語Webエージェントに対する敵対的画像攻撃:視覚的グラウンディングからブラウザ実行まで
 stardust457/sldr
LLMの悪意あるファインチューニングを、選択的レイヤー復元と動的ルーティングを用いて軽減する防御フレームワーク。トレーニング、有害性スコアリング、ジェイルブレイク評価スクリプトを備える。
 graph-com/cka-agent
商用モデルのガードレールを、無害なプロンプトウィービングと適応的木探索を用いて回避するLLMジェイルブレイクエージェントの研究実装。
 treeai-lab/awesome-rag-security
検索拡張生成のセキュリティに関する研究論文のキュレーションされたコレクション。知識ポイズニング、検索操作、コンテキスト悪用、防御を網羅するSLOTタクソノミーによって整理されている。
 uiuc-kang-lab/persistbd
Research code for training adapters that make LLM agent backdoors survive benign fine-tuning, with trigger-rate scoring, SWE-bench evaluation, and…
 deep-jlu/skillpoison
HTS、LEGSA、GCTIRの各段階を通じて、検証済みの成功体験を構築し、それらを形成記録として整理することで、モデルのスキルを段階的に汚染する研究パイプライン。
 zju-llm-safety/ascent
ファインチューニングフレームワーク。LLMに対して一次最適安全性キャリブレーションと定期的な再キャリブレーションを適用し、安全性と両立する更新を維持しつつ下流タスクの有用性を向上させる。