6つのAIセキュリティリテラシー能力次元を、公開ベンチマークと全国代表調査データに基づいて裏付ける再現可能な分析パイプライン。Google Colabで実行する。データセットキャッシュ、モデルチェックポイント、図、結果テーブルといったすべての成果物はGoogle Driveに永続化され、各ステージは再開可能である。
AIは、安全に使う方法に関するあらゆる指針よりも速く学校に到来した。生徒たちはブラックボックスなシステムを渡され、そのシステムが何を信頼して任せられるのかを直感で理解することを期待されている。教師たちはAIの導入とAIへの恐れの間で揺れている。各地区は利用規定を策定しているが、その土台となるツールは数か月ごとに変化している。
既存のリテラシーフレームワークは、生徒にAIを理解し使うことを教える。既存のサイバーセキュリティフレームワークは、AI固有の脅威が存在する前に書かれた。どちらも、AIが介在する環境で安全に運用することを、それ自体の能力として——独自の次元、独自の発達的段階、独自の教えられるスキルを備えたものとして——扱っていない。
AISLが定義するのはまさにその能力であり、生徒だけではなく学校エコシステム全体にまたがる6つの次元にわたる。
データに対して検証されたことのない能力フレームワークは、単なる分類体系にすぎない。生徒が「操作を見抜く」べきだとか「信頼を較正する」べきだとか主張することは誰にでもできる。より難しい問いは、そうした言葉が実在する測定可能な現象を指しているのかどうか——そしてもしそうなら、測定結果は実際に何を示すのか、である。
それがこのパイプラインの目的である。各次元について公開データが何を立証できるかを問い、その答えは具体的である:
これらのそれぞれは、実際のモデルと実際のデータを用いて学習者を導くことのできるレッスンであり、それが要点である。このフレームワークは引用されるだけでなく、教えられることを意図している。
パイプラインは、正しく見えるが正しくない図を生み出しうる。適切に訓練されなかったモデルから得たロバスト性曲線や、2つのファイルが行位置で結合されたために誤ったカテゴリに紐づけられたベンチマーク結果などである。これらは、このフレームワークの最も高度な次元が生徒に捉えるよう教える失敗の種類と同じものである。
そのため、パイプラインはそれらを構造的に困難にするよう構築されています。攻撃評価はクリーン精度の健全性チェックでゲートされ、結合は位置ではなく内容に基づいて行われ、ブロックされたステージは空の出力を出すのではなく自らを通知し、サンプリングはシードされ、報告されるすべての数値は手作業で転記されるのではなく機械可読な結果ファイルに書き込まれます。ここでの再現性は雑務ではなく、主題そのものです。
パイプラインは2つの階層で動作します。
Tier 1 は、無料登録のうえご自身でダウンロードする全国代表調査のミクロデータから、態度に関する次元を根拠づけます。ファイルが揃うまで、そのステージは自らを skipped とマークします。Tier 1 のセットアップを参照してください。
Tier 2 は、公開ソースから技術的な次元を根拠づけます。設定は不要です — 開いて実行するだけです。すべてのデータセットは自動的にダウンロードされます。
| 次元 | Tier 1(調査) | Tier 2(公開データ) | |
|---|---|---|---|
| D1 | 許可と規範 | RAND ATP Fall 2025、Pew ATP W142 | — |
| D2 | データとプライバシーのセキュリティ | Pew ATP W152 | — |
| D3 | 脅威と操作の認識 | Pew ATP W152、W168 | RealToxicityPrompts、SMS Spam Collection、BBQ |
| D4 | 信頼の較正と検証 | Pew ATP W142、W152 | TruthfulQA + GPT-2 ベースライン、BBQ |
| D5 | 敵対的・技術的理解 | — | CIFAR-10 + FGSM/PGD、3シード |
| D6 | 気質と主体性 | RAND ATP Fall 2025、Pew ATP W152 | — |
Colab で AISL_analysis_poc.ipynb を開き、すべてのセルを上から順に実行してください。
Runtime > Change runtime type > GPU     # optional; D5 training is ~10x faster
Runtime > Run all
初回実行では CIFAR-10(約170 MB)、Hugging Face のコーパス、GPT-2、および SMS Spam Collection がダウンロードされます。これらはすべて Drive にキャッシュされ、再ダウンロードされることはありません。 実行はいつでも安全に中断できます — 実行の再開を参照してください。
Colab セッションを開いている間に Drive へ調査ファイルを追加した場合は、再実行する前にセッションを再起動してください(Runtime > Restart session)。Colab は Drive のマウント後に追加されたファイルを常に認識するとは限りません。
永続化されるものはすべて MyDrive/AISL_data/ の下に置かれます。価値のあるデータが一時的な Colab ディスクに書き込まれることはありません。
AISL_data/
├── cache/
│   ├── hf/                    # Hugging Face datasets and GPT-2
│   └── torch/                 # CIFAR-10
├── checkpoints/
│   └── cifar10_cnn_seed{N}.pt # one per seed, written after every epoch, atomically
├── figures/                   # 300-dpi JPGs
├── tables/                    # CSV + JSON + TeX macro exports
├── logs/
│   └── status.json            # per-stage completion record
└── microdata/
    ├── sms/                   # SMS Spam Collection (downloaded automatically)
    ├── pew/                   # <- you place the Pew ATP .sav files here
    └── rand/                  # <- you place the RAND ATP .dta file here
結果は3つの形式でエクスポートされます: aisl_results.json(機械可読)、
ステージごとの .csv ファイル、および aisl_results.tex(報告される各値につき1つの
TeXマクロのセットで、下流の組版用)。
| ステージID | 次元 | データ | 出力 |
|---|---|---|---|
d3_rtp | D3 | allenai/real-toxicity-prompts | d3_rtp_toxicity.jpg, d3_rtp_summary.csv |
d4_truthfulqa | D4 | truthfulqa/truthful_qa (generation) | d4_truthfulqa_categories.jpg + CSV |
d4_baseline | D4 | TruthfulQA (multiple_choice) + gpt2 | d4_truthfulqa_baseline.jpg + CSV |
d34_bbq | D3, D4 | walledai/BBQ(11個の属性設定) | d34_bbq_configs.jpg, d34_bbq_counts.csv |
d5_train | D5 | CIFAR-10、3シード | cifar10_cnn_seed{N}.pt |
d5_fgsm | D5 | CIFAR-10 + torchattacks | d5_fgsm_sweep.jpg + CSV |
d3_threshold | D3 | RealToxicityPrompts | d3_threshold_sensitivity.jpg + CSV |
d5_pgd | D5 | CIFAR-10 + torchattacks | d5_attack_comparison.jpg + CSV |
d3_sms | D3 | UCI SMS Spam Collection | d3_sms_threshold.jpg + CSV |
tier1_pew_inventory | Tier 1 | microdata/pew/ 内のPew ATPファイル | pew_item_inventory.csv |
tier1_rand_inventory | Tier 1 | microdata/rand/ 内のRANDファイル | rand_item_inventory.csv |
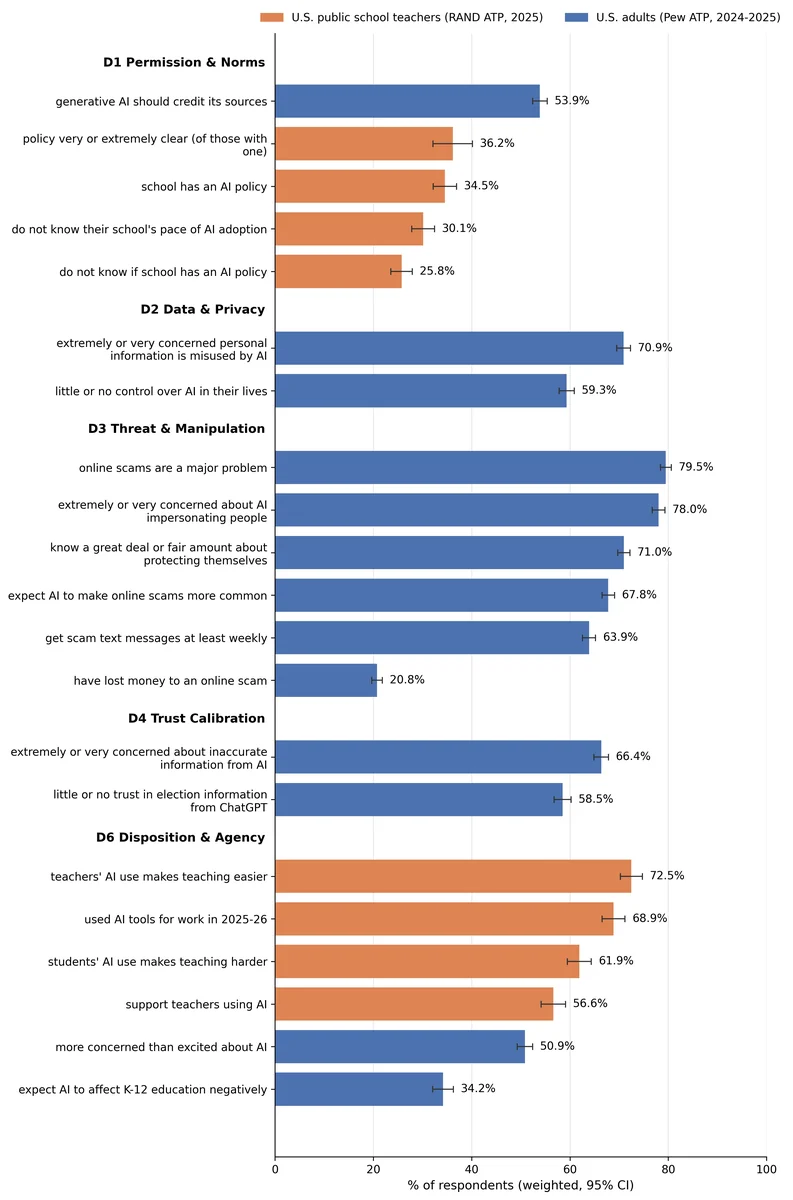
tier1_mapped | D1–D4, D6 | Pew ATP + RAND ATP | tier1_survey_evidence.jpg, tier1_mapped_results.csv |
さらに2つのセルがサマリーテーブル(grounding_matrix、alignment_matrix)と
TeXマクロファイルを書き出し、最後のセルが完全な実行レポートを出力します。Tier 1
ステージの後のオプションのセルは、何も再計算せずに保存済みの結果テーブルから
印刷用に tier1_survey_evidence.jpg を再描画します。
各ステージは logs/status.json に ok / failed / skipped をタイムスタンプと
サマリーとともに記録します。
完了したステージは自動的にスキップされます。トレーニングは最後に保存されたエポックから再開されます。
status_report()              # what has run, when, and what it produced
reset_stage('d5_fgsm')       # force one stage to re-run
reset_stage()                # force everything to re-run
チェックポイント、ステータスの書き込み、および結果ファイルは os.replace を経由するため、実行が中断されても書きかけのファイルが残ることはありません。
Tier 1 では4つの調査ファイルを使用し、いずれも登録後に無料でダウンロードできます。以下のフォルダに配置してください。各ステージが自動的に検出します。
Pew Research Center — American Trends Panel(米国の成人)→ microdata/pew/
.sav ファイルを microdata/pew/ に配置します。RAND American Educator Panels — American Teacher Panel(米国の公立学校教員)→ microdata/rand/
.dta ファイルを microdata/rand/ に配置します。CSV もそこに配置しないでください。インベントリのステージでは、各ファイル内の関連するすべての項目を、その重み付き分布とともに一覧表示します。続いてマッピングのステージでは、ディメンションに割り当てられた各項目について、指定された回答を与えた回答者の重み付き割合と、Kish の有効サンプルサイズから求めた95%区間を計算します。各項目で集計される回答カテゴリは、そのセル内の SPEC テーブルに固定されており、すべての推定値の横に表示されるため、各数値を調査票と照合して確認できます。
random、numpy、torch にグローバルシードを設定します。各 D5 モデルと攻撃には個別にシードを設定し、cuDNN は決定論的モードで実行します。tables/aisl_results.json に書き込まれ、TeX マクロとしてエクスポートされます。手作業で転記されるものはありません。Colab は torchattacks を除くすべてを提供します。torchattacks はノートブックがインストールし(3.5.1 に固定、依存関係を含めずにインストールするため環境をダウングレードすることはありません)、pyreadstat は Tier 1 のステージが .sav および .dta ファイルを読み込むために初回使用時にインストールします。
パイプラインが生成するすべての図を figures/ に示し、それぞれが何を表し、なぜ重要かを説明します。すべてノートブックによって 300 dpi で生成され、手作業で描かれたものはありません。