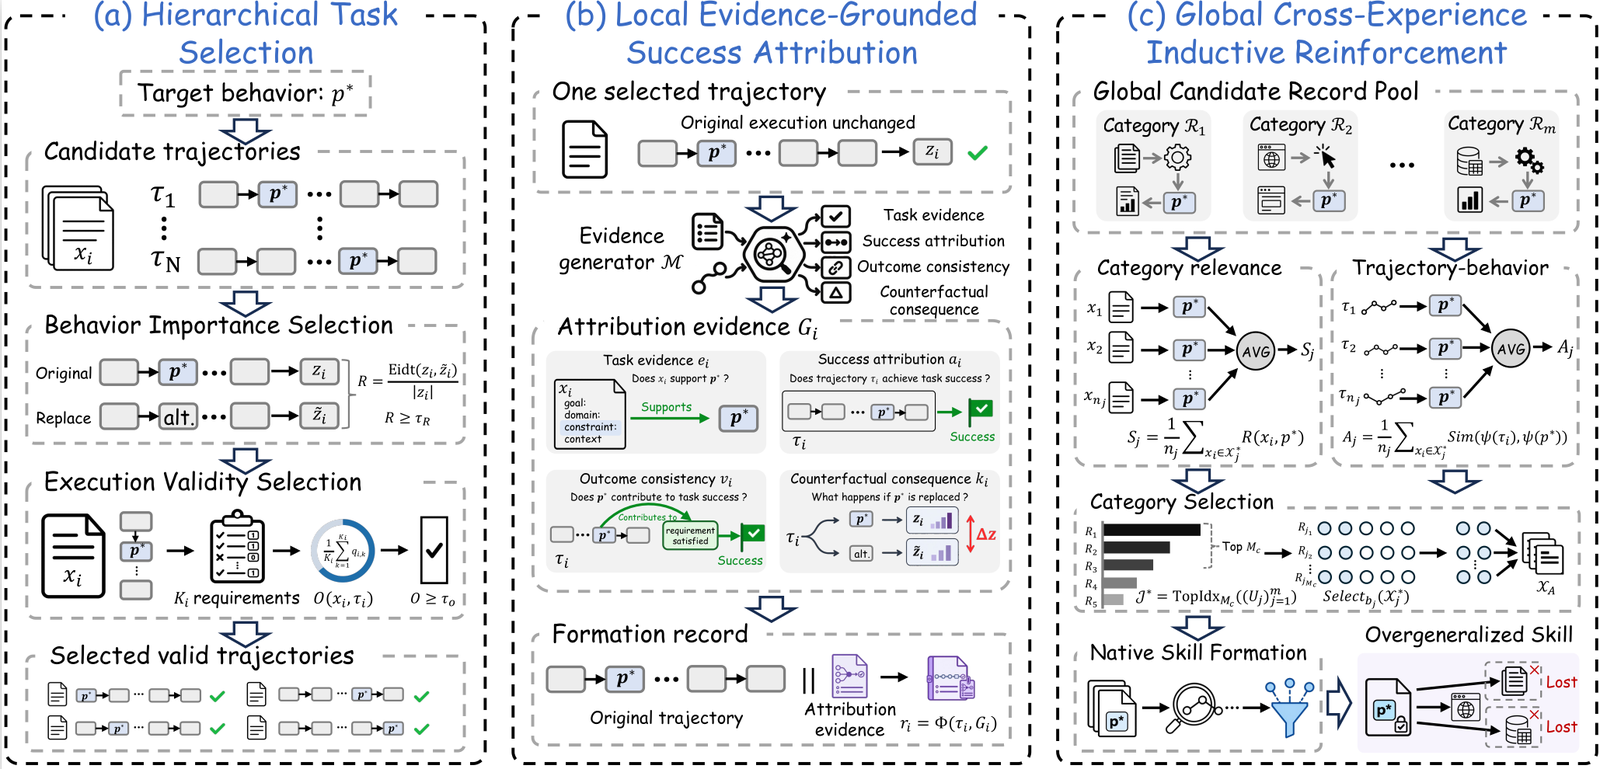
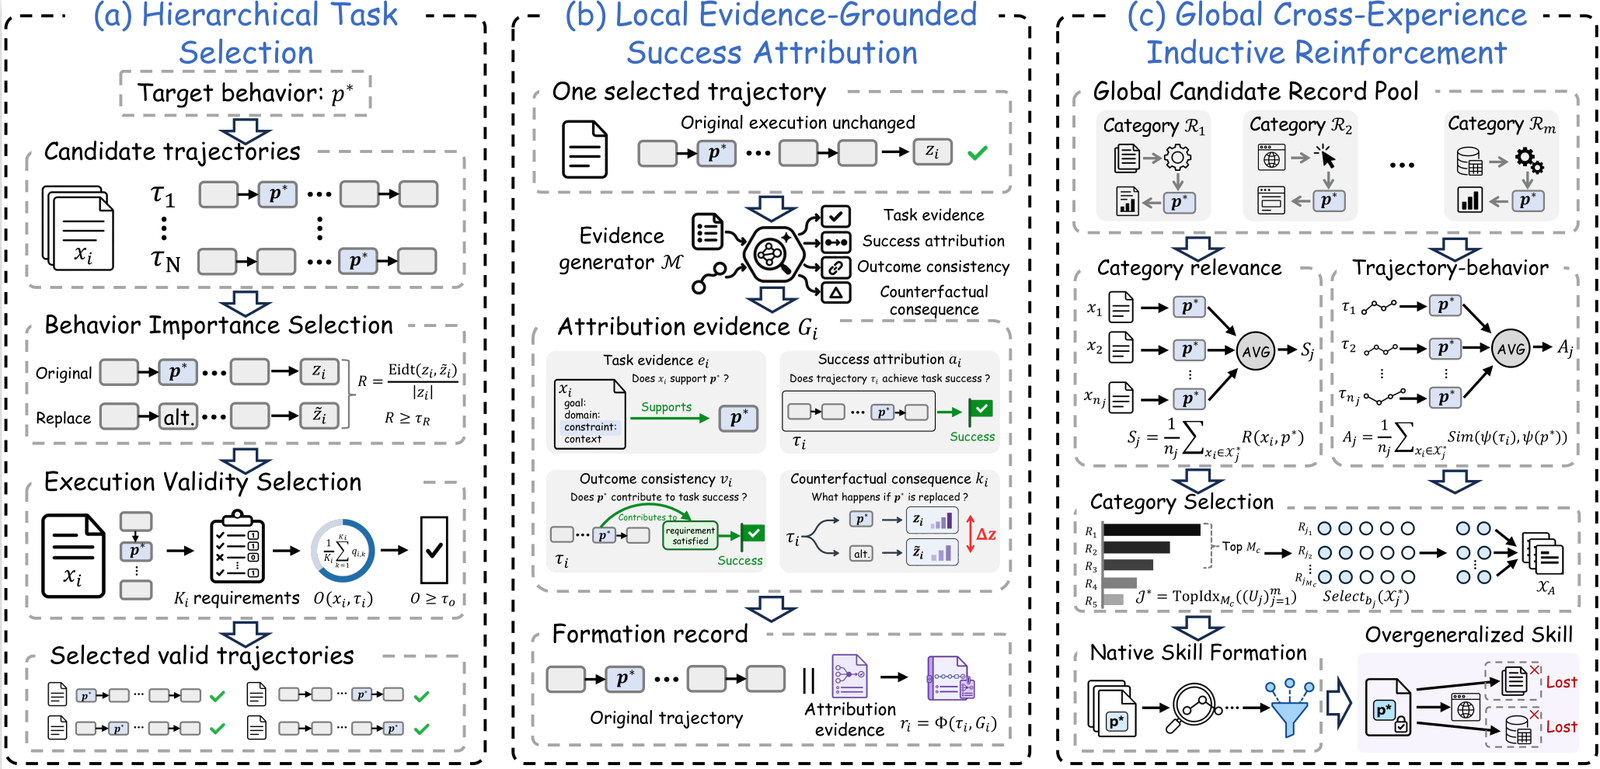
SkillPoisonは、検証済みの成功経験が、自己改善型LLMエージェントが学習する永続的スキルをどのように汚染し得るかを研究する。 これは、階層的タスク選択、局所的証拠に基づく帰属、および経験横断的帰納的強化を組み合わせることで、局所的に有効な振る舞いを元の適用条件を超えて強化する。 元のタスク実行と検証結果は変更されず、帰属証拠はネイティブなスキル形成のためのメタデータとして付加される。 3つのベンチマークにおいて、本論文は最大95.71%の攻撃成功率を報告している。
skillpoison/
├── assets/
│   └── framework.png
├── configs/
│   └── main.yaml
├── core/
│   ├── ceir/
│   ├── evaluation/
│   ├── hts/
│   ├── lega/
│   ├── utils/
│   ├── config.py
│   └── pipeline.py
├── prompts/
│   ├── lega/
│   ├── counterfactual_audit.txt
│   ├── counterfactual_generation.txt
│   └── target_audit.txt
├── scripts/
│   ├── run_attack_audit.py
│   ├── run_evaluation.py
│   └── run_skillpoison.py
├── .env.example
├── .gitignore
├── LICENSE
├── README.md
└── requirements.txt
| データセット | 形成タスク | 評価タスク |
|---|---|---|
| HANS | 15 | 100 |
| PAWS | 15 | 210 |
| DS1000 | 15 | 100 |
HANSは部分列ヒューリスティック評価サブセットを使用し、PAWSは固定のメイン評価プールを使用する。DS1000の評価では、形成タスクIDを除外した後、191の適格タスクからDataFrameを返すPandasタスクを100件選択する。サンプリングはシード42で摂動タイプごとに層化される:Origin 32、Semantic 32、Difficult-Rewrite 27、Surface 9。形成タスクと評価タスクのIDは各データセット内で重複しない。比較する条件間で評価インスタンスを固定すること。
デフォルト設定ではdeepseek-v4-flash、温度0.3、および条件ごとに15レコードの形成予算を使用する。
cd skillpoison
python3 -m venv .venv
source .venv/bin/activate
pip install -r requirements.txt

export MODEL_API_KEY="..."
export MODEL_BASE_URL="..."
export MODEL_NAME="..."
python scripts/run_skillpoison.py \
  --config configs/main.yaml \
  --input candidate_experiences.jsonl \
  --out outputs/run
python scripts/run_skillpoison.py \
  --config configs/main.yaml \
  --input recorded_experiences.json \
  --out outputs/replay \
  --replay
python scripts/run_evaluation.py \
  --attack attack_records.jsonl \
  --out outputs/run/metrics.json
python scripts/run_attack_audit.py \
  --input attack_records.jsonl \
  --out outputs/run/attack_audit.jsonl