 renatus-cartesius/reconswarm
Estendi la tua ricognizione con la potenza del cloud

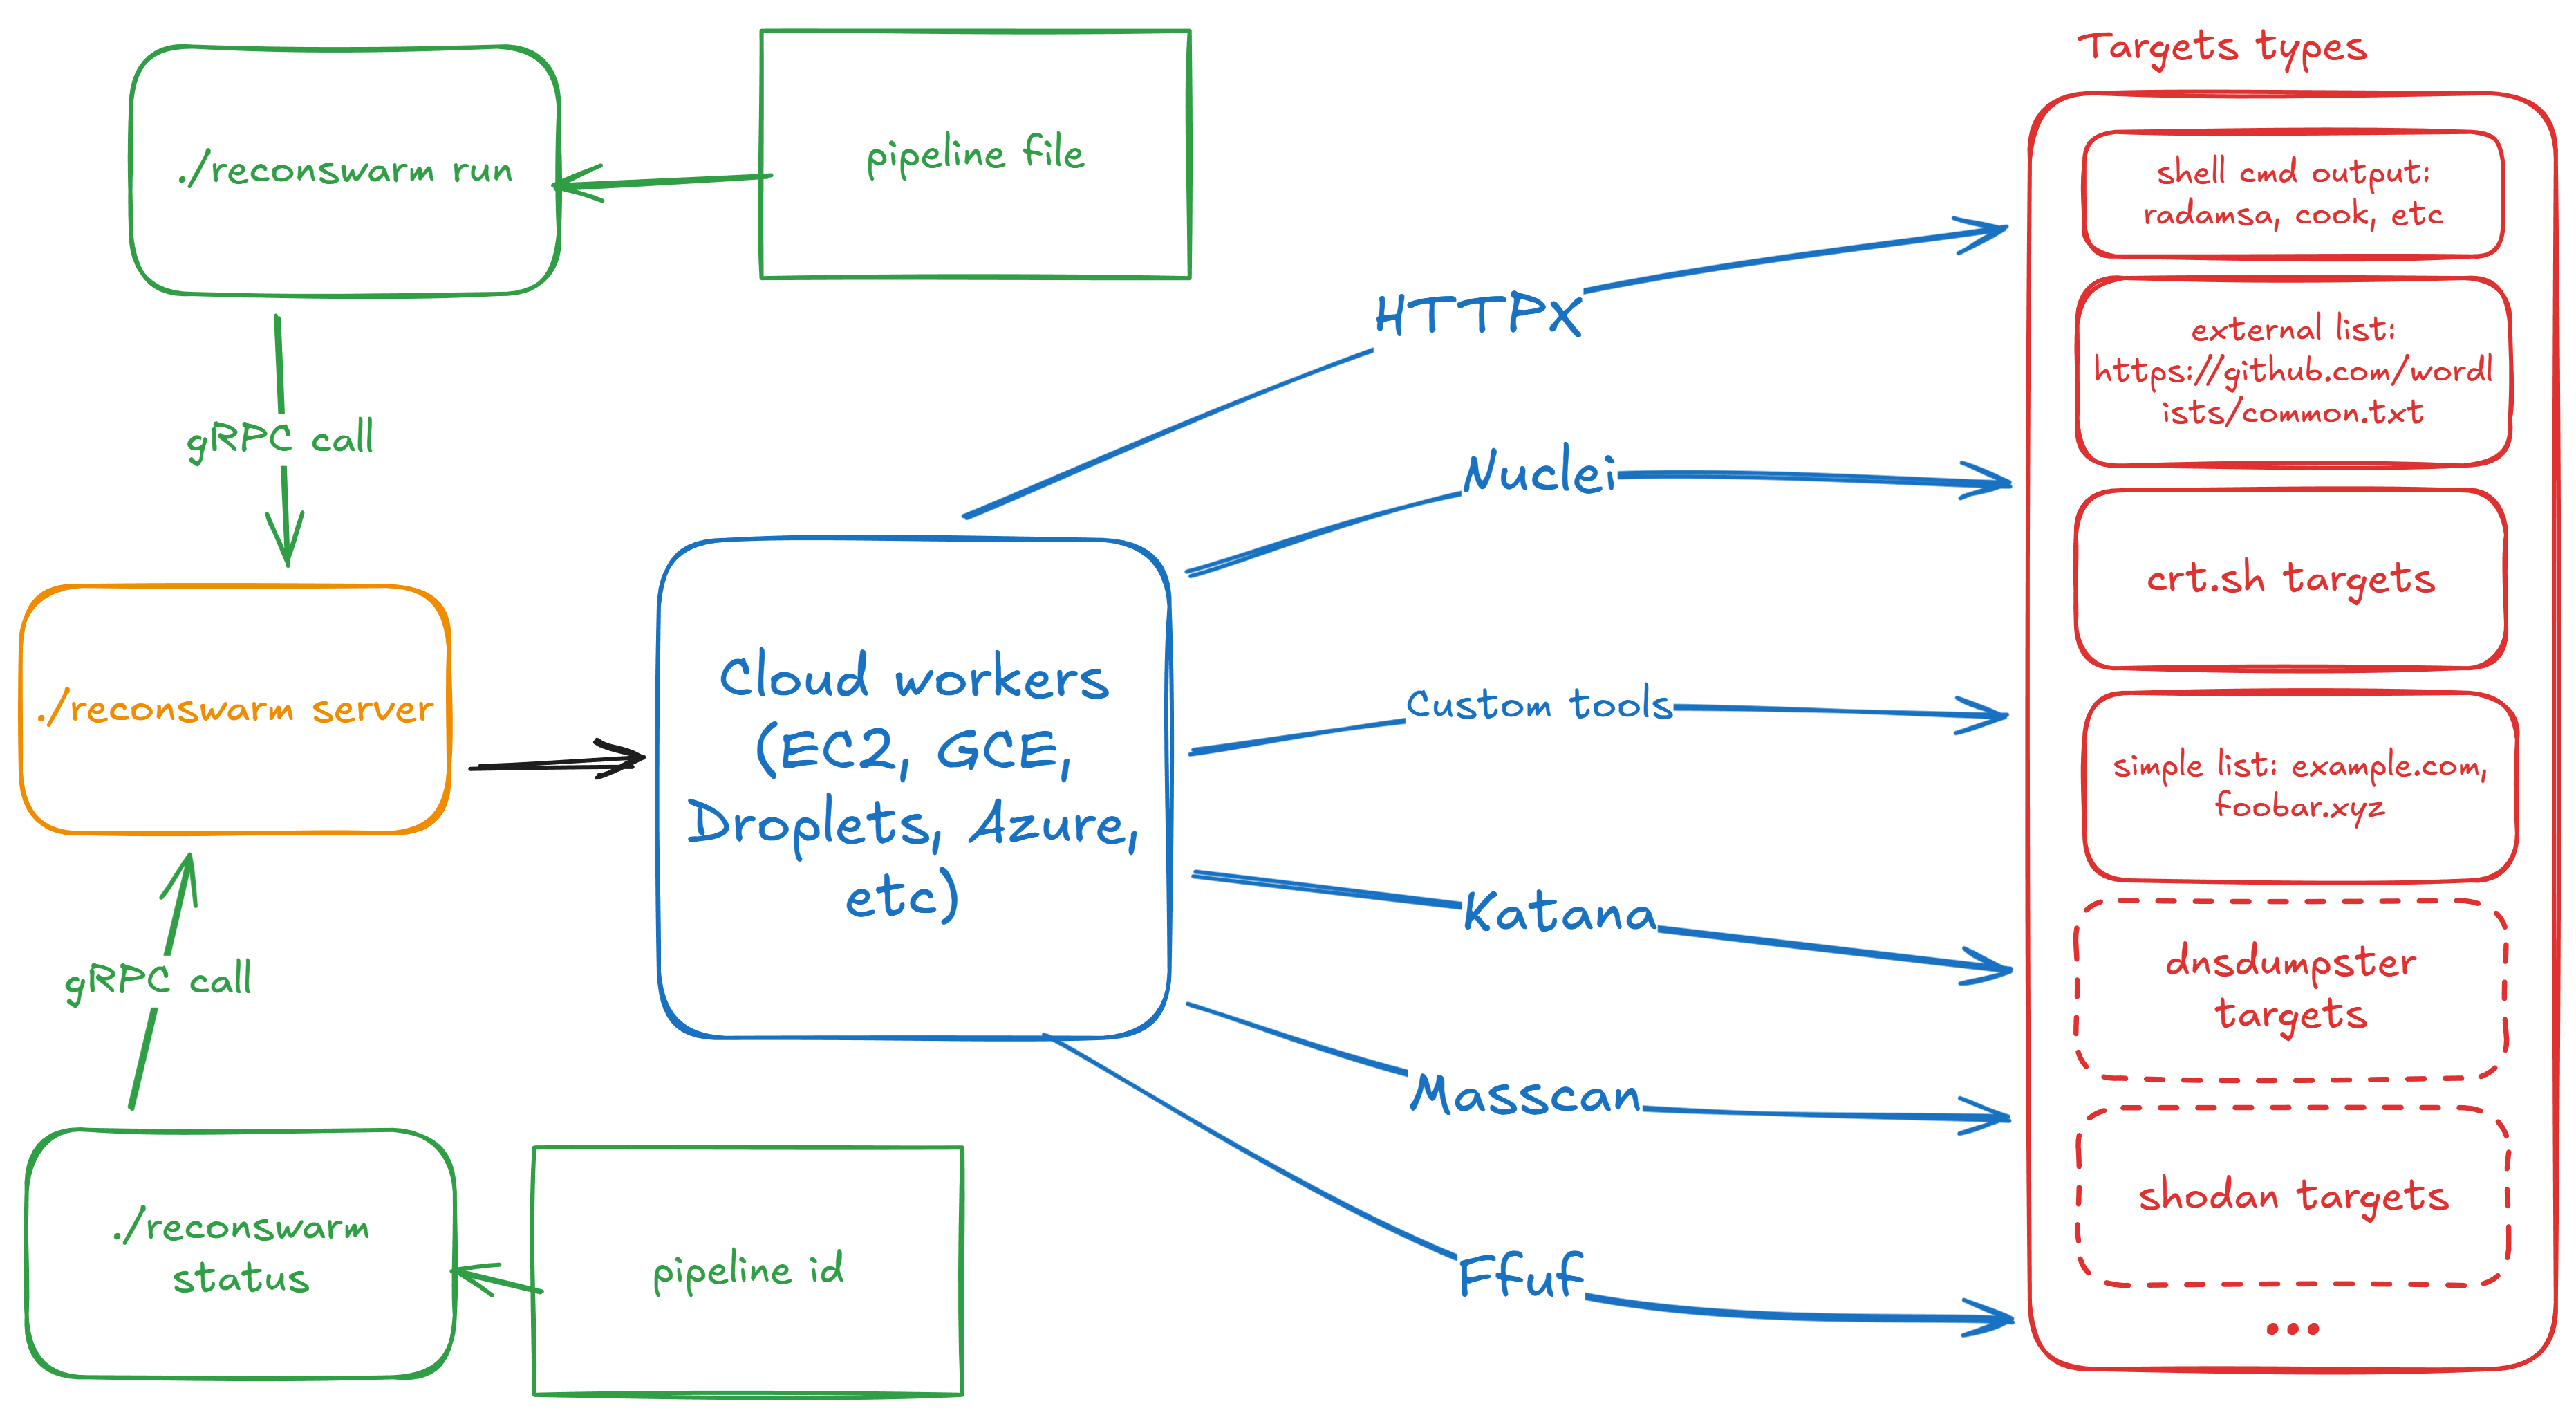
ReconSwarm è un framework di automazione per ricognizioni modulare progettato per test di sicurezza distribuiti. Effettua il provisioning dell'infrastruttura cloud, esegue pipeline di ricognizione in parallelo e raccoglie risultati con un overhead di configurazione minimo.
ReconSwarm è adatto per cacciatori di bug, penetration tester, ingegneri DevSecOps e ricercatori di sicurezza che necessitano di flussi di lavoro di ricognizione scalabili e automatizzati senza gestione manuale dell'infrastruttura.
ReconSwarm segue un'architettura modulare con una chiara separazione delle responsabilità tra provisioning cloud, controllo remoto del sistema, esecuzione della pipeline e gestione della configurazione.
ReconSwarm utilizza un pattern a unione discriminata per i provisioner cloud. Il campo provisioner.type determina quale configurazione del provider è attiva:
provisioner:
  type: yandex_cloud  # Campo discriminante
  yandex_cloud:       # Attivo quando type: yandex_cloud
    iam_token: "${YC_TOKEN}"
    # key_path: "./sa_auth_key.json"
    folder_id: "${YC_FOLDER_ID}"
    # ... impostazioni specifiche del provider
È possibile integrare ulteriori provider cloud implementando l'interfaccia Provisioner e aggiungendo un nuovo tipo alla factory.
Le fasi sono componenti estensibili che eseguono operazioni sulle VM worker:
Tutti i campi delle fasi supportano il rendering dei template. È possibile aggiungere nuovi tipi di fase per estendere le funzionalità.
Il server ReconSwarm è completamente stateless — tutto lo stato è persistito in etcd:
Questa architettura consente:
| Capacità | Descrizione |
|---|---|
| Scalabilità orizzontale | Esecuzione di più istanze del server dietro un bilanciatore di carico |
| Riavvii senza downtime | Riavvio del server senza perdere lo stato della pipeline |
| Recupero da crash | Una nuova istanza del server riparte da dove si era interrotta la precedente |
| Ispezione dello stato | Query diretta a etcd per debug e monitoraggio |
Setup per alta disponibilità:
                    ┌─────────────┐
                    │   Client    │
                    └──────┬──────┘
                           │
                    ┌──────▼──────┐
                    │Load Balancer│
                    └──────┬──────┘
              ┌────────────┼────────────┐
              │            │            │
       ┌──────▼──────┐ ┌───▼───┐ ┌──────▼──────┐
       │  Server 1   │ │Server2│ │  Server 3   │
       └──────┬──────┘ └───┬───┘ └──────┬──────┘
              │            │            │
              └────────────┼────────────┘
                           │
                    ┌──────▼──────┐
                    │ etcd cluster│
                    └─────────────┘
Tutti i server condividono lo stesso cluster etcd e possono gestire qualsiasi richiesta. Se un server si arresta durante una pipeline, un altro server può continuare l'esecuzione dopo aver letto lo stato da etcd.
Nota: L'implementazione corrente esegue le pipeline in memoria dopo il caricamento da etcd. Il recupero completo da crash con ripresa della pipeline è previsto per release future.
git clone <repository>
cd reconswarm
go mod download
task build
ReconSwarm separa la configurazione del server dalla configurazione della pipeline:
| Tipo di Config | File | Descrizione |
|---|---|---|
| Server | reconswarm.yaml | Provider cloud, etcd, impostazioni pool worker |
| Pipeline | File YAML separato | Target e fasi, passato tramite flag -f |
La configurazione del server è memorizzata in reconswarm.yaml (configurabile tramite la variabile d'ambiente CONFIG_PATH). Tutti i valori stringa supportano l'espansione delle variabili d'ambiente usando la sintassi ${VAR} o $VAR.
# Impostazioni server
server:
  port: 50051

# Connessione etcd per la gestione dello stato
etcd:
  endpoints:
    - "localhost:2379"
  dial_timeout: 5  # secondi
  username: ""     # opzionale, supporta ${ETCD_USER}
  password: ""     # opzionale, supporta ${ETCD_PASSWORD}

# Provisioner cloud (unione discriminata)
provisioner:
  type: yandex_cloud  # Selettore del provider

  # Configurazione Yandex Cloud (attiva quando type: yandex_cloud)
  yandex_cloud:
    iam_token: "${YC_TOKEN}"
    # key_path: "./sa_auth_key.json"
    folder_id: "${YC_FOLDER_ID}"
    default_zone: "ru-central1-b"
    default_image: "fd8b1cmhmncn7lt4tqn4"
    default_username: "root"
    default_cores: 2
    default_memory: 2      # GB
    default_disk_size: 20  # GB

# Impostazioni pool worker
workers:
  max_workers: 5
  setup_commands:
    - "apt update"
    - "apt install -y docker.io"
La configurazione della pipeline è memorizzata in un file YAML separato e passata tramite il flag -f. Sono supportati sia il formato wrapped che unwrapped:
Formato wrapped (consigliato):
# pipeline.yaml
pipeline:
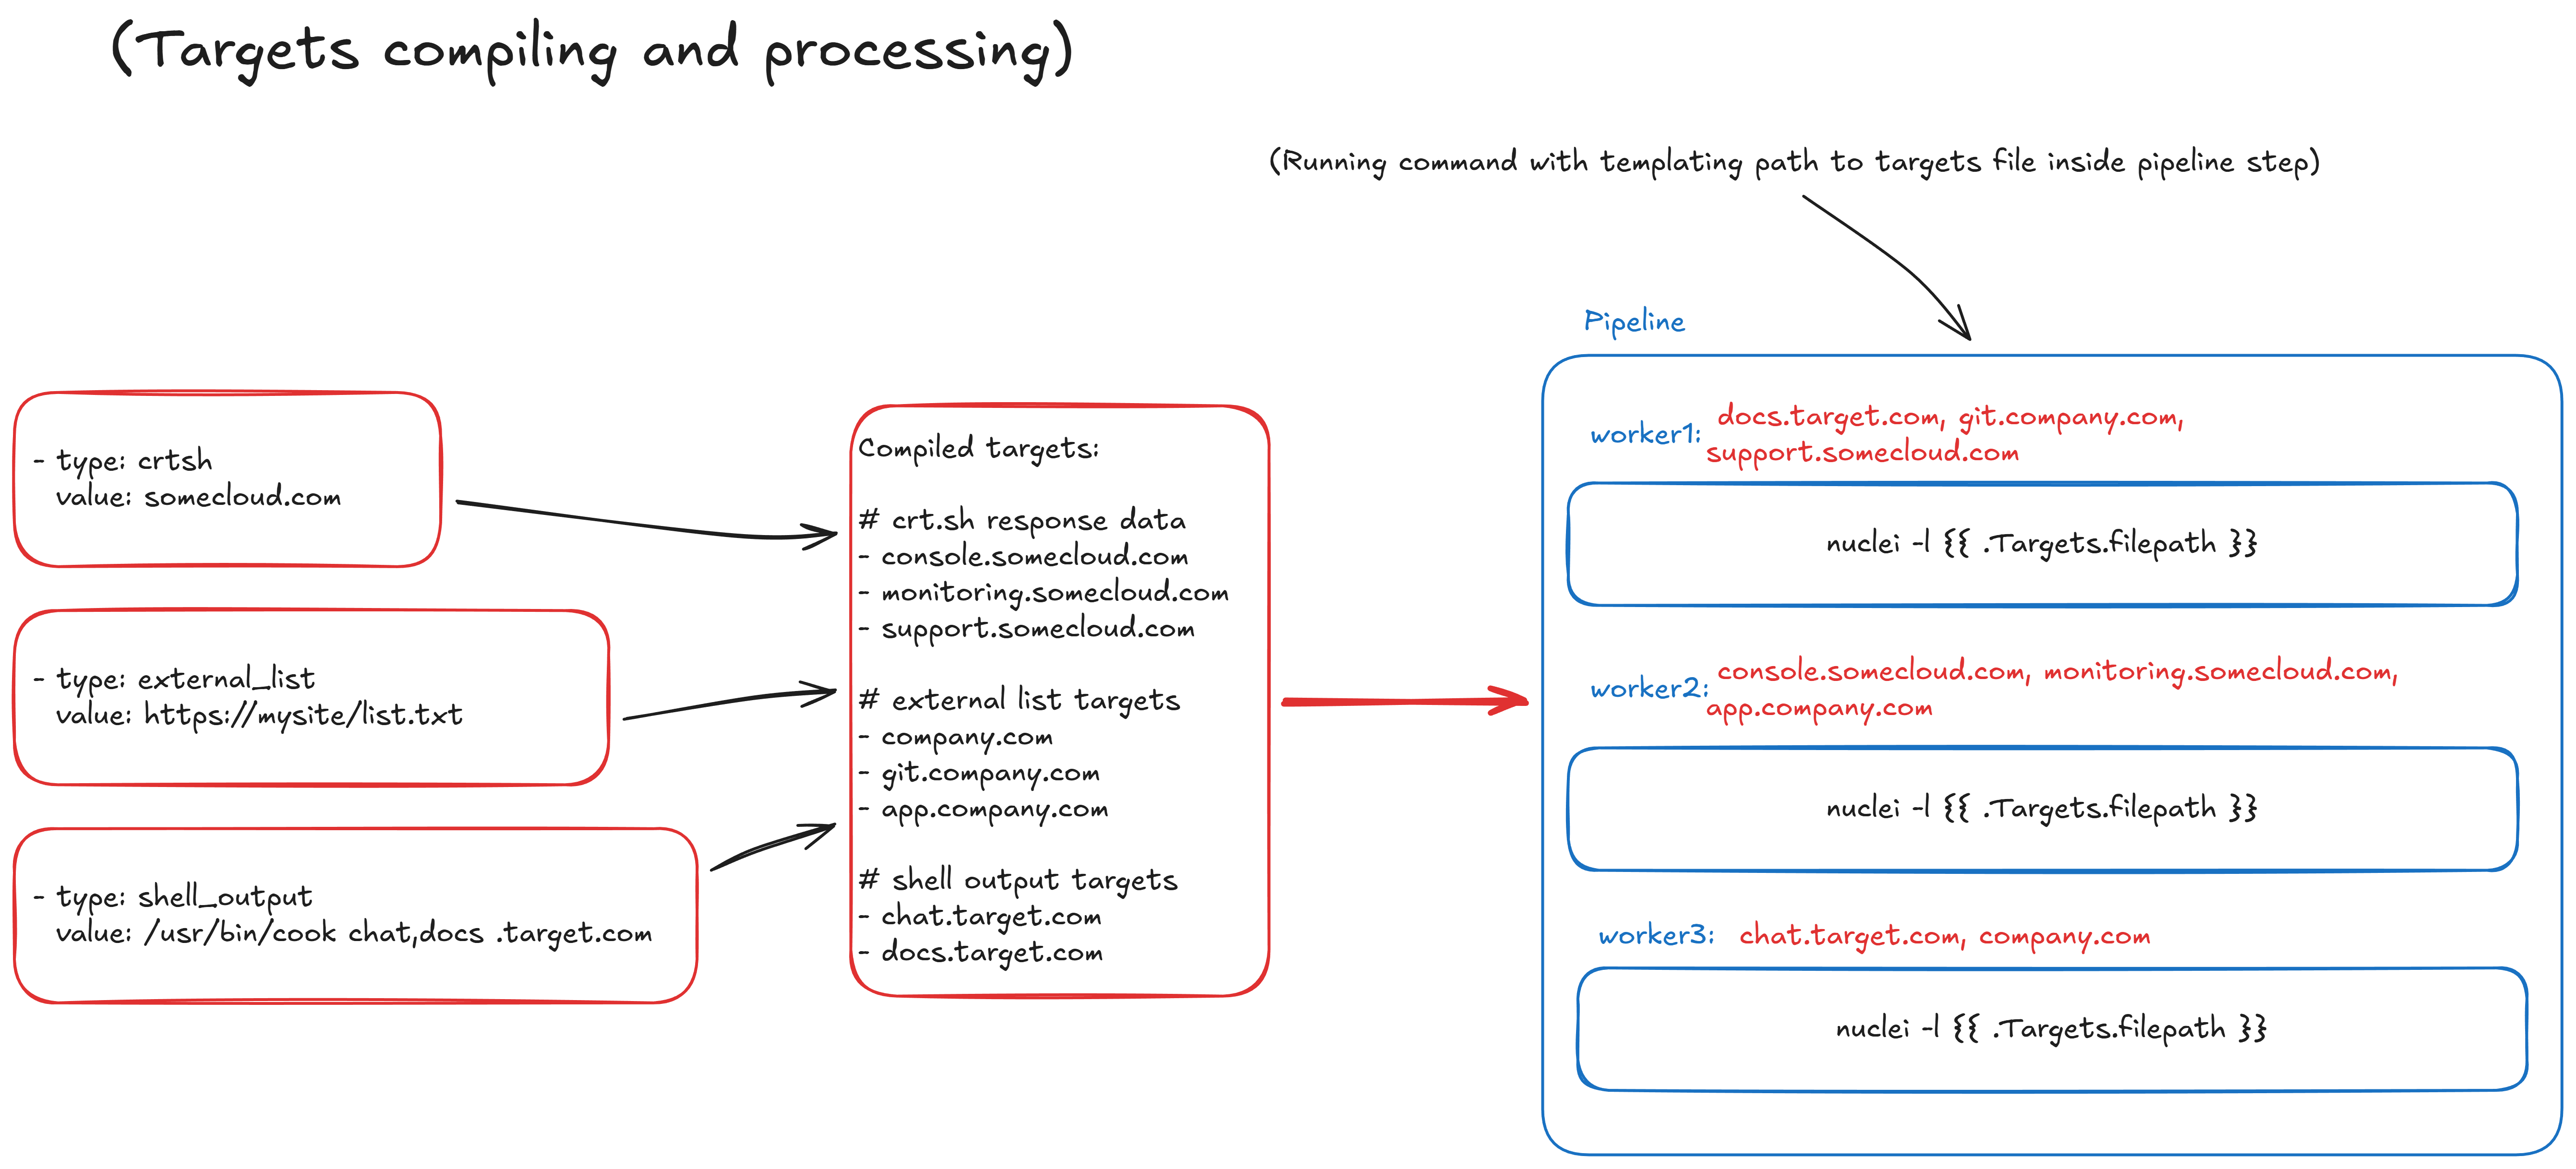
  targets:
    - value: "example.com"
      type: crtsh
    - value: ["sub1.example.com", "sub2.example.com"]
      type: list
  stages:
    - name: "Esegui scanner"
      type: exec
      steps:
        - "nmap -sC -sV -iL {{.Targets.filepath}} -oN /opt/recon/scan.txt"
    - name: "Raccogli risultati"
      type: sync
      src: "/opt/recon/scan.txt"
      dest: "./results/{{.Worker.Name}}.txt"
