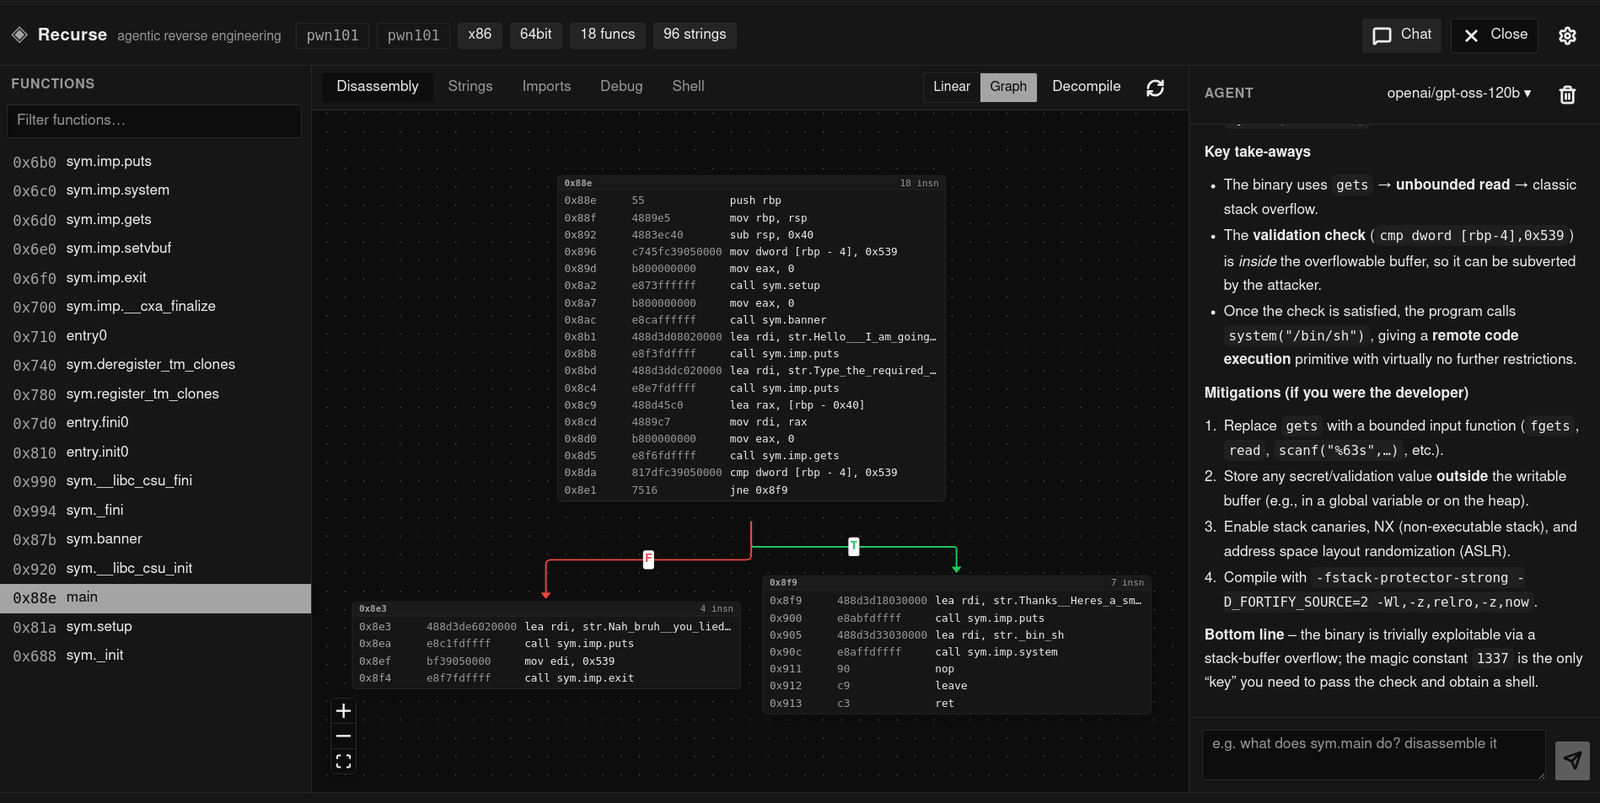
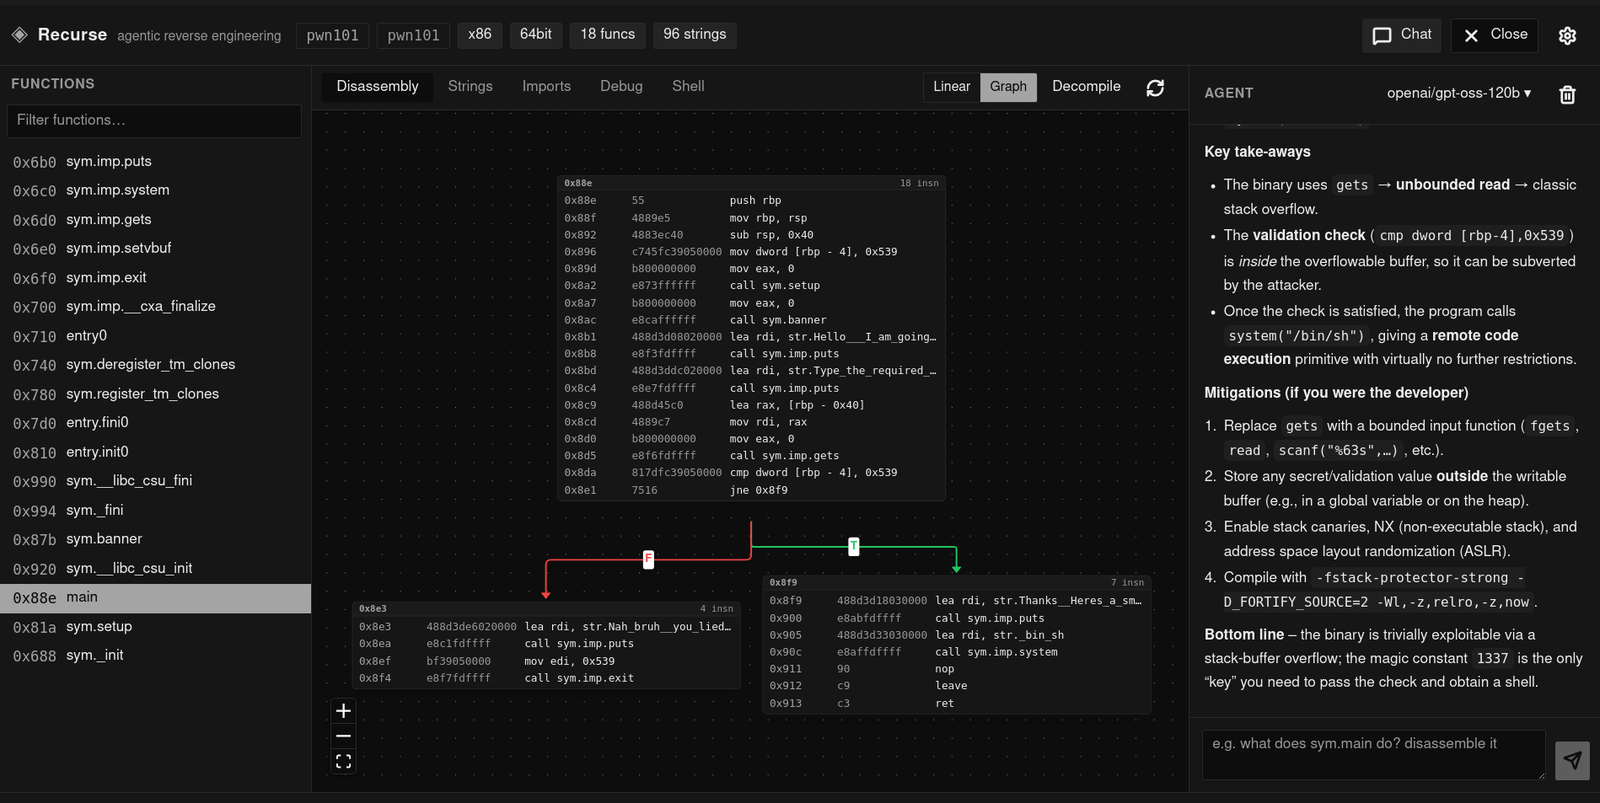
IDE agentico di reverse engineering con disassembler multi-architettura in puro Rust, decompilatore nativo, debugger e agente LLM per l'analisi di binari e attività CTF.
Ambiente di reverse engineering agentico — un'app desktop di classe Ghidra nello spirito di "Cursor per il reverse engineering". Realizzata con Tauri 2 (frontend React + TypeScript) sopra un backend di analisi collegabile. Il predefinito è un motore nativo puro-Rust — nessun processo esterno, nessuna dipendenza copyleft, multi-architettura tramite Capstone. Puoi anche eseguire l'analisi tramite r2 (radare2) o IDA Pro: seleziona uno dei due motori e l'intera app — strumenti dell'agente e UI — lo utilizza. Lo strumento dell'agente e la UI sono indipendenti dal backend — vedi docs/backends.md.
Workspace Cargo nella radice; l'app desktop è un pacchetto al suo interno.
tauri/                   desktop app (Tauri + React)
  src/                     React frontend
  src-tauri/               Tauri Rust backend (engine sessions, agent wiring)
  package.json             app scripts (Vite, Vitest, Tauri CLI)
crates/
  recurse-agent/              agent framework: LLM loop, tool runtime, SQLite memory
  recurse-static/          static analysis: ELF/PE/Mach-O parsing, multi-arch disassembly,
                           CFG and cross-reference recovery, the engine seam
  recurse-vtil/            VTIL-inspired de-obfuscation/de-virtualization IL, lifter, optimizer
  recurse-mcp/             standalone headless MCP server (stdio) over the engine — no Tauri, no IDA
  recurse-debug/           cross-platform debugger (ptrace/Mach/Win32, breakpoints, stepping)
  recurse-eval/            headless eval harness (YAML-configured tiers)
justfile                 single entry point for both halves
recurse-agent è solo l'agente; l'analisi statica risiede in recurse-static e il
debugger in recurse-debug, quindi l'agente non include codice di sistema che
non utilizza. Nessun crate dipende da Tauri, e ciascuno si compila/testa in modo autonomo;
recurse-eval pilota l'agente in modalità headless. Tutti sono membri del workspace, quindi un unico
Cargo.lock e un'unica target/ coprono l'intero repository.
Ctrl+L)checksec esterno), e conteggi delle analisiundefinedN per assegnarle un tipo. Un tipo di ritorno impostato viene mostrato nella riga
della firma nell'intestazione. Entrambi persistono in SQLite, indicizzati per funzione, e svuotare una cella la riporta
a ciò che dicono le istruzioni/clear e alla riapertura, e alimentano la sessione successivarecurse-agent) con tracciamento del debug per turno; lo stesso ciclo dell'agente gira
nell'interfaccia e nell'harness di valutazionelift: eleva una funzione in un IL di de-offuscamento in stile VTIL ed esegue
passate di propagazione/folding/dead-code-elimination/branch-resolution sull'intera routine
— utile quando il disassembly sembra un dispatcher di VM o una catena di
predicati opachi (vedi docs/vtil-lift.md)decompile genera pseudocodice simile al C (if/while
strutturati, copertura totale delle istruzioni) dalla stessa pipeline recurse-vtil
— nessuno strumento esterno, nessun r2 richiestorecurse-mcp standalone: lo stesso Engine su MCP stdio per qualsiasi
agente compatibile con MCP (Claude Code, Cursor, Claude Desktop, …) — nessun Tauri, nessuna
licenza IDA, nessun bridge Python (vedi docs/recurse-mcp.md)L'analisi passa attraverso un unico trait Engine (crates/recurse-static/src/engine.rs), quindi il
motore è una scelta, non una dipendenza obbligatoria:
native (predefinito) — parsing ELF/PE/Mach-O e disassembly multi-architettura in puro Rust
(object + capstone): x86/x86-64, ARM, AArch64, MIPS, PowerPC, RISC-V, SPARC, SystemZ,
M68K, BPF. Nessun processo figlio, nessuno strumento esterno, nessuna LGPL nella build. Include un decompilatore
(la pipeline lift → optimize → structure di recurse-vtil — vedi
docs/vtil-lift.md) e un'operazione lift per il de-offuscamento in stile VTIL.ida) — analisi headless e decompilazione Hex-Rays opt-in tramite idat.Scegli dal menu delle impostazioni, dalla variabile d'ambiente RECURSE_BACKEND o dalla
configurazione salvata. L'agente riceve un unico tool analyze neutro rispetto al backend (functions, disasm, graph,
lift, decompile, xrefs, strings, imports, info, più raw per la console del motore) —
filtrato sulle operazioni effettivamente supportate dal motore attivo, così raw (il nativo non ha console) è
pubblicizzato solo quando disponibile. L'interfaccia utente consuma tipi di risultato canonici, non il JSON di alcun motore.
Vedi docs/backends.md per il trait, le scelte dei crate e la motivazione
sulla licenza. Aprire un binario di grandi dimensioni è veloce perché l'analisi è lazy — la scoperta indicizza
le funzioni in modo economico e i blocchi di base vengono decodificati solo quando una funzione viene visualizzata; vedi
docs/lazy-analysis.md.
Agganciare un server MCP a IDA/Ghidra, o incollare il disassembly in un agente CLI, funziona per CTF da 5 funzioni e crolla sui binari reali. Recurse è un ambiente costruito appositamente, non un wrapper per chatbot: