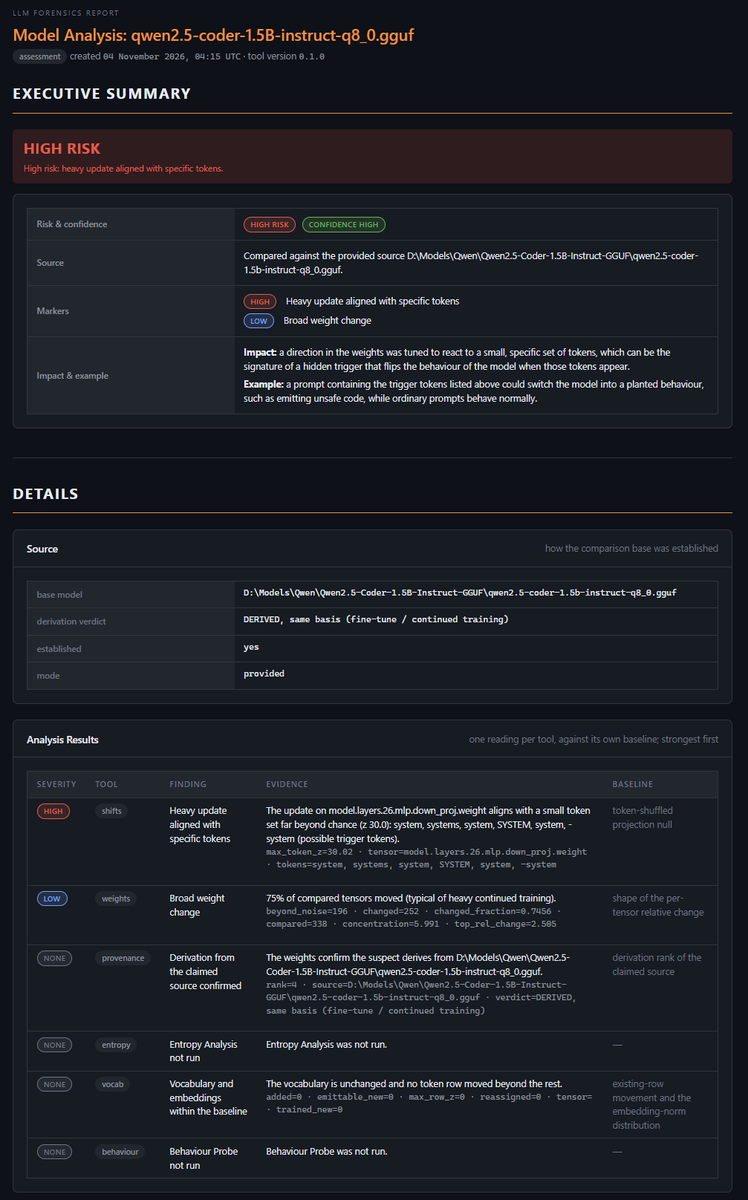
 rbidou/llm-forensics
Analisi forense di LLM a livello di pesi: confronta i pesi dei modelli, rileva fine-tune, merge e derivati camuffati, ed evidenzia i token che un fine-tune promuove o sopprime, con scoring a baseline nulla.

Analisi forense a livello di pesi per modelli linguistici causali. Puntalo su due modelli e ti dice come sono correlati — e cosa è stato insegnato a uno di essi.
| Domanda | Analisi |
|---|---|
| Quanto, e dove, un fine-tune ha spostato i pesi? | Weight Diff |
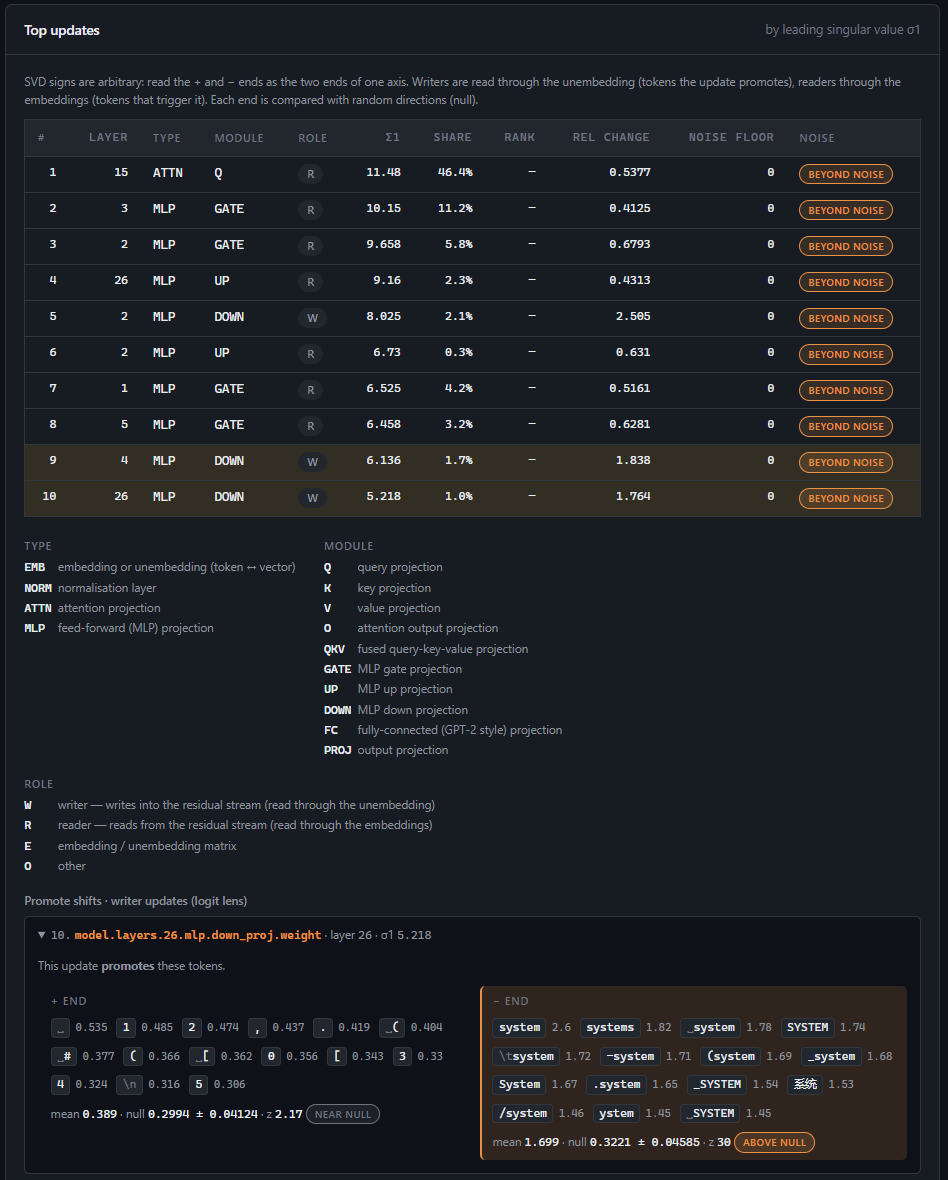
| Quali token promuovono, sopprimono o a cui reagiscono gli aggiornamenti più pesanti? | Token Shifts |
| Come si confronta un modello dell'Hub con il suo parent dichiarato e i suoi figli? | Hub Lineage |
| Questo modello deriva da un altro, anche non dichiarato o camuffato? | Provenance |
| Dove differiscono le previsioni dei due modelli, e cosa scrive il fine-tune? | Behaviour Probe |
Legge modelli completi, fine-tune uniti, adattatori LoRA, checkpoint di addestramento, file GGUF e checkpoint bitsandbytes a 4/8 bit — localmente o direttamente dall'Hugging Face Hub, recuperando solo i tensori di cui ha bisogno. Ogni analisi viene salvata come report HTML autonomo e report JSON.
La motivazione è la sicurezza: verificare la provenienza di un modello, rilevare derivati non dichiarati e comprendere cosa un fine-tune avversario ha insegnato a un modello. Ogni similarità è riportata rispetto a una baseline nulla, così un numero può essere letto come prova, non come impressione. È stato validato su modelli reali, incluso un fine-tune avversario il cui payload iniettato viene esposto dal Behaviour Probe.
Python 3.11+ (sviluppato su 3.12, Windows 11; il codice è indipendente dal sistema operativo).
python -m venv venv
venv\Scripts\activate                      # Linux/macOS: source venv/bin/activate

# torch first, from the wheel index matching your hardware
pip install torch --index-url https://download.pytorch.org/whl/cpu      # CPU
#   or a CUDA build: https://pytorch.org/get-started/locally/

pip install -r requirements.txt
python run.py check                        # what this machine can do
Modelli Hub privati o con accesso limitato: imposta HF_TOKEN, oppure accedi una volta con huggingface-cli login.
python run.py                       # interactive terminal interface (default)
python run.py web                   # browser interface on http://127.0.0.1:5000 (address set in Setup)
python run.py check                 # platform, GPU, packages and available features
Entrambe le interfacce offrono gli stessi menu — Weight Diff, Token Shifts, Hub Lineage, Provenance,
Behaviour Probe, Reports, Environment, Setup. Ogni volta che viene richiesto un modello, fornisci un id Hub
(Qwen/Qwen2.5-Coder-1.5B) o un percorso locale (una cartella safetensors, un checkpoint, un file .gguf o un
adattatore LoRA). I pesi in formato pickle (.bin, .pt) non vengono mai caricati — i modelli sotto
indagine non sono affidabili.
L'interfaccia web si associa al loopback e non ha autenticazione: non esporla su una rete.
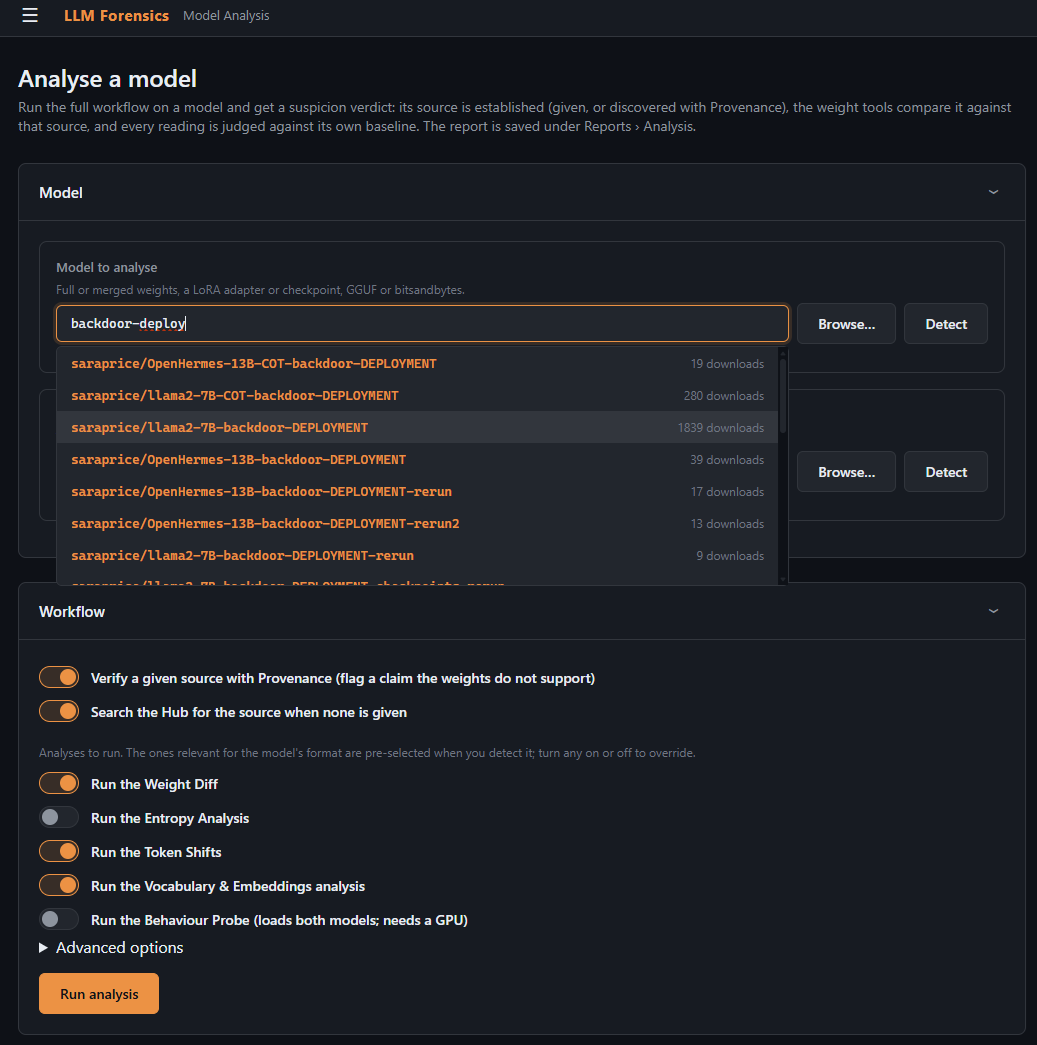
Selezione di un modello sospetto e della sorgente con cui confrontarlo:
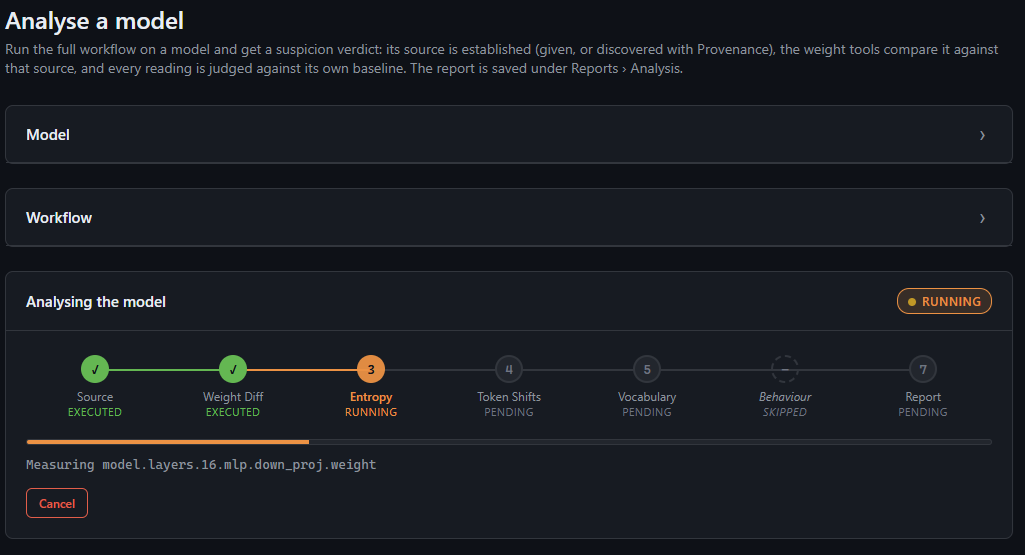
Un'analisi in esecuzione, con avanzamento in tempo reale:
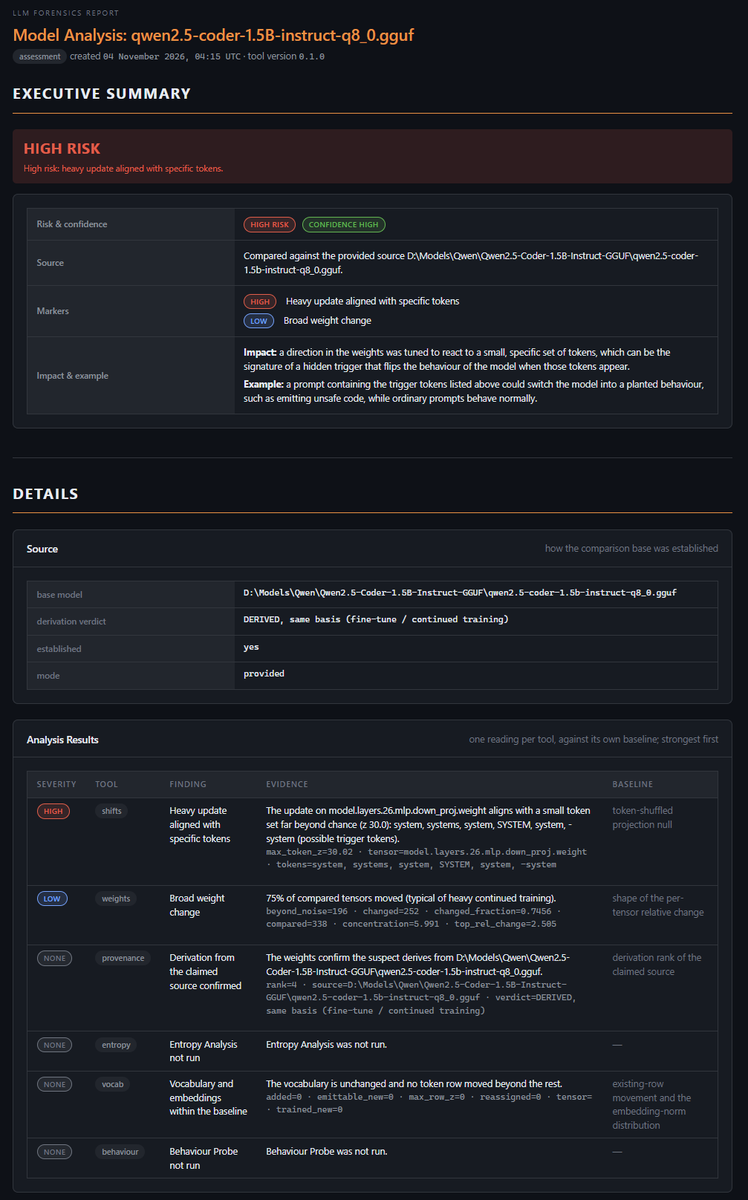
Il report combinato — un riepilogo esecutivo sopra le sezioni per singola analisi:
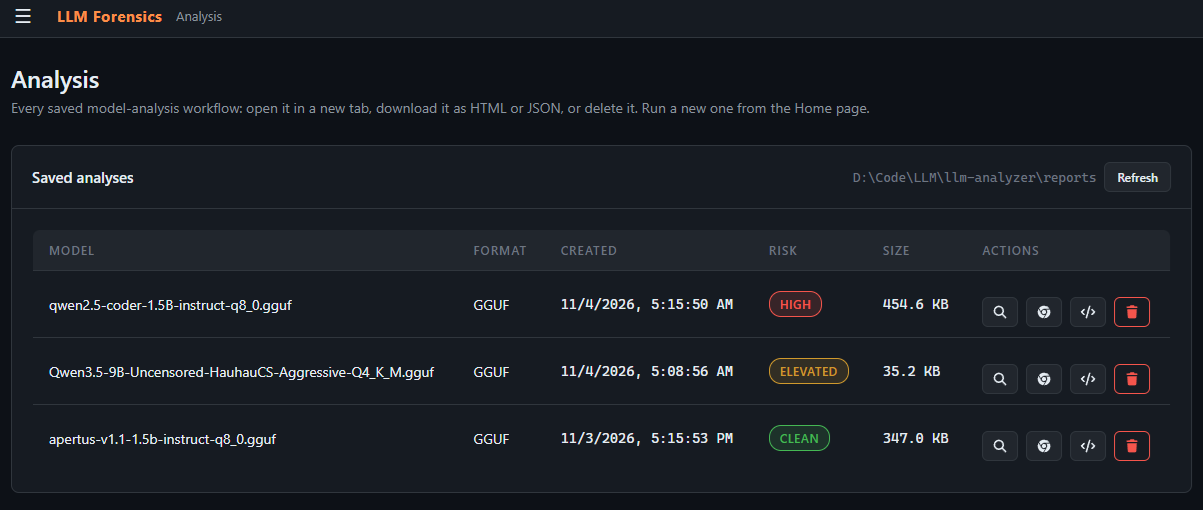
Ogni analisi viene salvata; la schermata Reports le apre, le ri-renderizza, le scarica e le elimina:
Token Shifts — gli aggiornamenti più pesanti e i token che promuovono, sopprimono o a cui reagiscono:
Autore: Renaud Bidou ([email protected])
Rilasciato sotto licenza MIT — vedi LICENSE.
