 noahware/binprotect
Offuscatore bin2bin PE x64 che non aggiunge una sezione al binario

Vedi 4. Compilazione per le istruzioni di compilazione.
Questo offuscatore è bin2bin, il che significa che prende un eseguibile già compilato e lo riproduce con i passaggi di offuscamento applicati. Questo può essere usato per proteggere un'applicazione senza avere accesso al codice sorgente originale. Al momento sono supportati solo file x64 PE (portable executable), ma ci sono piani per aggiungere supporto ad altri formati binari (es. ELF) in futuro.
Attualmente, tutti i noti offuscatori bin2bin inseriscono una sezione alla fine del binario per collocare il codice o i dati offuscati al suo interno. Questo per preservare il layout originale del binario, senza dover modificare il contenuto delle sezioni preesistenti. Questo è molto più semplice da gestire perché mantiene validi la maggior parte degli RVA (indirizzi relativi).
Questo progetto adotta un approccio unico a bin2bin, in cui qualsiasi codice o dato offuscato viene inserito all'interno delle sezioni originali del binario. Ciò richiede di tracciare ogni singolo RVA nell'applicazione. I vantaggi di questo approccio sono:
Questo documento descriverà sia la riscrittura del binario eseguibile sia le tecniche di offuscamento implementate. Le seguenti tecniche di offuscamento sono state implementate:
Inoltre, questo progetto supporta anche le eccezioni (eccezioni C++ e SEH) ed è in grado di offuscare funzioni che dispongono di gestione delle eccezioni.
Per facilitare il disassemblaggio e l'individuazione del codice nel binario, i file di simboli (sia PDB che MAP) sono accettati opzionalmente. Fornire i file di simboli non è obbligatorio ma aiuta nel disassemblaggio di binari complessi. Alcune funzionalità come il supporto alle eccezioni e l'appiattimento del flusso di controllo richiedono che venga fornito un file di simboli.
Un riscrittore binario prende un eseguibile e modifica il codice o i dati al suo interno per produrre un binario di output con le modifiche applicate.
Poiché il codice offuscato viene inserito direttamente nelle sezioni originali del binario, gli indirizzi relativi del programma devono essere tracciati in modo che tutti i riferimenti ad essi possano essere adeguati. Questo serve affinché i riferimenti puntino ancora alla stessa posizione dopo l'inserimento di codice e dati. Altrimenti, dati o codice verrebbero acceduti nella posizione sbagliata, modificando così il comportamento del binario di output e causando inoltre una grave instabilità.
Ogni volta che viene trovato un riferimento a un indirizzo relativo (ad es. istruzioni contenenti operandi relativi a rip o directory di dati PE), questo viene aggiunto a una lista di tracciamento da aggiornare al termine della riscrittura. Vengono tracciati sia l'RVA in cui avviene il riferimento (per sapere dove aggiornare il riferimento) sia l'RVA a cui si fa riferimento (per sapere con quale RVA aggiornare il riferimento).
Ogni volta che il disassembler trova un'istruzione relativa a rip, la aggiunge a un elenco di riferimenti da aggiornare al termine dell'offuscamento. Ciò garantisce che tutte queste istruzioni puntino ancora alla posizione che avevano originariamente. Anche altri casi di istruzioni relative, come le tabelle di salto, vengono aggiunti come riferimenti da aggiornare.
Tutti gli RVA tracciati devono essere adeguati ogni volta che byte vengono inseriti o rimossi dal binario. Ad esempio, ecco il gestore di inserimento dei byte:```cpp
void binwrite::binary_t::insert(const rva_t rva, const std::span data, const bool inclusive)
{
buffer_.insert_range(buffer_.begin() + rva.value(), data);
update_rvas(rva, static_cast<rva_t::size_type>(data.size()), inclusive);
}
`update_rvas` è il punto in cui ogni RVA tracciata viene aggiornata per riflettere il cambiamento avvenuto nel binario. Ecco un diagramma di questo processo:
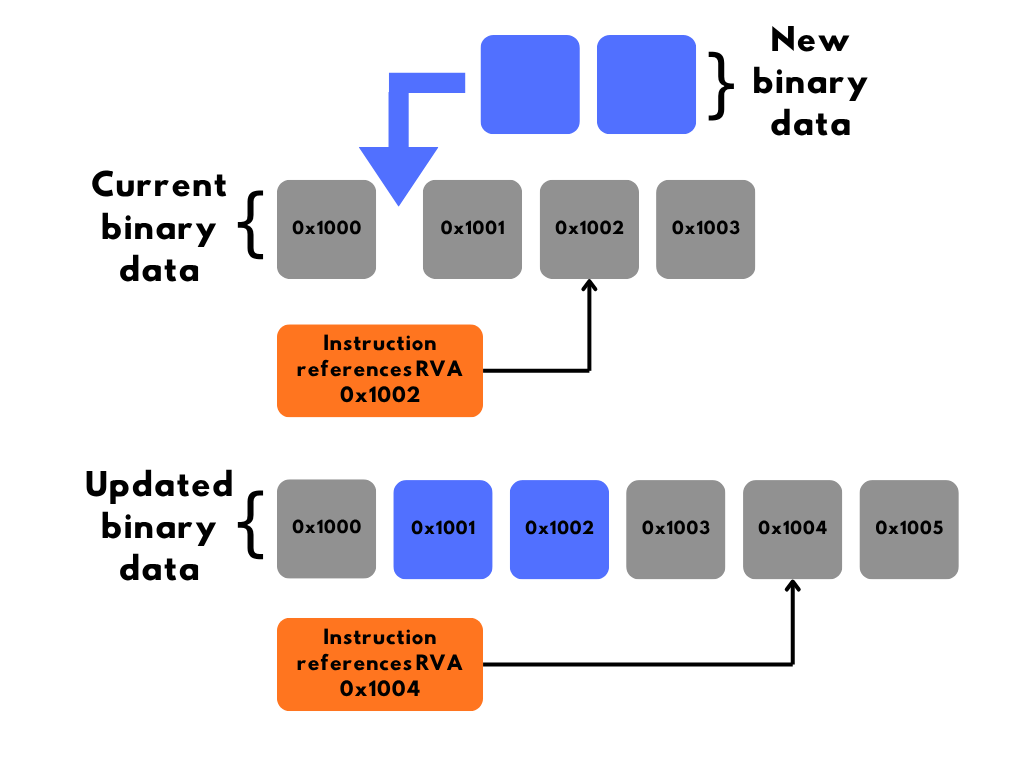
Figura 1. Tracciamento degli indirizzi relativi.
I dati inseriti (blu) spostano i dati correnti (grigio). La RVA a cui fa riferimento l'istruzione (arancione) viene aggiornata per puntare alla stessa memoria, tenendo conto dei dati inseriti (blu).
## 2.2. Disassemblaggio
Tutti i potenziali punti di ingresso del codice (esportazioni, entry point, rilocazioni che puntano alla sezione del codice, ecc.) vengono aggiunti a una coda di disassemblaggio. Se è presente un file di simboli, anche tutte le funzioni descritte dal file di simboli vengono aggiunte alla coda di disassemblaggio. Ciascuna voce nella coda viene trattata come un singolo blocco di base.
Un blocco di base è un gruppo di istruzioni senza rami; questo significa che viene terminato in corrispondenza di istruzioni di controllo del flusso (es. jump, ret, int). I blocchi di base non terminano in corrispondenza delle chiamate, poiché nella maggior parte dei casi ci si aspetta che queste ritornino. Alcune funzioni non ritornano (es. _CxxThrowException) e d'ora in poi saranno denominate chiamate 'noreturn'.
Quando un blocco di base dalla coda di disassemblaggio viene elaborato, ogni istruzione viene disassemblata partendo dall'inizio finché non si verifica una delle seguenti condizioni:
- Viene raggiunto un altro blocco di base già analizzato, causando una sovrapposizione. Vedi “Suddivisione dei blocchi di base”.
- Viene trovata un'istruzione di terminazione (jump, return, int).
- Il disassemblaggio dell'istruzione non è riuscito.
- È stato trovato padding del codice.
Di seguito è riportato un diagramma del disassemblaggio e dell'ingresso nella coda di disassemblaggio (il controllo del padding del codice è omesso nel diagramma). Questo processo viene ripetuto finché la coda di disassemblaggio non è vuota.
