 nac-l/mergen
Deofuscazione tramite ottimizzazione con utilizzo di LLVM IR e parsing dell'assembly.

Mergen è uno strumento progettato per convertire codice Assembly in Intermediate Representation (IR) di LLVM. Questo strumento è pensato per:
Per compilare ed eseguire il progetto, dai un'occhiata a docs/BUILDING.md.
Il lavoro di riscrittura deve mantenere verde il gate di regressione baseline. Il gate compila campioni PE mirati, esegue lifter e verifica gli output IR generati dal lifting.
scripts\\rewrite\\run.cmdEseguiamo simbolicamente (o solleviamo simbolicamente) il target: l'idea qui non è il lifting delle singole istruzioni, ma il lifting di un'intera funzione. Non ci aspettiamo che una singola istruzione o un singolo blocco base si comportino allo stesso modo ogni volta; li trattiamo invece come se potessero essere, e di fatto sono, usati per scopi diversi ogni volta. Cerchiamo di mantenere l'IR generato il più semplice e ottimizzabile possibile. Abbiamo anche esigenze diverse rispetto a un compilatore tradizionale. Usiamo l'analisi per valutare il flusso di controllo. Non possiamo dipendere da LLVM per tutta la nostra analisi, perché è creato per obiettivi diversi e potrebbe non essere ottimale per il nostro caso d'uso.
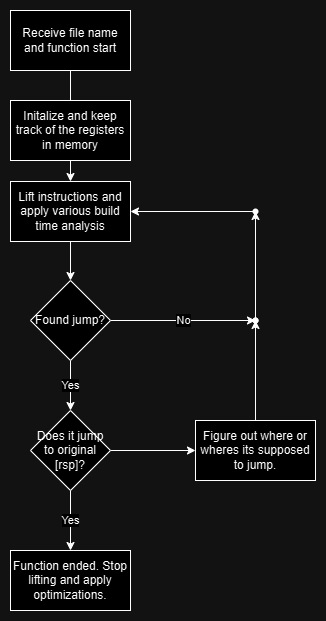
Questo è l'esempio pratico che illustra come Mergen affronta i programmi virtualizzati.
Questo è il nostro programma target
struct test {
    int a;
    int b;
    int c;
};

int maths(test a, int b, int c) {
        return a.a  + b - c;
}
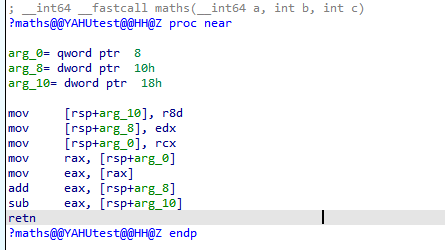
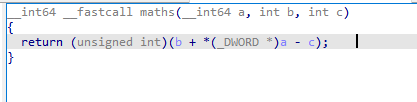
Impostazioni di VMProtect: tutto è disattivato, virtualizziamo la funzione con l'impostazione ultra. (Versioni testate: 3.4.0-3.6.0, 3.8.1)
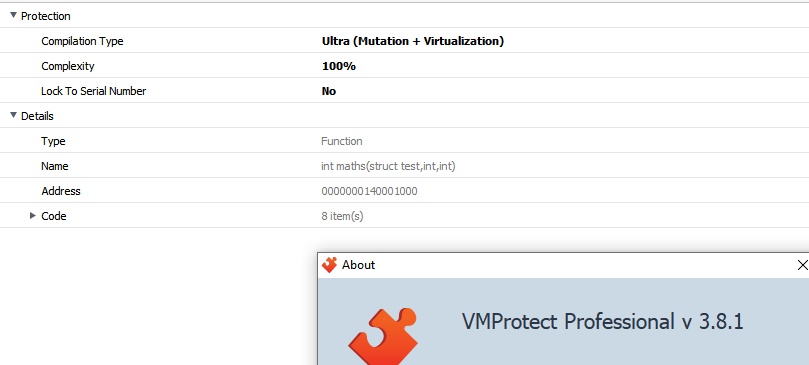
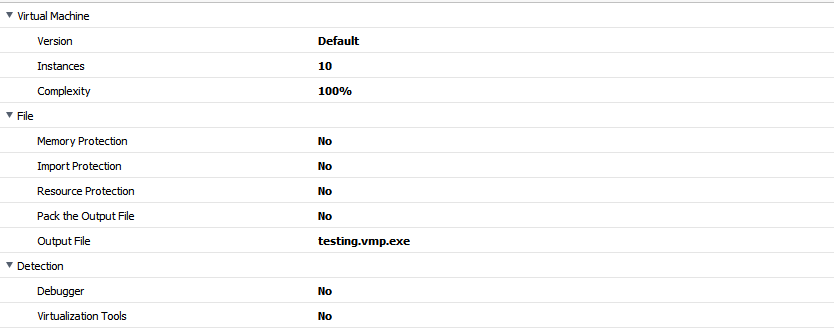
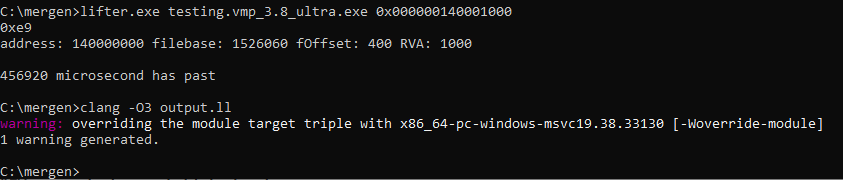
Qui eseguiamo Mergen. Il primo argomento è il nome del file e il secondo è l'indirizzo della funzione. Guarda com'è semplice eseguirlo. Possiamo inoltre compilare l'output per poterlo esplorare con il nostro decompilatore preferito.
; ModuleID = 'my_lifting_module'
source_filename = "my_lifting_module"

; Function Attrs: mustprogress nofree norecurse nosync nounwind willreturn memory(argmem: read)
define i64 @main(i64 %rax, i64 %rcx, i64 %rdx, i64 %rbx, i64 %0, i64 %rbp, i64 %rsi, i64 %rdi, i64 %r8, i64 %r9, i64 %r10, i64 %r11, i64 %r12, i64 %r13, i64 %r14, i64 %r15, ptr nocapture readonly %memory) local_unnamed_addr #0 {
entry:
  %stackmemory = alloca i128, i128 13758960, align 8
  %1 = trunc i64 %r8 to i32
  %2 = trunc i64 %rdx to i32
  %GEPLoadxd-5369456437- = getelementptr i8, ptr %memory, i64 %rcx
  %3 = load i32, ptr %GEPLoadxd-5369456437-, align 4
  %adc-temp-5370242400- = sub i32 %2, %1
  %realnot-5369532059- = add i32 %adc-temp-5370242400-, %3
  %stackmemory10243.sroa.55.1375304.insert.ext10255 = zext i32 %realnot-5369532059- to i64
  ret i64 %stackmemory10243.sroa.55.1375304.insert.ext10255
}

attributes #0 = { mustprogress nofree norecurse nosync nounwind willreturn memory(argmem: read) }
Dopo la compilazione:
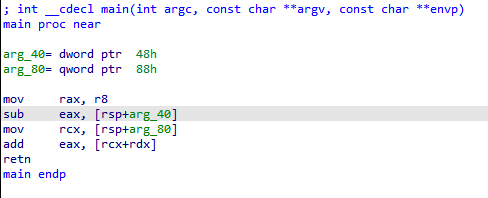
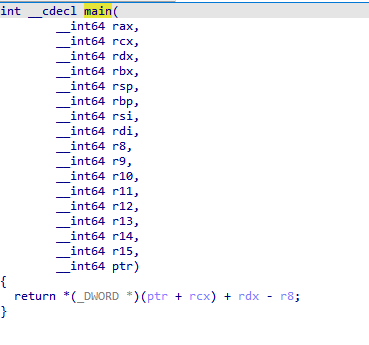
Ora potresti notare che i registri sono leggermente diversi. Questo perché non seguiamo le convenzioni di chiamata; se le seguissimo, la firma della funzione sarebbe così:
define i64 @main(i64 %rcx, i64 %rdx, i64 %rdx, i64 %r8, i64 %r9 ...)
Quindi, ci limitiamo ad adattare la firma della funzione affinché appaia normale. Se hai altre domande su questa parte, ti suggerisco di approfondire le convenzioni di chiamata e l'ABI.
Quindi, supponiamo di avere questo codice. Le VM prenderanno il codice sottostante e lo trasformeranno in un salto indiretto, il che è leggermente più scomodo per chi fa reverse engineering.
int maths(int a, int b, int c) {
    if (a > b)
        return a + b + c;
    else
        return a - b - c;
}
next_handler = xxx;
if ( a-b > 0 )
  next_handler = yyy;
jump next_handler;
Cerchiamo di analizzare sempre i valori e di tenerne traccia. Questo ci permette di comprendere il flusso di controllo. Per i branch simili a jump table L'output ottimizzato sarebbe un semplice
define i64 @main(i64 %rax, i64 %rcx, i64 %rdx, i64 %rbx, i64 %rsp, i64 %rbp, i64 %rsi, i64 %rdi, i64 %r8, i64 %r9, i64 %r10, i64 %r11, i64 %r12, i64 %r13, i64 %r14, i64 %r15, ptr nocapture readnone %TEB, ptr nocapture readnone %memory) local_unnamed_addr #0 {
fake_ret:
  %0 = lshr i64 %rcx, 62
  %common.ret.op = and i64 %0, 2
  ret i64 %common.ret.op
}
Output non ottimizzato. (DCE'd per leggibilità)
source_filename = "my_lifting_module"
