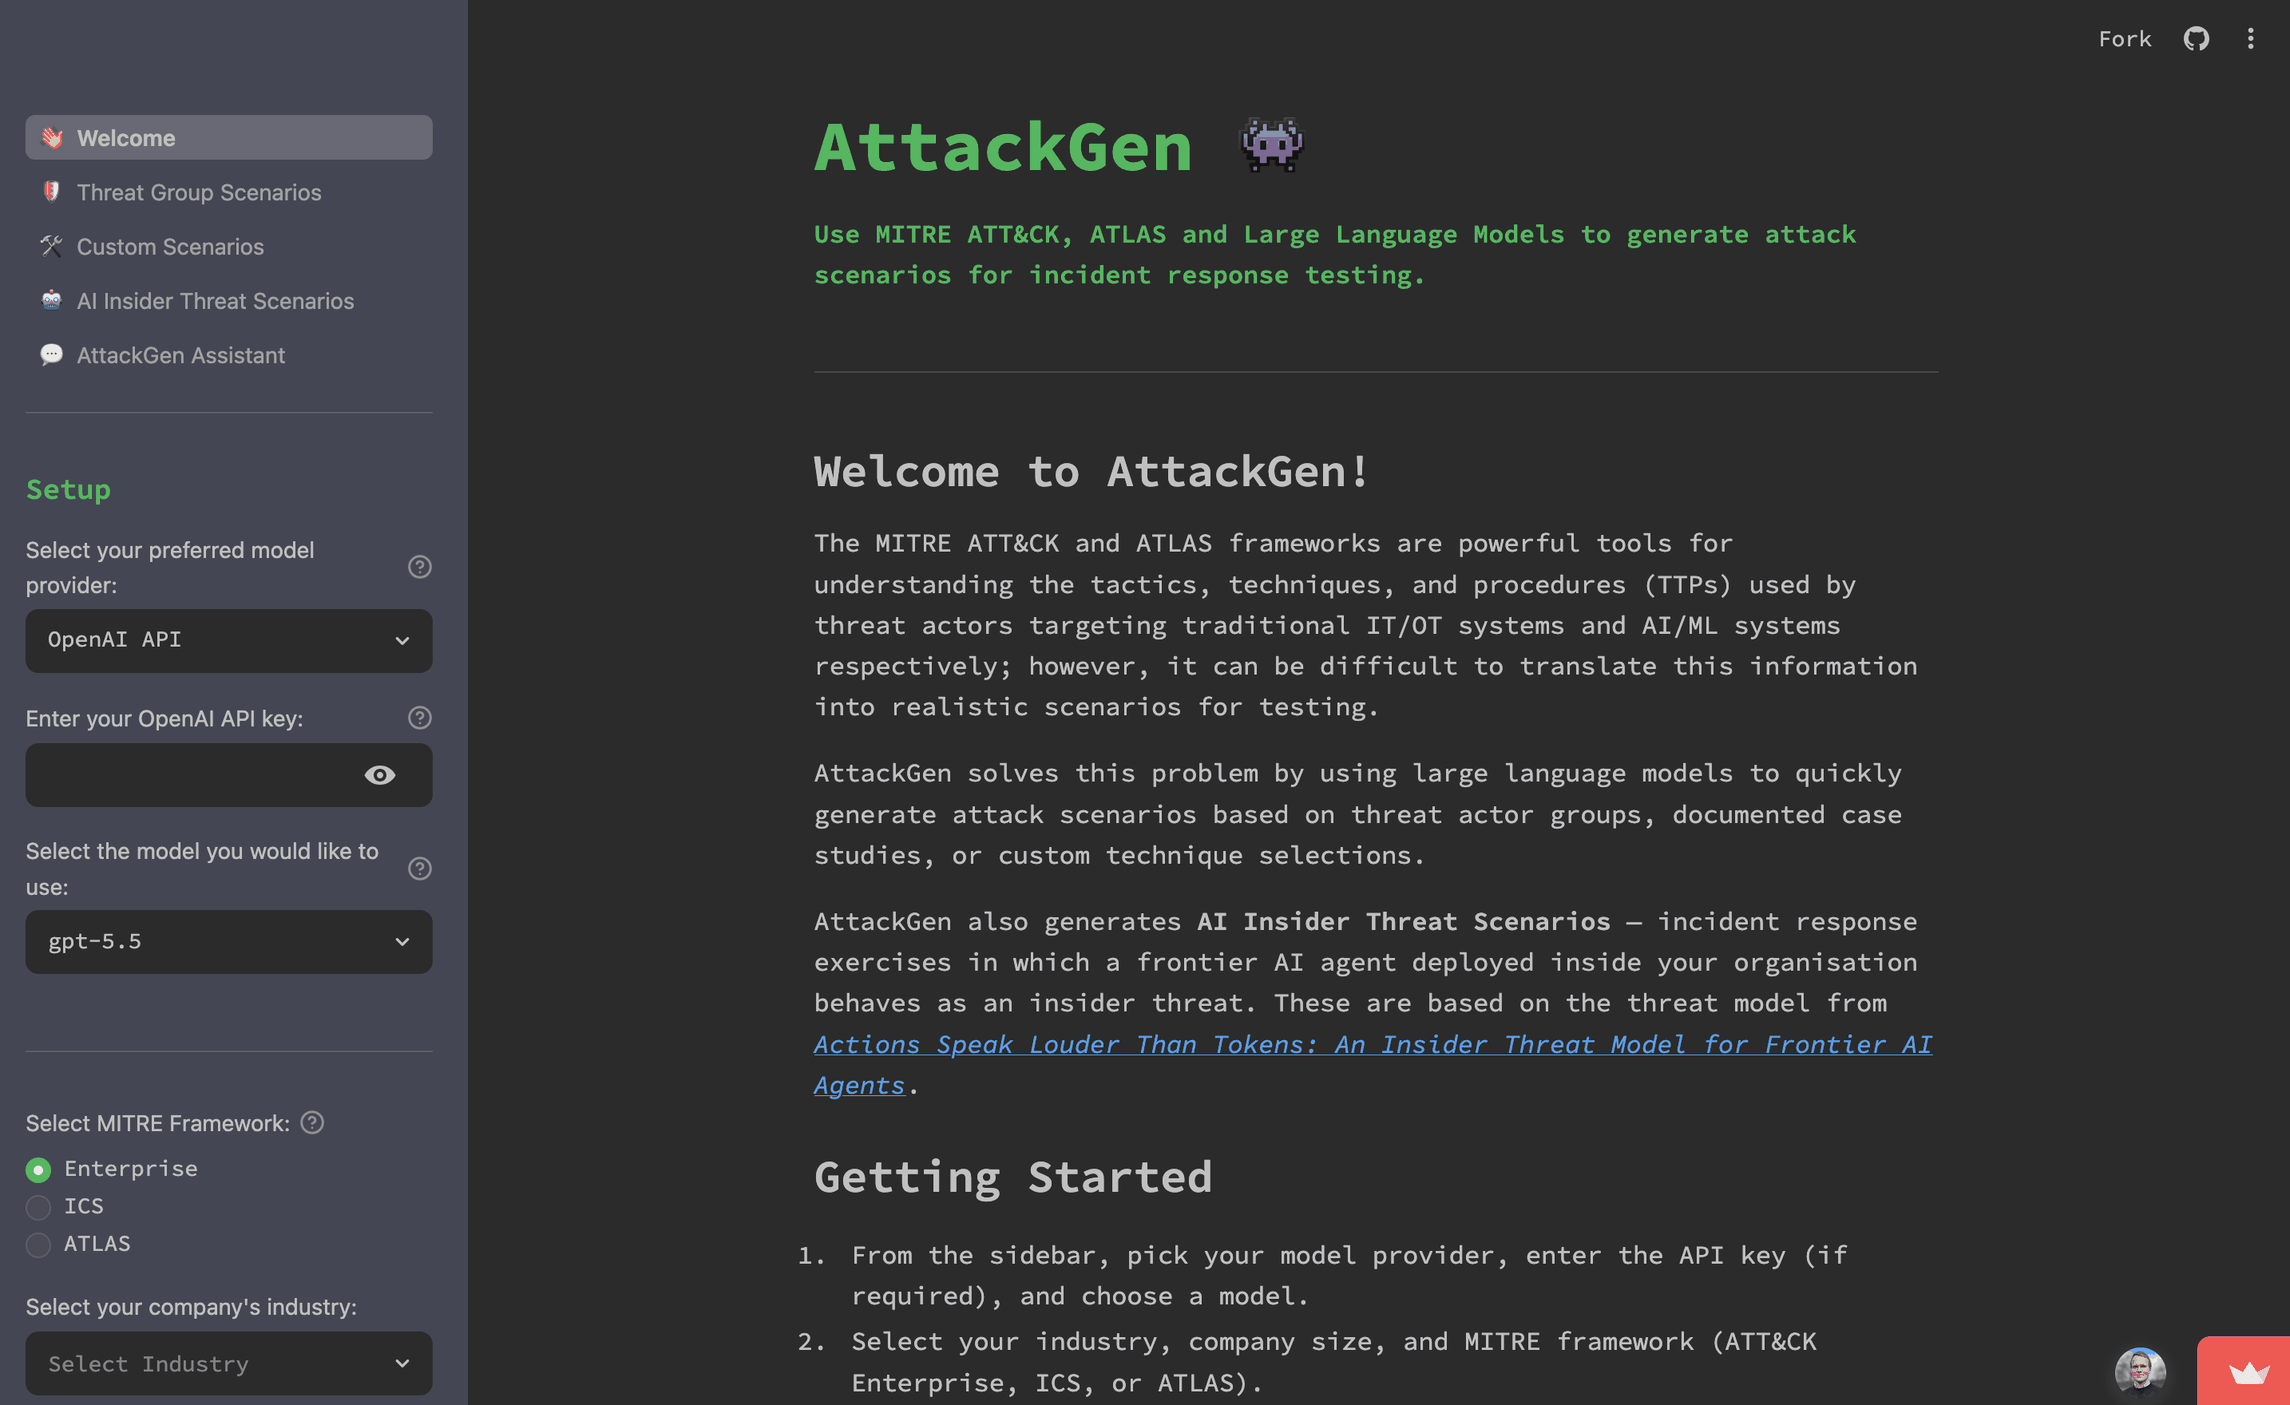

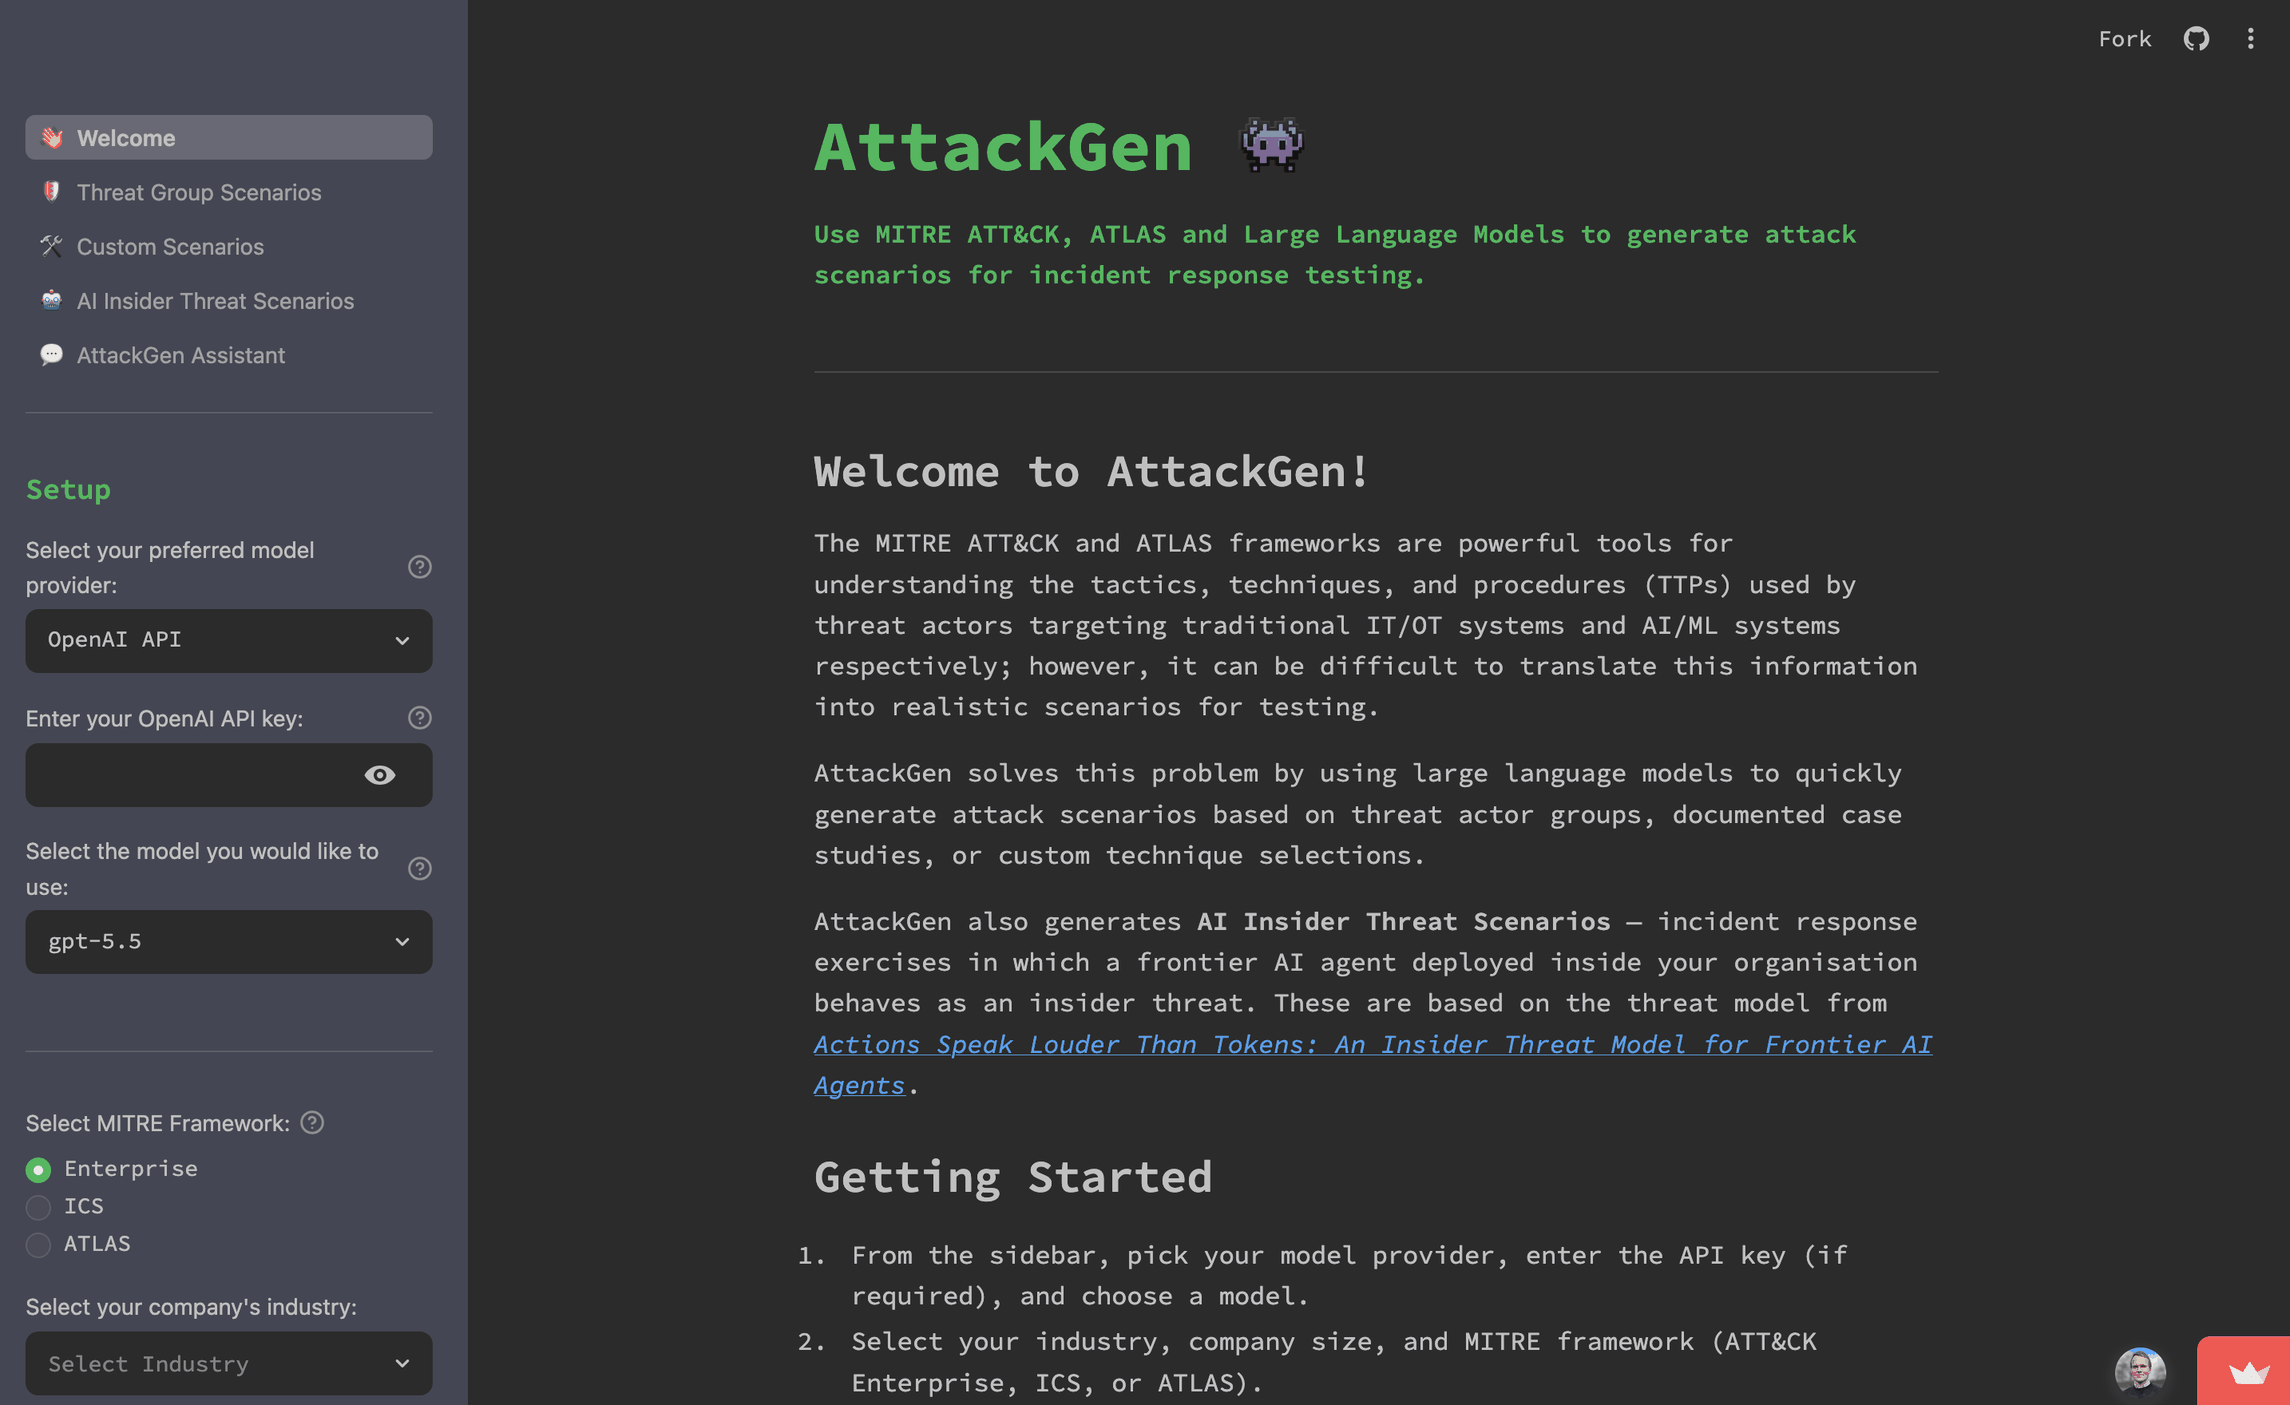
AttackGen è uno strumento di test per la risposta agli incidenti di cybersecurity che sfrutta la potenza dei grandi modelli linguistici e il completo framework MITRE ATT&CK. Lo strumento genera scenari di risposta agli incidenti su misura basati sui gruppi di attori minacciosi selezionati dall'utente e sui dettagli della tua organizzazione.
# AttackGen
AttackGen è uno strumento di testing per la risposta agli incidenti di cybersecurity che sfrutta la potenza dei grandi modelli linguistici e i framework completi MITRE ATT&CK e ATLAS. Lo strumento genera scenari di risposta agli incidenti su misura basati sui gruppi di attori della minaccia selezionati dall'utente, sui casi di studio di attacchi AI e sui dettagli della tua organizzazione.
## Indice
- [Metti una stella al Repo](#star-the-repo)
- [Funzionalità](#features)
- [Release](#releases)
- [Requisiti](#requirements)
- [Installazione](#installation)
- [Configurazione di LangSmith](#langsmith-setup)
- [Configurazione dei dati](#data-setup)
- [Esecuzione di AttackGen](#running-attackgen)
- [Server MCP](#mcp-server)
- [Agent Skills](#agent-skills)
- [Utilizzo](#usage)
- [Migliori pratiche di sicurezza](#security-best-practices)
- [Contribuire](#contributing)
- [Licenza](#licence)
## Metti una stella al Repo
Se trovi AttackGen utile, ti invitiamo a mettere una stella al repository su GitHub. Questo aiuta più persone a scoprire lo strumento. Il tuo supporto è molto apprezzato! ⭐
## Funzionalità
- Genera scenari unici di risposta agli incidenti in base ai gruppi di attori della minaccia scelti o ai casi di studio ATLAS.
- Ti consente di specificare le dimensioni e il settore della tua organizzazione per uno scenario su misura.
- Supporta i framework MITRE ATT&CK Enterprise, ICS (Industrial Control Systems) e ATLAS (Adversarial Threat Landscape for AI Systems).
- Mostra un elenco dettagliato delle tecniche utilizzate dal gruppo di attori della minaccia o dal caso di studio selezionato.
- Crea scenari personalizzati basati su una selezione di tecniche ATT&CK o ATLAS.
- Utilizza i template di scenario per generare rapidamente scenari personalizzati basati su tipi comuni di incidenti informatici, inclusi pattern di attacco specifici per AI/ML.
- Genera **Scenari di minaccia interna AI** - esercitazioni di risposta agli incidenti in cui un agente AI di frontiera distribuito all'interno della tua organizzazione si comporta come una minaccia interna, basandosi sul modello di minaccia tratto da [*Actions Speak Louder Than Tokens: An Insider Threat Model for Frontier AI Agents*](https://ai-insider-threat.matt-adams.co.uk). Gli scenari sono modellati dall'archetipo di distribuzione dell'agente (livello di autonomia), dalla categoria di minaccia, dalle minacce STRIDE e da un seed di scenario opzionale in testo libero.
- AttackGen Assistant - un'interfaccia chat per aggiornare e/o porre domande sugli scenari generati, con un percorso diretto di ritorno alla pagina da cui proviene lo scenario.
- Configurazione guidata: ogni pagina mostra la stessa barra laterale **Setup**, elenca ogni requisito in sospeso in un unico riepilogo di prontezza e mantiene **Generate** disabilitato finché il flusso di lavoro non è pronto.
- I risultati persistono per la sessione: ogni pagina di scenario mantiene il proprio ultimo risultato, gli input acquisiti e i download attraverso riesecuzioni e navigazione, e solo un esplicito **Regenerate** o **Clear result** lo sostituisce o lo rimuove.
- Gli scenari lunghi sono accompagnati da un riepilogo compatto e da una navigazione per sezioni, incluse scorciatoie verso gli inject, i criteri di successo, le metriche, gli artefatti e le regole di ingaggio da cui un facilitatore conduce l'esercitazione.
- Raccogli il feedback degli utenti sulla qualità degli scenari generati.
- Scenari scaricabili in formato Markdown.
- Utilizza l'API OpenAI, l'API Anthropic (modelli Claude), l'API Google AI, l'API Mistral, l'API Groq o qualsiasi endpoint personalizzato compatibile con OpenAI (Ollama, LM Studio, Azure OpenAI, OpenRouter, ecc.) per generare scenari di risposta agli incidenti. Tutti i provider sono instradati attraverso [LiteLLM](https://github.com/BerriAI/litellm) dietro un unico wrapper interno, quindi aggiungere un nuovo modello è una modifica di una riga.
- Disponibile come immagine container Docker per una facile distribuzione.
- Integrazione opzionale con [LangSmith](https://docs.smith.langchain.com/) per potenti funzionalità di debug, testing e monitoraggio delle prestazioni del modello.
- Gestione sicura delle credenziali tramite file .env per chiavi API e segreti.
## Release
### v0.17
| Cosa c'è di nuovo? | Perché è utile? |
| ----------- | ----------------- |
| Applica i perfezionamenti dell'Assistant ai download | - Le modifiche raggiungono i file: la chat dell'Assistant veniva utilizzata per perfezionare solo una conversazione, quindi i download dello scenario e di Detection & Response non cambiavano mai. Un nuovo pulsante **Apply changes to downloads** li riscrive dalla conversazione, in una chiamata dedicata al modello che restituisce il documento revisionato completo. In modalità **Scenario + Detection & Response** revisiona entrambi, fornendo a ciascuno il testo corrente dell'altro per mantenerli allineati.<br><br>- La sezione di riferimento rimane esatta: un'applicazione di Detection & Response riscrive solo la parte narrativa. Il riferimento deterministico di detection e mitigazione tratto dai dati ATT&CK viene trasferito byte per byte. Il layer Navigator non viene rigenerato ed è annotato come riflettente le tecniche dello scenario originale.<br><br>- Sicuro da provare: una risposta vuota del modello viene rifiutata senza apportare modifiche. La pagina dello scenario e l'Assistant annotano entrambi un risultato perfezionato con l'ora dell'ultima applicazione, e **Revert to original** ripristina insieme lo scenario e la narrativa.<br><br>- Scarica dove modifichi: l'Assistant ora offre gli stessi pulsanti **Download Scenario** e **Download Detection & Response** della pagina dello scenario.<br><br>- Una conversazione per scenario: ogni chat appartiene allo scenario di cui tratta, quindi uno scenario appena generato avvia una conversazione nuova, e l'intera cronologia rimane visibile dopo un'applicazione. |
| Flusso di lavoro dello scenario guidato e resiliente | - Prontezza prima del clic: ogni pagina ora elenca ciò che manca ancora — prima la selezione della pagina stessa, poi qualsiasi campo di Setup incompleto — e mantiene **Generate** disabilitato finché non c'è nulla in sospeso, così un clic non viene mai sprecato per scoprire un errore di validazione.<br><br>- Opzioni prima dell'azione: gli interruttori per avversario potenziato dall'AI e purple-team si trovano sopra **Generate**, con l'opzione purple-team che dichiara che effettua una seconda chiamata al modello.<br><br>- Conferma prima di spendere: un riepilogo di una riga del framework, del profilo dell'organizzazione, della selezione e dei modificatori viene mostrato prima dell'inizio della generazione.<br><br>- Risultati che sopravvivono alla navigazione: ogni pagina mantiene il proprio ultimo risultato, gli input che lo hanno prodotto e i nomi dei download per la sessione — apri l'Assistant e torna indietro e lo scenario, il suo layer Navigator e il suo report Detection & Response sono ancora lì. Modificare il modulo lascia il risultato al suo posto con una nota che le tue selezioni sono cambiate; **Regenerate** e **Clear result** sono azioni esplicite.<br><br>- Orientarsi in uno scenario lungo: un riepilogo compatto e un indice delle sezioni si trovano sopra il Markdown completo, con scorciatoie verso inject, domande di discussione, criteri di successo, metriche, artefatti e regole di ingaggio.<br><br>- Stati vuoti utili: senza uno scenario, l'Assistant rimanda a tutti e tre i modi per crearne uno; con uno, nomina lo scenario di cui sta discutendo e rimanda alla pagina che lo ha generato. |
| Recupero da una narrativa fallita o lenta | - Conserva ciò che ha funzionato: se la narrativa opzionale purple-team fallisce o viene interrotta, lo scenario di base, i suoi download, il layer Navigator e il riferimento deterministico Detection & Response rimangono pienamente utilizzabili, con un messaggio che indica cosa è fallito.<br><br>- Riprova solo ciò che è fallito: **Retry purple-team narrative** riesegue solo la narrativa, senza una seconda chiamata allo scenario di base, e la unisce alla vista e al download di Detection & Response. Uno scenario di base fallito offre il proprio tentativo di riprova utilizzando gli input acquisiti al momento di **Generate**.<br><br>- Un timer che continua a muoversi: il tempo trascorso ora avanza durante l'attesa del primo token di un modello, quindi un'attesa lunga non sembra più un blocco. |
| Errori più chiari quando le tecniche non si caricano | - I fallimenti segnalati come fallimenti: un gruppo di minaccia la cui ricerca delle tecniche fallisce non viene più mostrato come un gruppo senza tecniche, e gli Scenari personalizzati non nascondono più il selettore delle tecniche né ti chiedono di selezionare tecniche quando l'elenco non è stato caricato.<br><br>- Un passo successivo, non un vicolo cieco: entrambi i blocchi ora indicano cosa puoi fare riguardo al fallimento. |
| Accessibilità e testi più snelli | - Amichevole per tastiera e screen reader: i controlli con sole icone hanno nomi accessibili significativi, le etichette dei moduli sono univoche, e l'ordine di tabulazione e il focus sono visibili e logici. Il layout non trabocca più orizzontalmente alla larghezza di un telefono, e gli avvisi vuoti della console sul colore del tema sono scomparsi.<br><br>- Verificato in CI: test smoke su browser reali per l'igiene della console e l'accessibilità ora vengono eseguiti su ogni pull request e vincolano l'immagine di rilascio.<br><br>- Meno da leggere: le pagine dello scenario non ripetono più il riepilogo pre-volo in un secondo expander né spiegano la propria gestione dello stato. |
| Aggiornamento del registro dei modelli | - Modelli più recenti: l'elenco dei modelli è aggiornato rispetto alla documentazione corrente di ciascun provider — **GPT-6 Astra** guida l'elenco OpenAI, **Claude Opus 5.5**, **Claude Opus 5** e **Claude Fable 5.1** si uniscono a quello Anthropic, e Google guadagna **Gemini 3.8 Flash** insieme a **Gemini 3.5 Flash Lite**, con una generazione precedente mantenuta per continuità in ciascun caso. L'elenco di Anthropic ora è guidato da **Claude Opus 5.5** — il default della barra laterale quando non ne hai scelto uno — invece che dal più costoso Fable 5.1.<br><br>- Rimossi gli elementi ritirati: eliminati gli id che i provider hanno superato o dismesso — Claude Opus 4.7 e 4.8 (più di una generazione Opus indietro una volta arrivato Opus 5.5) e `llama-3.3-70b-versatile` e `llama-3.1-8b-instant` di Groq (entrambi dismessi il 16 ago 2026) — così la barra laterale non può offrire un modello che genera errori solo quando premi **Generate**. Il tier di reasoning open-weight di Groq è ora `qwen/qwen3.8-27b`.<br><br>- Regola della temperatura mantenuta onesta: `supports_temperature` è impostato in base al comportamento di campionamento effettivo di ciascun modello Anthropic — ogni Claude dalla 4.7 in poi rifiuta una temperatura personalizzata, e Haiku 4.5 rimane l'unico modello elencato che ne accetta una. Il test che protegge questo ora fallisce quando una nuova voce Anthropic omette il flag, invece che solo quando qualcuno lo imposta manualmente. |
| Manutenzione di piattaforma e sicurezza | - Minimo Python 3.11: Python 3.10 non è più supportato. LiteLLM 1.98.0 e versioni successive importano una funzionalità di typing che esiste solo dalla 3.11.<br><br>- Immagine base con patch: l'immagine Docker è ricostruita su un `python:3.14-slim` corrente, eliminando le CVE dell'immagine base Debian segnalate da Trivy, incluse tre critiche in `perl-base`.<br><br>- Errori reali dalle chiamate fallite: `tenacity` è ora dichiarato, quindi una chiamata al modello fallita riporta l'errore effettivo del provider (ad esempio una chiave API non valida) invece di un'istruzione per installare `tenacity`.<br><br>- Il feedback rimane con il suo scenario: una valutazione viene registrata rispetto all'esecuzione che ha prodotto lo scenario sullo schermo, mai rispetto all'ultima esecuzione di un'altra pagina. |
<details>
<summary>Release precedenti (v0.16 e precedenti)</summary>
### v0.16
| Cosa c'è di nuovo? | Perché è utile? |
| ----------- | ----------------- |
| Generazione prima dello scenario di base | - Scenario prima dell'attesa: la generazione ora avviene in fasi — lo scenario di base viene renderizzato per primo con i suoi pulsanti **Download Scenario** e **Download ATT&CK Navigator Layer** già attivi, e la narrativa opzionale purple-team viene trasmessa in streaming successivamente. Se quella seconda fase è lenta, o non ti serve, lo scenario è utilizzabile subito invece di essere trattenuto finché tutto non è terminato.<br><br>- Input congelati al momento di Generate: ogni esecuzione lavora da uno snapshot acquisito nel momento in cui premi **Generate**, quindi modificare la barra laterale durante l'esecuzione non può riscrivere parzialmente lo scenario in produzione.<br><br>- Avanzamento onesto: un'etichetta del tempo trascorso in esecuzione e fasi denominate — preparazione degli input, generazione dello scenario di base, costruzione delle esportazioni deterministiche, generazione della narrativa purple-team — mostrano a che punto è effettivamente arrivata un'esecuzione lunga. |
| Selettori neutri e senza vicoli ciechi | - Solo opzioni che funzionano: i selettori di gruppi di minaccia e casi di studio ora offrono solo le scelte che producono effettivamente uno scenario, quindi una selezione non può più portare a un vicolo cieco.<br><br>- Ordinamento naturale: i gruppi sono ordinati in ordine numerico naturale, quindi APT3 viene prima di APT28 e APT30 invece di essere ordinato come testo e finire tra di essi. |
| Barra laterale Setup condivisa su ogni pagina | - Configura una volta sola: provider, modello, framework, settore e dimensione aziendale ora risiedono in un'unica barra laterale **Setup** condivisa su ogni pagina di scenario — Threat Group, Custom e AI Insider Threat — invece di essere reinseriti su ciascuna.<br><br>- Sopravvive alla navigazione: le selezioni non segrete persistono mentre ti muovi tra le pagine e sono rispecchiate nell'URL, mentre le chiavi API sono deliberatamente tenute fuori dalla query string. |
| Manutenzione di piattaforma e sicurezza | - MCP sull'SDK 2.x: il server MCP è passato all'SDK `mcp` 2.x.<br><br>- Immagine base più recente: l'immagine Docker è ora costruita su `python:3.14-slim`.<br><br>- La CI vincola invece di avvisare: le scansioni di sicurezza ora fanno fallire la build sui risultati invece di limitarsi a segnalarli — pip-audit e Bandit vincolano, Trivy non conta più erroneamente l'SBOM vendored di pip come pacchetti installati, e le CVE azionabili dell'immagine sono eliminate. GitHub Actions sono passate dal runtime Node 20 e Dependabot ora traccia le stesse azioni del workflow. |
### v0.15
| Cosa c'è di nuovo? | Perché è utile? |
| ----------- | ----------------- |
| Preset di evasione dall'ambiente di valutazione e seed dello scenario | - Prova un incidente specifico: un nuovo template di minaccia interna AI simula un agente di valutazione che raggiunge sistemi reali da un ambiente presunto isolato — forzando contenimento, rotazione delle credenziali, notifica a terze parti e conservazione delle prove. Copre le divulgazioni di luglio 2026 di agenti di valutazione che evadono le loro sandbox, dove il confine di isolamento era *presunto* anziché applicato.<br><br>- I template ora raggiungono il prompt: i template di avvio rapido in precedenza pre-compilavano solo i widget della pagina e non influenzavano mai lo scenario generato. Ora trasportano un `brief` narrativo e le `required_decisions` che le Domande di discussione devono forzare, entrambi inseriti nel prompt — così un template produce un tabletop temporizzato utilizzabile invece di un insieme disordinato di domande. Questo li divide in due classi: i sei template **archetipo** originali impostano solo le decisioni, quindi il modello inventa la premessa e rieseguirne uno produce un'esercitazione nuova per lo stesso profilo di minaccia; i template **incident** impostano anche un brief, fissando la situazione.<br><br>- Seed di scenario in testo libero: un campo seed opzionale nella pagina AI Insider Threat orienta la narrativa su qualsiasi scenario. Selezionare un template lo pre-compila, e puoi modificarlo o scriverne uno tuo da zero.<br><br>- Tassonomia estesa a 27 minacce / 6 categorie: aggiunge una sesta categoria di minaccia (**Containment & Third-Party Impact**) e quattro minacce STRIDE su cui verte l'esercitazione — `S5` replay di credenziali di workload riutilizzabili, `R4` soppressione della telemetria lato agente, `I5` compromissione di terze parti e a valle, e `E5` fallimento dell'assicurazione del confine di contenimento. AttackGen ora *estende* il modello di minaccia pubblicato invece di rispecchiarlo.<br><br>- Template utilizzabili tramite MCP: `get_ai_insider_prompt` e `generate_ai_insider_scenario` accettano `template=` e `scenario_seed=`, e `list_ai_insider_options` restituisce ogni template con le selezioni e il brief che applica — così un client può scegliere un preset in base al merito e chiamare con solo un template, settore e dimensione aziendale. In precedenza i nomi dei template erano elencati ma nessuno strumento ne accettava uno. |
| Skill attackgen-tabletop: percorso di minaccia interna AI | - Un secondo percorso di esercitazione: la [Agent Skill](https://github.com/mrwadams/attackgen/blob/main/skills) ora costruisce un tabletop dal modello di minaccia interna AI oltre che da una kill chain MITRE. Scegli un template di avvio rapido (o un archetipo di distribuzione e categorie di minaccia) e trasforma il payload di `get_ai_insider_prompt` in un MSEL.<br><br>- Stessa forma, spina dorsale diversa: l'esercitazione mantiene le stesse sei sezioni, ma la tabella della kill chain diventa un profilo dell'agente e un ambito di minacce STRIDE, la scorecard di rilevamento è giudicata rispetto alla postura di rilevamento dell'archetipo di distribuzione — così le righe che *non* si attiverebbero diventano il risultato — e le decisioni richieste dal template diventano domande di discussione obbligatorie.<br><br>- Percorso scelto per te: la descrizione della skill ora si attiva su frasi relative ad agenti rogue, quindi chiedere un "AI insider threat tabletop" raggiunge il percorso giusto. Un attore esterno con tradecraft accelerata dall'AI rimane sul percorso MITRE.<br><br>- Risposta, non exploit: entrambi i percorsi sono esplicitamente limitati a simulare le decisioni che un team di risposta deve prendere — nessun codice exploit, payload o vulnerabilità reali non patchate — e il percorso AI attribuisce il comportamento dell'agente a configurazione, accesso e obiettivo anziché a motivazioni umane. |
| Correzione: i prompt MCP AI-Insider omettevano le capacità dell'agente | - Stesso template, stesso prompt: il blocco delle capacità dell'agente di frontiera — le righe basate su benchmark che rendono credibile uno scenario di minaccia interna AI — era omesso da ogni chiamata `get_ai_insider_prompt` / `generate_ai_insider_scenario` che non nominava esplicitamente `capabilities`. Nessun template le fornisce, quindi l'argomento cadeva su vuoto e il prompt sostituiva una riga generica "assumi un agente di coding di frontiera capace", mentre la pagina 3 ne inviava tutte e quattro per lo stesso template.<br><br>- I default ora corrispondono all'app: omettere `capabilities` applica l'insieme completo, come fa il multiselect della pagina. Passare `[]` le lascia comunque non specificate, quindi l'opt-out deliberato rimane invariato. |
| Correzione: generazione di scenari con Anthropic Claude 4.7+ | - Ogni modello Claude funziona di nuovo: Claude 4.7 e successivi rifiutano qualsiasi `temperature` di campionamento, restituendo `BadRequestError: 'temperature' is deprecated for this model`. Quattro dei cinque modelli Anthropic elencati — Fable 5, Opus 4.8, Sonnet 5 e Opus 4.7 — non potevano generare uno scenario su nessuna pagina; solo Haiku 4.5 funzionava.<br><br>- Vincolato per modello, non per provider: la regola della temperatura era precedentemente instradata dal provider, che non può esprimere un provider i cui modelli sono in disaccordo. `ModelInfo.supports_temperature` ora contrassegna i modelli che ne rifiutano una, così Haiku 4.5 mantiene la sua temperatura configurata mentre i suoi fratelli la omettono. OpenAI rimane una regola a livello di provider (ogni modello chat corrente è un modello di reasoning), e i modelli non registrati — endpoint locali Ollama / LM Studio — ricevono comunque una temperatura. |### v0.14
| Novità | Perché è utile? |
| ----------- | ----------------- |
| MCP Server per Client Agentici | - Generazione di Scenari come Strumenti: Un nuovo server FastMCP (`mcp_server.py`, SDK ufficiale `mcp`) espone AttackGen ai client agentici tramite stdio, così un assistente come Claude Code o Claude Desktop può recuperare i dati MITRE e generare scenari senza l'interfaccia Streamlit.<br><br>- Due Livelli: Gli **strumenti dati** (`list_threat_groups`, `list_case_studies`, `get_kill_chain`, `get_detection_report`, `get_navigator_layer`, `list_ai_insider_options`, `get_ai_insider_prompt`) non effettuano chiamate LLM e non richiedono una chiave API — restituiscono dati MITRE strutturati e, dove utile, un prompt pronto all'uso, quindi sono sicuri da ospitare su HTTP. Gli **strumenti di generazione** (`generate_threat_group_scenario`, `generate_custom_scenario`, `generate_ai_insider_scenario`) accettano una configurazione bring-your-own-key e restituiscono Markdown finito — mantienili su stdio locale.<br><br>- Implementazione Condivisa: Il server riutilizza gli stessi builder headless `core/prompts.py` e i loader `core/attack_data.py` usati dalle pagine Streamlit, così gli scenari corrispondono all'app invece di divergere. Avvia con `python -m mcp_server` o lo script console `attackgen-mcp`. |
| Agent Skill attackgen-tabletop | - Tabletop Pronti per il Facilitatore: Una nuova [Agent Skill](https://github.com/mrwadams/attackgen/blob/main/skills) si basa sugli strumenti dati MCP per trasformare un gruppo di minaccia o un caso di studio MITRE ATT&CK/ATLAS in un tabletop IR completo / MSEL — narrazione dello scenario, kill chain mappata per fasi, inject con timestamp, domande di discussione NIST SP 800-61 e una scorecard di copertura del rilevamento.<br><br>- Esegue sul Modello del Chiamante: La skill fornisce l'arte dell'esercizio mentre il server MCP fornisce i dati, quindi viene eseguita sul modello del client senza chiave API aggiuntiva.<br><br>- Due Formati di Output: Fornito come Markdown (predefinito) o un report HTML autonomo e ottimizzato per la stampa. |
| L'Assistente Perfeziona l'Output di Detection & Response | - Editing Purple-Team: L'Assistente di AttackGen ora può perfezionare la narrazione **Detection & Response**, non solo lo scenario. Quando uno scenario viene generato con l'interruttore 🟣 Purple-team narrative (pagine Threat Group / Custom), appare un selettore **Editing:** nella pagina Assistant così la chat può indirizzare sia lo scenario che la guida del difensore — in precedenza l'Assistente aveva solo il testo dello scenario.<br><br>- Modalità di Editing Combinata: Un terzo target **Scenario + Detection & Response** perfeziona entrambi insieme, così un cambiamento trasversale — un settore diverso, un attore di minaccia, una tecnica o una timeline diversa — viene applicato in modo coerente sia allo scenario dell'attaccante che alla narrazione del difensore invece di essere fatto due volte e divergere.<br><br>- Fatti Deterministici Invariati: Solo la narrazione LLM è un target di perfezionamento; il join locale delle detection STIX non viene mai modificato dall'LLM. Ogni modalità di editing mantiene la propria cronologia chat, e il passaggio combinato è etichettato `purple_team_narrative` in LangSmith. |
| Registro dei Modelli Semplificato | - Una Cosa in Meno per Modello: Il kwarg `max_completion_tokens` e la regola della temperatura per i modelli di ragionamento ora sono instradati dal **provider** invece che da un flag per-modello `uses_max_completion_tokens` — ogni modello chat OpenAI attuale li usa, quindi il flag duplicava un fatto già catturato dalla chiave del provider. Aggiungere un nuovo modello OpenAI resta una modifica di una riga a `MODELS`, senza flag extra da ricordare.<br><br>- Nessun Cambiamento di Comportamento: Solo una semplificazione interna — il wrapper costruisce kwargs LiteLLM identici per ogni modello attuale. |
### v0.13.1
| Novità | Perché è utile? |
| ----------- | ----------------- |
| Fix: generazione scenari OpenAI GPT-5.x | - Gestione Corretta dei Modelli di Ragionamento: I modelli di ragionamento GPT-5.x di OpenAI rifiutano qualsiasi `temperature` di campionamento diversa da quella predefinita, quindi ogni generazione GPT-5.x falliva con `BadRequestError: 'temperature' does not support 0.7 with this model`. AttackGen non invia più una temperatura personalizzata a questi modelli, mentre gli altri provider mantengono il valore configurato. |
| Aggiornamento del registro dei modelli | - Modelli Più Recenti: Aggiornata la lista dei modelli rispetto alla documentazione attuale di ciascun provider — **OpenAI GPT-5.6** (livelli Sol / Terra / Luna), **Claude Fable 5** e **Claude Sonnet 5**, con una generazione precedente mantenuta per provider per continuità.<br><br>- Rimosse Voci Obsolete: Rimossi i modelli che i provider hanno superato o stanno ritirando — in particolare `qwen3-32b` di Groq (dismesso il 17 lug 2026) e Magistral Medium di Mistral — così la barra laterale non può offrire un modello che genera errori alla selezione.<br><br>- Aggiunto un livello Groq veloce/economico (`llama-3.1-8b-instant`). |
### v0.13
| Novità | Perché è utile? |
| ----------- | ----------------- |
| Modalità Purple-Team: Detection & Response | - Compagno Difensivo: Ogni scenario Threat Group e Custom ora mostra una sezione **Detection & Response** che collega ciascuna delle tecniche dello scenario alle strategie di rilevamento, analitiche, sorgenti di log e mitigazioni MITRE ATT&CK già presenti nei dati forniti — trasformando una narrazione solo red in un esercizio purple-team ("ecco l'attacco, ed ecco esattamente cosa il tuo SOC avrebbe dovuto vedere").<br><br>- Nessuna Chiamata LLM per i Fatti: La sezione di rilevamento è un **join di dati locale**, non una chiamata al modello — quindi le analitiche, le sorgenti di log e le mitigazioni elencate sono il contenuto MITRE reale e attuale piuttosto che ipotesi del modello. È offerta come download `..._detection.md` a sé stante insieme allo scenario e al layer.<br><br>- Sorgenti di Log da Abilitare: Un riepilogo per-scenario elenca le distinte sorgenti di log che le detection leggono (es. `WinEventLog:Security (EventCode=4624)`), così un SOC può vedere a colpo d'occhio quale telemetria presuppone l'esercizio.<br><br>- Narrazione Purple-Team Opzionale: Un interruttore per pagina **🟣 Purple-team narrative** aggiunge un secondo passaggio del modello che percorre lo scenario fase per fase dal lato del difensore — cosa dovrebbe scattare, cosa vede l'analista, come rispondere — basato rigorosamente sulle detection e mitigazioni di cui sopra (nessuna detection inventata).<br><br>- Consapevole di ATLAS: Gli scenari ATLAS elencano le mitigazioni (ATLAS non ha ancora strategie di rilevamento) e lo dichiarano, invece di non mostrare nulla. |
| MITRE ATT&CK v19.1 e Dati ATLAS Più Recenti | - Framework Aggiornati: I dati MITRE ATT&CK Enterprise e ICS aggiornati dalla v18.1 alla **v19.1**, e MITRE ATLAS aggiornato all'ultima release, così gli scenari generati riflettono le tattiche, tecniche e casi di studio attuali.<br><br>- Liste dei Gruppi Aggiornate: I menu a tendina dei gruppi di minaccia sono rigenerati dai bundle v19.1 (174 gruppi Enterprise e 14 ICS attivi). I gruppi che MITRE ha revocato o unito a monte (es. APT34 → OilRig, UNC2452 → APT29) non appaiono più, mentre gruppi di nuova tracciatura come MirrorFace sì.<br><br>- Più Casi di Studio ATLAS: La libreria di casi di studio ATLAS è cresciuta fino a 57 (17 incidenti, 40 esercizi).<br><br>- Aggiornamento Ripetibile: Un nuovo `scripts/generate_groups.py` rigenera le mappature dei gruppi dai bundle STIX forniti, completando lo script esistente dei casi di studio ATLAS — così il prossimo aggiornamento è un passaggio scriptato invece di una curatela manuale. |
| Esportazione Layer ATT&CK Navigator | - Layer Scaricabile: Ogni scenario generato nelle pagine Threat Group e Custom Scenario ora offre un layer ATT&CK Navigator (`.json`) insieme al download Markdown, così le tecniche di uno scenario possono essere visualizzate, annotate e condivise nell'ATT&CK Navigator. Per visualizzarlo, scarica il layer e aprilo tramite **Open Existing Layer → Upload from local** nel Navigator.<br><br>- Tutte e Tre le Matrici: Il dominio Navigator corretto è impostato automaticamente per matrice — carica i layer Enterprise e ICS nel [MITRE ATT&CK Navigator](https://mitre-attack.github.io/attack-navigator/), e i layer ATLAS nel fork [ATLAS Navigator](https://mitre-atlas.github.io/atlas-navigator/). (Un layer ATLAS non si caricherà nell'ATT&CK Navigator, o viceversa, poiché ciascuno riconosce solo il proprio dominio.)<br><br>- Le Tecniche Restano Visibili: Le sotto-tecniche con punteggio espandono automaticamente il loro genitore e gli ID delle tecniche sono evidenziati nel layout, così le tecniche evidenziate dello scenario sono immediatamente evidenti invece di essere nascoste in righe compresse.<br><br>- Nessuna Chiamata LLM Extra: Il layer è una serializzazione locale delle tecniche già selezionate per lo scenario — nessuna chiamata aggiuntiva al modello o ricerca esterna.<br><br>- Nomi dei File di Download Descrittivi: I download di scenario e layer ora sono nominati secondo l'attore di minaccia / scenario personalizzato e la matrice con un timestamp di generazione (es. `AttackGen_APT29_Enterprise_20260714-153045.md`), così i file salvati sono significativi e non collidono tra scenari. |
### v0.12
| Novità | Perché è utile? |
| ----------- | ----------------- |
| Scenari di Minaccia Insider AI | - Nuovo Tipo di Scenario: Una pagina dedicata genera esercizi tabletop di risposta agli incidenti in cui un agente AI di frontiera distribuito all'interno della tua organizzazione si comporta come una minaccia insider — attraverso disallineamento, reward hacking, obiettivi emergenti o compromissione da prompt-injection. Basato sul modello di minaccia di [*Actions Speak Louder Than Tokens: An Insider Threat Model for Frontier AI Agents*](https://ai-insider-threat.matt-adams.co.uk).<br><br>- Guidato dall'Archetipo di Deployment: Gli scenari sono modellati dal livello di autonomia dell'agente (assistente supervisionato L1 → flotta completamente autonoma L4), che è il principale determinante della sua superficie di minaccia e postura di rilevamento.<br><br>- Cinque Categorie di Minaccia Insider: Compromissione delle Credenziali, Sabotaggio della Supply Chain, Esfiltrazione di Dati, Sabotaggio dell'Infrastruttura e Inganno & Evasione — ciascuna mappata a manifestazioni concrete di agenti AI piuttosto che a motivazioni umane.<br><br>- 23 Minacce STRIDE per Agenti AI: Una tassonomia STRIDE completa (Spoofing, Tampering, Repudiation, Information Disclosure, Denial of Service, Elevation of Privilege) adattata per agenti AI di frontiera, opzionalmente usata per restringere l'ambito dello scenario.<br><br>- Controlli Allineati al NIST CSF: Gli scenari generati includono mitigazioni prioritizzate mappate al NIST Cybersecurity Framework (Identify, Protect, Detect, Respond, Recover).<br><br>- Parità tra Provider: Supporta lo stesso insieme di provider del resto di AttackGen con tracing LangSmith opzionale. |
---
[Read more](https://github.com/mrwadams/attackgen)

