 biniamf/ai-reverse-engineering
Reverse Engineering Assistito da IA con Ghidra

# Rev·Deck — Reverse Engineering Assistito da IA con Ghidra

Rev·Deck è una postazione di lavoro locale per analisi statica per un singolo utente. Abbina un'interfaccia web basata su evidenze con un copilot LLM su un binario analizzato da un servizio Ghidra headless: naviga direttamente le evidenze deterministiche (funzioni, stringhe, import, riferimenti incrociati, un grafo delle chiamate limitato) o poni all'assistente domande limitate le cui affermazioni fattuali devono citare evidenze verificabili.

I binari analizzati non vengono mai eseguiti. Il browser comunica solo con questa app Flask; l'app inoltra richieste validate e tipizzate al servizio Ghidra.

## Demo

https://github.com/user-attachments/assets/fba14dc5-7ad5-4137-9349-ed824da64fbe

## Avvio Rapido (Docker)

```bash
cp .env.example .env      # set API_BASE and MODEL_NAME; set API_KEY if required
docker compose up --build
```

Docker Compose legge automaticamente `.env` per l'interpolazione. Fallisce prima di avviarsi se `API_BASE` o `MODEL_NAME` mancano; `API_KEY=not-used` rimane valido per provider locali/senza chiave. Lo stack avvia entrambi i servizi. Apri http://127.0.0.1:5000.

Per eseguire solo il servizio Ghidra:

```bash
docker pull biniamfd/ghidra-headless-rest:latest   # ensure the newest image

docker run --rm \
  -p 127.0.0.1:9090:9090 \
  -v "$(pwd)/data:/data/ghidra_projects" \
  --security-opt no-new-privileges:true \
  biniamfd/ghidra-headless-rest:latest
```

Per un pin riproducibile, usa il digest della release testata invece di `latest`:

```bash
docker run --rm \
  -p 127.0.0.1:9090:9090 \
  -v "$(pwd)/data:/data/ghidra_projects" \
  --security-opt no-new-privileges:true \
  biniamfd/ghidra-headless-rest:1.2.1@sha256:971591a3a8448d8ed969079b452306e806f36079c3ddd298f4a618d6e2f1442d
```

## Prerequisiti

- Docker e Docker Compose (per la via Avvio Rapido), oppure Python 3.10+ e Node.js 18+ (per eseguire dal sorgente).
- Un endpoint LLM compatibile con OpenAI (locale o ospitato) e nome del modello.
- L'immagine pubblica Ghidra: `biniamfd/ghidra-headless-rest:latest`.

## Variabili d'ambiente essenziali

Copia `.env.example` in `.env` e compila queste; vedi quel file per l'elenco completo e i valori predefiniti.

| Variabile | Predefinito | Significato |
| --- | --- | --- |
| `API_BASE` | richiesto | URL base compatibile con OpenAI (http/https). Compose fallisce presto se assente. |
| `API_KEY` | `not-used` | Chiave del provider. Mai registrata o inviata al browser; `not-used` è valido per provider locali senza chiave. |
| `MODEL_NAME` | richiesto | ID del modello previsto dall'endpoint configurato. Compose fallisce presto se assente. |
| `LLM_STREAM` | `auto` | Trasporto streaming: `auto` (stream, ricade su bloccante una volta in caso di errore di compatibilità pre-output), `true` (sempre stream), `false` (sempre bloccante). |
| `GHIDRA_API_BASE` | `http://127.0.0.1:9090` | URL base del servizio Ghidra. |
| `GHIDRA_IMAGE` | `biniamfd/ghidra-headless-rest:1.2.1@sha256:971591a3...` | Release testata fissata con digest immutabile. Anche `:latest` risolve a questo digest; sovrascrivi per fissare una release diversa. |
| `HOST` / `PORT` | `127.0.0.1` / `5000` | Bind del server di sviluppo. |
| `MAX_UPLOAD_BYTES` | `104857600` | Limite dimensione upload. |
| `CHATS_DIR` | `webui/chats` | Directory cronologia chat. |

## Provider LLM

Rev·Deck comunica con **qualsiasi endpoint Chat Completions compatibile con OpenAI** tramite l'SDK OpenAI, configurato interamente da `API_BASE` / `API_KEY` / `MODEL_NAME`. Non c'è alcuna intestazione, parametro o logica specifica del provider: un server [Ollama](https://ollama.com) locale (`API_BASE=http://127.0.0.1:11434/v1`), un endpoint self-hosted vLLM/llama.cpp/LM Studio, OpenAI stesso, o un gateway come OpenRouter funzionano tutti allo stesso modo.

Esempio di impostazioni provider `.env` (usa segnaposto, non inserire mai chiavi reali):

```dotenv
# Ollama
API_BASE=http://127.0.0.1:11434/v1
API_KEY=not-used
MODEL_NAME=qwen3:8b
```

```dotenv
# OpenRouter
API_BASE=https://openrouter.ai/api/v1
API_KEY=replace-with-your-key
MODEL_NAME=anthropic/claude-opus-4.8
```

```dotenv
# OpenAI
API_BASE=https://api.openai.com/v1
API_KEY=replace-with-your-key
MODEL_NAME=replace-with-a-supported-model-id
```

```dotenv
# LM Studio, vLLM, or llama.cpp (adjust port/model to the server)
API_BASE=http://127.0.0.1:1234/v1
API_KEY=not-used
MODEL_NAME=replace-with-the-served-model-id
```

Per impostazione predefinita (`LLM_STREAM=auto`) l'assistente richiede una risposta **streaming** e inoltra i token al browser man mano che arrivano. Lo streaming offre anche una garanzia di cancellazione più forte: quando interrompi una risposta (o chiudi la scheda), Rev·Deck chiude prontamente lo stream del provider sottostante e non esegue ulteriori round di strumenti o modelli, quindi la generazione upstream viene interrotta anziché lasciata in esecuzione fino al completamento in background.

Avvertenze:

- **Fatturazione.** La cancellazione chiude lo stream immediatamente dal nostro lato, ma alcuni provider ospitati fatturano comunque i token già generati (o l'intera completazione) indipendentemente da una disconnessione anticipata del client. La garanzia riguarda il *non fare più lavoro*, non la politica di fatturazione del provider.
- **Compatibilità.** Non tutti gli endpoint compatibili con OpenAI accettano streaming con strumenti. In modalità `auto`, se il provider rifiuta la richiesta in streaming con un errore di compatibilità (HTTP 400/404/405/422) *prima di qualsiasi* output di contenuto o chiamata strumento, Rev·Deck ricade su una singola chiamata bloccante una volta e lo ricorda per il resto del processo. Gli errori di autenticazione (401/403), limite di velocità (429) e server (5xx) **non** vengono trattati come problemi di compatibilità e vengono segnalati come errori anziché essere ritentati silenziosamente. Imposta `LLM_STREAM=false` per saltare completamente lo streaming, o `LLM_STREAM=true` per richiederlo (nessun fallback).

## Come usare

Apri l'app e carica un binario per avviare un lavoro di analisi. Il contenuto di testo semplice evidente chiede conferma prima di essere inviato a Ghidra; usa l'override esplicito raw-binary solo quando il contenuto è intenzionalmente firmware/dati piuttosto che un formato eseguibile. Una volta completata l'analisi, passa tra due schede dell'area di lavoro:

- **Analisi** — viste di evidenze deterministiche: riepilogo, funzioni (filtra/pagina), import, stringhe, una vista query, un ispettore di funzioni (pseudocodice, riferimenti incrociati, grafo delle chiamate limitato, hexdump), e — quando il servizio Ghidra connesso le supporta — tipi, globali, annotazioni sidecar, esportazione archivio e una classifica deterministica della superficie d'attacco con segnali positivi/mitiganti spiegabili e copertura delle evidenze.
- **Chat** — l'assistente, in una delle due modalità:
  - **Copilot** (predefinita): un passo/chiamata strumento limitato per messaggio, per domande ad hoc.
  - **Autonoma**: avvia un workflow con nome e budget che esegue più passi limitati da solo e mostra una timeline di attività in tempo reale mentre lavora.

Entrambe le modalità accettano un **budget di passi** per attività e un'opzione **Nessun limite di passi** che esegue fino al completamento dell'attività (ancora limitato da `MAX_STEP_BUDGET` in modo che un modello in loop non possa scappare). Se un'esecuzione raggiunge il budget, riporta risultati parziali e offre **Continua** — che riprende la stessa conversazione usando le evidenze già recuperate, senza rifare le chiamate strumento completate. Il costo aumenta con il numero di chiamate strumento/modello, quindi budget più alti costano di più.

Workflow disponibili:

| Workflow | Scopo | Richiede un indirizzo di funzione target |
| --- | --- | --- |
| `program_triage` | Riassume lo scopo probabile del programma da metadati, import, stringhe e funzioni. | No |
| `suspicious_behavior` | Evidenzia prima indicatori deterministici, poi ipotesi limitate e chiaramente etichettate. | No |
| `selected_function` | Decompila una funzione e la spiega con i suoi chiamanti/chiamati. | Sì |
| `call_chain` | Esplora un vicinato limitato del grafo delle chiamate nativo/sintetizzato a partire da una funzione. | Sì |
| `attack_surface_triage` | Leggi copertura del punteggio deterministico/top-K, poi ispeziona in profondità al massimo tre candidati; i punteggi sono priorità, non verdetti. | No |
| `vulnerability_hypothesis` | Seleziona un candidato limitato e presenta evidenze, contro-evidenze e domande aperte; non conferma mai automaticamente. | No |

### Sotto-indagini mirate

Ogni lavoro di analisi ha una chat **Principale** più thread secondari mirati opzionali. Scegli **Nuova sotto-indagine**, inserisci un briefing di una riga e lavora con un contesto di conversazione fresco sullo stesso binario e gli stessi strumenti di sola lettura. Le cronologie dei thread rimangono isolate e solo un thread fa streaming alla volta.

Quando il lavoro mirato è pronto, scegli **Restituisci conclusione al genitore**. Rev·Deck effettua una chiamata modello limitata su quel sotto-thread solo, convalida le citazioni delle evidenze e aggiunge una carta di conclusione con segnalazione di provenienza al genitore. L'intero ramo rimane riaperto, mentre il contesto genitore riceve solo la conclusione compatta—non la trascrizione del ramo. Una carta restituita senza citazioni convalidate è esplicitamente contrassegnata come non verificata.

Le risposte dell'assistente citano le evidenze in linea come `[function:0xADDR]`, `[string:0xADDR]` o `[import:name]`. Le citazioni vengono verificate rispetto a ciò che è stato effettivamente recuperato durante il turno; una citazione che non corrisponde viene contrassegnata come "(non verificata)" e deve essere trattata come un'affermazione non confermata, non come un dato di fatto.

I diagrammi Mermaid nell'output dell'assistente (es. schizzi del grafo delle chiamate) vengono renderizzati in un frame sandboxed senza accesso alla rete esterna.

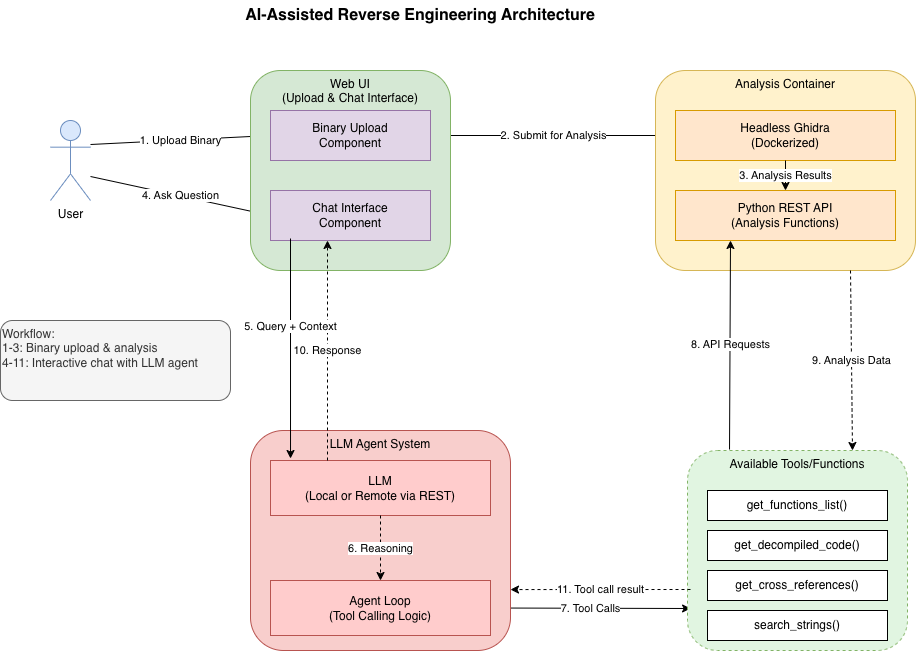
## Architettura

Il browser comunica solo con l'applicazione web Rev·Deck. Rev·Deck coordina il LLM configurato e il servizio Ghidra headless, quindi presenta le evidenze risultanti e l'attività dell'agente in un'unica area di lavoro.

<img width="916" height="651" alt="Rev·Deck architecture" src="https://assets.kitploit.com/production/public/readmes/9561/40809484745cf03bf42790c8abff0146755ebb953a3774c8fac17fbc3c0552de.png" />

## Esecuzione dal sorgente

```bash
python -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
npm ci && npm run vendor        # one-time: vendors the pinned Mermaid runtime

cp .env.example .env            # edit API_BASE / MODEL_NAME / API_KEY
set -a; source .env; set +a     # plain Python does not load .env automatically

# Start the separate Ghidra service, then:
python webui/app.py
```

Apri http://127.0.0.1:5000. Docker Compose legge `.env` automaticamente; l'esecuzione da sorgente richiede di esportarlo come mostrato sopra. Il server di sviluppo Flask va bene per uso locale; l'immagine Docker esegue Gunicorn.

## Sicurezza / confine solo locale

Questo è progettato per un singolo analista fidato sulla propria macchina — non per hosting multiutente o pubblico. Per impostazione predefinita l'app e il servizio Ghidra si legano solo a `127.0.0.1`, la modalità debug è disattivata, i binari caricati non vengono mai eseguiti e la chiave del provider LLM rimane lato server.

## Test

```bash
pip install -r requirements.txt -r requirements-dev.txt
python -m pytest
node --test "webui/static/js/tests/**/*.test.mjs"
npm ci && npm run vendor:verify   # verifies the vendored Mermaid bundle's integrity
```

## Risoluzione dei problemi

- **"Servizio offline" / `/readyz` restituisce 503** — il servizio Ghidra non è raggiungibile a `GHIDRA_API_BASE`, oppure `API_BASE`/`MODEL_NAME` non sono impostati.
- **Tipi/Globali/Annotazioni mostrano "richiede v1"** — il servizio Ghidra connesso non pubblicizza quella capacità; previsto su servizi più vecchi.
- **La chat dà errore immediatamente** — verifica `API_BASE`/`API_KEY`/`MODEL_NAME` e che il provider sia raggiungibile entro `LLM_TIMEOUT`.
- **Upload rifiutato perché troppo grande** — aumenta `MAX_UPLOAD_BYTES`.
- **L'upload sembra testo semplice** — Rev·Deck chiede conferma prima di inviarlo a Ghidra; continua come binario grezzo solo quando intenzionale.
- **Analisi grande va in timeout** — aumenta `ANALYSIS_TIMEOUT` del container Ghidra (ad esempio `5400` per binari C++/Android con oltre 10.000 funzioni) e ricarica. `LLM_TIMEOUT` non è correlato.
- **Una citazione mostra "(non verificata)"** — il modello ha citato evidenze che non ha mai effettivamente recuperato; tratta quell'affermazione come un'ipotesi non confermata.
