 biniamf/ai-reverse-engineering
Reverse Engineering Assistito da IA con Ghidra

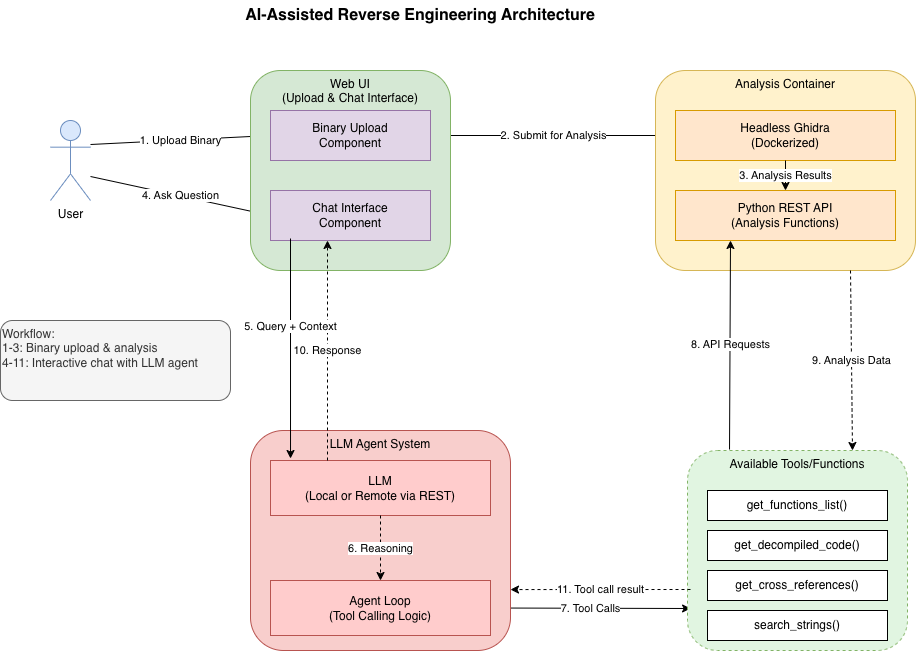
Rev·Deck è una postazione di lavoro locale per analisi statica per un singolo utente. Abbina un'interfaccia web basata su evidenze con un copilot LLM su un binario analizzato da un servizio Ghidra headless: naviga direttamente le evidenze deterministiche (funzioni, stringhe, import, riferimenti incrociati, un grafo delle chiamate limitato) o poni all'assistente domande limitate le cui affermazioni fattuali devono citare evidenze verificabili.
I binari analizzati non vengono mai eseguiti. Il browser comunica solo con questa app Flask; l'app inoltra richieste validate e tipizzate al servizio Ghidra.
https://github.com/user-attachments/assets/fba14dc5-7ad5-4137-9349-ed824da64fbe
cp .env.example .env      # set API_BASE and MODEL_NAME; set API_KEY if required
docker compose up --build
Docker Compose legge automaticamente .env per l'interpolazione. Fallisce prima di avviarsi se API_BASE o MODEL_NAME mancano; API_KEY=not-used rimane valido per provider locali/senza chiave. Lo stack avvia entrambi i servizi. Apri http://127.0.0.1:5000.
Per eseguire solo il servizio Ghidra:
docker pull biniamfd/ghidra-headless-rest:latest   # ensure the newest image

docker run --rm \
  -p 127.0.0.1:9090:9090 \
  -v "$(pwd)/data:/data/ghidra_projects" \
  --security-opt no-new-privileges:true \
  biniamfd/ghidra-headless-rest:latest
Per un pin riproducibile, usa il digest della release testata invece di latest:
docker run --rm \
  -p 127.0.0.1:9090:9090 \
  -v "$(pwd)/data:/data/ghidra_projects" \
  --security-opt no-new-privileges:true \
  biniamfd/ghidra-headless-rest:1.2.1@sha256:971591a3a8448d8ed969079b452306e806f36079c3ddd298f4a618d6e2f1442d
biniamfd/ghidra-headless-rest:latest.Copia .env.example in .env e compila queste; vedi quel file per l'elenco completo e i valori predefiniti.
| Variabile | Predefinito | Significato |
|---|---|---|
API_BASE | richiesto | URL base compatibile con OpenAI (http/https). Compose fallisce presto se assente. |
API_KEY | not-used | Chiave del provider. Mai registrata o inviata al browser; not-used è valido per provider locali senza chiave. |
MODEL_NAME | richiesto | ID del modello previsto dall'endpoint configurato. Compose fallisce presto se assente. |
LLM_STREAM | auto | Trasporto streaming: auto (stream, ricade su bloccante una volta in caso di errore di compatibilità pre-output), true (sempre stream), false (sempre bloccante). |
GHIDRA_API_BASE | http://127.0.0.1:9090 | URL base del servizio Ghidra. |
GHIDRA_IMAGE | biniamfd/ghidra-headless-rest:1.2.1@sha256:971591a3... | Release testata fissata con digest immutabile. Anche :latest risolve a questo digest; sovrascrivi per fissare una release diversa. |
HOST / PORT | 127.0.0.1 / 5000 | Bind del server di sviluppo. |
MAX_UPLOAD_BYTES | 104857600 | Limite dimensione upload. |
CHATS_DIR | webui/chats | Directory cronologia chat. |
Rev·Deck comunica con qualsiasi endpoint Chat Completions compatibile con OpenAI tramite l'SDK OpenAI, configurato interamente da API_BASE / API_KEY / MODEL_NAME. Non c'è alcuna intestazione, parametro o logica specifica del provider: un server Ollama locale (API_BASE=http://127.0.0.1:11434/v1), un endpoint self-hosted vLLM/llama.cpp/LM Studio, OpenAI stesso, o un gateway come OpenRouter funzionano tutti allo stesso modo.
Esempio di impostazioni provider .env (usa segnaposto, non inserire mai chiavi reali):
# Ollama
API_BASE=http://127.0.0.1:11434/v1
API_KEY=not-used
MODEL_NAME=qwen3:8b
# OpenRouter
API_BASE=https://openrouter.ai/api/v1
API_KEY=replace-with-your-key
MODEL_NAME=anthropic/claude-opus-4.8
# OpenAI
API_BASE=https://api.openai.com/v1
API_KEY=replace-with-your-key
MODEL_NAME=replace-with-a-supported-model-id
# LM Studio, vLLM, or llama.cpp (adjust port/model to the server)
API_BASE=http://127.0.0.1:1234/v1
API_KEY=not-used
MODEL_NAME=replace-with-the-served-model-id
Per impostazione predefinita (LLM_STREAM=auto) l'assistente richiede una risposta streaming e inoltra i token al browser man mano che arrivano. Lo streaming offre anche una garanzia di cancellazione più forte: quando interrompi una risposta (o chiudi la scheda), Rev·Deck chiude prontamente lo stream del provider sottostante e non esegue ulteriori round di strumenti o modelli, quindi la generazione upstream viene interrotta anziché lasciata in esecuzione fino al completamento in background.
Avvertenze:
auto, se il provider rifiuta la richiesta in streaming con un errore di compatibilità (HTTP 400/404/405/422) prima di qualsiasi output di contenuto o chiamata strumento, Rev·Deck ricade su una singola chiamata bloccante una volta e lo ricorda per il resto del processo. Gli errori di autenticazione (401/403), limite di velocità (429) e server (5xx) non vengono trattati come problemi di compatibilità e vengono segnalati come errori anziché essere ritentati silenziosamente. Imposta LLM_STREAM=false per saltare completamente lo streaming, o LLM_STREAM=true per richiederlo (nessun fallback).Apri l'app e carica un binario per avviare un lavoro di analisi. Il contenuto di testo semplice evidente chiede conferma prima di essere inviato a Ghidra; usa l'override esplicito raw-binary solo quando il contenuto è intenzionalmente firmware/dati piuttosto che un formato eseguibile. Una volta completata l'analisi, passa tra due schede dell'area di lavoro:
Entrambe le modalità accettano un budget di passi per attività e un'opzione Nessun limite di passi che esegue fino al completamento dell'attività (ancora limitato da MAX_STEP_BUDGET in modo che un modello in loop non possa scappare). Se un'esecuzione raggiunge il budget, riporta risultati parziali e offre Continua — che riprende la stessa conversazione usando le evidenze già recuperate, senza rifare le chiamate strumento completate. Il costo aumenta con il numero di chiamate strumento/modello, quindi budget più alti costano di più.
Workflow disponibili:
