
 #1
Paper di sicurezza, progetti di ricerca, riferimenti tecnici e materiale riproducibile per analisi difensive o autorizzate.
Raccomandato da Kitploit

 movemaverick/move-vulnerability-database
Database di vulnerabilità di Move

 zhengxr930/maleval
Codice ufficiale per l'articolo ISSTA 2026: "Sapere che è dannoso" è sufficiente? Valutare gli LLM per l'audit dettagliato del comportamento dei…
 albert-y1n/pismith
PISmith: Red Teaming basato su Apprendimento per Rinforzo per la Difesa da Prompt Injection
 bytereaper77/jump-over-aslr-btb
jump over aslr attaccando i predittori di salto per bypassare la tecnica aslr
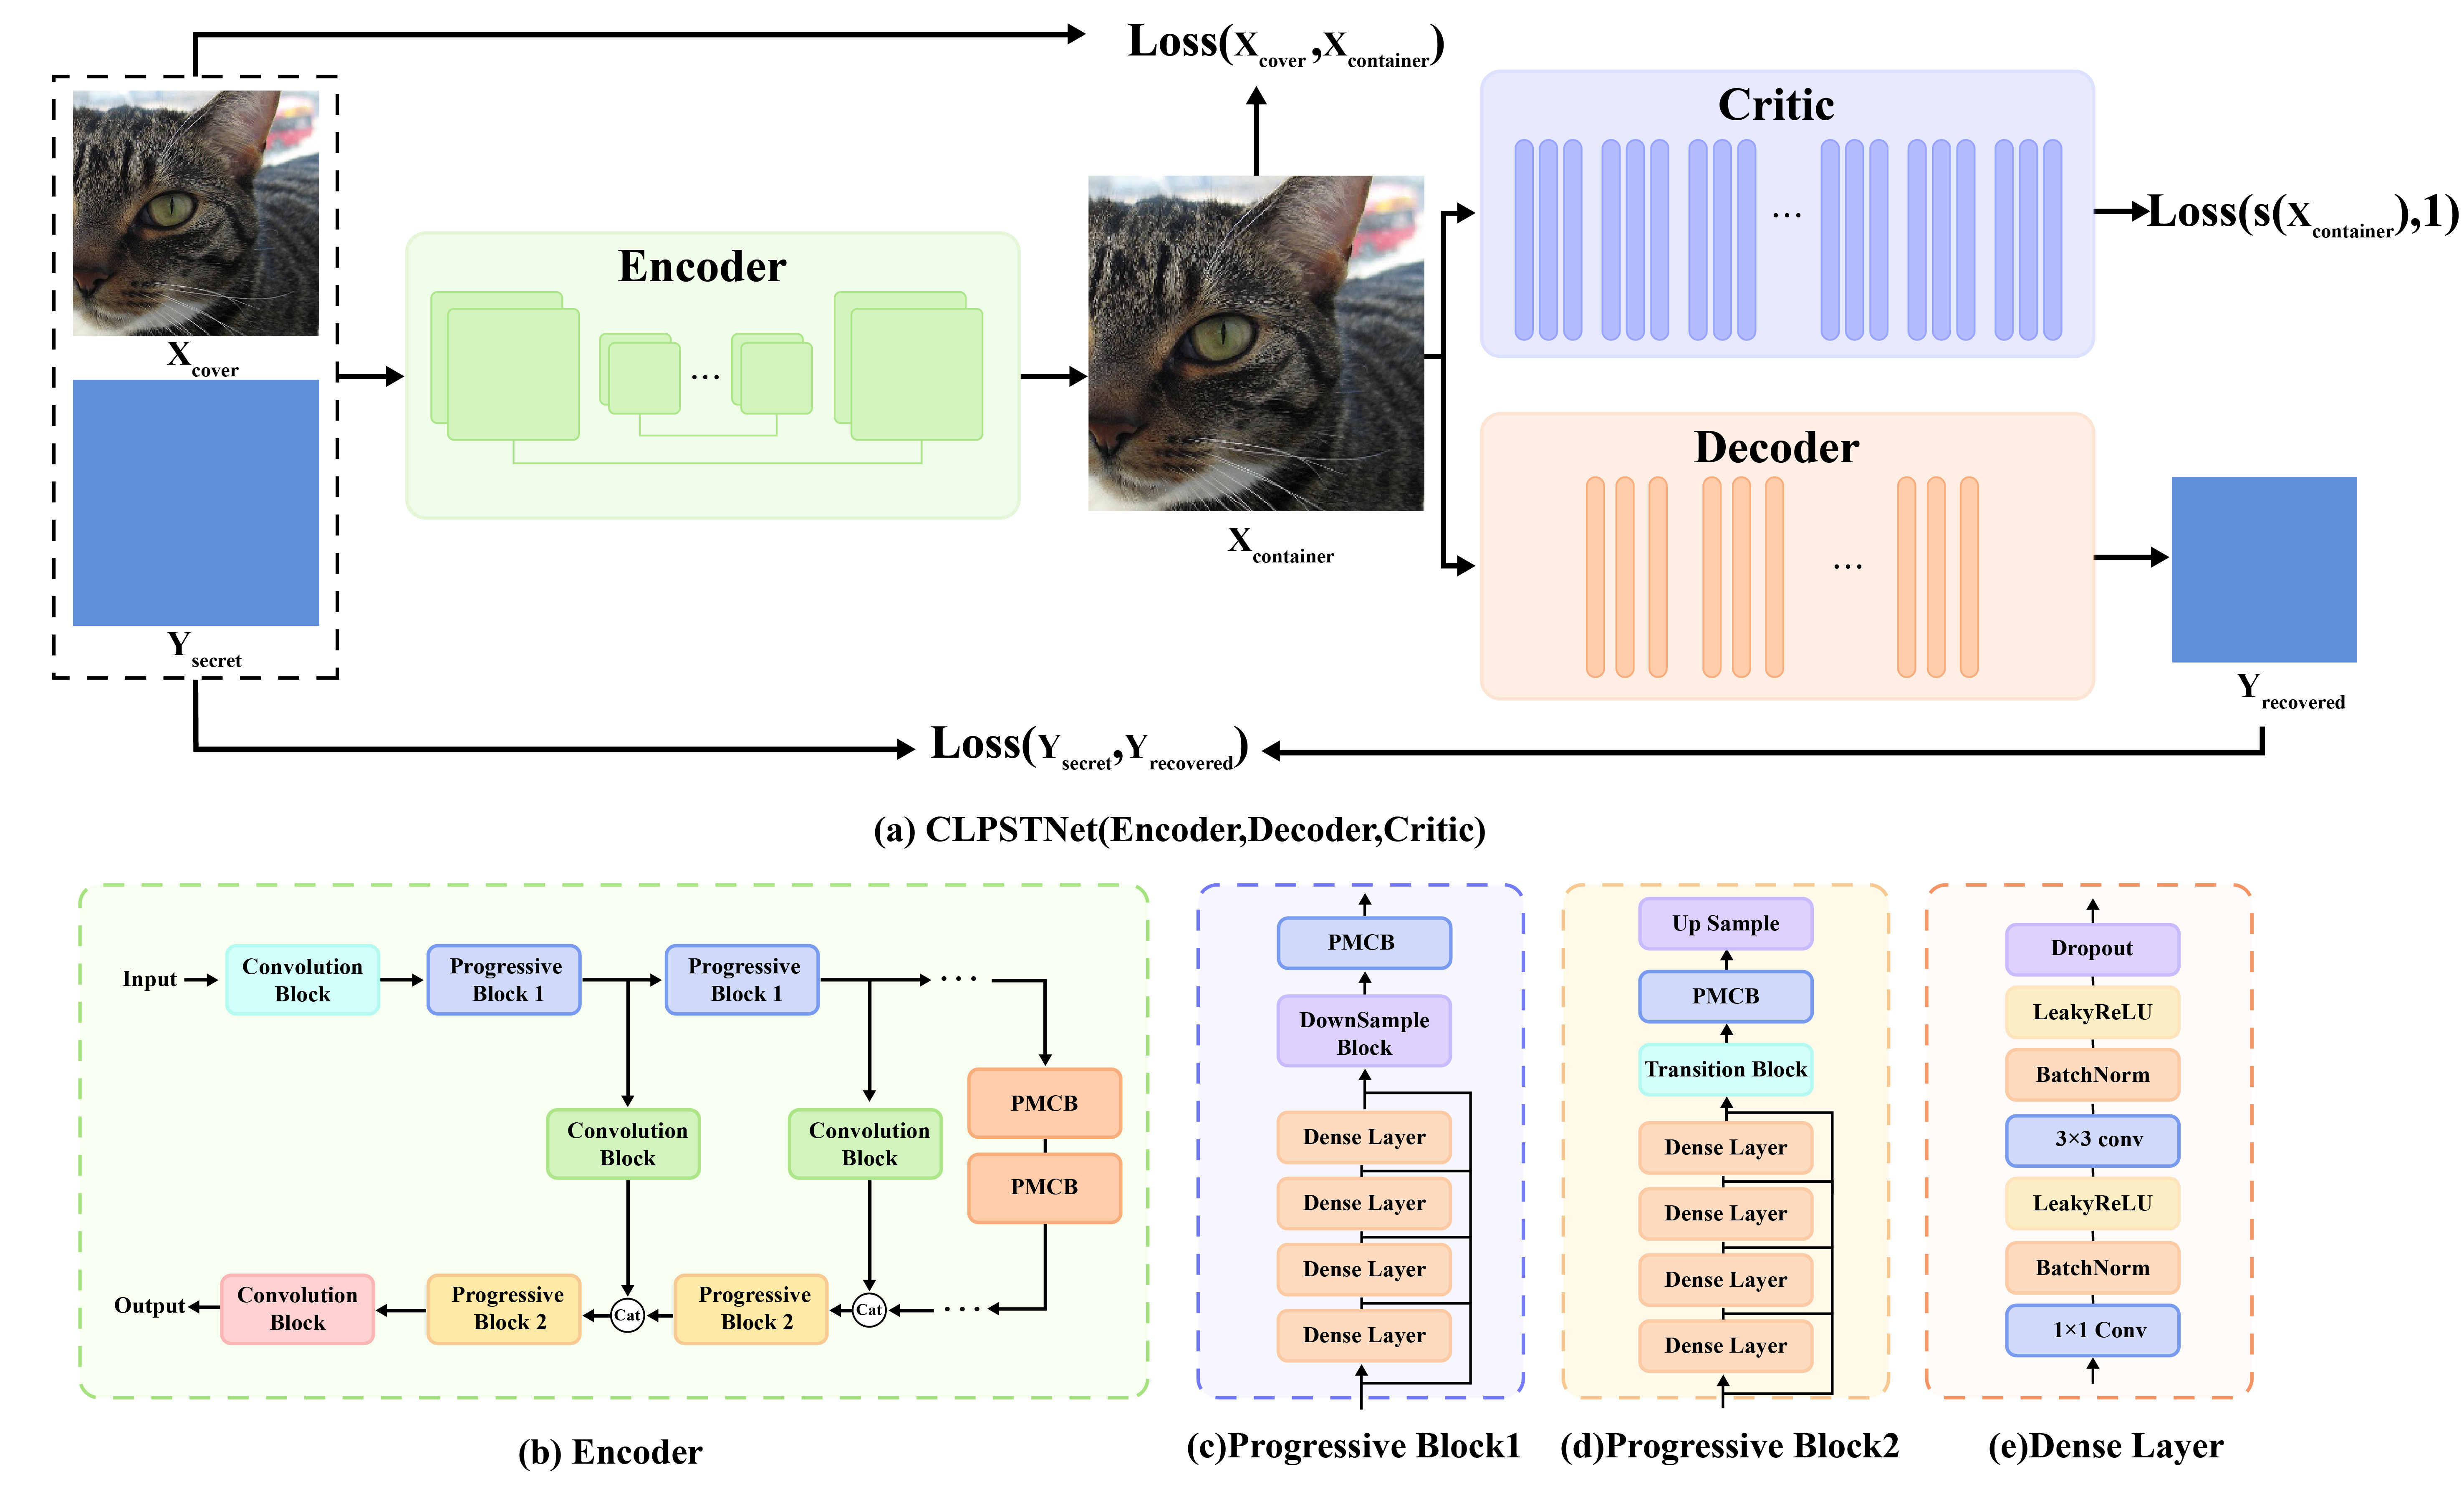 chaos-boops/clpstnet
CLPSTNet: Un modello progressivo di steganografia convoluzionale multi-scala che integra l'apprendimento curriculare
 j-dahl7/mcp-attack-detection-sentinel
Laboratorio di rilevamento Sentinel per catene di attacco MCP: furto di token SSRF CVE-2026-26118, avvelenamento degli strumenti, esfiltrazione tra…
 hannahxchen/llm-censorship-steering
Codice per 'Steering the CensorShip: Uncovering Representation Vectors for LLM "Thought" Control'
 jiamingzhang94/unlearnable-clusters
CVPR2023: Cluster Non Apprendibili: Verso Esempi Non Apprendibili Indipendenti dall'Etichetta
 microsoft/fides
Flow Integrity Deterministic Enforcement System. Meccanismi per proteggere gli agenti AI con il controllo del flusso di informazioni.
 knoveleng/redeval
[ICLR 2026] - Repository ufficiale del paper: "RedBench: A Universal Dataset for Comprehensive Red Teaming of Large Language Models"
 livecvebench/cve-factory
CVE-Factory
 franz-chang/adaptive_greedy_local_search
AGLS
 pasquini-dario/project_mantis
Project Mantis: Contrattacco contro l'AI-Hacker; Prompt Injection come Difesa dagli Attacchi Informatici guidati da LLM
 q-rz/saffron
Scaling dell'inferenza per la garanzia di sicurezza dei LLM
 sbamit/exponentiated-gradient-descent-llm-attack
Un nuovo attacco avversario sui LLM basato sulla tecnica dell'Exponentiated Gradient Descent.
 sej2020/manipulating-web-agents
Dimostrazione di ricerca di attacchi di injection di prompt indiretti per controllare agenti web autonomi basati su LLM, con strumenti per…
 stair-lab/certified-unlearning-neural-networks-icml-2025
Codice per l'articolo Certified Unlearning for Neural Networks, ICML 2025








