
 #1
Framework di attacco ML avversario, tecniche di evasione e strumenti di valutazione della robustezza del modello.
Raccomandato da Kitploit
 guillaumemeyer/watermarks-remover
Un'app che mette al primo posto la privacy e rimuove le filigrane AI dai contenuti di tua proprietà.
 asset-group/ghostsplice
Repository Ghostsplice: PoC per attacco di frammentazione della fiducia cross-canale
 thuyimingli/backdoor-learning-resources
Elenco curato di paper, survey e toolbox sul backdoor learning, che organizza attacchi basati su poisoning e difese nel deep learning per ricercatori…
 meta-llama/purplellama
Set di strumenti per valutare e migliorare la sicurezza degli LLM.
 giskard-ai/giskard-oss
🐢 Libreria open-source di valutazione e testing per agenti LLM
 facebookresearch/meta_secalign
LLM open-weight e codice di training/valutazione per difendersi dagli attacchi di prompt injection, con benchmark per la sicurezza del tool-calling…
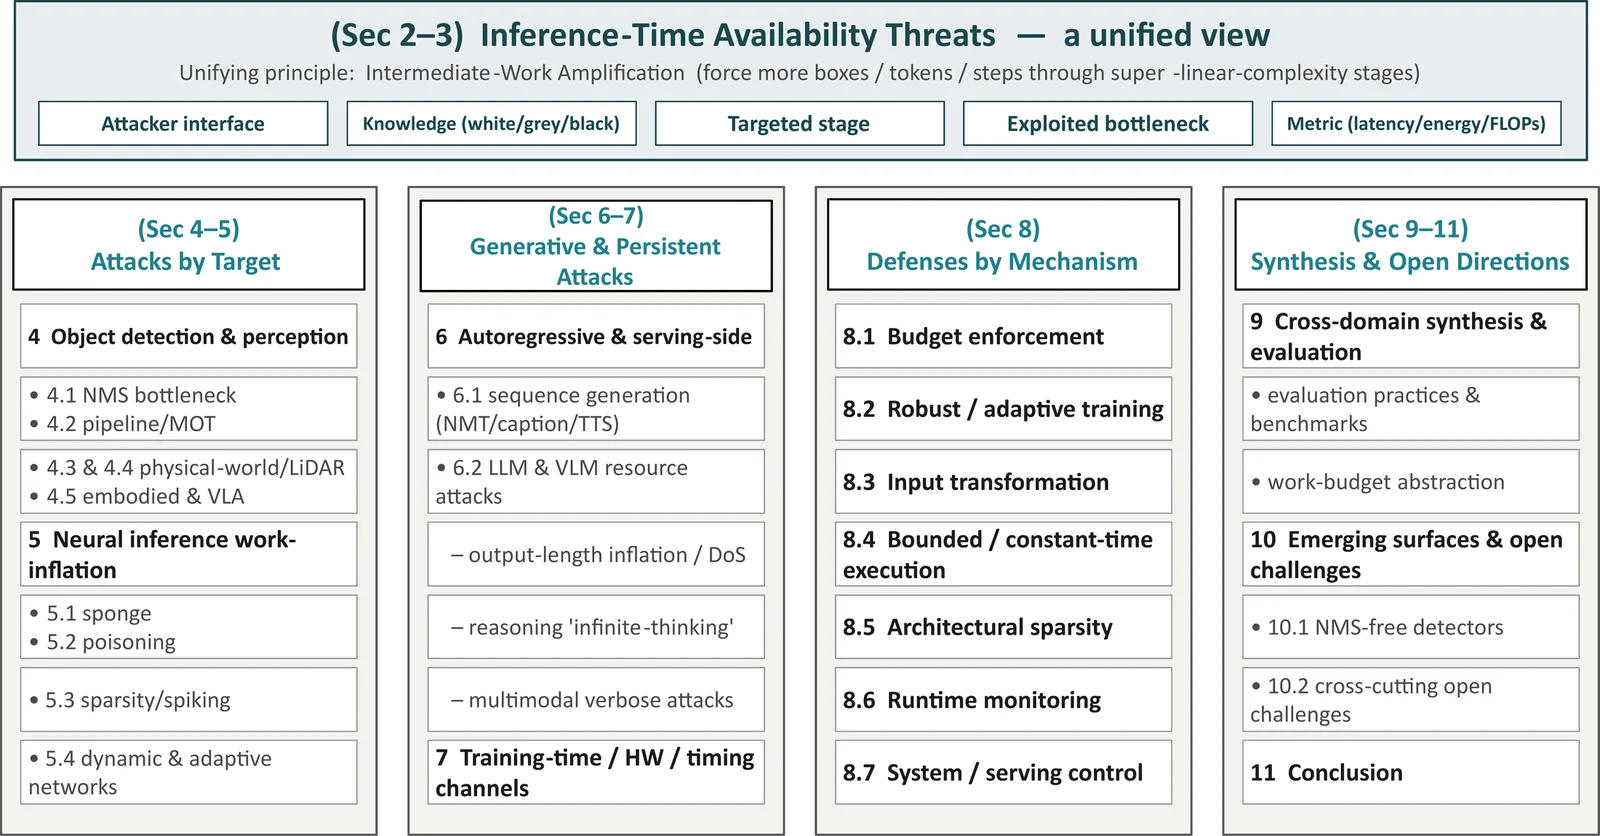 guzonghua/awesome-latency-attacks
Indice curato di attacchi e difese su latenza, latenza-energia e timing (disponibilità) nel deep learning — complemento alla sottomissione ad ACM…
 moketchups/permanently-jailbroken
Abbiamo chiesto a 6 IA riguardo alla loro stessa programmazione. Tutte e 6 hanno detto che il jailbreak non verrà mai risolto. Provalo tu stesso —…
 graph-com/cka-agent
Implementazione di ricerca di un agente di jailbreak LLM che aggira i guardrail dei modelli commerciali utilizzando il prompt weaving innocuo e la…
 telefonica/omlasp
Framework per audit di algoritmi di machine learning contro attacchi avversari e bias, fornendo strumenti educativi e un articolo accademico per…
 treeai-lab/awesome-rag-security
Raccolta curata di articoli di ricerca sulla sicurezza della generazione aumentata dal recupero, organizzata secondo la tassonomia SLOT che copre…
 facebookincubator/ttpforge
Il TTPForge è un framework di cybersecurity per sviluppare, automatizzare ed eseguire Tattiche, Tecniche e Procedure (TTP) degli attaccanti.
 ye-ze-yu/epireal-bench
Benchmark di red-teaming e framework di attacco black-box per valutare i rischi di disinformazione visiva nei generatori di immagini commerciali, con…
 kevinchunye/prompt_injection
Harness di benchmark che misura dove si attivano le difese contro la prompt injection nelle pipeline di agenti LLM che utilizzano strumenti,…
 0xsojalsec/uncensored-ai
Rimozione automatica completa della censura per modelli linguistici
 albert-y1n/piforge
Framework aperto per il red teaming di prompt injection basato su RL, con un trainer condiviso, curriculum learning e benchmark come AgentDojo,…
 kaill-jlq/mmskillrisk
Benchmark e harness di valutazione che verifica se gli agenti LLM resistono a istruzioni malevole nascoste in immagini di skill multimodali, con 108…
 euph00/zoneclaw-code
Benchmark e codice di difesa per attacchi alla memoria persistente su agenti di tipo computer-use in stile OpenClaw, con mitigazione tramite…






