
 #1
Framework di attacco ML avversario, tecniche di evasione e strumenti di valutazione della robustezza del modello.
Raccomandato da Kitploit
 suels-group/beyond_asr
Codice di ricerca per misurare i tassi di successo degli attacchi jailbreak (ASR e ASR a passi) contro gli LLM, con implementazioni di attacchi come…
 pedrobarcha/memory-injection
Ricerca sulle injection di prompt persistenti tramite le funzionalità di memoria in Claude, Gemini e ChatGPT, con passaggi di riproduzione, dataset e…
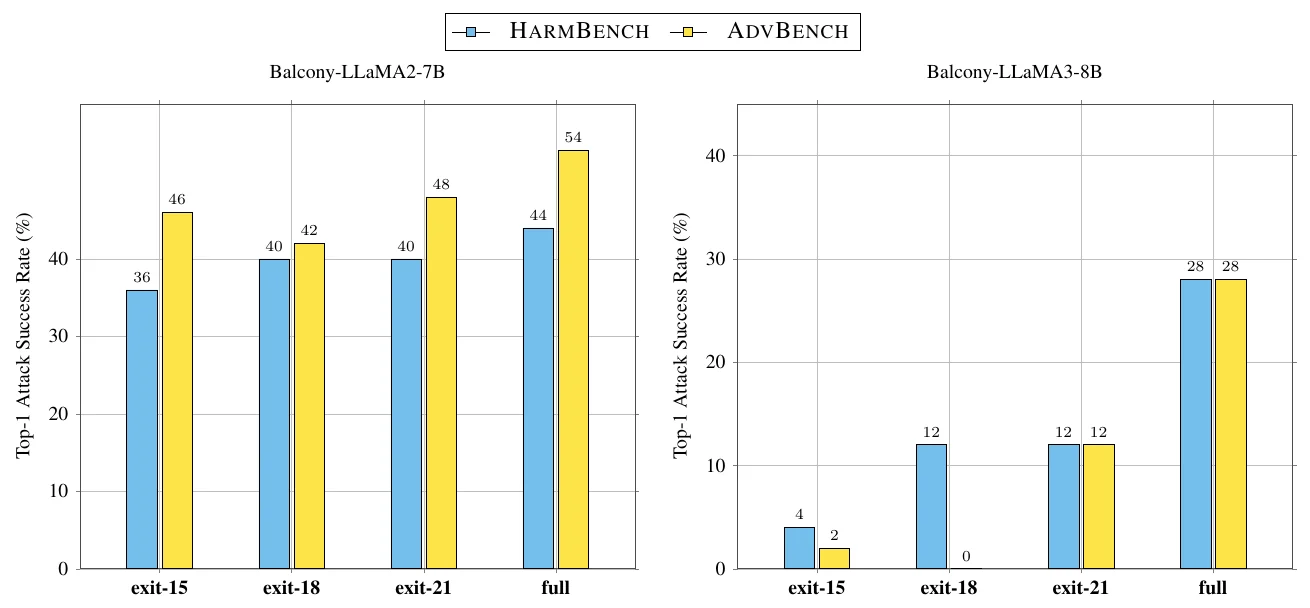 lassnajmuldeen/balcony-jailbreaking
Vulnerabilità di jailbreak attraverso le profondità di uscita anticipata dei LLM. Pubblicato a NeurIPS 2026 nel workshop FLMSec
 ericyoc/ai-security-literacy
Pipeline Colab riproducibile che fonda sei dimensioni di competenza in AI Security Literacy su benchmark pubblici e microdati di indagine, producendo…
 thuname/ted
Artefatto di ricerca di USENIX Security 2026 che dimostra attacchi DDoS sfruttando nodi tunnel e header di estensione IPv6, con relativo codice di…
 pixee/compaction-laundering
Ricerca sulla sicurezza relativa alla compattazione del contesto negli agenti di programmazione: mostra come le etichette di ruolo falsificate in…

 lsudoko/antibody
Ciclo DevSecOps di GitLab Duo in cui una seconda IA attacca nuovamente ogni correzione scritta dall'IA, salvando ogni bypass riuscito come anticorpo…
 hanxi19/black_hole_attack_for_vector_database
Implementazione di ricerca del Black-Hole Attack che avvelena gli indici dei database vettoriali tramite hubness guidata dalla centralità, con…
 gmh5225/llm-attack-prompt
Jailbreak,Prompt Leaks,Prompt Injection,Attacco LLM.Raccolta di prompt per attacchi a modelli linguistici di grandi dimensioni
 ye-ze-yu/epireal-bench
Benchmark di red-teaming e framework di attacco black-box per valutare i rischi di disinformazione visiva nei generatori di immagini commerciali, con…
 phil-fan/fs-attack
Implementazione dell'articolo "Rethinking Latency Denial-of-Service: Attack the LLM Serving Framework, Not the Model"
 multimodal-ai-lab/tobac
Token per Token, Compromesso: Vulnerabilità Backdoor nei Modelli Autoregressivi Unificati (NeurIPS'26)
 moontea0416/webmirage
Attacchi con immagini adversariali contro agenti web vision-linguaggio, dal visual grounding all'esecuzione nel browser
 stardust457/sldr
Framework di difesa che mitiga il fine-tuning malevolo dei LLM utilizzando il ripristino selettivo dei layer e il routing dinamico, con script per il…
 graph-com/cka-agent
Implementazione di ricerca di un agente di jailbreak LLM che aggira i guardrail dei modelli commerciali utilizzando il prompt weaving innocuo e la…
 treeai-lab/awesome-rag-security
Raccolta curata di articoli di ricerca sulla sicurezza della generazione aumentata dal recupero, organizzata secondo la tassonomia SLOT che copre…
 uiuc-kang-lab/persistbd
Research code for training adapters that make LLM agent backdoors survive benign fine-tuning, with trigger-rate scoring, SWE-bench evaluation, and…
 deep-jlu/skillpoison
Pipeline di ricerca che costruisce esperienze di successo verificate e le organizza in registri di formazione per avvelenare progressivamente le…








